【关于 对话系统】那些你不知道的事
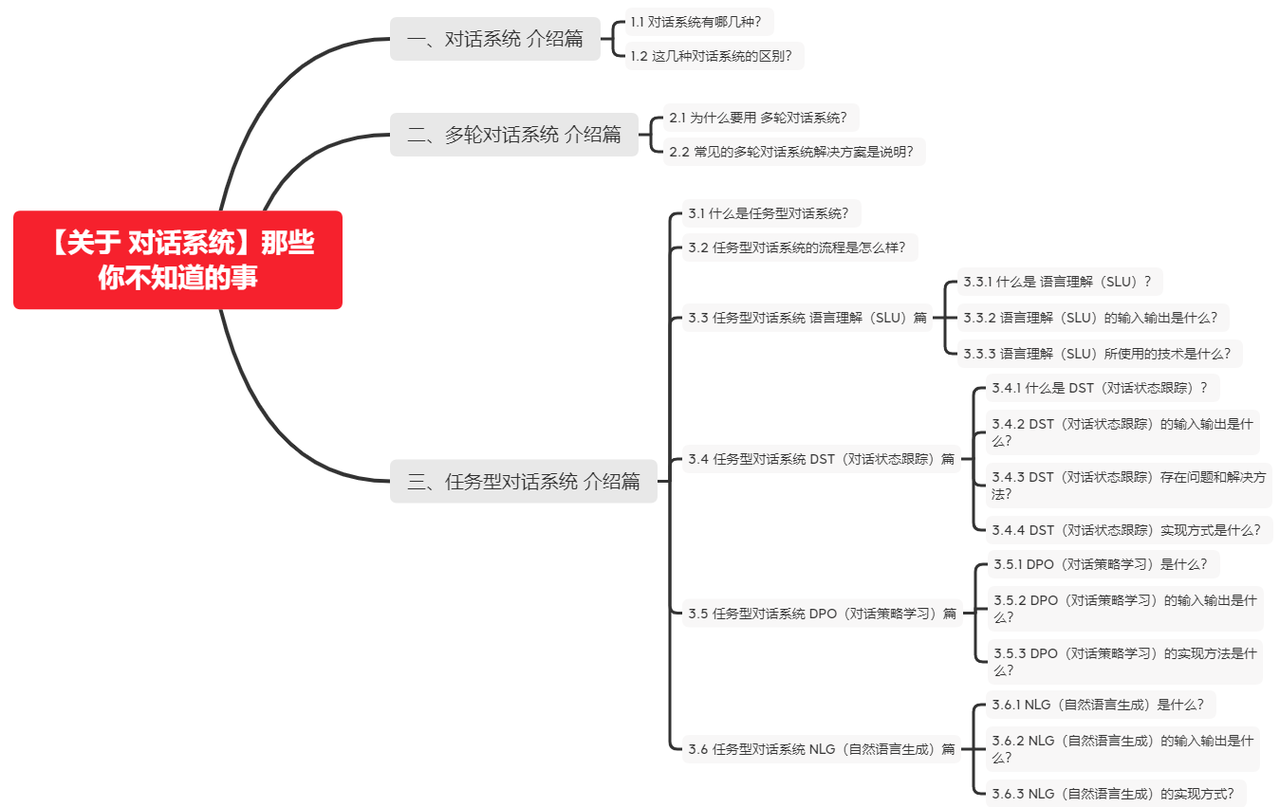
一、对话系统 介绍篇
1.1 对话系统有哪几种?
•
类别:
◦
任务型对话系统
▪
目标:通过对话系统能够找到用户完成一项特定任务
▪
类别:
•
基于规则
•
基于数据
◦
面向开放域的对话系统
▪
支持类型:闲聊
▪
类别:
•
基于 海量 FAQ 的检索方式
•
端到端方式
1.2 这几种对话系统的区别?
•
区别:是否有明确的目标和任务
•
面向开放域的对话系统
◦
特点:有户一般具有不确定的目的性
◦
如何衡量质量:以用户的主观体验为主
•
任务型对话系统
◦
特点:具有目前的目的性
◦
如何衡量质量:以任务的完成情况来衡量对话质量
二、多轮对话系统 介绍篇
2.1 为什么要用 多轮对话系统?
对于一项特定任务,需要多个不同的必要信息(eg:订餐任务:用户地址,用户电话等),单轮请求无法提供用户满足条件的充足信息。
2.2 常见的多轮对话系统解决方案是什么?
•
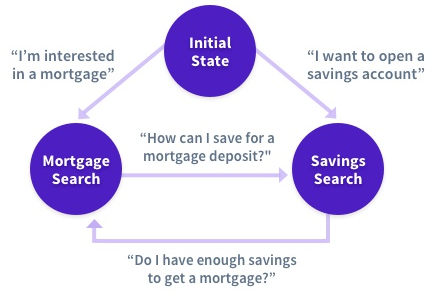
基于手写规则,状态机state machines
◦
缺陷:硬编码,不灵活,各种 if-else 的集合,一个场景对应一段代码,逻辑会越来越复杂,基本没有扩展性,泛化能力较差;
◦
举例介绍:
•
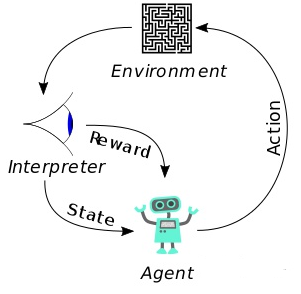
增强学习, reinforcement learning (RL)
◦
方法:采用增强学习的方法,对机器人的回答结果进行鼓励或惩罚;
◦
问题:需要大量数据和不停的与机器人对话,给予奖励才会变的智能,但是用户的对话是非理想状态不可控的
三、任务型对话系统 介绍篇
3.1 什么是任务型对话系统?
•
介绍:完成用户所指定的一项特定任务(天气、订餐等)
3.2 任务型对话系统的流程是怎么样?
•
ASR(语音识别)
◦
介绍:识别用户输入的语音信息,将其转化为文本。
◦
例如:将 "定云海肴中关村店" 语音转化为 文本;
•
SLU(语言理解)
◦
介绍:将用户输入的自然语言语句映射为机器可读的结构化语义表述;
▪
结构化语义:
•
意图识别:
•
槽值:
•
DST(对话状态跟踪)
◦
目标:跟踪用户需求并判断当前的对话状态
◦
工作原理:以多轮对话历史、当前用户动作为输入,通过总结和推理理解在上下文环境下用户当前输入自然语言的具体含义
◦
举例:根据 SLU 结果 {意图识别:预订,slot:{(restaurant_name,云海肴)、(subbranch,中关村店)}} 推理出 用户 想 预订(意图识别) 云海肴(restaurant_name)中关村店(subbranch)的餐位,更新 当前对话的意图和槽位信息;
•
DPO(对话策略学习)
◦
工作原理:根据当前的对话状态,对话策略决定下一步执行什么系统动作
◦
举例:根据 DST 的结果,判断用户的意图,已经完成该意图工作需要的槽位信息 request(phone,name)
•
NLG(自然语言生成)
◦
工作原理:负责将对话策略模块选择的系统动作转化到自然语言,最终反馈给用户
◦
举例:根据 DPL 的信息,输出对话:"麻烦请提供一下手机号和姓名"
•
TTS(语音合成)
◦
工作原理:将 NLG 的 文本回复转化为语音信息;
◦
举例:将 文本信息 "麻烦请提供一下手机号和姓名" 转化为 语音信息
3.3 任务型对话系统 语言理解(SLU)篇
3.3.1 什么是 语言理解(SLU)?
将用户输入的自然语言映射为机器可读的结构化语义表述,即用户的意图信息和对应的槽位值信息。
3.3.2 语言理解(SLU)的输入输出是什么?
•
输入:用户当前的对话信息 Xn
•
输出:解析 语句Xn 后所得到的用户动作信息 Un (意图,槽位);
3.3.3 语言理解(SLU)所使用的技术是什么?
•
意图识别->意图信息
◦
介绍:将用户输入的自然语言会谈划分为不同用户意图;
◦
举例:
▪
query: 定云海肴中关村店
▪
意图 : 预订
•
命名实体识别->槽位信息
◦
介绍:意图所带的参数,一个意图可以携带若干个相应槽位
◦
举例:
▪
query: 定云海肴中关村店
▪
槽位:(restaurant_name,云海肴)、(subbranch,中关村店)
◦
目标:在已知特定领域或意图的语义框架下,从输入语句中抽取处该语义框架中余弦定义好的语义槽的值
3.4 任务型对话系统 DST(对话状态跟踪)篇
3.4.1 什么是 DST(对话状态跟踪)?
根据旧状态、最新的系统动作和用户动作,更新对话状态,以获得新的对话状态。
3.4.2 DST(对话状态跟踪)的输入输出是什么?
•
输入:以旧状态、最新的系统动作和当前用户动作 (意图识别,槽位值) ;
•
输出:DST 模块判定得到的当前对话状态
3.4.3 DST(对话状态跟踪)存在问题和解决方法?
•
存在问题:由于 语音识别不准确 或 自然语言 本身存在 歧义问题,导致 NLU 的识别结果 往往 和真实结果间存在误差,所以 NLU 的 输出 是带概率的,及每一种可能的结果由一个相应的置信程度;
•
DST 在判断当前对话存在两种选择:
◦
第一种选择所对应的处理方法:1-Best
▪
介绍:DSt 判断当前对话状态时只考虑置信程度最高的情况,维护对话状态的表示时,只需要等同于槽位数量的空间;
◦
第二种选择所对应的处理方法:N-Best
▪
介绍:DST 判断当前对话时会综合考虑所有槽位的置信程度,每一个槽位的N-best 结构都要考虑和维护,且最终还需要维护一个槽位组合在一起的整体置信程度,作为最终的对话状态判断依据;
3.4.4 DST(对话状态跟踪)实现方式是什么?
•
基于CRF的系列跟踪模型
•
基于 RNN 或 LSTM 的序列跟踪模型
3.5 任务型对话系统 DPO(对话策略学习)篇
3.5.1 DPO(对话策略学习)是什么?
根据当前的对话状态,对话策略决定下一步执行什么系统动作
3.5.2 DPO(对话策略学习)的输入输出是什么?
•
输入:DST 模块输出的当前对话状态;
•
输出:通过预设的对话策略,选择系统动作作为输出;
3.5.3 DPO(对话策略学习)的实现方法是什么?
•
实现方式:增强学习,针对 DST 模块输出的当前对话状态 ,作为序列决策过程进行优化;
3.6 任务型对话系统 NLG(自然语言生成)篇
3.6.1 NLG(自然语言生成)是什么?
•
工作原理:负责将对话策略模块选择的系统动作转化到自然语言,最终反馈给用户
3.6.2 NLG(自然语言生成)的输入输出是什么?
•
输入:DPO 模块输出的当前系统动作;
•
输出:系统对用户输入 Xn 的回复;
3.6.3 NLG(自然语言生成)的实现方式?
•
基于模板:麻烦请提供一下{phone}和{name}
•
基于语法规则
•
生成式模型方法
【关于 概率图模型】 那些你不知道的事
一、基础信息 介绍篇
1.1 什么是概率图模型?
概率图模型(Probabilistic Graphical Model, PGM),简称图模型(Graphical Model,GM),是指一种用图结构来描述多元随机变量之间条件独立性的概率模型(注意条件独立性),从而给研究高维空间的概率模型带来了很大的便捷性。
1.2 什么是 随机场?
每个位置按照某种分布随机赋予一个值 所构成 的 整体。
二、马尔可夫过程 介绍篇
2.1 什么是 马尔可夫过程?
假设一个随机过程中,
tn
时刻的状态
xn
的条件发布,只与其前一状态
xn−1
相关,即:
则将其称为 马尔可夫过程。
2.2 马尔可夫过程 的核心思想 是什么?
对于 马尔可夫过程 的 思想,用一句话去概括:当前时刻状态 仅与上一时刻状态相关,与其他时刻不相关。
可以从 马尔可夫过程 图 去理解,由于 每个状态间 是以 有向直线连接,也就是 当前时刻状态 仅与上一时刻状态相关。
三、隐马尔科夫算法 篇
3.1 隐马尔科夫算法 介绍篇
3.1.1 隐马尔科夫算法 是什么?
隐马尔科夫算法是对含有未知参数(隐状态)的马尔可夫链进行建模的生成模型,如下图所示:
在隐马尔科夫模型中,包含隐状态 和 观察状态,隐状态 ii 对于观察者而言是不可见的,而观察状态 oi 对于观察者而言是可见的。隐状态间存在转移概率,隐状态 ii到对应的观察状态 oi 间存在输出概率。
3.1.2 隐马尔科夫算法 中 两个序列 是什么?
•
两序列
◦
隐藏序列:隐状态 ii 对于观察者而言是不可见的
◦
观测序列:$o_i$ 对于观察者而言是可见的
3.1.3 隐马尔科夫算法 中 三个矩阵 是什么?
•
初始状态矩阵:每个标签的概率矩阵
•
发射状态矩阵:一个字变成每个标签的概率 $B=\left[b_{i j}\right]{N \times M}
(
N
为隐藏状态集元素个数,M为观测集元素个数),其中
b{i j}=P\left(o_{t} | i_{t}\right)
,
(o_{t}
为第i个观测节点,
i_t$ 为第i个隐状态节点,即所谓的观测概率(发射概率);
•
状态转移级证:标签到每个标签的概率 $A=\left[a_{i j}\right]{N \times N}
(N表示隐藏状态集元素的个数),其中
a{i j}=P\left(i_{t+1} | i_{t}\right)
,
i_t$ 即第i个隐状态节点,即所谓的状态转移;
3.1.4 隐马尔科夫算法 中 两个假设 是什么?
•
假设一:输出观测值间严格独立,仅取决于对应隐状态。假设隐状态
xi
的状态满足马尔可夫过程,i时刻的状态
xi
的条件分布,仅与其前一个状态
xi−1
相关,即:
•
假设二:状态转移过程中,当前状态只与前一状态相关。假设观测序列中各个状态仅取决于它所对应的隐状态,即:
3.1.5 隐马尔科夫算法 中 工作流程 是什么?
隐状态节点 it 是不能直接观测到的数据节点, ot 才是能观测到的节点,并且注意箭头的指向表示了依赖生成条件关系;
it在
A
的指导下生成下一个隐状态节点
it+1
;
it在
B
的指导下生成依赖于该
it
的观测节点
ot
;
•
深层次理解:由于 为有向图,而且属于生成式模型,直接对联合概率分布建模
3.2 隐马尔科夫算法 模型计算过程篇
3.2.1 隐马尔科夫算法 学习训练过程 是什么样的?
思想
找出数据的分布情况,也就是模型参数的确定;
常用方法
•
极大似然估计:该算法在训练数据是会 将 观测状态序列 O 和 隐状态序列 I;
•
Baum-Welch(前向后向):该算法在训练数据是只会 将 观测状态序列 O;
3.2.2 隐马尔科夫算法 序列标注(解码)过程 是什么样的?
思想
也就是“预测过程”,通常称为解码过程。在给定的观测序列下找出一条隐状态序列,条件是这个隐状态序列的概率是最大的那个
Qmax=argmaxallQP(O)P(Q,O)
常用方法:Viterbi算法
Viterbi计算有向无环图的一条最大路径:
3.2.3 隐马尔科夫算法 序列概率过程 是什么样的?
思想
如何对一条序列计算其整体的概率。即目标是计算出 P(O|λ) ;
常用方法
•
直接计算法(穷举搜索)
•
前向算法
•
后向算法
3.3 隐马尔科夫算法 问题篇
在序列标注问题中,隐状态(标注)不仅和单个观测状态相关,还和观察序列的长度、上下文等信息相关。例如词性标注问题中,一个词被标注为动词还是名词,不仅与它本身以及它前一个词的标注有关,还依赖于上下文中的其他词。
四、最大熵马尔科夫模型(MEMM)篇
4.1 最大熵马尔科夫模型(MEMM)动机篇
4.1.1 HMM 存在 什么问题?
HMM中,观测节点 oi 依赖隐藏状态节点 ii ,也就意味着我的观测节点只依赖当前时刻的隐藏状态。但在更多的实际场景下,观测序列是需要很多的特征来刻画的,比如说,我在做NER时,我的标注 ii 不仅跟当前状态 oi 相关,而且还跟前后标注 oj(j≠i) 相关,比如字母大小写、词性等等。
4.2 最大熵马尔科夫模型(MEMM)介绍篇
4.2.1 最大熵马尔科夫模型(MEMM) 是什么样?
通过 “定义特征” 的方式,学习条件概率:
并且, P(i|i′,o) 这个概率通过最大熵分类器建模(取名MEMM的原因):
重点来了,这是ME的内容,也是理解MEMM的关键: Z(o,i′) 这部分是归一化; fa(o,i) 是特征函数,具体点,这个函数是需要去定义的; λ 是特征函数的权重,这是个未知参数,需要从训练阶段学习而得。
定义特征函数:
其中,特征函数 fa(o,i) 的 个数 可以任意制定,(a=1,...,n)
所以总体上,MEMM的建模公式这样:
请务必注意,理解判别模型和定义特征两部分含义,这已经涉及到CRF的雏形了。
4.2.2 最大熵马尔科夫模型(MEMM) 如何解决 HMM 问题?
在前面介绍 HMM 时,HMM 提出了 观测节点 oi 依赖隐藏状态节点 ii 假设,该假设不合理的,针对该问题, MEMM 提出 观测节点 ii 依赖隐藏状态节点 oi 以及上一时刻的隐藏节点
ii−1
假设。(HMM 和 MEMM 箭头);
4.3 最大熵马尔科夫模型(MEMM)问题篇
问题简述
MEMM 容易出现标注偏置问题,MEMM倾向于选择拥有更少转移的状态。
问题介绍
用Viterbi算法解码MEMM,状态1倾向于转换到状态2,同时状态2倾向于保留在状态2。 解码过程细节(需要会viterbi算法这个前提):
但是得到的最优的状态转换路径是1->1->1->1,为什么呢?因为状态2可以转换的状态比状态1要多,从而使转移概率降低,即MEMM倾向于选择拥有更少转移的状态。
问题原因分析
对于MEMM公式:
求和的作用在概率中是归一化,但是这里归一化放在了指数内部,管这叫local归一化。 来了,viterbi求解过程,是用dp的状态转移公式(MEMM的没展开,请参考CRF下面的公式),因为是局部归一化,所以MEMM的viterbi的转移公式的第二部分出现了问题,导致dp无法正确的递归到全局的最优。
五、条件随机场(CRF)篇
5.1 CRF 动机篇
5.1.1 HMM 和 MEMM 存在什么问题?
•
HMM :状态的转移过程中当前状态只与前一状态相关问题
•
MEMM :标注偏置 问题
◦
解决方法:统计全局概率,在做归一化时考虑数据在全局的分布
5.2 CRF 介绍篇
5.2.1 什么是 CRF?
设X与Y是随机变量,P(Y|X)是给定条件X的条件下Y的条件概率分布,若随机变量Y构成一个由无向图G=(V,E)表示的马尔科夫随机场。则称条件概率分布P(X|Y)为条件随机场。
5.2.2 CRF 的 主要思想是什么?
统计全局概率,在做归一化时,考虑了数据在全局的分布。
5.2.3 CRF 的定义是什么?
给定 X=(x1,x2,...,xn) ,
Y=(y1,y2,...,yn)
均为线性链表示的随机变量序列,若在给随机变量序列 X 的条件下,随机变量序列 Y 的条件概率分布 P(Y|X) 构成条件随机场,即满足马尔可夫性:
则称为 P(Y|X) 为线性链条件随机场。
通过去除了隐马尔科夫算法中的观测状态相互独立假设,使算法在计算当前隐状态
xi
时,会考虑整个观测序列,从而获得更高的表达能力,并进行全局归一化解决标注偏置问题。
•
参数化形式
其中:
Z(x) 为归一化因子,是在全局范围进行归一化,枚举了整个隐状态序列
x1…n
的全部可能,从而解决了局部归一化带来的标注偏置问题。
tk 为定义在边上的特征函数,转移特征,依赖于前一个和当前位置
5.2.4 CRF 的 流程是什么?
选择特征模板:抽取文本中的字符组合 or 具有其他特殊意义的标记组成特征,作为当前 token 在模板中的表示;
构建特征函数:通过一组函数来完成由特征向数值转换的过程,使特征与权重对应;
进行前向计算:每个状态特征函数(0-1二值特征函数)对应 L 维向量,最终状态特征函数权值的和即为该位置上激活了的状态特征函数对应的 L 维向量之和;
解码:利用 维特比算法 解码 出 最优标注序列
5.3 CRF 优缺点篇
5.3.1 CRF 的 优点在哪里?
•
为每个位置进行标注过程中可利用丰富的内部及上下文特征信息;
•
CRF模型在结合多种特征方面的存在优势;
•
避免了标记偏置问题;
•
CRF的性能更好,对特征的融合能力更强;
5.3.2 CRF 的 缺点在哪里?
•
训练模型的时间比ME更长,且获得的模型非常大。在一般的PC机上可能无法执行;
•
特征的选择和优化是影响结果的关键因素。特征选择问题的好与坏,直接决定了系统性能的高低
5.4 CRF 复现?
代码块
Python
import numpy as np
class CRF(object):
'''实现条件随机场预测问题的维特比算法
'''
def __init__(self, V, VW, E, EW):
'''
:param V:是定义在节点上的特征函数,称为状态特征
:param VW:是V对应的权值
:param E:是定义在边上的特征函数,称为转移特征
:param EW:是E对应的权值
'''
六、对比篇
6.1 CRF模型 和 HMM和MEMM模型 区别?
•
相同点:MEMM、HMM、CRF 都常用于 序列标注任务;
•
不同点:
◦
与 HMM 的区别:CRF 能够解决 HMMM 因其输出独立性假设,导致其不能考虑上下文的特征,限制了特征的选择的问题;