Agent项目:0-1考拉王数据分析智能体Agent
AI实战丨数据分析Agent -- DataAgent
一、整体架构
从架构上,DataAgent 是一款基于 Agent 构建的、面向企业级复杂场景的“虚拟 AI 数据分析师”。
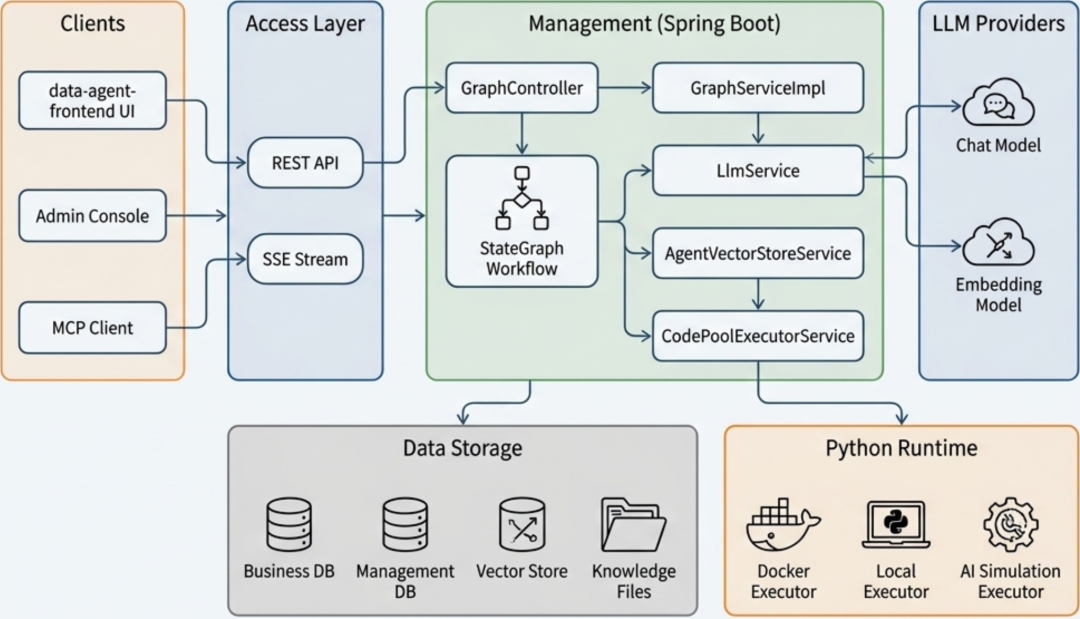
通过 Spring AI Alibaba Graph & Agent Framework 构建了一套具备自我规划、工具调用、反思纠错及人类干预能力的数据智能体(Agent)
二、项目实现
2.1 反馈机制 (Human-In-The-Loop)
•
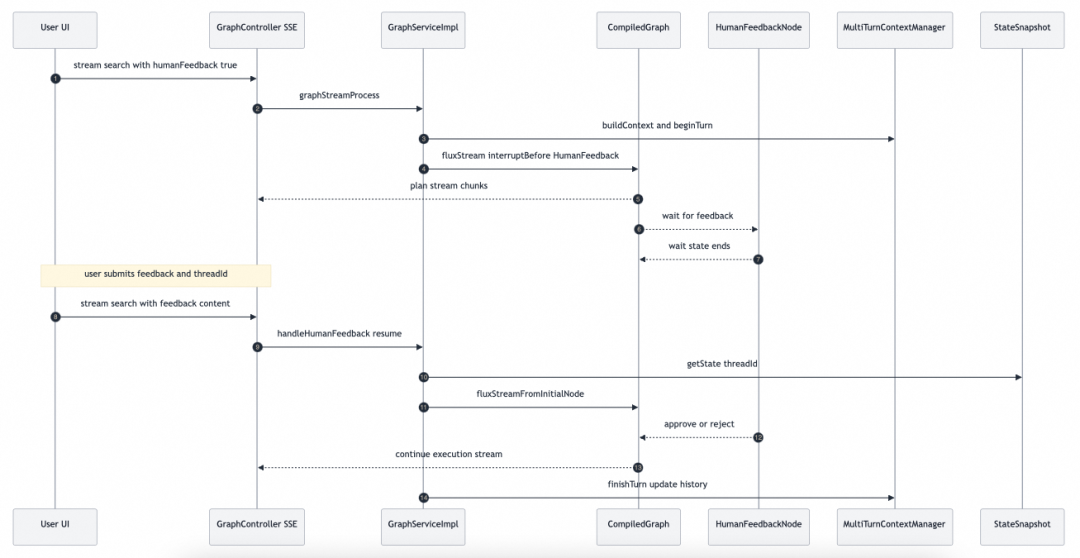
遇到问题:一个错误的执行计划可能瞬间拖垮生产库,甚至“一步错步步错”。
•
解决方案:
•
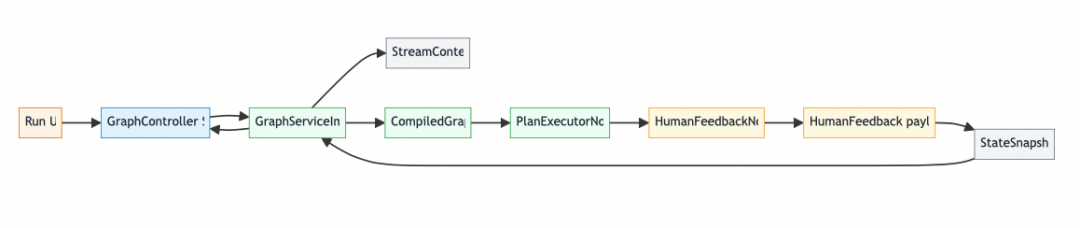
数据字段:agent.human_review_enabled 用于保存配置,运行时以请求参数为准。
•
图编排:PlanExecutorNode 检测 HUMAN_REVIEW_ENABLED。
46%
54%
2.2 Prompt 动态配置与自动优化
•
遇到问题:修改一句 Prompt 就要重启系统?不同模型对 Prompt 脾气不同,一套模板走天下根本行不通。
•
解决方案:
•
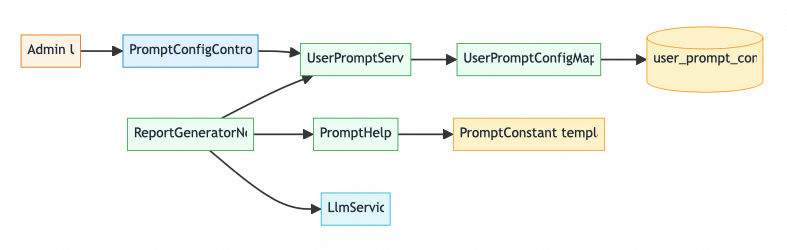
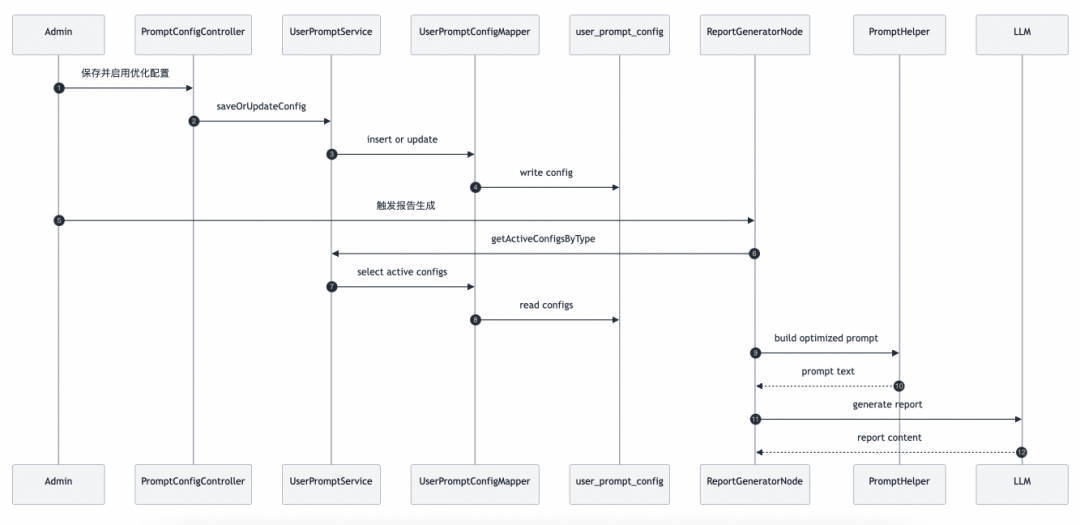
配置入口:/api/prompt-config/*,数据表 user_prompt_config。
•
作用范围:支持按 agentId 绑定或全局配置(agentId 为空)。
•
Prompt 类型:report-generator、planner、sql-generator、python-generator、rewrite。
•
自动优化方式:ReportGeneratorNode 拉取启用配置(按 priority 与 display_order 排序),
•
获得效果: 像配置 Excel 一样调优 AI。运维人员无需重启,即可让 DataAgent 瞬间从“菜鸟分析师”变身“首席架构师”。
2.3 深度 RAG 与混合检索增强
遇到问题:
•
纯向量检索常召回一堆废话?
•
AI 不认识你的业务缩写?
•
表结构太复杂,AI 搜不到。
•
解决方案:
•
查询重写:EvidenceRecallNode 将多轮上下文与用户问题组装为检索指令,调用 LLM 生成 standaloneQuery,避免上下文遗漏与歧义。
•
召回通道:AgentVectorStoreService 作为统一入口,默认走向量检索;开启混合检索后走 AbstractHybridRetrievalStrategy,将“向量召回 + 关键词召回”进行融合。(用户需要提供混合检索实现。当前默认只支持es)
•
召回过滤:DynamicFilterService 生成基于智能体与知识类型的过滤条件,限制检索范围,避免跨智能体串库。
•
获得效果: AI 拥有了老员工的“直觉”。它能秒懂你的业务逻辑,即便表名全是乱码,它也能精准命中。
2.4 容器化 Python 执行引擎
•
遇到问题:SQL 只能算数,不能预测。想看趋势图、做线性回归?SQL 此时显得苍白无力。
•
解决方案:
•
获得效果: 赋予 AI 科学家级的建模能力。不仅能提取数据,还能输出带图表、带算法、带深度预测的高质量产出。
50%
50%
2.5 流式输出 (SSE) 与多轮对话管理
•
遇到问题:分析任务耗时太长,用户盯着屏幕转圈
•
解决方案:
◦
流式输出:GraphController SSE + GraphServiceImpl 流式处理。
•
获得效果:极致的交互快感!让用户亲眼看到 AI 正在如何“思考”与“推演”,每一秒都有获得感。
2.6 MCP 服务器发布与多模型调度
•
遇到问题: DataAgent 虽好,但只能在自研系统用?想集成到 Claude 或 IDE?适配成本高到吓人。
•
解决方案:
•
MCP:McpServerService 提供 NL2SQL 与 Agent 列表工具,使用 Mcp Server Boot Starter。
•
多模型调度:ModelConfig 配置模型,AiModelRegistry 缓存当前 Chat/Embedding 模型并支持热切换(同一时间每类仅一个激活模型)。
•
已内置工具:nl2SqlToolCallback、listAgentsToolCallback。
2.7 多数据源接入
•
遇到问题:企业数据散落在 MySQL、PostgreSQL 等各类库中,跨库取数像是在做“情报搜集”,配置繁琐且标准不一。
解决方案:
•
元数据存储:数据源配置写入 datasource,智能体绑定写入 agent_datasource,选表写入 agent_datasource_tables,逻辑外键写入 logical_relation。
•
Schema 初始化:AgentDatasourceController 触发初始化,SchemaService 通过 AccessorFactory 拉取表/列/外键并写入向量库。
•
约束:同一智能体同一时间仅允许启用一个数据源(AgentDatasourceService.toggleDatasourceForAgent)。
•
获得效果:一个智能体,纵览全司数据!无论数据在哪儿,DataAgent 都能精准“路由”。它是数据孤岛的终结者,让跨库分析像查询单表一样简单。
2.8 报告生成与摘要建议
•
遇到问题: 查出来一堆数字有什么用?领导要的是洞察,是结论,是能直接发在群里的 HTML 报告。
•
解决方案:
•
报告节点:ReportGeneratorNode 读取计划、SQL/Python 结果与摘要建议(summary_and_recommendations)。
•
输出格式:默认 HTML,plainReport=true 输出 Markdown(简洁报告)。
•
获得效果:把分析师的一天缩短为 10 秒。从查数到成稿,DataAgent 承包了所有体力活,让你只负责最后的一锤定音。
2.9 NL2SQL 转换, 语义模型,逻辑外键引擎
•
遇到问题: 纯大模型写 SQL 经常“盲目自信”,不是字段写错,就是不懂业务术语。语法错误导致的执行中断更是家常便饭。
•
解决方案:
•
语义模型层:通过管理端定义的术语映射规则,在生成阶段强制约束。
•
两阶段校验:SqlGenerateNode 生成后接 SemanticConsistencyNode 检查语义一致性。
•
自愈循环:SqlExecuteNode 捕获执行错误并反馈给 Graph 状态机,触发重定向至重写节点进行纠错。
•
逻辑外键:写入外部业务逻辑,不写入业务数据库。增强对表的理解能力。
2.10 API Key 与权限管理
•
遇到问题:接口裸奔?权限失控?想对外开放能力却怕费用爆炸或数据泄露。
•
解决方案:
•
数据字段:agent.api_key 与 agent.api_key_enabled。
•
调用方式:请求头 X-API-Key。
获得效果:
•
生产级安全防护。
•
让 DataAgent 不仅是业务利器,
•
更是安全可控的企业级数字资产。
💡
在企业数据分析的复杂生态中,指标作为衡量业务表现的关键标尺,其语义的清晰界定与统一理解至关重要。然而,现实情况却常常不尽如人意,不同部门、不同业务场景下,同一指标名称可能蕴含着截然不同的计算逻辑与含义。
指标语义层的横空出世,恰如一座明亮的灯塔,驱散了这片语义迷雾,为 Agent 与数据使用者之间搭建起畅通无阻的沟通桥梁。它通过建立一套统一、规范的指标定义体系,确保无论在何种业务语境下,相同指标名都对应着唯一、精确的计算口径与业务含义。
💡
不妨对比一下有无指标语义层时的场景差异。在没有指标语义层的情况下,当业务人员向 Agent 提出 “查询本月各地区的销售额” 这样看似简单的需求时,Agent 可能会陷入迷茫。
因为它无法确定业务人员所指的 “销售额” 究竟遵循哪种计算逻辑,是电商部门的净销售额,还是财务部门的总销售额,亦或是其他特定业务规则下的定义。这可能导致 Agent 返回错误的数据结果,或者因无法理解需求而无法给出有效回应,使得业务人员不得不花费额外的时间与精力去解释、澄清需求,严重影响工作效率。
而当指标语义层就位后,情况则截然不同。指标语义层就像一本详尽的词典,将每个指标的名称、定义、计算方式、数据来源等关键信息进行了标准化封装。Agent 接收到业务人员的查询指令后,能够迅速在指标语义层中查找 “销售额” 的精准定义,明确其对应的计算规则与数据来源。它可以直接关联到相应的底层数据表与计算逻辑,快速执行准确的数据查询与分析任务,为业务人员提供符合其预期的、可靠的数据分析结果,如一张清晰呈现本月各地区按照统一标准计算的销售额对比图表,助力业务决策的高效制定。
搭建物流智能体的技术流
(一)数据层
▪
数据收集:从多个数据源收集物流相关数据,包括订单数据(客户信息、货物信息、配送地址等)、运输数据(车辆信息、行驶轨迹、运输时间等)、仓储数据(库存水平、货物出入库记录等)、地理信息数据(地图、路况等)。
代码编写
路径规划代码(使用Python和NetworkX库实现Dijkstra算法来计算最短路径)
代码块
Python
import networkx as nx
# 创建图对象
G = nx.Graph()
# 添加节点和边(节点表示地点,边的权重表示距离)
G.add_edge('A', 'B', weight=5)
G.add_edge('A', 'C', weight=3)
G.add_edge('B', 'C', weight=1)
G.add_edge('B', 'D', weight=2)
G.add_edge('C', 'D', weight=4)
库存需求预测代码(使用Python和Scikit-learn库中的线性回归模型)
代码块
Python
import numpy as np
from sklearn.linear_model import LinearRegression
# 生成模拟数据(时间序列数据)
X = np.array([[1], [2], [3], [4], [5]]) # 时间步长
y = np.array([10, 12, 15, 18, 20]) # 库存需求
# 创建线性回归模型并训练
model = LinearRegression()
model.fit(X, y)
# 预测下一个时间步的库存需求
next_time_step = np.array([[6]])
predicted_demand = model.predict(next_time_step)
print("预测的下一个时间步库存需求:", predicted_demand[0])
数据指标语义理解与转换代码
代码块
Python
# 定义数据指标和标签的语义映射字典
semantic_mapping = {
"total_sales": "销售总额",
"net_profit": "净利润",
"customer_acquisition_cost": "客户获取成本",
"churn_rate": "客户流失率"
}
多任务数据分析调度代码
代码块
Python
import concurrent.futures
# 模拟三个数据分析任务函数
def task1():
# 模拟任务 1 的数据分析操作,这里简单返回一个固定结果
return "Task 1 result: Data analysis for sales trends completed."
def task2():
# 模拟任务 2 的数据分析操作,比如分析客户行为数据
customer_data = [{"id": 1, "behavior": "purchase"}, {"id": 2, "behavior": "browse"}]
purchase_count = sum(1 for c in customer_data if c["behavior"] == "purchase")
return f"Task 2 result: {purchase_count} customers made purchases."
基于用户反馈的数据分析模型优化代码
代码块
Python
# 模拟初始的数据分析模型(简单的线性回归模型)
import numpy as np
from sklearn.linear_model import LinearRegression
# 模拟训练数据
X = np.array([[1], [2], [3], [4], [5]])
y = np.array([2, 4, 6, 8, 10])
# 创建并训练初始模型
分析产品在不同地区、不同时间段的用户活跃度数据代码
代码块
Python
import matplotlib.pyplot as plt
import pandas as pd
# 假设数据已存储为DataFrame格式,名为user_activity_data
# 包含 columns: ['region', 'date', 'active_users']
# 按照地区分组
grouped_data = user_activity_data.groupby('region')
for region, group in grouped_data:
对于高阶计算任务,如利用机器学习算法进行用户行为预测、基于时间序列分析进行销售趋势预测等
代码块
Python
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
import numpy as np
# 假设历史销售数据存储为DataFrame格式,名为sales_data
# 包含 columns: ['month', 'sales_volume']
# 提取特征与目标变量
X = sales_data[['month']].values
y = sales_data['sales_volume'].values
# 划分训练集与测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 训练线性回归模型
智能体搭建的要点
(一)数据质量和整合
▪
确保数据的准确性、完整性和一致性,对收集到的数据进行清洗、预处理和标准化。
▪
整合来自不同数据源的数据,解决数据格式不一致、语义模糊等问题,以便后续的分析和处理。
(二)算法选择和优化
搭建物流智能体需要综合运用多种技术和方法,并结合实际业务需求进行不断优化和完善。希望以上介绍能够帮助你对物流智能体的搭建有一个全面的了解。