机器学习
机器学习算法可以分为监督学习、无监督学习、强化学习等类别。
监督学习算法:
•
线性回归(Linear Regression):用于回归任务,预测连续的数值。
•
逻辑回归(Logistic Regression):用于二分类任务,预测类别。
•
支持向量机(SVM):用于分类任务,构建超平面进行分类。
•
决策树(Decision Tree):基于树状结构进行决策的分类或回归方法。
无监督学习算法:
•
K-means 聚类:通过聚类中心将数据分组。
•
主成分分析(PCA):用于降维,提取数据的主成分。
每种算法都有其适用的场景,在实际应用中,可以根据数据的特征(如是否有标签、数据的维度等)来选择最合适的机器学习算法。
#zyAUKRJhhvqF text { white-space: pre; }#zyAUKRJhhvqF .fb0 { stroke: var(--N900-FG, 0.15); }#zyAUKRJhhvqF .fb0 {stroke: rgba(31,35,41, 0.15)}#zyAUKRJhhvqF .fx0 { stroke-miterlimit: 10; }#zyAUKRJhhvqF .fx0 {stroke-miterlimit: 10}#zyAUKRJhhvqF .fa1 { fill: rgb(187, 191, 196); }#zyAUKRJhhvqF .fa1 {fill: rgb(187, 191, 196)}#zyAUKRJhhvqF .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#zyAUKRJhhvqF .fx1 {font-style: normal}#zyAUKRJhhvqF .fx2 { text-anchor: middle; }#zyAUKRJhhvqF .fx2 {text-anchor: middle}#zyAUKRJhhvqF .fx3 { dominant-baseline: central; }#zyAUKRJhhvqF .fx3 {dominant-baseline: central}#zyAUKRJhhvqF .fx4 { stroke: none; }#zyAUKRJhhvqF .fx4 {stroke: none}#zyAUKRJhhvqF .fc0 { fill: var(--text-caption); }#zyAUKRJhhvqF .fc0 {fill: #646a73}#zyAUKRJhhvqF .fa2 { fill: var(--text-link-disabled); }#zyAUKRJhhvqF .fa2 {fill: rgb(187, 191, 196)}#zyAUKRJhhvqF .fa3 { fill: rgb(59, 58, 56); }#zyAUKRJhhvqF .fa3 {fill: rgb(59, 58, 56)}#zyAUKRJhhvqF .fx5 { font: 700 14px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#zyAUKRJhhvqF .fx5 {font-style: normal}#zyAUKRJhhvqF .fx6 { text-anchor: start; }#zyAUKRJhhvqF .fx6 {text-anchor: start}#zyAUKRJhhvqF .fx7 { dominant-baseline: alphabetic; }#zyAUKRJhhvqF .fx7 {dominant-baseline: alphabetic}#zyAUKRJhhvqF .fc1 { fill: rgb(255, 255, 255); }#zyAUKRJhhvqF .fc1 {fill: rgb(255, 255, 255)}#zyAUKRJhhvqF .fc2 { fill: rgb(51, 51, 51); }#zyAUKRJhhvqF .fc2 {fill: rgb(51, 51, 51)}#zyAUKRJhhvqF .fx8 { font: 400 14px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#zyAUKRJhhvqF .fx8 {font-style: normal}#zyAUKRJhhvqF .fb1 { fill: var(--N900-FG, 0.15); }#zyAUKRJhhvqF .fb1 {fill: rgba(31,35,41, 0.15)}#zyAUKRJhhvqF .fb2 { fill: rgb(212, 212, 212); }#zyAUKRJhhvqF .fb2 {fill: rgb(212, 212, 212)}#zyAUKRJhhvqF .fb3 { fill: rgb(232, 234, 246); }#zyAUKRJhhvqF .fb3 {fill: rgb(232, 234, 246)}#zyAUKRJhhvqF .fa4 { fill: var(--bg-body); }#zyAUKRJhhvqF .fa4 {fill: #fff}ABCDEF12345678910111213分类维度类别核心定义典型算法核心优缺点适用场景学习方式任务目标模型结构监督学习无监督学习半监督学习强化学习分类算法回归算法聚类算法降维算法线性模型树模型神经网络模型概率模型用带标签数据学习输入到输出的映射用无标签数据挖掘数据内在规律结合少量标签数据和大量无标签数据训练模型通过与环境交互,以奖励信号优化策略预测离散的类别标签预测连续的数值输出无标签下将相似数据归为一类减少特征维度,保留核心信息假设输入与输出为线性关系基于决策树构建,处理非线性关系多层神经元结构,自动提取复杂特征基于概率统计理论,计算概率分布逻辑回归、SVM、决策树、CNN、LSTMK-Means、PCA、DBSCAN、自编码器半监督SVM、标签传播算法Q-Learning、DQN、PPO逻辑回归、随机森林、CNN线性回归、岭回归、XGBoostK-Means、层次聚类、DBSCANPCA、t-SNE、LDA线性回归、逻辑回归、岭回归决策树、随机森林、XGBoost、LightGBMANN、CNN、RNN、Transformer朴素贝叶斯、隐马尔可夫模型优点:预测精度高;缺点:依赖高质量标注数据优点:无需标注;缺点:结果可解释性弱优点:降低标注成本;缺点:模型设计复杂优点:适配动态决策;缺点:训练周期长优点:适配分类场景;缺点:对类别不平衡敏感优点:输出连续值;缺点:对异常值敏感优点:自动分群;缺点:聚类效果依赖距离度量优点:降低计算成本;缺点:可能丢失部分信息优点:可解释性强、训练快;缺点:难以拟合非线性关系优点:无需特征归一化;缺点:树过深易过拟合优点:拟合复杂关系;缺点:需大量数据和算力优点:理论基础扎实;缺点:依赖强假设分类、回归、图像识别、文本翻译数据聚类、降维、异常检测、用户分群医疗影像分析、小众语种NLP游戏AI、机器人控制、推荐策略优化垃圾邮件识别、图像分类、疾病诊断房价预测、销量预测、温度预测市场细分、用户画像、异常检测高维数据可视化、特征预处理简单分类回归、基线模型搭建工业级分类回归、竞赛级任务图像识别、NLP、语音合成文本分类、语音识别、序列标注
监督学习算法
线性回归(Linear Regression)
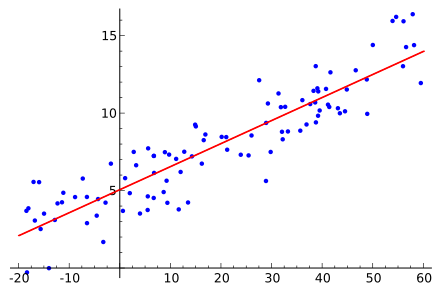
线性回归是一种用于回归问题的算法,它通过学习输入特征与目标值之间的线性关系,来预测一个连续的输出。
应用场景:预测房价、股票价格等。
线性回归的目标是找到一个最佳的线性方程:
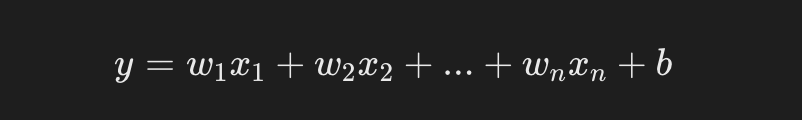
•
y 是预测值(目标值)。
•
x(1),x(2),x(n) 是输入特征。
•
w(1),w(2),w(n)是待学习的权重(模型参数)。
•
b 是偏置项。
接下来我们使用 sklearn 进行简单的房价预测:
实例
代码块
Python
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
import pandas as pd
输出结果为:
代码块
Plain Text
预测的房价: [180.8411215]
逻辑回归(Logistic Regression)
逻辑回归是一种用于分类问题的算法,尽管名字中包含"回归",它是用来处理二分类问题的。
逻辑回归通过学习输入特征与类别之间的关系,来预测一个类别标签。
应用场景:垃圾邮件分类、疾病诊断(是否患病)。
逻辑回归的输出是一个概率值,表示样本属于某一类别的概率。
通常使用 Sigmoid 函数:
使用逻辑回归进行二分类任务:
实例
代码块
Python
from sklearn.linear_model import LogisticRegression
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 加载鸢尾花数据集
iris = load_iris()
X = iris.data
y = iris.target
# 只取前两类做二分类任务
输出结果为:
代码块
Plain Text
分类准确率: 1.00
支持向量机(SVM)
支持向量机是一种常用的分类算法,它通过构造超平面来最大化类别之间的间隔(Margin),使得分类的误差最小。
应用场景:文本分类、人脸识别等。
使用 SVM 进行鸢尾花分类任务:
实例
代码块
Python
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 加载鸢尾花数据集
iris = load_iris()
输出结果为:
代码块
Plain Text
决策树(Decision Tree)
决策树是一种基于树结构进行决策的分类和回归方法。它通过一系列的"判断条件"来决定一个样本属于哪个类别。
应用场景:客户分类、信用评分等。
使用决策树进行分类任务:
实例
代码块
Python
from sklearn.tree import DecisionTreeClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 加载鸢尾花数据集
输出结果为:
代码块
Plain Text
无监督学习算法
K-means 聚类(K-means Clustering)
K-means 是一种基于中心点的聚类算法,通过不断调整簇的中心点,使每个簇中的数据点尽可能靠近簇中心。
应用场景:客户分群、市场分析、图像压缩。
使用 K-means 进行客户分群:
实例
代码块
Python
from sklearn.cluster import KMeans
输出的图如下所示:
主成分分析(PCA)
PCA 是一种降维技术,它通过线性变换将数据转换到新的坐标系中,使得大部分的方差集中在前几个主成分上。
应用场景:图像降维、特征选择、数据可视化。
使用 PCA 降维并可视化高维数据:
实例
代码块
Python
from sklearn.decomposition import PCA
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
# 加载鸢尾花数据集
iris = load_iris()
X = iris.data
y = iris.target
输出的图如下所示:
机器学习算法