Agent项目:智谱智能问答系统
一、智谱智能问答系统概述
🔍智能问答系统 Open-AutoGLM 是由智谱AI推出的一款开源自动化语言模型框架,旨在降低大模型在实际场景中的使用门槛,提升任务执行效率与智能化水平。该框架融合了自然语言理解、任务分解、工具调用与自我反馈机制,支持在无需人工干预的情况下完成复杂指令的解析与执行。
💡核心特性:
🌀
支持多轮对话中的任务自动拆解与规划;
内置丰富的工具接口,可扩展连接数据库、API、代码解释器等外部系统;
具备自我评估与纠错能力,提升输出结果的准确性
快速部署示例:
代码块
Python
# 安装依赖包
pip install open-autoglm
# 启动本地推理服务
from autoglm import AutoGLM
agent = AutoGLM(model_name="glm-4-plus") # 指定使用的基础模型
response = agent.run("请分析过去三个月的销售趋势,并生成可视化图表")
print(response)
# 执行逻辑:模型接收指令 → 自动拆解为数据查询和绘图两个子任务 → 调用对应工具执行 → 汇总结果返回
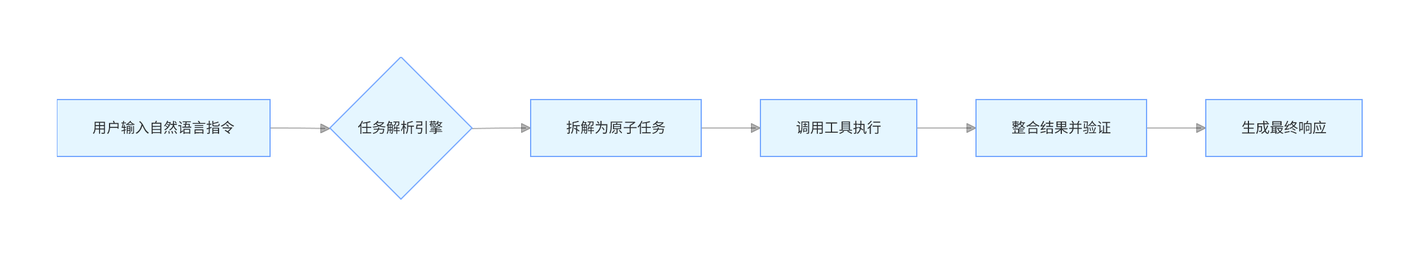
典型应用场景对比:
二、Open-AutoGLM核心技术解析
2.1 自研大模型架构与GLM 技术演进
架构设计理念:
🌀
自研大模型采用通用语言模型(GLM)架构,融合双向注意力与前缀语言建模,在训练效率与上下文理解之间实现平衡。通过层次化模块设计,支持从亿级到千亿参数的灵活扩展。
关键技术演进:
GLM 技术持续迭代,主要体现在以下方面:
🌀
稀疏注意力机制优化长序列处理
混合精度训练提升计算效率
动态批处理增强 GPU 利用率
代码块
YAML

该函数生成下三角掩码,确保自回归特性。其中 torch.tril 保留主对角线及以下元素,实现单向信息流动控制。
性能对比分析:
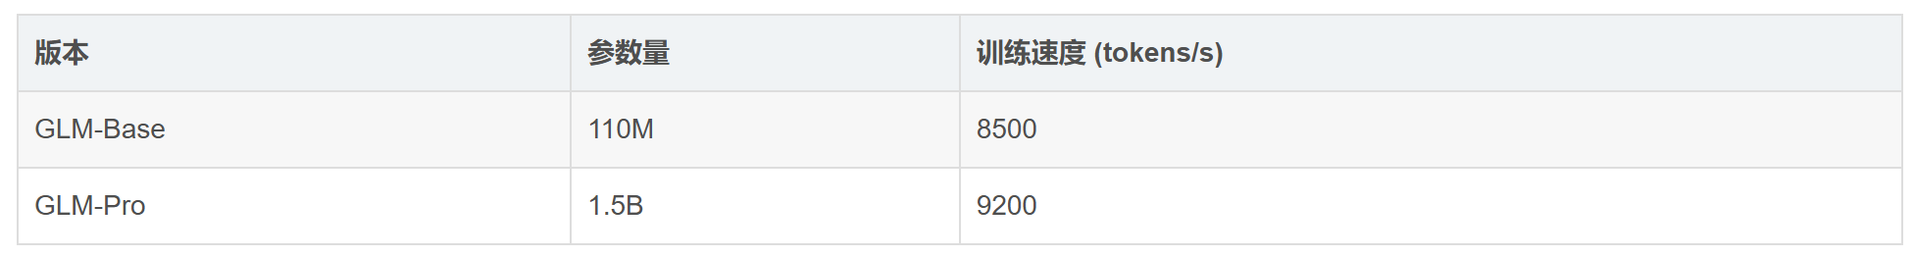
2.2 多模态 理解与知识增强机制
跨模态语义对齐
多模态理解的核心在于将不同模态(如文本、图像、音频)映射到统一的语义空间。通过共享嵌入层,模型可实现跨模态信息融合。例如,使用Transformer结构联合编码图文输入:
代码块
Python
# 图文联合编码示例
def forward(self, text_input, image_input):
text_emb = self.text_encoder(text_input) # 文本编码
image_emb = self.image_encoder(image_input) # 图像编码
joint_emb = torch.cat([text_emb, image_emb], dim=-1)
return self.cross_modal_transform(joint_emb) # 跨模态融合
该结构通过拼接与线性变换实现初步对齐,关键参数为嵌入维度与融合层数,影响语义交互深度。
知识图谱增强推理
引入外部知识图谱提升模型推理能力,通过实体链接与关系注入补充上下文信息。
🌀
常用策略包括:
•
实体对齐:将输入中提及的实体匹配至知识库节点
•
子图检索:提取相关三元组构建局部知识子图
•
图神经网络融合:利用GNN传播知识信息至模型输出
2.3 高效推理优化与低延迟响应设计
模型轻量化与算子融合
🌀
为提升推理效率,采用模型剪枝、量化与知识蒸馏技术,在保持精度的同时显著降低计算负载。现代推理框架如TensorRT支持自动算子融合,将多个小算子合并为单一内核调用,减少GPU调度开销。
代码块
YAML
上述代码启用半精度浮点运算,有效提升吞吐量并减少显存占用,适用于对精度损失容忍度较高的场景。
异步批处理与流水线调度
通过动态批处理(Dynamic Batching)聚合多个请求,提高硬件利用率。结合异步I/O与多级缓冲队列,实现计算与数据传输重叠,降低端到端延迟。
2.4 企业数据安全与隐私保护策略
数据分类与访问控制
企业应根据数据敏感性实施分级管理,常见分为公开、内部、机密和绝密四级。通过角色基础访问控制(RBAC),确保最小权限原则。
🌀
识别核心数据资产(如客户信息、财务记录)
定义访问角色与权限矩阵
定期审计权限分配与使用日志
加密传输与存储
所有敏感数据在传输过程中必须启用TLS 1.3以上协议。存储阶段采用AES-256加密,并结合密钥管理系统(KMS)实现动态密钥轮换。
代码块
Go
// 示例:Go中使用crypto库进行AES加密
block, _ := aes.NewCipher(key)
gcm, _ := cipher.NewGCM(block)
nonce := make([]byte, gcm.NonceSize())
if _, err := io.ReadFull(rand.Reader, nonce); err != nil {
panic(err)
}
encrypted := gcm.Seal(nonce, nonce, plaintext, nil)
上述代码生成随机nonce并执行AEAD加密,确保数据完整性和机密性。key需由KMS托管,避免硬编码。
2.5 实战:搭建本地化模型推理环境
环境准备与依赖安装
搭建本地推理环境首先需要配置Python运行时及核心依赖库。推荐使用虚拟环境隔离项目依赖:
代码块
YAML
python -m venv llm-env
source llm-env/bin/activate # Linux/Mac
pip install torch transformers accelerate onnxruntime
上述命令创建独立Python环境并安装主流推理框架。其中,transformers 提供模型接口,accelerate 支持多设备推理调度,onnxruntime 可提升推理性能。
加载本地模型进行推理
以Hugging Face的BERT模型为例,实现文本分类推理:
代码块
Python
🌀
代码首先加载本地存储的分词器和模型,将输入文本编码为张量后执行前向传播,最终获取预测类别。return_tensors="pt" 指定输出PyTorch张量格式。
第三章:智能问答系统构建原理
3.1 问答系统的主流架构与技术选型
现代问答系统通常采用检索增强生成(RAG)或端到端神经网络架构。RAG结合了信息检索与语言生成模型,先从知识库中检索相关文档,再由生成模型构造答案。
典型RAG流程示例
代码块
YAML
# 伪代码:RAG架构中的推理过程
上述流程中,DenseRetriever 使用向量相似度匹配候选文档,T5Generator 基于上下文生成自然语言回答,兼顾准确性与流畅性。
技术选型对比
3.2 基于Open-AutoGLM的语义理解实现
模型初始化与配置
在集成Open-AutoGLM时,首先需加载预训练模型并配置推理参数。以下为初始化代码示例:
代码块
YAML
from openautoglm import AutoSemanticModel
model = AutoSemanticModel.from_pretrained(
"openautoglm-base",
device="cuda",
max_seq_length=512
)
该代码加载基础版本模型,指定使用GPU加速,并限制最大序列长度以平衡性能与精度。
语义解析流程
模型接收自然语言输入后,自动执行分词、向量编码与意图识别。其处理流程如下:
🌀
输入文本标准化(去除噪声、统一编码)
基于BPE算法进行子词切分
3.3 实战:从零构建一个行业问答原型
环境准备与技术选型
本系统基于Python Flask构建轻量级Web服务,结合Sentence-BERT实现语义匹配。依赖库包括flask、transformers和faiss,用于高效向量检索。
代码块
Python
from sentence_transformers import SentenceTransformer
import faiss
import numpy as np
# 加载预训练模型
该代码加载多语言Sentence-BERT模型,将行业术语与用户问题编码为768维向量,便于后续相似度计算。
核心流程设计
系统工作流如下:
加载行业知识库(FAQ文本对)
批量生成问题向量并存入FAISS索引
接收用户输入,编码后检索Top-3最相似问题
返回对应答案及匹配分数
第四章:企业级应用落地实践
4.1 金融领域智能客服集成方案
在金融行业,智能客服需兼顾响应效率与数据安全。系统通常采用微服务架构,通过API网关统一接入客户请求,并结合身份鉴权、会话加密等机制保障通信安全。
核心集成流程:
•
用户通过Web或App发起咨询请求
•
请求经API网关路由至智能客服引擎
•
自然语言理解模块解析意图并调用业务接口
•
返回结构化数据生成自然语言回复
关键代码示例:
代码块
Python
def authenticate_request(token: str) -> bool:
# 验证JWT令牌合法性
try:
payload = jwt.decode(token, SECRET_KEY, algorithms=['HS256'])
return payload.get('role') == 'customer'
except jwt.ExpiredSignatureError:
return False
该函数用于验证客户端传入的JWT令牌是否有效,确保仅授权用户可访问敏感金融服务接口,SECRET_KEY为系统级密钥,防止篡改。
性能监控指标
4.2 制造业设备运维问答系统部署
在制造业场景中,设备运维问答系统的部署需兼顾实时性与稳定性。系统通常采用微服务架构,通过Kubernetes进行容器编排,确保高可用与弹性伸缩。
服务部署配置示例
代码块
YAML
apiVersion: apps/v1
kind: Deployment
metadata:
name: maintenance-qa-service
spec:
replicas: 3
selector:
matchLabels:
app: qa-engine
上述YAML定义了问答引擎的Kubernetes部署配置,设置3个副本保障容灾,通过环境变量注入数据库连接地址,实现配置与镜像解耦。
核心组件依赖
•
NLP解析引擎:负责语义理解与意图识别
•
知识图谱存储:基于Neo4j构建设备故障库
•
API网关:统一接入认证与流量控制
4.3 医疗健康场景下的合规性适配
在医疗健康系统中,数据合规性是核心要求,尤其需满足《HIPAA》和《GDPR》对患者隐私的严格规定。系统设计必须确保敏感信息的加密存储与传输。
数据脱敏处理策略
采用字段级加密与匿名化技术,对患者身份信息进行不可逆处理。例如,在日志输出前执行脱敏逻辑:
代码块
Go
func sanitizePatientData(log string) string {
re := regexp.MustCompile(`\b\d{9}\b`) // 匹配9位患者ID
return re.ReplaceAllString(log, "XXX-XX-XXXX")
}
该函数识别并替换原始患者标识符,防止PII(个人身份信息)泄露,正则表达式精准匹配特定格式ID,确保脱敏一致性。
访问控制矩阵
通过角色权限表实现最小权限原则:
4.4 实战:性能压测与高可用架构调优
在高并发系统中,性能压测是验证架构稳定性的关键环节。通过模拟真实流量,可精准识别系统瓶颈。
压测工具选型与参数配置
使用 wrk 进行 HTTP 压力测试,具备高并发和低资源消耗优势:
代码块
YAML
wrk -t12 -c400 -d30s --script=POST.lua http://api.example.com/v1/order
可用调优策略
•
引入 Nginx 动态负载均衡,支持权重轮询与故障自动剔除
•
数据库主从复制 + 读写分离,降低单点压力
•
Redis 集群分片,提升缓存吞吐能力
•
结合监控指标(如 P99 延迟、错误率)动态调整线程池与连接池大小,实现服务自适应伸缩。
第五章:未来展望与生态发展
随着云原生技术的不断演进,Kubernetes 已成为构建现代应用平台的核心。未来,其生态将向更智能、更轻量、更安全的方向发展。服务网格与 Serverless 架构将进一步融合,提升资源利用率和部署效率。
边缘计算的深度集成
在工业物联网场景中,Kubernetes 正通过 K3s 等轻量化发行版向边缘延伸。以下是一个典型的边缘节点部署配置示例:
代码块
YAML
apiVersion: apps/v1
kind: Deployment
metadata:
name: edge-sensor-collector
spec:
replicas: 3
selector:
多运行时架构的兴起
未来的应用平台将不再局限于容器运行时,而是支持 WebAssembly、函数运行时、AI 推理引擎等多类型工作负载共存。这种趋势推动了 CRI、CNI 和 CSI 插件生态的繁荣。
•
WebAssembly 模块可在 Istio Sidecar 中直接执行,实现毫秒级冷启动
•
OpenFunction 利用 Dapr 构建事件驱动的异构工作流
•
机密计算支持如 Intel SGX 容器已在金融合规场景落地
自动化运维的实践路径