04-Locate-Anything视觉语言定位
04-Locate Anything:把自然语言变成机器人可用的视觉定位框
Locate Anything 是 NVIDIA 发布的视觉语言定位模型。它解决的问题很直接:给一张图和一句自然语言,让模型输出目标的 2D box 或 point。对具身智能来说,它不是 VLA 策略,也不是抓取规划器,而是一个很适合接在 VLA、SAM、深度估计和抓取模块前面的语言条件感知前端。
学完这一章后,大家可以完成三件事:
•
在本地下载并跑通 nvidia/LocateAnything-3B。
•
用同一张图对比 Locate Anything 与 YOLO26n 的输出和速度。
•
理解它为什么要做 Parallel Box Decoding,以及它在机器人链路里该放在哪一层。
本章把环境、模型权重和运行输出都放到大盘目录 $DATA_ROOT,教程仓库只保留 Markdown 和轻量结果图。模型权重、HF cache、pip cache 和运行日志不要提交到仓库。
一、它适合放在具身系统的哪一层
Locate Anything 的输入是图像和文本,输出是类似下面的结构化文本:
代码块
Plain Text
bus
坐标是 0 到 1000 的归一化整数,后处理时再映射回原图像素。它适合做:
| | |
| | |
| | |
| | |
| | |
它不直接输出 6D pose、grasp pose、接触状态、路径规划或闭环控制信号。如果大家要把它用于机械臂抓取,更合理的链路是:
代码块
Plain Text
flowchart LR
A["RGB 图像 + 语言任务"] --> B["Locate Anything
box / point"]
B --> C["SAM / SAM2
mask"]
B --> D["Depth / RGB-D
深度"]
C --> E["2D mask + 深度融合"]
D --> E
E --> F["3D 点云 / 目标中心"]
F --> G["抓取检测 / 位姿估计 / VLA policy"]
二、本机验证环境
本章在下面环境中跑通:
| |
| |
| |
| |
| |
| |
| |
本机 smoke test 没有安装 flash_attn 或 MagiAttention,日志中可以看到模型自动 fallback 到 PyTorch SDPA:
代码块
Plain Text
flash_attn is not available for MoonViT inference; falling back to sdpa.
因此,本章速度只是“基础环境可跑通”的记录,不是官方峰值 benchmark。官方 README 报告 Locate Anything-3B 在单张 H100 上 Hybrid Mode 达到 12.7 BPS;本章本机则是在 SDPA fallback、并且 GPU 上还有其他任务时测得。
三、环境与模型准备
先定义几个目录。大家可以把 $DATA_ROOT 换成自己的大盘路径;不要把模型权重放进教程仓库。
代码块
Bash
export DATA_ROOT=/path/to/large_disk/locate-anything
export ENV_ROOT=/path/to/large_disk/envs/locate-anything
export HF_HOME=/path/to/large_disk/cache/huggingface
export PIP_CACHE_DIR=/path/to/large_disk/cache/pip
export UV_CACHE_DIR=/path/to/large_disk/cache/uv
export TORCH_EXTENSIONS_DIR=/path/to/large_disk/cache/torch_extensions
mkdir -p "$DATA_ROOT" "$HF_HOME" "$PIP_CACHE_DIR" "$UV_CACHE_DIR" "$TORCH_EXTENSIONS_DIR"
如果和本机一样使用 /data/Data14TB 作为大盘,可以这样设置:
代码块
Bash
export DATA_ROOT=/data/Data14TB/01Proj/locate-anything
export ENV_ROOT=/data/Data14TB/envs/locate-anything
export HF_HOME=/data/Data14TB/cache/huggingface
export PIP_CACHE_DIR=/data/Data14TB/cache/pip
export UV_CACHE_DIR=/data/Data14TB/cache/uv
export TORCH_EXTENSIONS_DIR=/data/Data14TB/cache/torch_extensions
克隆官方仓库:
代码块
Bash
cd "$DATA_ROOT"
git clone --depth 1 https://github.com/NVlabs/Eagle.git
cd "$DATA_ROOT/Eagle/Embodied"
创建 Python 3.11 环境:
代码块
Bash
uv venv "$ENV_ROOT" --python 3.11
"$ENV_ROOT/bin/python" -m ensurepip --upgrade
"$ENV_ROOT/bin/python" -m pip install --upgrade pip wheel setuptools
安装 PyTorch CUDA 12.8 轮子。本机 Driver 显示 CUDA 13.0,但 cu128 wheel 可以正常运行:
代码块
Bash
"$ENV_ROOT/bin/python" -m pip install torch torchvision \
--index-url https://download.pytorch.org/whl/cu128
验证 CUDA:
代码块
Bash
本机输出:
代码块
Plain Text
torch 2.11.0+cu128
cuda available True
cuda version 12.8
device NVIDIA RTX PRO 6000 Blackwell Workstation Edition
安装 Locate Anything 依赖:
代码块
Bash
cd "$DATA_ROOT/Eagle/Embodied"
"$ENV_ROOT/bin/python" -m pip install -e .
官方项目的关键依赖包括 transformers==4.57.1、tokenizers==0.22.0、deepspeed==0.15.4、accelerate==1.5.2、timm>=1.0.11、liger_kernel==0.3.1、peft==0.12.0 和 decord。
下载模型:
代码块
Bash
export MODEL_DIR="$DATA_ROOT/models/LocateAnything-3B"
mkdir -p "$DATA_ROOT/models"
"$ENV_ROOT/bin/hf" download nvidia/LocateAnything-3B \
--local-dir "$MODEL_DIR"
本机下载后模型目录约 7.3GB,其中两个主要权重文件为:
代码块
Plain Text
如果下载中断,重新运行同一条 hf download 命令即可断点续传。
四、Locate Anything smoke test
我们先用 Ultralytics 官方示例图 bus.jpg 做 smoke test,便于后面和 YOLO26 对比。
代码块
Bash
export IMAGE_PATH="$DATA_ROOT/bus.jpg"
curl -L https://ultralytics.com/images/bus.jpg -o "$IMAGE_PATH"
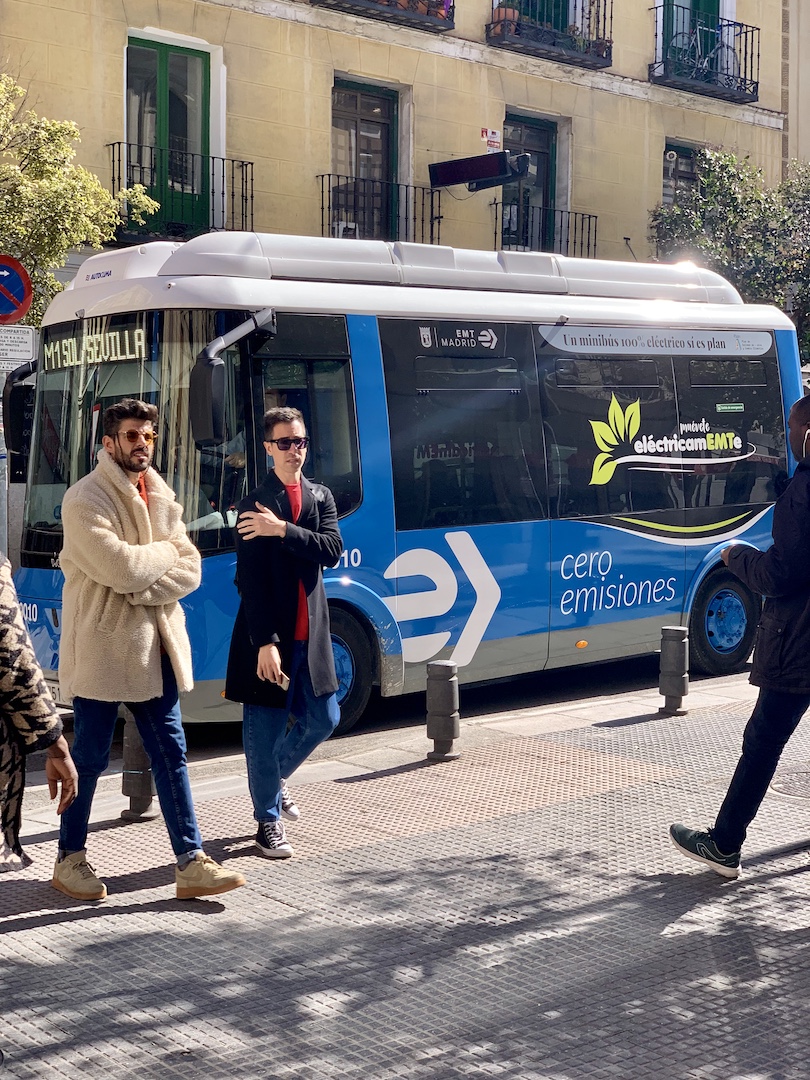
图 1 是输入图像。
运行 Locate Anything:
代码块
Bash
cd "$DATA_ROOT/Eagle/Embodied"
HF_HOME="$HF_HOME" \
TORCH_EXTENSIONS_DIR="$TORCH_EXTENSIONS_DIR" \
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True \
MODEL_DIR="$MODEL_DIR" \
IMAGE_PATH="$IMAGE_PATH" \
DATA_ROOT="$DATA_ROOT" \
"$ENV_ROOT/bin/python" - <<'PY'
import json, os, time
from pathlib import Path
from PIL import Image, ImageDraw
from locateanything_worker import LocateAnythingWorker
本机三条查询的结果如下:
| | |
| | |
| | |
| | |
公交车定位结果:
行人多目标定位结果:
自然语言指代表达定位结果:
大家要重点注意图 4:这里不是简单地检测 person 类,而是从多个行人里找“穿奶油色外套、站在公交车前的人”。这正是 Locate Anything 比普通固定类别检测器更有价值的地方。
五、和 YOLO26n 做同图对比
YOLO26 是 Ultralytics 发布的实时视觉模型族,官方文档介绍它支持 detection、segmentation、pose、classification、oriented detection 等任务。检测模型在 COCO 上覆盖 80 个预训练类别,并强调端到端、NMS-free 的低延迟部署。
为了不破坏 Locate Anything 的 numpy<2 约束,本章在同一个环境里安装 Ultralytics 时使用 --no-deps,并手动补齐少量依赖。更干净的做法是给 YOLO 单独建一个小环境。
代码块
Bash
运行 YOLO26n:
代码块
Bash
export YOLO_CONFIG_DIR=/path/to/large_disk/cache/ultralytics
mkdir -p "$YOLO_CONFIG_DIR/Ultralytics"
cd "$DATA_ROOT"
YOLO_CONFIG_DIR="$YOLO_CONFIG_DIR" \
DATA_ROOT="$DATA_ROOT" \
"$ENV_ROOT/bin/python" - <<'PY'
本机 YOLO26n 输出 5 个框:1 个 bus 和 4 个 person。预热后的模型内部耗时为:
代码块
Plain Text
preprocess: 2.38 ms
inference: 4.12 ms
postprocess: 0.80 ms
对比结论
| | |
| | |
| | |
| | |
| | |
| | |
| | |
| | |
如果任务只是“摄像头里有没有人、车、杯子”,YOLO26n 明显更快、更省显存,也更适合实时部署。如果任务是“找到穿奶油色外套、站在公交车前的人”,或者“找到网页右上角下载按钮”“文档摘要标题下方第一段”“桌面上靠近夹爪的透明杯子”,Locate Anything 更贴合问题。
需要补充的是,Ultralytics 也发布了 YOLOE-26,支持 text prompt / visual prompt 的开放词汇检测与分割。YOLOE-26 更接近“实时开放词汇 detector”,但 Locate Anything 的定位范围更偏 VLM grounding,覆盖 GUI、OCR、layout、referring 和 pointing 等结构化场景。写论文相关工作时,不要把它们简单写成互相替代关系;更准确的说法是:
代码块
Plain Text
YOLO26 / YOLOE-26:实时检测与分割模型族,重部署速度和检测任务。
Locate Anything:通用视觉语言定位器,重自然语言 grounding 和多域结构化定位。
六、为什么 PBD / MTP 会更快
传统生成式 grounding 可以把坐标当普通文本 token 输出:
代码块
Plain Text
如果用 NTP,也就是 Next Token Prediction,模型要先生成 x1,再生成 y1,再生成 x2,再生成 y2。这有两个问题:
坐标生成步骤多,速度慢。
box 的四个坐标本来是一个几何整体,逐 token 生成时容易出现结构不一致。
Locate Anything 的核心思路是 Parallel Box Decoding,简称 PBD。它把一个 box 或 point 当成固定长度的 atomic unit,让完整坐标在一个并行步骤里预测。官方 README 将它描述为 box-aligned 的多 token 预测:Fast Mode 使用 MTP,Slow Mode 使用 NTP,Hybrid Mode 默认走 MTP,如果遇到格式异常或空间歧义,再局部回退到 NTP。
大家可以这样理解:
| | |
| | |
| | |
| | |
本机在 bus.jpg 上跑 person 多框时,Hybrid Mode 日志显示:
代码块
Plain Text
num_tokens=28
generate_time(s)=0.6157
forward_step=9
num_boxes=4
bps=6.4966
switch_to_ar=1
这里 switch_to_ar=1 说明 Hybrid Mode 中确实触发了一次自回归 fallback。跑单个 bus 时:
代码块
Plain Text
num_tokens=10
generate_time(s)=0.9805
forward_step=3
num_boxes=1
bps=1.0199
switch_to_ar=0
这些数字只说明本机 smoke test 已经走通,不应直接和官方 H100 benchmark 横向比较。
七、常见问题
1. RTX 4090、RTX PRO 6000 这类消费级或工作站卡能跑吗?
能跑。NVIDIA 模型卡列出的兼容架构包括 Ampere、Hopper、Blackwell 和 Lovelace,其中 Lovelace 示例包含 RTX 4090。本机 RTX PRO 6000 Blackwell 96GB 跑 BF16 单图没有显存压力。24GB 显存的 4090 更适合 batch=1、低并发、离线标注或 demo;4K 高分辨率、密集目标和服务化批处理仍建议使用更大显存。
2. 为什么本章没有安装 MagiAttention?
本章目标是先跑通基础推理。官方 README 说明 MagiAttention 面向 Hopper / Blackwell 的长上下文训练和推理;如果大家要跑 16K 到 32K 以上长上下文或追求 batch throughput,再单独安装并验证。基础教程里先保留 SDPA fallback,排障路径更简单。
3. Locate Anything 返回
不一定。可能是 prompt 不清楚、图像是拼图/表格导致歧义,或目标不在图中。本章尝试在官方 teaser.jpg 上找 car 时就返回了 None,但同图找 ship 和 crop tool icon 可以得到合理框。复刻时先用干净图像和明确目标验证,再测试复杂场景。
4. 它能不能替代 YOLO26?
不要这样用。如果任务是实时固定类别检测,YOLO26 更合适。如果任务依赖自然语言、GUI/OCR/文档布局、复杂指代表达或机器人任务语义,Locate Anything 更有价值。两者常见的组合方式是:YOLO 负责高速常见类别安全检测,Locate Anything 负责任务语言相关目标定位。
5. 下一步怎么接到机器人抓取?
先把 Locate Anything 的 2D box 作为 prompt 给 SAM/SAM2 得到 mask,再把 mask 区域和 RGB-D 深度融合为 3D 点云。后面可以接 GraspNet、6D pose、传统抓取检测或 VLA policy。这样拆开后,每一层都有明确输入输出,排障也更容易。
八、参考链接
•
NVIDIA Locate Anything 项目页:https://research.nvidia.com/labs/lpr/locate-anything/
•
NVlabs/Eagle Embodied 代码:https://github.com/NVlabs/Eagle/tree/main/Embodied
•
Hugging Face 模型卡:https://huggingface.co/nvidia/LocateAnything-3B
•
Ultralytics YOLO26 文档:https://docs.ultralytics.com/models/yolo26/