Transformer面试问题汇总
Attention机制,Transformer面试问题参考答案
Transformer Encoder 有什么子层?
📌
Transformer 编码器(Encoder)由六个相同层构成,每层的主要子层包括两个部分:
多头自注意力机制(Multi-Head Self-Attention Mechanism):这一层允许编码器查看输入序列中的其他位置来更好地编码一个单词。它由多个头组成,每个头独立地学习输入数据的不同方面。
前馈神经网络(Feed-Forward Neural Network)(Linear+relu+dropout+Linear):这是一个简单的全连接神经网络,它对每个位置的注意力向量进行处理,但是对不同位置是独立的。
除了这些主要子层,还有一些重要的组件:
层归一化(Layer Normalization):在多头自注意力机制和前馈神经网络之后,通常会有层归一化步骤,以稳定网络的学习过程。
残差连接(Residual Connections):在每个子层之后,都会加上一个残差连接,然后进行层归一化。残差连接有助于避免在网络中出现梯度消失的问题。 这种结构的组合使得Transformer编码器非常有效且灵活,适用于处理各种顺序数据任务。
Transformer self-attention的公式是什么?
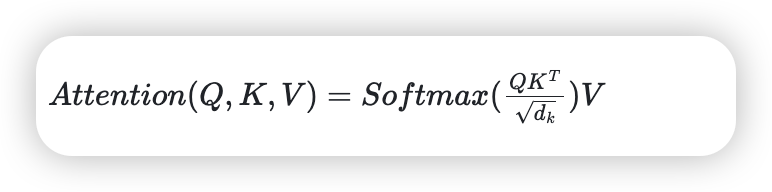
Transformer的优缺点有哪些?
📌
优点
•
具有并行处理能力:与基于循环的模型(如LSTM和GRU)相比,Transformer可以并行处理整个序列,大大提高了训练效率。
•
长距离依赖:借助多头自注意力机制,Transformer能够有效捕捉序列中长距离的依赖关系,这对于理解文本等复杂序列数据至关重要。
•
灵活性和泛化能力:Transformer模型在多种任务上都表现出色,包括机器翻译、文本生成、语音识别等。 可扩展性:Transformer模型可以通过增加层数来提高其复杂性和学习能力,使其适用于大规模数据集和复杂任务。
•
更好的性能:在许多NLP任务中,Transformer模型超越了以往的技术,设立了新的性能标准。 缺点 计算资源密集:尽管Transformer允许并行化,但其自注意力机制涉及大量的计算,对计算资源(尤其是内存)的需求很高。
•
可解释性不足:与某些传统模型相比,Transformer的决策过程更难解释和理解。 过拟合风险:Transformer模型因其大量的参数而容易过拟合,尤其是在数据较少的情况下。
•
训练需要精心调优:由于模型的复杂性,找到最佳的训练参数(如学习率、层数、头数等)可能需要大量的实验和调整。
•
长序列挑战:尽管Transformer在处理长距离依赖方面表现出色,但处理非常长的序列时,性能可能会下降,因为自注意力机制的计算成本随序列长度的增加而显著增加。
4、Encoder端和Decoder端是如何进行交互的?
📌
在 Transformer 模型中,编码器(Encoder)和解码器(Decoder)通过一个特殊的注意力机制进行交互,这个机制通常被称为 "编码器-解码器注意力" 或 "交叉注意力"(Cross-Attention)
以下是这种交互的详细步骤:
编码器处理输入序列:编码器首先处理输入序列,通过自注意力和前馈网络生成一系列上下文表示。这些表示包含了输入序列中每个元素的信息,以及它们之间的相对关系。
解码器自注意力层:在解码器端,每个解码器层首先通过自注意力机制处理先前生成的输出(例如,在序列生成任务中的先前生成的单词)。这个过程与编码器中的自注意力相似,但有一个关键差异:为了保证自回归属性(即只能使用当前位置之前的信息),解码器在自注意力计算中应用了掩码(masking)
5、Transformer中为什么需要线性变换?
📌
K、Q、V分别是输入向量经过不同的线性变换矩阵$W_k$、$Q_k$、$V_k$计算得到。 在$QK^T$部分,线性变换矩阵将KQ投影到了不同的空间,增加了表达能力(这一原理可以同理SVM中的核函数-将向量映射到高维空间以解决非线性问题),这样计算得到的注意力矩阵的泛化能力更高。
6、Transformer attention的注意力矩阵的计算为什么用乘法而不是加法?
📌
Transformer attention的注意力矩阵的计算用乘法是为了计算速度更快。 在计算复杂度上,乘法和加法理论上的复杂度相似,但是在实践中,乘法可以利用高度优化的矩阵乘法代码(有成熟的加速实现)使得点乘速度更快,空间利用率更高。
7、transformer中的attention为什么scaled?
📌
因为虽然矩阵加法的计算更简单,但是 Add形式套着tanh和V,相当于一个完整的隐层。在整体计算复杂度上两者接近,但是矩阵乘法已经有了非常成熟的加速实现。在 𝑑𝑘(即 attention-dim)较小的时候,两者的效果接近。但是随着 𝑑𝑘增大,Add 开始显著超越 Mul。
极大的点积值将整个 softmax 推向梯度平缓区,使得收敛困难。也就是出现了高赞答案里解释的“梯度消失”。
这才有了 scaled。所以,Add 是天然地不需要 scaled,Mul 在 较大的时候必须要做 scaled。个人认为,Add 中的矩阵乘法,和 Mul 中的矩阵乘法不同。前者中只有随机变量 X 和参数矩阵 W 相乘,但是后者中包含随机变量 X 和 随机变量 X 之间的乘法。
8、Transformer attention计算注意力矩阵的时候如何对padding做mask操作的?
📌
padding位置置为-1000,再对注意力矩阵进行相加。
9、介绍一下Transformer的残差结构及意义
📌
Transformer 模型中的残差连接(Residual Connection)是一种重要的网络结构设计,它直接将某一层的输入添加到后面层的输出上。以下是残差结构的介绍及其意义:
残差结构的介绍
在 Transformer 中,每个编码器和解码器层都包含残差连接。具体来说,对于一个给定的层(比如自注意力层或前馈神经网络层),其处理过程可以总结为:
层内处理:输入首先通过层内的主要操作(如自注意力或前馈神经网络)。
加上残差:将这个操作的原始输入直接加到操作的输出上。
10、Transformer为什么使用LN而不是BN?
📌
Transformer模型选择使用层归一化(Layer Normalization, LN)而不是批归一化(Batch Normalization, BN)的决策,主要是基于这两种归一化技术的不同特性和在处理序列数据时的适用性考虑:
独立于批大小:
•
LN:层归一化对每个样本独立进行,不依赖于批大小。这使得 LN 在处理不同长度的序列或小批量数据时表现更稳定。
•
BN:批归一化依赖于整个批次的数据统计信息。在小批量数据或批量大小变化时,BN 的效果可能会受到影响。
序列数据的动态长度:
•
在处理序列数据(特别是长度不一的序列)时,LN的独立性使其更适合。因为BN需要整个批次的数据统计,不同长度的序列可能会导致统计信息不准确。
11、Decoder阶段的多头自注意力和encoder的多头自注意力有什么区别?/ 为什么decoder自注意力需要进行sequence mask?
📌
在 Transformer 模型中,编码器(Encoder)和解码器(Decoder)的多头自注意力机制在基本原理上是相似的,但在实际应用中存在几个关键的区别:
12、Transformer的并行化体现在哪里,Decoder可以做并行化嘛?
📌
Encoder的模块是串行的,但模块内的子模块多头注意力和前馈网络内部都是并行的,因为单词之间没有依赖关系。 Decode引入sequence mask就是为了并行化训练,推理过程不并行
13、Transformer计算量最大的部分是哪里?
📌
在 Transformer 模型中,计算量最大的部分通常是多头自注意力(Multi-Head Self-Attention)机制。这是因为自注意力涉及到对序列中的每个元素与序列中的所有其他元素进行比较,这种全序列对全序列的操作在计算上是非常昂贵的。
以下是自注意力机制中计算量大的几个方面:
点积注意力计算:在自注意力机制中,对于每个元素,都需要计算其与序列中所有其他元素的点积。这种全对全的操作导致计算量随序列长度的平方增长。
线性变换:在计算注意力之前和之后,需要对查询(Query)、键(Key)和值(Value)进行线性变换。这些变换本身也是计算密集型的,尤其是当模型的维度和头数较大时。
14、Transformer、LSTM和单纯的前馈神经网络比,有哪些提升?
📌
LSTM相比于单纯的前馈神经网络,首先具有理解文本的语序关系的能力(RNN)。除此之外,又解决了RNN在处理长序列时发生的梯度消失和梯度爆炸的问题。 Transformer进一步解决了RNN、LSTM等模型的长距离依赖问题,能够理解更长的上下文语义。可以并行化,所要的训练时间更短。
15、有哪些处理超长文本的方法?
📌
处理超长文本是自然语言处理(NLP)中的一个挑战,尤其是在使用标准的 Transformer 模型时,因为它们通常对输入序列的长度有限制。以下是一些处理超长文本的常用方法:
16、Transformer为何不使用一个头而使用多头注意力机制?
📌
多头能让transformer注意到不同子空间,捕捉到更加丰富的特征信息。这一做法是论文作者提出用于克服“模型在对当前位置的信息进行编码时,会过度的将注意力集中于自身的位置“的问题,并且经过作者验证这样效果比较好。
17、Transformer为什么Q和K使用不同的权重矩阵,不能使用同一个值进行自身的点乘操作?
📌
K和Q的点乘是为了得到一个attention score 矩阵,然后经过归一化后与V进行相乘,如果不用Q,直接拿K和K点乘的话,attention score 矩阵会是一个对称矩阵,导致泛化能力很差。使用Q 、K不相同可以保证在不同空间进行投影,增强了表达能力,提高了泛化能力。
18、深度学习中有哪些常用的注意力机制?
📌
在深度学习中,注意力机制是一种重要的技术,用于增强模型在处理复杂任务时的表现。以下是一些常用的注意力机制及其经典例子:
- Soft Attention(软注意力)
软注意力机制对输入的所有部分分配权重,通常通过一个可训练的模型来计算。
•
Bahdanau Attention(Additive Attention)
◦
经典例子:用于神经机器翻译(Neural Machine Translation, NMT)。序列到序列模型(seq2seq)中的注意力机制,通过学习输入序列中每个元素的相关性来生成目标序列。
•
Luong Attention(Multiplicative Attention)
◦
经典例子:改进的神经机器翻译。在生成目标序列时,通过点积计算输入和隐藏状态之间的相似性。
19、注意力机制计算时,QKV的维度必须相同吗?
📌
不一定必须相同,但在有些维度上必须相同:
QKV的N和head默认是必须相同的