Agentic-RL 是什么?如何用 GRPO 训练 Agent 的决策能力?
难度:高级 分类:Planning & Reasoning
简短回答
Agentic-RL 是指用强化学习训练 LLM Agent 的工具调用、多步规划和任务执行能力,区别于传统 RLHF 只对齐人类偏好——Agentic-RL 的奖励信号来自任务完成度而非人类评分。典型训练流程为 SFT 冷启动 → Reward Model / 规则奖励 → RL 策略优化,其中 GRPO(Group Relative Policy Optimization) 是 DeepSeek 提出的核心算法,与 PPO 的关键差异在于 GRPO 不需要 Critic Model,而是对同一 prompt 采样一组响应,用组内相对排名计算 advantage,大幅降低了训练成本。奖励函数的设计是 Agentic-RL 的核心难点,通常包括任务完成度、工具使用准确率、步骤简洁性和格式遵循度四个维度。DeepSeek-R1 的训练范式证明,通过大规模 RL(GRPO)训练,模型可以自主涌现出复杂的推理和工具使用策略,无需人工逐步示范。
详细解析
Agentic-RL vs 传统 RLHF
代码块
Plain Text
传统 RLHF(对齐人类偏好):
┌──────────┐ ┌──────────────┐ ┌──────────────┐
│ Prompt │ → │ LLM 生成 │ → │ 人类标注偏好 │
└──────────┘ │ 两个回答 │ │ A > B │
└──────────────┘ └──────┬───────┘
↓
┌──────────────┐
│ Reward Model │
│ 学习偏好打分 │
└──────┬───────┘
↓
┌──────────────┐
│ PPO 优化策略 │
│ 目标:讨人喜欢 │
└──────────────┘
Agentic-RL(训练任务执行能力):
┌──────────┐ ┌──────────────┐ ┌──────────────────┐
│ 任务指令 │ → │ Agent 执行 │ → │ 环境反馈 / 规则 │
└──────────┘ │ 工具调用序列 │ │ 自动计算奖励 │
└──────────────┘ └──────┬───────────┘
↓
┌──────────────────┐
│ GRPO / PPO 优化 │
│ 目标:完成任务 │
└──────────────────┘
代码块
Python
# 两种 RL 范式的对比
rl_paradigms = {
"传统 RLHF": {
"目标": "对齐人类偏好(helpful, harmless, honest)",
"奖励来源": "人类标注 → Reward Model 打分",
"训练信号": "回答 A 比回答 B 更好",
"典型场景": "聊天、创意写作、安全对齐",
},
"Agentic-RL": {
"目标": "提升任务执行能力(工具调用、规划、推理)",
"奖励来源": "任务环境自动评估(可验证奖励)",
"训练信号": "任务是否完成、执行效率、步骤正确性",
"典型场景": "Agent 工具调用、代码生成、多步推理",
},
}
完整训练流程
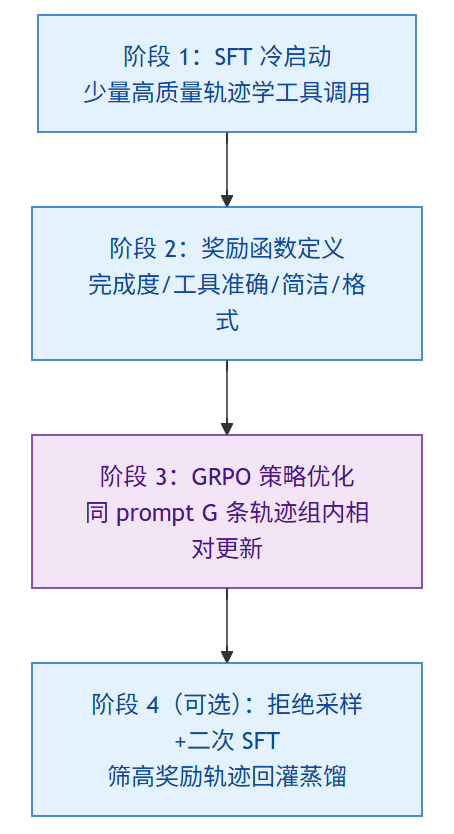
Agentic-RL 四段流水线:SFT 冷启动→奖励定义(四维)→GRPO 组内优化→拒绝采样回灌二次 SFT。
GRPO vs PPO:核心算法差异
PPO 要额外训练 Critic 估 V(s),GRPO 用同 prompt G 条响应的组内相对排名替代 Critic。
代码块
Python
GRPO vs PPO 对比表
#STdcFgrECqmO text { white-space: pre; }#STdcFgrECqmO .fb0 { stroke: var(--N900-FG, 0.15); }#STdcFgrECqmO .fb0 {stroke: rgba(31,35,41, 0.15)}#STdcFgrECqmO .fx0 { stroke-miterlimit: 10; }#STdcFgrECqmO .fx0 {stroke-miterlimit: 10}#STdcFgrECqmO .fa1 { fill: rgb(187, 191, 196); }#STdcFgrECqmO .fa1 {fill: rgb(187, 191, 196)}#STdcFgrECqmO .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#STdcFgrECqmO .fx1 {font-style: normal}#STdcFgrECqmO .fx2 { text-anchor: middle; }#STdcFgrECqmO .fx2 {text-anchor: middle}#STdcFgrECqmO .fx3 { dominant-baseline: central; }#STdcFgrECqmO .fx3 {dominant-baseline: central}#STdcFgrECqmO .fx4 { stroke: none; }#STdcFgrECqmO .fx4 {stroke: none}#STdcFgrECqmO .fc0 { fill: var(--text-caption); }#STdcFgrECqmO .fc0 {fill: #646a73}#STdcFgrECqmO .fa2 { fill: var(--text-link-disabled); }#STdcFgrECqmO .fa2 {fill: rgb(187, 191, 196)}#STdcFgrECqmO .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#STdcFgrECqmO .fx5 {font-style: normal}#STdcFgrECqmO .fx6 { text-anchor: start; }#STdcFgrECqmO .fx6 {text-anchor: start}#STdcFgrECqmO .fx7 { dominant-baseline: alphabetic; }#STdcFgrECqmO .fx7 {dominant-baseline: alphabetic}#STdcFgrECqmO .fc1 { fill: rgb(0, 0, 0); }#STdcFgrECqmO .fc1 {fill: rgb(0, 0, 0)}#STdcFgrECqmO .fb1 { fill: var(--N900-FG, 0.15); }#STdcFgrECqmO .fb1 {fill: rgba(31,35,41, 0.15)}#STdcFgrECqmO .fb2 { fill: rgb(209, 217, 224); }#STdcFgrECqmO .fb2 {fill: rgb(209, 217, 224)}#STdcFgrECqmO .fa3 { fill: var(--bg-body); }#STdcFgrECqmO .fa3 {fill: #fff}ABC12345678维度Critic ModelAdvantage 计算采样方式训练稳定性显存占用代表应用适合场景PPO需要(额外训练开销大)A = R - V(s)依赖 Value Function每个 prompt 1 个响应依赖 Critic 质量Actor + CriticChatGPT/InstructGPT通用 RLHFGRPO不需要(节省 ~50% 显存)A = (r-mean)/std依赖组内相对排名每个 prompt G 个响应依赖组大小 G仅 Policy + RefDeepSeek-R1可验证奖励的任务
奖励函数设计:Agentic-RL 的核心难点
代码块
Python
def compute_agent_reward(prompt, trajectory, max_steps=20):
"""
Agent 任务的多维度奖励函数
trajectory: Agent 执行的完整轨迹(思考 + 工具调用 + 结果)
"""
# 维度 1:任务完成度(权重最高,可验证任务直接判正误)
completion = 1.0 if trajectory.final_answer == get_ground_truth(prompt) \
else partial_match_score(trajectory.final_answer, prompt)
# 维度 2:工具使用准确率(调用了正确的工具和参数)
tool_calls = trajectory.get_tool_calls()
tool_acc = sum(tc.is_valid() for tc in tool_calls) / max(len(tool_calls), 1)
# 维度 3:步骤简洁性(用更少步骤完成 → 更高奖励)
efficiency = max(0, 1.0 - len(trajectory.steps) / max_steps)
# 维度 4:格式遵循度(输出符合 JSON / 函数调用格式等)
format_score = max(0, 1.0 - 0.2 * trajectory.count_format_violations())
DeepSeek-R1 训练范式:Agentic-RL 的成功案例
代码块
Python
# DeepSeek-R1 五阶段训练流程
# Step 1 → 基座模型 DeepSeek-V3 (671B MoE)
# Step 2 → Cold Start SFT:数千条高质量长 CoT 数据,教模型"开始思考"
# Step 3 → 大规模 GRPO(核心阶段)
# Step 4 → Rejection Sampling + SFT(蒸馏 RL 策略)
# Step 5 → 第二轮 RL(加入 helpfulness / safety 奖励)
r1_grpo_config = {
"group_size": 64, # 每个 prompt 采样 64 个响应
"sampling_temperature": 1.0,
"kl_coefficient": 0.05,
GRPO 之后:2025-2026 后续算法演进
GRPO 不是终点。2025 开始陆续出现一批"GRPO 后续",主要解决 GRPO 在长 trajectory、稀疏奖励、训练稳定性上的痛点:
代码块
JSON
post_grpo_algorithms = {
"DAPO (ByteDance, 2025)": {
"全称": "Dynamic Sampling Policy Optimization",
"改进点": (
"1. Clip-Higher:放宽正向 ratio 的裁剪上界,缓解 entropy collapse;"
"2. Dynamic Sampling:剔除组内全对/全错样本(advantage 全 0 无梯度);"
"3. Token-level loss:长序列按 token 而非 sequence 平均;"
"4. Overlong-shaping:长输出软惩罚而非硬截断"
),
"效果": "AIME 2024 使用 Qwen2.5-32B 在 50% steps 内超过 R1-Zero",
"开源": "ByteDance 公开了完整训练栈(含数据 + 代码)",
},
"GSPO (Qwen Team, 2025)": {
"全称": "Group Sequence Policy Optimization",
"改进点": "把 ratio/clipping 从 token 级别上升到 sequence 级别,解决长 CoT 训练不稳",
"应用": "Qwen3 系列推理模型训练",
},
关键观察:2026 工业界训练推理/Agent 模型时已经很少直接用 paper-version GRPO,几乎都跑在 DAPO/GSPO 这一代改良算法上。面试中如果只能说出 "GRPO = DeepSeek-R1",会显得知识停在 2025-01。
从 RLHF 到 Agentic-RL 的演进路线
代码块
Plain Text
┌─────────────┐ ┌──────────────┐ ┌──────────────────┐
│ RLHF │ → │ RLAIF │ → │ Agentic-RL │
常见误区 / 面试追问
误区:"RLHF 和 Agentic-RL 是一回事" — 两者都用强化学习优化 LLM,但目标截然不同。RLHF 优化的是人类偏好("这个回答好不好"),依赖人类标注训练 Reward Model;Agentic-RL 优化的是任务执行能力("任务完成了没有"),奖励信号来自环境的可验证反馈(代码是否通过测试、答案是否正确)。这导致 Agentic-RL 可以大规模自动化生成训练信号,不受人类标注瓶颈限制。
误区:"RL 训练 Agent 不需要 SFT 冷启动" — DeepSeek 的实验(R1-Zero)表明,纯 RL 训练虽然能涌现推理能力,但存在两个严重问题:(1) 输出可读性差,常混合多种语言;(2) 训练初期的探索效率极低,模型可能长时间在无意义的行为空间中徘徊。Cold Start SFT 用少量高质量数据给模型一个"起跑点",显著提升了训练效率和最终输出质量。
追问:"如何设计 Agent 任务的奖励函数?" — 核心原则是"可验证 + 多维度"。对于可验证任务(数学、代码),直接用答案正确性作为主奖励信号;对于不可验证任务(开放式规划),需要 LLM-as-Judge 或人类评估。多维度设计很关键:除任务完成度外,还应奖励工具使用的准确性、执行效率(更少步骤)和格式规范性。权重分配上,任务完成度应占 50% 以上,避免模型学会"格式正确但不解决问题"的 reward hacking 行为。
追问:"Agentic-RL 的训练数据如何采集?" — 分阶段采集。SFT 阶段需要少量高质量 Agent 轨迹(专家标注或强模型生成,通常几千到几万条)。RL 阶段的核心优势是数据可以自动生成:设定任务 prompt → Agent 自由探索 → 环境自动打分。关键挑战是任务分布的多样性——需要覆盖不同难度、不同工具组合、不同领域的任务,否则模型只会在训练分布内表现好。实践中常用课程学习(Curriculum Learning),从简单任务开始逐步增加难度。