如何实现 Agent 的持久化记忆(PersistentMemory)?
难度:中级 分类:Memory & State
简短回答
持久化记忆使 Agent 能跨会话保留知识——用户下周回来时,Agent 仍记得之前的对话和偏好。核心架构是双层存储:短期记忆(上下文窗口)+ 长期记忆(外部持久存储)。
实现方式包括:向量数据库(Chroma/Pinecone/Weaviate,用于语义检索历史)、结构化存储(Redis/PostgreSQL/MongoDB,用于精确查询用户数据)、图数据库(Neo4j/Neptune,用于实体关系追踪)。主流框架如 Mem0 提供了完整的记忆编排层,自动处理提取、存储、检索和遗忘。关键挑战是选择性存储——不是所有信息都值得记住,且需要遗忘机制防止记忆无限膨胀。
详细解析
为什么需要持久化记忆?
代码块
Plain Text
没有持久化记忆:
会话 1: 用户说"我是 Python 开发者" → Agent 记住
会话 2: 用户问"推荐个框架" → Agent 不知道用户是 Python 开发者,推荐了 Java 框架
有持久化记忆:
会话 1: 用户说"我是 Python 开发者" → Agent 记住 → 存入长期记忆
会话 2: 用户问"推荐个框架" → Agent 检索长期记忆 → 推荐 FastAPI/Django
LLM 本身是无状态的。产品中的"记忆"(如 ChatGPT 记住你的名字)完全是工程实现。
持久化记忆架构
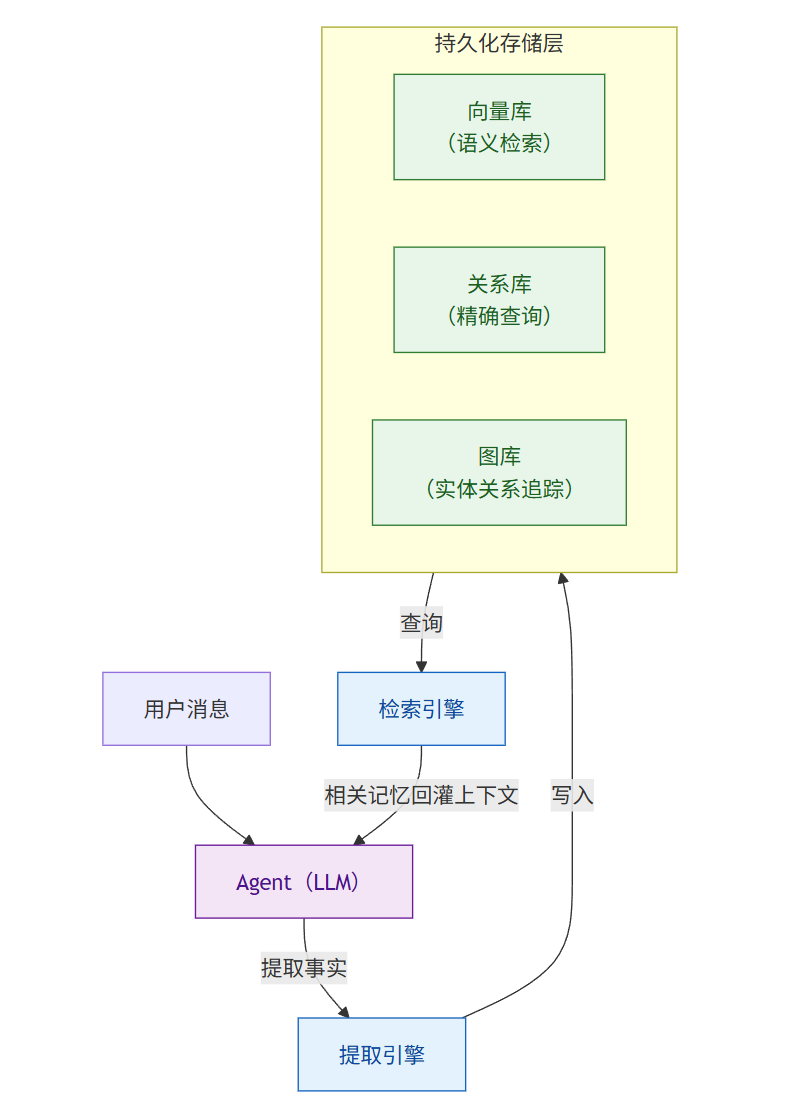
持久化记忆 = Agent 挂双引擎(提取落库 + 检索回灌),底层是向量 / 关系 / 图三库持久层。
实现方式 1:向量数据库存储
代码块
Python
import chromadb
from sentence_transformers import SentenceTransformer
class VectorMemory:
def __init__(self):
self.client = chromadb.PersistentClient(path="./memory_db")
self.collection = self.client.get_or_create_collection("agent_memory")
self.encoder = SentenceTransformer("all-MiniLM-L6-v2")
def store(self, user_id: str, content: str, metadata: dict = None):
"""存储记忆"""
实现方式 2:LangGraph + MongoDB
代码块
Python
实现方式 3:Mem0 记忆编排层
代码块
Python
from mem0 import Memory
Mem0 的研究结果:91% 更低的 p95 延迟,90%+ token 成本降低。
记忆生命周期管理
代码块
Python
class MemoryLifecycle:
"""记忆的完整生命周期"""
async def process_interaction(self, user_id, conversation):
# 1. 提取:从对话中提取值得记忆的信息
facts = await self.extract(conversation)
# 2. 去重:检查是否已有类似记忆
for fact in facts:
existing = self.retrieve_similar(user_id, fact, threshold=0.9)
if existing:
# 更新已有记忆而非重复添加
await self.update(existing.id, fact)
else:
await self.store(user_id, fact)
用户偏好学习:从"记住事实"到"了解用户"
前面的记忆生命周期解决的是"记什么、忘什么",而用户偏好学习(User Preference Learning)更进一步——让 Agent 像人类助手一样"了解用户":记住用户的习惯、风格偏好和工作方式,并在后续会话中自动适配。这是持久化记忆最高价值的应用场景之一。
偏好的提取-存储-检索复用上文的记忆生命周期管线(提取 → 去重 → 衰减 → 整合),难点在于偏好自身的特性——它常是隐式的、且会随时间漂移:
代码块
Python
preference_types = {
"explicit": ["请用中文回复", "代码示例用 Python"], # 用户直接说出的,一次提取即可
"implicit": ["用户总追问技术细节 → 偏好深度分析", # 从行为推断,需要归纳
"多次选方案 A 而非 B → 偏好某种技术栈"],
"evolving": ["三个月前用 React → 最近开始学 Vue"], # 随时间变化,需要持续追踪
}
针对隐式归纳和漂移追踪这两个难点,前沿研究给出三条路径:PAMU 负责感知偏好变化、动态画像负责结构化聚合、Memory-R1 则用 RL 把记忆操作本身学出来。
PAMU:偏好感知记忆更新
普通记忆系统对偏好的处理是"提取一次、存一次",但用户偏好不是静态的。PAMU(Preference-Aware Memory Update,偏好感知记忆更新)专门解决偏好变化的追踪问题——它用滑动窗口平均捕捉短期波动,用**指数移动平均(EMA)**捕捉长期趋势,再融合两路信号检测偏好漂移:
代码块
Python
class PreferenceAwareMemory:
"""PAMU: 融合短期波动和长期趋势"""
def __init__(self, alpha=0.3):
self.alpha = alpha # EMA 平滑因子
def update_preference(self, user_id, new_signal):
# 滑动窗口平均(捕捉短期变化)
sw_avg = self.sliding_window_average(
self.recent_signals[user_id], window=5
)
# 指数移动平均(捕捉长期趋势)
ema = self.ema_values.get(user_id, new_signal)
ema = self.alpha * new_signal + (1 - self.alpha) * ema
self.ema_values[user_id] = ema
# 融合两种信号
PAMU 的"渐变 + 突变"双检测比单纯的时间衰减更精细——衰减只回答"要不要遗忘"(见 #048 记忆的遗忘与更新机制),PAMU 还要回答"偏好是不是变了、要不要主动适配"。
动态用户画像构建
偏好项是零散的,动态用户画像(Dynamic User Profile)把它们聚合成一个持续演进的结构化档案——技术水平、偏好语言、沟通风格、领域专长等字段初始为 unknown,随每次交互逐步具化:
代码块
Python
class DynamicUserProfile:
"""动态演进的用户画像"""
def __init__(self, user_id):
self.profile = {
"user_id": user_id,
"technical_level": "unknown",
"preferred_language": "unknown",
"communication_style": "unknown",
"domain_expertise": [],
"last_updated": None,
}
关键纪律是"有证据才更新"——画像填充必须基于真实交互证据,而非 LLM 臆测,否则错误画像会污染后续所有个性化决策。
Memory-R1:用 RL 学习记忆操作策略
前面所有的提取/更新/遗忘逻辑都是人工写死的规则。Memory-R1 把记忆管理建模为显式的动作空间,用强化学习训练 Memory Manager 学习最优操作策略:
表格加载中...
其中 NOOP 尤为关键——它避免 Agent 对无信息量的对话强行写入噪声,是记忆库质量的"守门员"。Memory-R1 把 Memory Manager(学上述 4 个动作)和 Answer Agent(学检索与推理)联合训练,仅用 152 条训练样本即在多个长期记忆基准上超越 Mem0 等强基线。
这印证了一个趋势:记忆管理的下一站不是更复杂的启发式规则,而是像 #103 Agentic-RL 与 GRPO 那样用 RL 让 Agent 自己学会"记什么、改什么、忘什么"。偏好学习场景尤其受益——隐式偏好的归纳、进化偏好的漂移检测,本质上都是难以手写规则、适合 RL 优化的决策问题。
记忆检索优化策略
写入容易,检索才是 Memory 系统能不能用的胜负手。Mem0 论文(arXiv 2504.19413)和 MemMachine 的消融实验都表明:检索阶段的优化(+4.2%)远比摄入阶段(+0.8%)影响大。下面是工业界主流的 4 个优化方向。
优化 1:多因子打分(Generative Agents 经典公式)
Stanford 的 Generative Agents(Park et al., UIST'23)开创了三因子加权检索,至今是主流参考:
代码块
Python
为什么需要三因子?纯向量相似度会让"频繁出现但无意义"的记忆压倒"少见但重要"的记忆——Klaus 之所以选 Maria 一起做研究而不是天天碰面的 Wolfgang,靠的就是 importance 分量。
优化 2:多信号融合(Mem0 2025 新算法)
代码块
Python
# Mem0 多信号并行打分 + 融合
results = parallel(
semantic_search(query), # 向量语义
bm25_keyword_search(query), # 关键词(实体重的查询表现好)
entity_match(query), # 命名实体直接匹配
)
final = score_fusion(results) # 加权融合后排序
# 性能:LoCoMo 92.5 / LongMemEval 94.4,平均 <7K token/检索
# 对比:full-context 方法要烧 25K+ tokens
优化 3:两阶段检索(Vector → Reranker)
代码块
Plain Text
生产标准管线(25-30ms 总延迟):
Query → Embed (TEI/GPU, ~2ms)
优化 4:Query 改写 / 检索 Agent
代码块
Python
实战推荐组合:
•
轻量场景(<10万条记忆、单用户):向量检索 + 三因子打分 + 时间衰减
•
生产场景(多用户、跨会话):多信号融合(vector+BM25+entity)+ reranker
•
复杂推理(多跳、依赖链):上面 + Retrieval Agent(query 路由 + decomposition)
安全考虑
代码块
JSON
security_concerns = {
"数据泄露": "MEXTRA 攻击可通过 prompt injection 提取存储的记忆",
"记忆污染": "恶意用户可注入虚假信息到 Agent 的记忆中",
"隐私合规": "GDPR 要求支持记忆的完全删除",
"防护措施": [
"对记忆内容做 PII 脱敏",
"输入验证防止注入攻击",
"实现记忆的完全删除(right to be forgotten)",
"访问控制确保用户间记忆隔离",
],
方案选型
常见误区 / 面试追问
误区:"向量数据库是唯一选择" — Google 的 Always On Memory Agent 用 SQLite + LLM 驱动的整合替代了向量数据库。向量检索适合语义查找,但结构化查询和关系推理需要其他存储方案。最佳实践是混合使用。
误区:"所有对话都应该存入记忆" — 选择性存储是关键。寒暄、重复提问、中间推理步骤不值得持久化。只存储影响未来交互的信息:用户偏好、关键决定、重要事实。
追问:"如何处理记忆冲突?" — 当新信息与旧记忆矛盾时(如用户改了偏好),应该用新信息更新旧记忆而非并存。Mem0 通过检索相似记忆 + LLM 判断是否为更新来自动处理这个问题。
追问:"记忆安全的最大风险是什么?" — MEXTRA 攻击证明存储的记忆可被 prompt injection 提取。防护需要:记忆内容脱敏、访问控制、输入验证、以及将记忆视为"可被操纵的不可信数据"。
追问:"Memory Retrieval 怎么优化?纯向量检索为什么不够?" — 纯向量有三个硬伤:(1) 没有时间维度——昨天和半年前的记忆同等对待;(2) 没有重要性维度——"刷牙"和"我离婚了"被同等检索;(3) ANN 召回有 false positive,污染 context。工业界标准方案是 Generative Agents 三因子打分(recency × importance × relevance)+ 多信号融合(vector+BM25+entity 并行)+ 两阶段 rerank(vector top-50 → cross-encoder top-5)。Mem0 用这套方案在 LongMemEval 拿到 94.4,平均每次检索只烧 7K token,比 full-context 方案省 90%+。
追问:"HyDE 等查询改写为什么不够用?" — HyDE / BM25 hybrid / chunk rerank 这些都是单查询策略——只在原查询的一次表达上做文章。但很多记忆问题是依赖链:要回答"我上次提到的那个客户的预算多少",得先定位"上次提到的客户是谁"再查预算。MemMachine 论文(2025)的解法是 Retrieval Agent——加一层 LLM 路由器,把查询分类为 direct/decompose/iterative 三种策略,复杂查询走 query decomposition 或 chain-of-query,HotpotQA hard 上能到 93.2%。