对话上下文窗口管理与压缩策略
难度:基础 分类:Memory & State
简短回答
上下文窗口是 LLM 的"工作记忆"——所有输入(System Prompt、对话历史、检索内容、工具结果)和输出都必须装进这个固定大小的 token 空间(4K 到百万级 tokens,如 Claude 标准为 200K,Sonnet 4.6+ / Opus 4.6+ / Mythos 已支持 1M;Gemini 2.5 Pro 也支持 1M+)。
随着对话增长,上下文窗口的管理与压缩成为核心挑战。
管理策略从简到繁包括:截断(Truncation)——直接裁剪最早的消息;
滑动窗口(Sliding Window)——只保留最近 N 轮对话;
观察掩码(Observation Masking)——用占位符替代旧内容;
LLM 摘要(Summarization)——用模型将旧对话压缩为摘要;
分层摘要(Hierarchical)——越旧的信息压缩越激进;
结构化提取——提取实体和事实到结构化格式。
研究表明,简单策略(掩码、截断)在总效率上往往不逊于复杂的 LLM 摘要。生产最佳实践是将上下文控制在窗口的 75% 以内(用 ACON 等自适应压缩框架做触发式压缩),并注意"中间丢失"效应。
详细解析
一、为什么需要管理上下文窗口?
代码块
Plain Text
上下文窗口 = LLM 能"看到"的全部信息
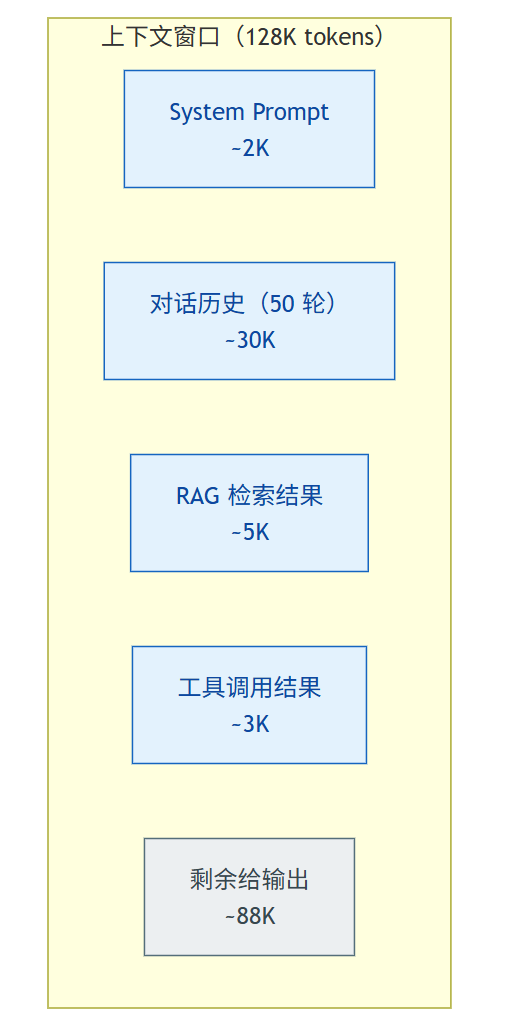
上下文窗口是固定 token 预算:System Prompt、对话历史、RAG、工具结果四类内容争抢同一空间,输出只能用剩下的部分。
代码块
Plain Text
对话增长曲线:
二、基础策略:截断与滑动窗口
策略 1:截断(最简单)
代码块
Python
def truncate_messages(messages, max_tokens):
"""保留最新消息,截断最旧的"""
total = 0
kept = []
改进版——优先级截断:
代码块
Python
def smart_truncate(messages, max_tokens):
"""区分必须保留和可选内容"""
must_keep = [m for m in messages if m["priority"] == "high"]
# 系统消息 + 最新用户消息 = 必须保留
optional = [m for m in messages if m["priority"] == "normal"]
remaining = max_tokens - count_tokens(must_keep)
策略 2:滑动窗口
代码块
Python
def sliding_window(messages, window_size=10):
"""只保留最近 N 轮对话"""
system_messages = [m for m in messages if m["role"] == "system"]
conversation = [m for m in messages if m["role"] != "system"]
return system_messages + conversation[-window_size * 2:] # 每轮 = user + assistant
优势: 零额外成本、可预测的 token 用量 劣势: 丢失所有旧上下文,Agent 会"遗忘"早期对话
策略 3:观察掩码(Observation Masking)
代码块
Python
def observation_masking(messages, window=5):
"""用占位符替代旧的工具结果和长回复"""
result = []
for i, msg in enumerate(messages):
if i < len(messages) - window:
if msg["role"] == "tool" or len(msg["content"]) > 500:
result.append({
"role": msg["role"],
"content": "[内容已省略——如需详情请重新查询]"
})
else:
result.append(msg)
else:
result.append(msg) # 最近 N 条保持原样
return result
研究表明,掩码策略在**总效率(性能/成本比)**上与 LLM 摘要相当甚至更优。
三、进阶策略:LLM 摘要、分层摘要与结构化提取
策略 4:LLM 摘要
代码块
Python
class IncrementalSummarizer:
"""增量式对话摘要"""
def __init__(self):
self.running_summary = ""
def update(self, new_messages):
prompt = f"""
已有摘要:
{self.running_summary}
新的对话内容:
优势: 保留语义完整性,不丢失关键信息 劣势: 每次压缩需要一次 LLM 调用(成本 + 延迟),可能丢失细节
策略 5:分层压缩(Hierarchical)
以下为概念示意代码,实际实现需处理边界情况(如消息不足、批次重叠等)。
代码块
Python
class HierarchicalCompression:
"""越旧的信息压缩越激进"""
def compress(self, messages):
total = len(messages)
result = []
for i, msg in enumerate(messages):
age = total - i # 消息的"年龄"
if age <= 5:
# 最近 5 轮:保留原文
result.append(msg)
elif age <= 20:
# 5-20 轮前:压缩为摘要
if i % 4 == 0: # 每 4 条做一次摘要
batch = messages[i:i+4]
result.append(self.summarize_batch(batch))
else:
策略 6:结构化提取
代码块
Python
class StructuredExtractor:
"""从对话中提取结构化信息"""
def extract(self, conversation):
prompt = f"""
从以下对话中提取关键信息,以结构化格式输出:
{conversation}
输出格式:
CONTEXT: 当前在做什么
优势: 信息密度最高,不丢失关键事实 劣势: 提取质量依赖 LLM,可能遗漏隐式信息
四、生产实践方案
ACON 框架:自然语言指引优化 + 小模型蒸馏
ACON 原论文("Optimizing Context Compression for Long-Horizon LLM Agents", arXiv:2510.00615)实际由两个核心机制构成,并不是按 40%/60%/95% 三阈值切换——这是常见误传,请勿在面试中引用:
Natural-Language Compression Guideline Optimization:把"该压缩什么/保留什么"显式化为一段可优化的自然语言指引,通过对比成功/失败轨迹的反馈不断 refine(类似 OPRO/PromptBreeder 风格的 prompt 优化)。
Compressor Distillation:把大模型生成的高质量压缩样本蒸馏到一个小模型(如 Qwen2.5-7B),作为生产环境的廉价 compressor。
代码块
Python
class ACONCompressor:
"""ACON: Optimizing Context Compression for Long-Horizon LLM Agents
实际工作流(简化):
给定任务、当前 trace、已优化的 guideline
compressor LLM 按 guideline 输出"保留 + 丢弃"决策
失败案例反向优化 guideline;成功 trace 蒸馏到小 compressor
"""
def __init__(self, compressor_llm, guideline: str):
self.compressor = compressor_llm # 可以是大模型;生产用蒸馏后的小模型
self.guideline = guideline # 通过对比反馈持续优化的自然语言指引
def compress(self, task: str, trace: list[dict]) -> list[dict]:
prompt = f"""
任务:{task}
当前轨迹:{trace}
压缩指引(请严格遵守):
ACON 论文报告:在 AppWorld / OfficeBench / TravelPlanner 等长视野 Agent 任务上显著降低峰值 token 使用,同时维持甚至提升任务成功率;蒸馏后的小 compressor 兼具低成本和接近大模型的压缩质量。具体数字以论文为准——避免引用未经核实的 40%/60%/95% 阈值。
混合策略(生产推荐)
代码块
Python
class ProductionContextManager:
"""组合多种策略的生产级上下文管理"""
def __init__(self, config):
self.max_context = config.max_tokens * 0.75 # 预留 25% 给输出
self.buffer_size = config.buffer_turns # 保留最近 N 轮原文
self.vector_store = config.vector_store # 语义检索历史
注意"中间丢失"效应
代码块
Plain Text
LLM 对上下文中不同位置的注意力:
高 ██████░░░░░░░░░░░░░░░░░██████ 高
开头 结尾
░░░░░░░░░░░░░░░░
策略选择指南
关键洞察
代码块
JSON
insights = {
"简单未必差": "掩码和截断将成本减半,且可靠性往往优于摘要",
"摘要≠万能": "通用摘要捕获'发生了什么'但丢失'进展到哪了'",
"场景决定策略": "工具密集型用掩码,对话密集型用摘要",
"组合优于单一": "最佳实践是组合多种策略:最近原文 + 中期摘要 + 远期结构化提取",
}
常见误区 / 面试追问
误区:"上下文窗口越大越好 / 越大就不需要压缩" — 更大的窗口意味着更高的成本(按 token 计费)、更大的延迟、以及更严重的"中间丢失"效应。即使 200K 窗口,长对话仍会导致成本线性增长和注意力质量下降。压缩不仅省钱,还能提高模型注意力的质量。最佳实践是精心管理上下文内容,而非依赖大窗口。
误区:"只要不超过上下文限制就没问题" — 即使不超限,上下文中的噪声信息也会降低模型的准确率("上下文腐化")。精简的、高相关性的上下文优于冗长的完整历史。
误区:"LLM 摘要是最佳策略" — 研究表明简单的观察掩码在总效率上不逊于 LLM 摘要。摘要额外消耗约 7%+ 成本(经验估算值,实际因场景而异),且不总是能保留正确信息。应该根据场景选择,而非默认使用最复杂的方案。
追问:"摘要压缩的成本问题怎么解决?" — 每次摘要需要一次额外 LLM 调用,可能占总成本的 7%+。优化方案:(1) 只在 token 超阈值时才触发摘要;(2) 用小模型做摘要;(3) 用观察掩码(Observation Masking)替代 LLM 摘要。
追问:"如何评估压缩策略的质量?" — 两个维度:(1) 信息保留率——压缩后 Agent 能否正确回答依赖历史信息的问题;(2) 成本效率——总 token 消耗(含压缩调用本身的开销)。LoCoBench-Agent 是专门评估长上下文压缩的基准测试。
追问:"增量摘要 vs 全量重新摘要?" — 增量摘要(每次只处理新消息)更快更便宜,但可能累积误差。全量重新摘要更准确但成本高。实践中用增量摘要 + 定期全量校正的混合方式。
追问:"Claude 的 Server-Side Compaction 是什么?" — Anthropic 在 Claude Sonnet 4.6+ / Opus 4.6+ 上提供服务端自动压缩(context editing / compaction)能力——当对话接近上限时,由服务端策略性删除/折叠旧的 tool_result 与思考块,让长对话可以"无限延续"。早期 Sonnet 4 / Opus 4 不带这套原语,需要客户端自己实现。此外它和 Memory Tool(memory_20250818)配合使用尤其强大:被压缩掉的内容可以通过 Memory Tool 显式落盘后再被检索回来,相当于 Anthropic 把"长寿命 Agent 的上下文虚拟内存"做成了官方原语组合。