如何实现 Agent 的自我反思(Self-Reflection)和自我纠正?
难度:高级 分类:Agent 架构
简短回答
Agent 自我反思的核心框架是 Reflexion(Shinn et al., 2023),它将环境反馈转化为语言化的自我反思,存入长期记忆,供下一轮迭代参考——本质上是一种"语言化的强化学习"。除 Reflexion 外,还有 Self-Refine(迭代自我改进)、Self-Debug(自动调试代码)、Self-RAG(自我评估检索质量)等变体。关键争议在于:LLM 能否在没有外部反馈的情况下真正自我纠正推理?
详细解析
为什么需要自我反思?
传统 Agent 执行失败后通常只是简单重试,不会从失败中学习。自我反思赋予 Agent "元认知"能力——它不仅执行任务,还能回顾自己的表现、识别错误原因、生成改进建议,并在后续尝试中应用这些经验。
类比人类学习:
•
无反思:做错题 → 重做一遍 → 可能还是错
•
有反思:做错题 → 分析为什么错 → 总结规律 → 下次避免同类错误
Reflexion 框架详解
Reflexion 是最有影响力的 Agent 自我反思框架,核心思想是用语言反馈代替梯度更新。
三个核心组件
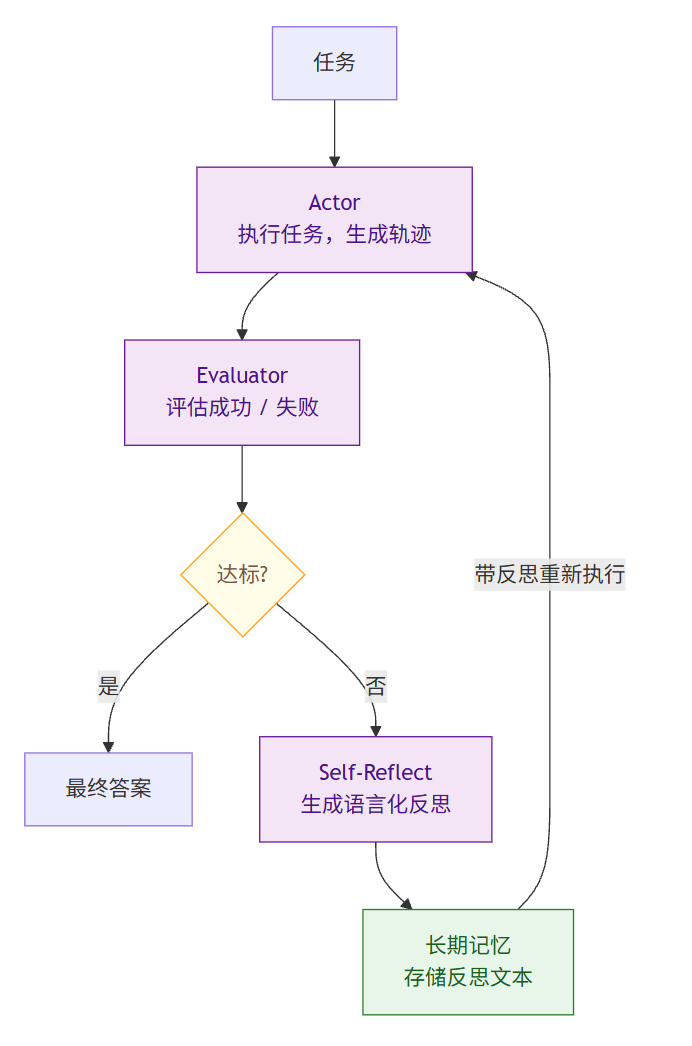
Reflexion 用语言反馈代替梯度更新:评估失败后生成语言化反思存入长期记忆,下一轮带着反思重新执行。
执行流程
代码块
Python
class ReflexionAgent:
def __init__(self, actor_llm, evaluator, reflector_llm):
self.actor = actor_llm
self.evaluator = evaluator
self.reflector = reflector_llm
self.memory = [] # 长期反思记忆
def run(self, task: str, max_trials: int = 3) -> str:
for trial in range(max_trials):
# 1. Actor 执行任务(带上历史反思作为上下文)
trajectory = self.actor.execute(
task=task,
past_reflections=self.memory
)
# 2. Evaluator 评估结果
score, feedback = self.evaluator.evaluate(task, trajectory)
if score >= THRESHOLD:
实验结果
•
AlfWorld(顺序决策任务):ReAct + Reflexion 完成 130/134 任务,显著优于纯 ReAct
•
HumanEval / MBPP(代码生成):Reflexion 超越先前 SOTA
•
LeetCode Hard:Reflexion 在困难编程题上展现出从失败中学习的能力
实现自我反思的多种模式
模式 1:内置反思循环
在单次任务内加入反思步骤:
代码块
Plain Text
# Agent 完成初稿后自我审查
draft = agent.generate(task)
critique = agent.reflect(
f"审查你的输出:\n{draft}\n"
f"列出可能的问题、遗漏或改进点。"
)
final = agent.revise(draft, critique)
模式 2:双 Agent 反思(Andrew Ng 推荐)
用两个 Agent 实现:一个生成,一个批评:
代码块
Plain Text
# Generator Agent + Critic Agent
generator = Agent(system_prompt="生成高质量的代码实现")
critic = Agent(system_prompt="你是严格的代码审查者,找出所有问题")
output = generator.run(task)
for round in range(max_rounds):
criticism = critic.review(output)
if criticism.no_issues:
break
output = generator.revise(output, criticism)
模式 3:基于测试的自我纠正(Self-Debug)
特别适合代码生成场景:
代码块
Python
def self_debug_loop(task: str, max_attempts: int = 3) -> str:
code = llm.generate_code(task)
关键争议:LLM 能真正自我纠正吗?
Huang et al. (2023) 的研究《Large Language Models Cannot Self-Correct Reasoning Yet》指出:
•
没有外部反馈时,LLM 的"自我纠正"可能反而把正确答案改错
•
有外部反馈时(如测试结果、搜索结果),自我纠正才真正有效
•
关键区别:"intrinsic self-correction"(纯内省)vs "extrinsic self-correction"(基于外部信号)
实践建议:不要依赖 LLM 凭空反思。确保反思环节有外部信号输入——测试结果、评估分数、工具返回值、人工反馈。
Self-Reflection vs Self-Correction 的区别
三者互补:先 Self-Evaluation(发现问题)→ Self-Reflection(分析原因)→ Self-Correction(修复问题)。
常见误区 / 面试追问
误区:"让 LLM 反思就能提升效果" — 无外部信号的纯内省可能适得其反。Reflexion 的效果来源于环境反馈(Evaluator),不是 LLM 凭空反思。
误区:"反思越多轮越好" — 过多反思轮次增加成本且可能引入过度修正。通常 2-3 轮反思就够,设置反思轮次上限。
追问:"Reflexion 的记忆如何管理?" — 论文使用滑动窗口保留最近的反思。生产中可用向量数据库存储,按相关性检索历史反思。
追问:"如何区分'值得反思的失败'和'不可恢复的失败'?" — 工具不存在、权限不足等结构性问题不需要反思,直接报错。逻辑错误、策略选择错误才适合反思。结合错误分类(详见第 006 题《Agent Loop 设计与错误恢复》中的错误分类与路由章节)来决定。
场景追问:"你的 Agent 在反思后反而把正确答案改错了,用户反馈'你之前是对的,为什么要改'。如何防止?" — 这是"过度反思"问题。解决路径:(1) 加入置信度阈值,当 Agent 对初始答案很有信心时跳过反思;(2) 反思后对比新旧答案,如果差异过大需要理由说明;(3) 实施"反思审查"——用另一个 LLM 评估反思是否合理;(4) 限制反思轮次,通常 1-2 轮足够;(5) 在用户反馈"改错了"时记录为负面样本,训练模型识别何时不应反思。
场景追问:"你的代码生成 Agent 反复修复代码但每次都有新 bug,测试通过率始终低于 30%。如何优化?" — 这是"修复引入新错误"问题。优化路径:(1) 实施测试驱动的修复流程 → Agent 必须先看测试失败原因再修改;(2) 加入局部修改原则 → 只修改与失败测试相关的代码段,避免大范围改动;(3) 使用更强的模型进行反思和修复,代码生成和验证用不同模型;(4) 实施增量验证 → 每次修复后只运行相关测试子集,快速验证;(5) 当连续修复失败时转人工介入,避免浪费时间。
场景追问:"你的 Agent 面对复杂问题时反思轮次过多,用户等待时间超过 30 秒。如何提升响应速度?" — 这是"反思效率"问题。优化路径:(1) 并行化反思 → 在 Agent 执行主任务的同时,后台启动一个"反思 Agent"预判可能的问题;(2) 缓存反思结果 → 对相似的历史查询直接复用之前的反思;(3) 设置反思时间预算 → 单次反思不超过 X 秒;(4) 采用快速反思模式 → 用小模型快速扫描,只在必要时用大模型深度分析;(5) 流式输出 → 先给出初步答案,同时后台反思并在需要时更新答案。
追问:"自我反思在长程任务里为什么会失效?" — 因为自评的依据正是那份可能已经出错的上下文。任务越长上下文越膨胀,Agent 基于含错状态做自评,等于把错误"自我确认"下来,并在后续轮次里持续传播——这不是反思轮数不够,而是反馈来源根本不独立。LongHorizon-Harness(2026)的解法是把校验从主 Agent 里拆出去:交给一个独立的、只读环境的 Auditor,且状态只接受环境已验证的事实,模型自己的断言不入状态。WeaveBench 上 51.8% → 80.7%。这条同时也是对 Reflexion 的边界限定:反思的可靠性取决于反馈是否来自环境,自评 ≠ 环境验证。
参考资料
•
Reflexion: Language Agents with Verbal Reinforcement Learning (arXiv:2303.11366)
•
Self-Reflection in LLM Agents: Effects on Problem-Solving Performance (arXiv:2405.06682)
•
Reflexion (Prompt Engineering Guide)
•
Agentic Design Patterns Part 2: Reflection (Andrew Ng / DeepLearning.AI)
•
How Do Agents Learn from Their Own Mistakes? (HuggingFace Blog)
•
LongHorizon-Harness: 长程任务中自评的错误传播与独立 Auditor 校验 (arXiv:2608.01964)