基于 LLM 的 Agent 金融分析系统
📜 简介
🏖️
Kronos 是一个专为金融市场"语言"——K线序列预训练的 decoder-only 基础模型系列。与通用时间序列预测模型(TSFM)不同,Kronos 专门设计用于处理金融数据独特的高噪声特性。它采用创新的两阶段框架:
📈 进行预测
使用 Kronos 进行预测非常简单,只需通过 KronosPredictor 类即可完成。该类处理数据预处理、归一化、预测和反归一化等步骤,让你仅用几行代码就能从原始数据获得预测结果。
📍
重要提示:Kronos-small 和 Kronos-base 的 max_context 值为 512。这是模型能处理的最大序列长度。为获得最佳性能,建议输入数据长度(即 lookback)不要超过此限制。KronosPredictor 会自动处理较长上下文的截断。
加载分词器和模型
首先,从 Hugging Face Hub 加载预训练的 Kronos 模型及其对应的分词器。
代码块
Python
from model import Kronos, KronosTokenizer, KronosPredictor
# Load from Hugging Face Hub
tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base")
model = Kronos.from_pretrained("NeoQuasar/Kronos-small")
实例化预测器
创建 KronosPredictor 的实例,传入模型、分词器以及所需的设备。
代码块
Python
# Initialize the predictor
predictor = KronosPredictor(model, tokenizer, max_context=512)
准备输入数据
predict 方法需要三个主要输入:
•
df:包含历史 K 线数据的 pandas DataFrame。必须包含列 ['open', 'high', 'low', 'close']。volume 和 amount 为可选列。
•
x_timestamp:与 df 中历史数据对应的时间戳 pandas Series。
•
y_timestamp:你想要预测的未来时间段的时间戳 pandas Series。
代码块
Python
生成预测
调用 predict 方法生成预测。您可以通过 T、top_p 和 sample_count 等参数控制概率性预测的采样过程。
代码块
Python
# Generate predictions
predict 方法返回一个 pandas DataFrame,包含 open、high、low、close、volume 和 amount 的预测值,并以您提供的 y_timestamp 作为索引。
为实现多时间序列的高效处理,Kronos 提供了 predict_batch 方法,支持对多个数据集同时进行并行预测。这在需要一次性预测多个资产或时间段时尤为实用。
代码块
Python
批量预测的重要要求:
•
所有序列必须具有相同的历史长度(回看窗口)
•
所有序列必须具有相同的预测长度(pred_len)
•
每个 DataFrame 必须包含必需列:['open', 'high', 'low', 'close']
•
volume 和 amount 列为可选列,若缺失将自动填充零值
predict_batch 方法利用 GPU 并行机制实现高效处理,并自动为每个序列独立执行归一化与反归一化操作。
示例与可视化
有关包含数据加载、预测和绘图的完整可运行脚本,请参阅 examples/prediction_example.py。
运行此脚本将生成一个对比真实数据与模型预测结果的图表,类似于下图所示:
此外,我们还提供了一个无需交易量和成交额数据即可进行预测的脚本,可在 examples/prediction_wo_vol_example.py 中找到。
🔧 使用自有数据进行微调(A股市场示例)
我们提供了完整的流程,用于在您自己的数据集上对 Kronos 进行微调。作为示例,我们演示了如何使用 Qlib 准备中国A股市场数据并进行简单的回测。
免责声明: 本流程旨在演示微调过程,是一个简化示例而非生产就绪的量化交易系统。稳健的量化策略需要更复杂的技术(如投资组合优化和风险因子中性化)才能获得稳定的阿尔法收益。
微调过程分为四个主要步骤:
配置:设置路径和超参数
数据准备:使用 Qlib 处理和拆分数据
模型微调:微调 Tokenizer 和 Predictor 模型
回测:评估微调后模型的性能
环境要求
首先确保已安装 requirements.txt 中的所有依赖项
本流程依赖 qlib,请通过以下命令安装:
代码块
Shell
pip install pyqlib
需要准备 Qlib 数据。请遵循 Qlib 官方指南 下载并在本地设置数据。示例脚本假定您使用日频数据
步骤一:配置实验
所有数据、训练和模型路径的设置均集中在 finetune/config.py 中。在运行任何脚本前,请根据您的环境修改以下路径:
•
qlib_data_path: 您本地 Qlib 数据目录的路径。
•
dataset_path: 用于保存处理后的训练/验证/测试 pickle 文件的目录。
•
save_path: 保存模型检查点的基目录。
•
backtest_result_path: 用于保存回测结果的目录。
•
pretrained_tokenizer_path 和 pretrained_predictor_path: 您希望从中开始训练的预训练模型路径(可以是本地路径或 Hugging Face 模型名称)。
您还可以调整其他参数,如 instrument、train_time_range、epochs 和 batch_size,以适应您的具体任务。如果不使用 Comet.ml,请设置 use_comet = False。
步骤 2:准备数据集
运行数据预处理脚本。该脚本将从您的 Qlib 目录加载原始市场数据,进行处理,将其分割为训练集、验证集和测试集,并保存为 pickle 文件。
代码块
Shell
python finetune/qlib_data_preprocess.py
运行后,您将在配置文件中 dataset_path 指定的目录中找到 train_data.pkl、val_data.pkl 和 test_data.pkl。
步骤 3:运行微调
微调过程包含两个阶段:首先微调分词器,然后微调预测器。两个训练脚本均设计为使用 torchrun 进行多 GPU 训练。
3.1 微调分词器
此步骤调整分词器以适应您特定领域的数据分布。
代码块
Shell
# Replace NUM_GPUS with the number of GPUs you want to use (e.g., 2)
torchrun --standalone --nproc_per_node=NUM_GPUS finetune/train_tokenizer.py
最佳分词器检查点将被保存到 config.py 中配置的路径(该路径由 save_path 和 tokenizer_save_folder_name 派生而来)。
3.2 微调预测器
此步骤针对预测任务微调主要的 Kronos 模型。
代码块
Shell
# Replace NUM_GPUS with the number of GPUs you want to use (e.g., 2)
最佳预测器检查点将被保存到 config.py 中配置的路径。
步骤 4:通过回测进行评估
最后,运行回测脚本来评估您微调后的模型。该脚本会加载模型,在测试集上执行推理,生成预测信号(例如,预测价格变动),并运行一个简单的 Top-K 策略回测。
代码块
Shell
# Specify the GPU for inference
python finetune/qlib_test.py --device cuda:0
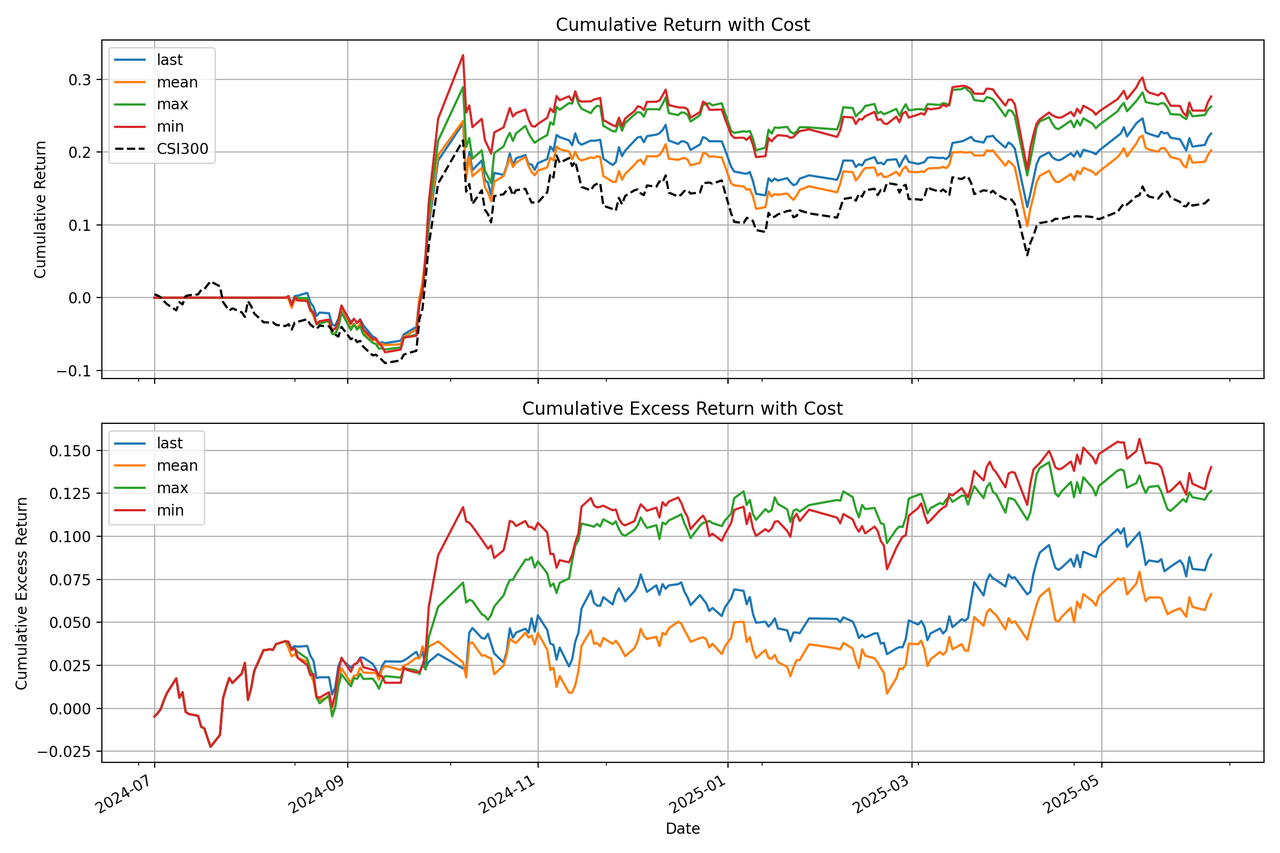
脚本将在控制台输出详细的性能分析,并生成一张图表,显示您的策略相对于基准的累计收益曲线,类似于下图所示:
💡 从演示到生产:重要注意事项
•
原始信号 vs. 纯Alpha: 本演示中模型生成的信号为原始预测。在实际量化工作流中,这些信号通常会被输入投资组合优化模型。该模型会施加约束以对冲常见风险因子(如市场Beta、规模和价值等风格因子)的敞口,从而分离出**"纯Alpha"**并提升策略的稳健性。
•
数据处理: 提供的 QlibDataset 是一个示例。对于不同的数据源或格式,您需要调整数据加载和预处理逻辑。
•
策略与回测复杂性: 此处使用的简单Top-K策略是一个基础起点。生产级策略通常包含更复杂的投资组合构建逻辑、动态头寸规模调整和风险管理(如止盈止损规则)。此外,高保真度的回测应精细地模拟交易成本、滑点及市场冲击,以更准确地评估实际表现。