LLM & VLM & Agent 面试回答参考
本文档旨在为大语言模型(LLM)、视觉语言模型(VLM)、智能体(Agent)、RAG及相关领域的面试提供一个全面的复习指南。仅提供1-6部分参考答案,7、8章节为半开放题目,可以自行借助AI或结合自身经历回答。
LLM 八股
1.1 请详细解释一下 Transformer 模型中的自注意力机制是如何工作的?它为什么比 RNN 更适合处理长序列?
参考答案: 自注意力(Self-Attention)机制是Transformer模型的核心,它使得模型能够动态地衡量输入序列中不同单词之间的重要性,并据此生成每个单词的上下文感知表示。
工作原理如下:
a.
生成Q, K, V向量: 对于输入序列中的每一个词元(token)的嵌入向量,我们通过乘以三个可学习的权重矩阵 WQ,WK,WV ,分别生成三个向量:查询向量(Query, Q)、键向量(Key, K)和值向量(Value, V)。
▪
Query (Q): 代表当前词元为了更好地理解自己,需要去“查询”序列中其他词元的信息。
▪
Key (K): 代表序列中每个词元所“携带”的,可以被查询的信息标签。
▪
Value (V): 代表序列中每个词元实际包含的深层含义。
b.
计算注意力分数: 为了确定当前词元(由Q代表)应该对其他所有词元(由K代表)投入多少关注,我们计算当前词元的Q与其他所有词元的K的点积。这个分数衡量了两者之间的相关性。
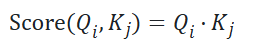
缩放(Scaling): 将计算出的分数除以一个缩放因子 dk( dk 是K向量的维度)。这一步是为了在反向传播时获得更稳定的梯度,防止点积结果过大导致Softmax函数进入饱和区。

Softmax归一化: 将缩放后的分数通过一个Softmax函数,使其转换为一组总和为1的概率分布。这些概率就是“注意力权重”,表示在当前位置,每个输入词元所占的重要性。
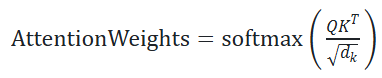
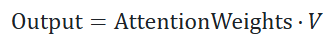
加权求和: 最后,将得到的注意力权重与每个词元对应的V向量相乘并求和,得到最终的自注意力层输出。这个输出向量融合了整个序列的上下文信息,且权重由模型动态学习得到。
为什么比RNN更适合处理长序列?
并行计算能力: 自注意力机制在计算时,可以一次性处理整个序列,计算所有位置之间的关联,是高度并行的。而RNN(包括LSTM、GRU)必须按照时间顺序依次处理每个词元,无法并行化,导致处理长序列时速度非常慢。
解决长距离依赖问题: 在自注意力中,任意两个位置之间的交互路径长度都是O(1),因为可以直接计算它们的注意力分数。而在RNN中,序列首尾两个词元的信息传递需要经过整个序列的长度,路径为O(N),这极易导致梯度消失或梯度爆炸,使得模型难以捕捉长距离的依赖关系。
1.2 什么是位置编码?在 Transformer 中,为什么它是必需的?请列举至少两种实现方式。
参考答案:
什么是位置编码?
位置编码(Positional Encoding, PE)是一个与词嵌入维度相同的向量,其目的是向模型注入关于词元在输入序列中绝对或相对位置的信息。它会与词元的词嵌入(Token Embedding)相加,然后一同输入到Transformer的底层。
为什么它是必需的?
Transformer的核心机制——自注意力,在计算时处理的是一个集合(Set)而非序列(Sequence)。它本身不包含任何关于词元顺序的信息,是 置换不变(Permutation-invariant) 的。这意味着,如果打乱输入序列中词元的顺序,自注意力层的输出也会相应地被打乱,但每个词元自身的输出向量(在不考虑softmax归一化的情况下)是相同的。这显然不符合自然语言的特性,因为语序至关重要(例如“我打你”和“你打我”含义完全相反)。因此,必须通过一种外部机制,将位置信息显式地提供给模型,这就是位置编码的作用。
至少两种实现方式:
正弦/余弦位置编码(Sinusoidal Positional Encoding): 这是原始Transformer论文《Attention Is All You Need》中使用的方法。它使用不同频率的正弦和余弦函数来生成位置编码,其公式如下:
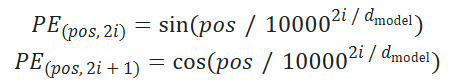
其中, pos 是词元在序列中的位置, i 是编码向量中的维度索引, dmodel 是嵌入维度。
优点:
可外推性: 能够处理比训练中最长序列还要长的序列。
相对位置信息: 模型可以轻易地学习到相对位置关系,因为对于任何固定的偏移量 k , PEpos+k 都可以表示为 PEpos 的一个线性函数,这使得模型更容易捕捉相对位置的依赖。
可学习的绝对位置编码(Learned Absolute Positional Encoding): 这种方法将位置编码视为模型参数的一部分,通过训练学习得到。具体来说,会创建一个形状为 (max_sequence_length, embedding_dimension) 的位置编码矩阵。在处理序列时,根据每个词元的位置索引,从这个矩阵中查找对应的编码向量,并加到词嵌入上。BERT和GPT-2等模型采用了这种方式。
优点: 模式更加灵活,可以让模型自己学习出最适合数据的位置表示。
缺点: 无法泛化到超过预设 max_sequence_length 的长度。如果需要处理更长的序列,就需要对位置编码进行微调或采用其他策略。
1.3 请你详细介绍ROPE,对比绝对位置编码它的优劣势分别是什么?
参考答案:
RoPE (Rotary Position Embedding) 介绍 RoPE,全称旋转位置编码,是目前大语言模型(如Llama系列、Qwen等)中最主流的位置编码方案之一。它是一种将位置信息融入自注意力机制的创新方法。
其核心思想是:通过向量旋转的方式,将绝对位置信息编码到Query和Key向量中,从而使得模型在计算注意力分数时,能够自然地利用相对位置信息。
工作原理: RoPE不再像传统位置编码那样直接将位置向量加到词嵌入上。它的操作发生在生成Q和K向量之后、计算注意力分数之前:
a.
维度分组: 将Q和K向量的 d 维特征两两一组,视为 d/2 个二维向量。
b.
构造旋转矩阵: 对于序列中的位置 m,构造一个与位置相关的旋转矩阵 Rm。这个矩阵在二维空间中表示一个旋转操作。
c.
旋转Q和K: 将每个二维向量组通过对应的旋转矩阵 Rm 进行旋转。
数学上,这个过程等价于将每个二维向量 (xm,xm+1) 看作一个复数,然后乘以一个复数 eimθ,其中 m 是位置, θ 是一个预设的、与维度相关的常数。这个操作只会改变向量的相位(方向),而不改变其模(长度)。
关键特性: RoPE的巧妙之处在于,经过旋转后的两个位置 m 和 n 的Query向量 qm 和Key向量 kn 进行点积运算时,其结果只与它们的相对位置 (m−n) 有关,而与它们的绝对位置 m 和 n 无关。这使得自注意力机制天然地具备了对相对位置的感知能力。
对比绝对位置编码的优劣势:
RoPE的优势:
a.
内置相对位置建模: 这是其最大的优势。RoPE使得注意力分数直接依赖于词元间的相对距离,这更符合自然语言中语法和语义依赖通常是相对的这一特性。
b.
良好的外推能力: 由于其数学性质,RoPE在处理比训练时更长的序列时表现出色,具有很强的长度泛化能力,这也是长序列LLM偏爱它的重要原因。
c.
不引入额外可训练参数: RoPE是一种函数式的、固定的编码方式,不需要像可学习位置编码那样占用模型参数。
d.
随着距离增加,依赖性衰减: 旋转的性质使得距离越远的词元,其内积关系会呈现周期性的衰减,符合语言中距离越远相关性越弱的直觉。
RoPE的劣势:
a.
理论理解相对复杂: 其背后的数学原理(复数、欧拉公式、旋转矩阵)比直接相加的绝对位置编码更抽象。
b.
对绝对位置信息的表征可能较弱: 虽然RoPE从绝对位置导出,但其在注意力机制中的核心作用是体现相对位置。对于那些强依赖绝对位置信息的特定任务(例如,判断一个词是否在句子开头),它的效果可能不如直接使用绝对位置编码直观。
1.4 你知道MHA,MQA,GQA的区别吗?详细解释一下。
参考答案: MHA、MQA和GQA是Transformer模型中三种不同的注意力机制变体,它们的主要区别在于如何组织和共享Query、Key和Value的“头”(Head),核心目标是在模型效果和推理效率(特别是显存占用)之间做出不同的权衡。
MHA (Multi-Head Attention)
这是原始Transformer论文中提出的标准注意力机制。
工作原理:
i.
将输入的Q、K、V向量分别通过 N 个独立的线性变换,得到 N 组不同的 Qi,Ki,Vi 头( i=1,...,N )。
ii.
这 N 组头在各自的子空间中并行地计算注意力(Scaled Dot-Product Attention)。
iii.
将 N 个头计算得到的输出向量拼接(Concatenate)起来。
MQA (Multi-Query Attention)
为了解决MHA在推理时的显存瓶颈而被提出。
工作原理:
与MHA一样,有 N 个独立的Query头。
核心区别: 所有的 N 个Query头共享同一个Key头和同一个Value头。
结构: N 个Query头,1个Key头,1个Value头。
优点: 极大地降低了推理成本。KV Cache的大小不再依赖于头的数量 N ,相比MHA减小了 N 倍,显著降低了显存占用,并加快了推理速度。
缺点: 可能会导致模型性能的下降。因为所有Query头被迫从同样的一组Key和Value中提取信息,模型的表达能力受到了一定的限制。
GQA (Grouped-Query Attention)
GQA是MHA和MQA之间的一个折中方案,旨在平衡性能和效率。
工作原理:
将 N 个Query头分成 G 组。
核心区别: 每组内的Query头共享一个Key头和一个Value头。总共有 G 个Key头和 G 个Value头。
结构: N 个Query头,G个Key头,G个Value头。(通常 1<G<N )。
说明:
当 G=N 时,GQA等价于MHA。
当 G=1 时,GQA等价于MQA。
优点: 在推理效率上远超MHA,同时在模型性能上优于MQA。它提供了一个灵活的旋钮,可以根据具体需求在效率和效果之间进行调整。Llama 2等模型就采用了GQA。
总结:
表格加载中...
1.5 请比较一下几种常见的 LLM 架构,例如 Encoder-Only, Decoder-Only, 和 Encoder-Decoder,并说明它们各自最擅长的任务类型。
参考答案:
LLM的架构主要可以分为三类,它们的核心区别在于使用了Transformer的哪些部分以及注意力机制的类型,这直接决定了它们各自擅长的任务。
Encoder-Only 架构 (例如 BERT, RoBERTa)
结构: 由多个Transformer Encoder层堆叠而成。
核心机制: 双向自注意力机制。在处理序列中的任何一个词元时,模型都可以同时关注到它左边和右边的所有词元。这使得模型能够获得非常丰富的上下文表示。
最擅长的任务类型:自然语言理解 (NLU)。
Decoder-Only 架构 (例如 GPT系列, Llama, Qwen)
结构: 由多个Transformer Decoder层堆叠而成,但移除了其中的Encoder-Decoder交叉注意力部分。
核心机制: 单向(因果)自注意力机制 (Causal Self-Attention)。在预测第 t 个词元时,模型只能关注到位置 1 到 t-1 的词元,不能看到未来的信息。这种自回归的特性天然适合生成任务。
最擅长的任务类型:自然语言生成 (NLG)。
具体任务:
▪
开放式文本生成: 写文章、故事、诗歌。
Encoder-Decoder 架构 (例如 T5, BART, 原始Transformer)
结构: 包含一个完整的Encoder栈和一个完整的Decoder栈。
核心机制: Encoder部分使用双向注意力来编码整个输入序列,形成一个全面的上下文表示。Decoder部分在生成输出时,一方面使用单向注意力处理已生成的序列,另一方面通过交叉注意力 (Cross-Attention)机制来关注Encoder的输出,确保生成内容与输入相关。
最擅长的任务类型:序列到序列 (Seq2Seq)。
具体任务:
a.
机器翻译: 将一种语言(输入序列)翻译成另一种语言(输出序列)。
b.
文本摘要: 将一篇长文章(输入序列)概括成几句话(输出序列)。
原因: 这类任务需要首先对源序列有一个完整的、全局的理解(由Encoder完成),然后基于这个理解有条件地生成一个目标序列(由Decoder完成)。
1.6 什么是Scaling Laws?它揭示了模型性能、计算量和数据量之间的什么关系?这对LLM的研发有什么指导意义?
参考答案: 什么是Scaling Laws? Scaling Laws(尺度定律)是由OpenAI、DeepMind等机构通过大量实验发现的一系列经验性规律。它揭示了大型语言模型的性能(通常以交叉熵损失函数Loss来衡量)与三个关键资源要素——模型参数规模(N)、训练数据集大小(D)和训练所用的计算量(C)——之间存在着可预测的幂律关系(Power-Law Relationship)。
揭示了什么关系?
性能的可预测性: Scaling Laws表明,模型的性能损失会随着N、D、C的增加而平滑地、可预测地下降。这种关系可以用一个幂律公式来描述,例如,当数据和计算量足够时,模型损失 L 与模型参数量 N 的关系大致为: L(N)∝N−α ,其中 α 是一个小的正指数。这意味着我们可以通过在小规模模型上的实验结果,来外推(predict)更大规模模型可能达到的性能。
瓶颈效应: 模型的最终性能会被N、D、C中最受限的那个因素所制约。如果仅仅增加模型大小而不增加数据量,性能提升会很快达到瓶颈;反之亦然。为了有效提升模型性能,必须协同扩展这三个要素。
资源的最优分配: 对于一个给定的计算预算(FLOPs),存在一个最优的模型大小(N)和数据量(D)的组合。DeepMind的Chinchilla论文是一个里程碑式的发现,它修正了早期认为应该优先扩大模型规模的观点,指出为了达到计算最优,模型参数量和训练数据量应该近似1:20的比例进行扩展。例如,训练一个70B参数的模型,大约需要1.4万亿个token的数据。
对LLM研发的指导意义:
科学指导项目规划: 在投入数百万甚至数千万美元进行一次大规模训练之前,研究机构可以先通过小规模实验拟合出自己数据集和模型架构下的Scaling Law。这使得他们能够科学地预测最终模型的性能,评估项目的投资回报率,并合理申请计算资源。
优化资源配置,避免浪费: Scaling Laws,特别是Chinchilla定律,为如何高效使用计算预算提供了明确的指导。它告诉我们,与其训练一个参数巨大但数据不足的模型(over-trained),不如用同样的算力去训练一个参数稍小但数据更充分的模型(under-trained),后者效果可能更好。这促使业界从单纯追求“大参数”转向“大参数与大数据的平衡”。
强调数据的重要性: Scaling Laws的发现,让学术界和工业界都更加深刻地认识到,高质量、大规模的训练数据和模型参数规模同等重要,甚至在某些阶段更为关键。这推动了数据工程、数据清洗和高质量合成数据生成等领域的发展。
1.7 在LLM的推理阶段,有哪些常见的解码策略?请解释 Greedy Search, Beam Search, Top-K Sampling 和 Nucleus Sampling (Top-P) 的原理和优缺点。
参考答案: 在LLM的推理(或称解码)阶段,模型会生成一个词元概率分布,解码策略决定了如何从这个分布中选择下一个词元。常见的策略可以分为确定性和随机性两类。
Greedy Search (贪心搜索)
原理: 在每个时间步,总是选择当前概率分布中概率最高的那个词元作为输出。
优点:
速度快: 计算开销最小,实现最简单。
缺点:
局部最优: 每一步的“贪心”选择可能导致整个序列不是全局最优的。一个高概率的词后面可能跟着一系列低概率的词,最终序列的总概率反而不高。
缺乏多样性: 输出是完全确定的,对于同一个输入,每次生成的结果都一样,内容往往比较呆板、重复。
Beam Search (集束搜索)
原理: 这是对贪心搜索的改进。它在每个时间步会保留 k 个( k 称为 "beam width" 或 "beam size")最有可能的候选序列。在下一步,它会从这 k 个候选序列出发,生成所有可能的下一个词元,然后从所有这些扩展出的新序列中,再次选出累计概率最高的 k 个。最后,从最终的 k 个完整序列中选择最优的一个。
优点:
质量更高: 通过探索更广的搜索空间,通常能找到比贪心搜索概率更高、质量更好的序列。
缺点:
计算成本高: 需要维护 k 个候选序列,计算和内存开销是贪心搜索的 k 倍。
仍然倾向于安全和高频: 优化目标是全局概率,这使得它还是倾向于生成常见、安全的句子,可能缺乏创造性,并且在长文本生成中容易出现重复。
Top-K Sampling (Top-K 采样)
原理: 这是一种随机采样策略。在每个时间步,不再是选择最优的,而是:
a.
从整个词汇表的概率分布中,筛选出概率最高的 K 个词元。
b.
将这 K 个词元的概率进行归一化(使它们的和为1)。
c.
在这 K 个词元中,根据新的概率分布进行随机采样。
优点:
◦
增加多样性: 引入了随机性,使得生成内容更加丰富、有趣和不可预测。
缺点:
◦
K值固定: K 是一个固定的超参数。当概率分布很尖锐时(模型非常确定下一个词),一个大的K可能会引入不相关的词;当概率分布很平坦时(模型不确定),一个小的K可能会限制模型的选择。
1.1
Nucleus Sampling / Top-P Sampling (核心采样)
原理: 这是对Top-K采样的改进,它使用一个动态的候选词元集。
a.
将所有词元按概率从高到低排序。
b.
从概率最高的词元开始,逐个累加它们的概率,直到总概率之和超过一个预设的阈值 p(例如 p=0.95)。
c.
这个累加过程中包含的所有词元构成了“核心(Nucleus)”候选集。
d.
然后,在这个动态大小的候选集中,根据它们的原始概率进行归一化和随机采样。
优点:
◦
自适应候选集: 候选集的大小会根据上下文动态变化。当模型对下一个词非常确定时,概率分布尖锐,可能只有一两个词的概率和就超过了 p,候选集就很小,生成更精确;当模型不确定时,概率分布平坦,需要包含更多词才能达到 p,候选集就变大,允许更多探索。
1.8 什么是词元化?请比较一下 BPE 和 WordPiece 这两种主流的子词切分算法。
参考答案: 什么是词元化(Tokenization)? 词元化是将原始的文本字符串分解成一个个独立的单元(称为“词元”或“token”),并将这些词元映射到唯一的整数ID的过程。这是自然语言处理模型处理文本的第一步,因为模型只能处理数字输入。
现代大型语言模型普遍采用 子词(Subword) 词元化算法,它介于按词切分和按字符切分之间。这样做的好处是:
有效处理未登录词(OOV): 任何罕见词或新词都可以被拆解成已知的子词组合,避免了“未知”标记。
平衡词表大小与序列长度: 相比于词级别,词表规模大大减小;相比于字符级别,生成的序列长度又不会过长,兼顾了效率。
保留形态信息: 像 "running", "runner" 这样的词可以共享 "run" 这个子词,使得模型能够理解词根和词缀的关系。
BPE vs. WordPiece
BPE和WordPiece是两种最主流的子词切分算法,它们构建词表的过程相似,但在合并子词的决策标准上有所不同。
BPE (Byte Pair Encoding)
工作原理:
a.
初始化: 词汇表由语料库中出现的所有基本字符组成。
b.
迭代合并: 重复以下步骤直到达到预设的词表大小: a. 在整个语料库中,统计所有相邻词元对的出现频率。 b. 找出频率最高的那个词元对(例如 ('e', 's'))。 c. 将这个词元对合并成一个新的、更长的词元('es'),并将其加入词汇表。 d. 在语料库中,用新词元替换所有出现的该词元对。
应用模型: GPT系列、Llama等。
特点: 算法思想简单直观,完全基于数据中符号对的出现频率。
WordPiece
工作原理:
应用模型: BERT, DistilBERT, Electra。
特点: WordPiece在切分时,通常会在单词的非起始部分子词前加上特殊符号(如##),例如 "tokenization" 可能会被切分为 ("token", "##ization")。
主要区别总结:
1.9 你觉得NLP和LLM最大的区别是什么?两者有何共同和不同之处?
参考答案: NLP(自然语言处理)和LLM(大型语言模型)之间是领域与技术、一般与具体的关系。LLM是NLP发展至今最前沿、最具影响力的一项技术范式,它在很大程度上重塑了NLP领域。
共同之处:
最终目标一致: 两者的根本目标都是实现人工智能对人类语言的理解、生成、和运用,即所谓的“人工智能皇冠上的明珠”。
技术根基相通: 现代NLP和LLM都建立在深度学习,特别是神经网络的基础上。Transformer架构是连接两者的关键桥梁,从BERT到GPT,都是其思想的延伸和发展。
最大的区别与不同之处:
最大的区别在于研究和应用范式的根本性转变,从“为每个任务训练一个模型”转向“用一个模型解决所有任务”。
具体可以从以下几个维度来看:
任务处理范式 (Task-Handling Paradigm):
传统NLP: 奉行“分而治之”的策略。研究者会针对每一个具体的NLP任务(如机器翻译、情感分析、命名实体识别)设计特定的模型架构、损失函数和训练数据集,遵循Pre-train -> Fine-tune的流程。每个模型都是一个“专家”。
LLM: 追求“大一统”的通用模型。通过在海量数据上进行大规模预训练,一个LLM基础模型就具备了解决多种任务的潜力。用户通过设计不同的 提示(Prompt) 或提供 上下文示例(In-context Learning) 来引导模型完成任务,大大简化了开发流程,甚至实现了 零样本(Zero-shot) 和 少样本(Few-shot) 学习。
模型能力与“涌现” (Model Capabilities & Emergence):
传统NLP: 模型的能 力是明确且有限的,通常与其训练目标直接相关。
LLM: 当模型规模(参数、数据、算力)跨越某个阈值后,会表现出小模型上不存在的 “涌现能力” (Emergent Abilities) 。例如,复杂的逻辑推理(思维链, Chain-of-Thought)、代码生成、遵循复杂指令等。这些能力不是被直接训练的,而是从海量数据中自发学习到的。
规模 (Scale):
传统NLP: 模型参数量通常在百万级到几亿级(例如,BERT-base约1.1亿)。
LLM: 参数量从百亿(Billion)起步,发展到千亿甚至万亿级别。训练数据和所需计算资源也比传统NLP模型高出几个数量级。
交互与应用方式 (Interaction & Application):
传统NLP: 通常以API形式被集成到软件中,输入输出格式相对固定。
总结: 如果说传统NLP是在打造一支由各种“工具专家”组成的工具箱,那么LLM则是在努力打造一个“瑞士军刀”式的通用智能工具,它可能在某些特定任务上不如专用工具精细,但其通用性、灵活性和强大的涌现能力是前所未有的。
1.10 L1和L2正则化分别是什么,什么场景适合使用呢?
参考答案: L1和L2正则化都是在机器学习和深度学习中用于防止模型过拟合的常用技术。它们通过在模型的损失函数(Loss Function)中添加一个代表模型复杂度的惩罚项来实现这一目标。
L1 正则化 (L1 Regularization / Lasso)
定义: L1正则化添加的惩罚项是模型所有权重参数 wi 的绝对值之和,乘以一个正则化系数 λ。
核心作用:产生稀疏性 (Sparsity)。 在梯度下降优化过程中,L1惩罚项会驱使那些对模型贡献不大的特征的权重最终变为精确的0。这相当于从模型中完全移除了这些特征。
适用场景:特征选择 (Feature Selection)。 当你的数据集中包含大量特征,但你怀疑其中许多特征是冗余或无用的时,L1正则化非常有用。它能够自动地“筛选”出最重要的特征,简化模型,提高解释性。
L2 正则化 (L2 Regularization / Ridge / Weight Decay)
定义: L2正则化添加的惩罚项是模型所有权重参数 wi 的平方和,乘以一个正则化系数 λ。
核心作用:权重衰减 (Weight Decay)。 L2正则化会惩罚大的权重值,它会促使模型的权重参数尽可能小,趋近于0但通常不会等于0。这使得模型的权重分布更加平滑和分散,避免模型过度依赖少数几个高权重的特征。
适用场景:通用性的过拟合防治。 L2是更常用、更通用的正则化方法。当特征之间可能存在相关性(共线性),或者你认为绝大多数特征都对预测有或多或少的贡献时,L2是首选。它能有效地提高模型的泛化能力,使其在未见过的数据上表现更好。在深度学习中,“权重衰减”通常就是指L2正则化。
总结对比:
1.11 “涌现能力”是大型模型中一个备受关注的现象,请问你如何理解这个概念?它通常在模型规模达到什么程度时出现?
参考答案: 对“涌现能力”的理解: “涌现能力”(Emergent Abilities)是指那些在小型模型中不存在或表现不佳,但当模型规模(包括参数量、训练数据和计算量)达到某个临界点后,突然出现并显著超越随机水平的能力。它的核心特征是非线性和不可预测性:
非线性增长: 这种能力的性能表现并不随着模型规模的增加而平滑、线性地提升。相反,它会在某个规模区间内发生“相变”式的跃迁,性能从接近随机猜测的水平迅速提升到非常高的水平。
非直接训练: 这些高级能力通常不是通过特定的监督学习目标直接训练出来的。例如,我们没有直接教模型如何“一步一步思考”,但当模型足够大时,它通过学习海量文本中的逻辑关系,自发地获得了这种能力。
典型的涌现能力例子包括:
思维链(Chain-of-Thought, CoT): 在面对需要多步推理的数学或逻辑问题时,通过提示模型“一步一步地思考”,大模型可以生成一个连贯的推理过程并得出正确答案。小模型则无法利用这种提示。
上下文学习(In-context Learning): 无需更新模型权重,仅在Prompt中提供几个任务示例(Few-shot),大模型就能“学会”并执行这个新任务。
执行复杂指令: 理解并遵循包含多个步骤、约束和否定逻辑的复杂人类指令。
出现的模型规模: 涌现能力出现的具体规模没有一个固定的数值,它取决于能力本身、模型架构、数据质量和评估任务的复杂性。
然而,根据Google等机构的标志性研究,许多引人注目的涌现能力,例如思维链推理,通常是在模型参数规模达到百亿(tens of billions)到千亿(a hundred billion) 级别时开始出现的。
例如,在Google PaLM模型的实验中,思维链推理能力在62B参数的模型上开始显现,而在8B和16B的模型上则完全无效。这种能力随着模型增长到540B时变得更加强大和稳定。
总而言之,“涌现能力”是“量变引起质变”在大型模型领域的生动体现,它表明单纯地扩大规模可以解锁全新的、更高级的认知能力,这也是当前LLM研究持续推动模型规模增长的核心驱动力之一。
1.12 激活函数有了解吗,你知道哪些LLM常用的激活函数?为什么选用它?
参考答案: 是的,我了解激活函数。激活函数是神经网络中至关重要的一环,它的主要作用是为网络引入非线性(non-linearity)。如果没有激活函数,多层神经网络本质上等同于一个单层的线性模型,无法学习和拟合复杂的数据模式。
在现代大型语言模型(Transformer架构)中,最常用的激活函数主要有两个:GeLU 和 SwiGLU。
GeLU (Gaussian Error Linear Unit):
简介: GeLU曾是Transformer模型中的主流激活函数,被BERT、GPT-2等经典模型采用。它的数学形式是 x⋅Φ(x),其中 Φ(x) 是高斯分布的累积分布函数。
为什么选用它?
平滑性: GeLU是ReLU的一个平滑近似。相比于ReLU在0点的突变,GeLU的平滑特性使其在优化过程中梯度更稳定,更有利于模型收敛。
随机正则化思想: GeLU可以看作是综合了Dropout和ReLU的思想。它根据输入的数值大小,对其进行随机的“归零”或“保留”,但这个过程是确定性的。输入越小,其输出被“归零”的概率越高。
SwiGLU (Swish-Gated Linear Unit):
简介: SwiGLU是目前最先进、最主流的选择,被Llama、PaLM、Mixtral、Gemma等一系列现代LLM广泛采用。它属于门控线性单元(Gated Linear Unit, GLU) 家族的变体。
工作原理: 它将前馈网络(FFN)的第一个线性层的输出 X 分成两部分, A 和 B 。然后通过公式 Swish(A)⊗B 计算输出,其中 Swish(x)=x⋅σ(x) , σ 是Sigmoid函数, ⊗ 是逐元素相乘。
为什么选用它?
门控机制(Gating Mechanism): SwiGLU的核心优势在于其“门控”设计。 B 部分可以被看作一个动态的“门”,它可以根据输入内容,控制 Swish(A) 中的信息哪些可以通过、哪些需要被抑制。这种机制显著增强了模型的表达能力,使得FFN层可以更灵活地处理信息。
实证效果优越: Google在PaLM论文中的实验发现,使用SwiGLU替换标准的GeLU或ReLU,可以显著提升模型的性能(降低困惑度)。尽管SwiGLU会增加FFN层的参数量(因为需要两个矩阵而不是一个),但其带来的性能增益被证明是值得的。
1.13 混合专家模型(MoE)是如何在不显著增加推理成本的情况下,有效扩大模型参数规模的?请简述其工作原理。
参考答案: 混合专家模型(Mixture of Experts, MoE)是一种模型架构,它的核心思想是通过 “稀疏激活”(Sparse Activation) 的策略,来解决模型规模与计算成本之间的矛盾。它允许模型拥有巨大的总参数量,但在处理任何一个输入时,只动用其中一小部分参数,从而在不显著增加推理成本(FLOPs)的情况下,大幅提升模型容量。
工作原理如下:
用“专家”替换FFN层:
◦
在标准的Transformer架构中,计算量最大的部分之一是前馈网络(Feed-Forward Network, FFN)层。
动态路由决策:
◦
当一个词元(token)的向量表示来到MoE层时,它首先被送入路由器。
◦
路由器的作用是 “决策” ,判断这个token应该由哪些专家来处理最合适。它会输出一个包含N个分数的向量,代表该token与N个专家的“匹配度”。
Top-K稀疏激活:
◦
路由器输出的分数经过Softmax归一化后,系统并不会激活所有的专家。相反,它只选择分数最高的Top-K个专家(K通常很小,比如1或2)。
◦
这就是“稀疏激活”的关键:对于每一个token,只有极少数(K个)专家被激活并进行计算,其余的(N-K个)专家则完全不参与,不产生任何计算成本。
加权输出:
◦
被选中的K个专家分别对输入的token向量进行处理,得到K个输出向量。
◦
最终的输出是这K个输出向量的加权和,权重同样由路由器的输出分数决定。
如何实现“参数大但成本低”?
•
假设一个模型有8个专家(N=8),并且每次只激活2个(K=2),如Mixtral-8x7B模型。
•
总参数量: 模型的总参数量是所有共享部分(如注意力层)的参数量,加上所有8个专家的参数量之和。这使得模型的总参数规模可以非常大(例如达到47B)。
•
推理成本: 但在进行一次前向传播(推理)时,对于任意一个token,实际参与计算的只有共享部分和被激活的2个专家。因此,其计算量(FLOPs)约等于一个规模小得多的“稠密”模型(例如一个13B的模型)。
•
结论: MoE成功地将总参数量(代表模型的知识容量)和单次推理的计算量(代表模型的速度和成本)解耦,从而实现了“用小模型的成本,获得大模型的知识”。
1.14 在训练一个百或千亿参数级别的 LLM 时,你会面临哪些主要的工程和算法挑战?(例如:显存、通信、训练不稳定性等)
参考答案: 训练百亿或千亿参数级别的LLM是一个巨大的系统工程,涉及硬件、软件和算法的深度协同。其挑战主要体现在以下三个方面:
显存挑战 (Memory Wall):
•
问题: 一个千亿参数的模型,其模型参数、梯度、优化器状态(如Adam中的动量和方差)加起来需要数TB的存储空间,远远超出了任何单张GPU的显存(目前最先进的H100也只有80GB)。
•
解决方案(3D并行):
◦
数据并行 (Data Parallelism, DP): 最基础的并行方式。在每张卡上都保留一份完整的模型副本,但将数据切分成多个batch,每张卡处理一个batch。计算完成后通过All-Reduce操作同步梯度。这种方式不能解决单卡显存不足的问题。
◦
流水线并行 (Pipeline Parallelism, PP): 将模型的层(layers)进行垂直切分,不同的GPU负责模型的一部分(例如,GPU-1负责1-16层,GPU-2负责17-32层)。这可以有效降低单卡显存,但会引入“流水线气泡”(pipeline bubbles),即部分GPU在等待上下游数据时会处于空闲状态。
◦
张量并行 (Tensor Parallelism, TP): 将模型中的单个大算子(如大的权重矩阵)进行水平切分,放到不同的GPU上协同计算。例如,将一个大的矩阵乘法分解到多张卡上。这也能降低单卡显存,但会引入非常高的通信开销。
◦
ZeRO (Zero Redundancy Optimizer): 由微软DeepSpeed提出的显存优化技术。它在数据并行的基础上,将优化器状态、梯度、甚至模型参数也进行切分,分布到所有GPU上。每个GPU只保留自己需要计算的那一部分,极大地降低了单卡的显存冗余,是目前大规模训练的标配。
通信挑战 (Communication Bottleneck):
•
问题: 上述所有并行策略都引入了大量的GPU间通信。例如,DP需要同步梯度,PP需要传递激活值,TP需要在每次前向和后向传播中交换计算结果。当GPU数量巨大时,通信所需的时间可能超过计算本身,成为整个训练的瓶颈。
•
解决方案:
◦
硬件层面: 使用高速互联技术,如单机内的NVLink和跨节点的InfiniBand网络。
◦
软件层面: 开发高效的通信算法(如Ring All-Reduce),并设计调度策略来将计算和通信操作重叠(overlap),以隐藏通信延迟。
训练不稳定性挑战 (Training Instability):
•
问题: 训练如此巨大的模型在数值上非常脆弱。由于计算层数极深、数据量极大,训练过程中很容易出现梯度爆炸或消失,导致损失(Loss)突然飙升为NaN(Not a Number),使得数小时甚至数天的训练成果毁于一旦。
•
解决方案:
◦
数值精度: 普遍采用 BF16 (BFloat16) 混合精度训练。BF16相比FP16有更大的动态范围,能有效避免梯度下溢,同时保持FP32的稳定性。同时,关键部分(如优化器的master weights)仍保留FP32以保证精度。
1.15 开源框架了解过哪些?Qwen,Deepseek的论文是否有研读过,说一下其中的创新点主要体现在哪?
参考答案:
开源框架:
•
基础框架: PyTorch 是目前大模型研究和开发的事实标准,提供了灵活的张量计算和自动微分能力。
•
模型与生态: Hugging Face Transformers 是最重要的模型库和生态系统,它极大地降低了使用和分享模型的门槛。
•
大规模训练: DeepSpeed (微软) 和 Megatron-LM (英伟达) 是进行大规模分布式训练的核心框架,它们实现了上述的3D并行、ZeRO等关键技术。
•
高效推理: vLLM, TensorRT-LLM 等框架专注于优化LLM的推理速度和吞吐量,通过PagedAttention等技术来解决KV Cache的显存瓶颈。
Qwen系列(可以参考开源论文自行回答,Qwen2.5,Qwen3系列)
Deepseek系列(可以参考开源论文自行回答,如GRPO)
1.16 最近读过哪些LLM比较前沿的论文,聊一下它的相关方法,针对什么问题,提出了什么方法,对比实验有哪些?
•
参考答案: (这是一个开放性问题,回答时应选择1-2篇自己真正理解的、有影响力的近期论文。)
VLM 八股
2.1 多模态大模型(如 VLM)的核心挑战是什么?即如何实现不同模态信息(如视觉和语言)的有效对齐和融合?
•
参考答案: 多模态大模型(VLM)的核心挑战在于解决 “模态鸿沟”(Modality Gap) 。视觉信息(如图像、视频)是以像素矩阵的形式存在的,密集、具体且连续;而语言信息是以离散的符号(token)序列存在的,稀疏、抽象且结构化。如何让模型跨越这两种完全不同的数据形式,实现有效的理解和推理,是VLM研究的中心问题。
这个挑战的解决方案主要包含两个关键环节:
对齐(Alignment):建立跨模态的语义连接
◦
目标: 对齐的目标是让模型理解视觉世界中的“概念”和人类语言中的“符号”是指代的同一事物。例如,模型需要知道图片中的一只奔跑的狗的像素集合,和文本描述“a running dog”在语义上是等价的。
◦
实现方式: 主流方法是表示空间对齐。通过设计一个训练任务,将图像和其对应的文本描述映射到一个共享的或可比较的向量空间中。在这个空间里,匹配的图文对的向量表示距离很近,而不匹配的图文对则距离很远。CLIP模型使用的对比学习就是实现对齐的经典范式。
融合(Fusion):实现跨模态信息的深度交互
◦
目标: 在对齐的基础上,让两种模态的信息能够深度地交互,以完成更复杂的推理任务,而不仅仅是识别。例如,回答“图片中穿红色衣服的人在做什么?”就需要同时理解“红色衣服”(视觉属性)和“做什么”(动作识别),并将它们结合起来推理。
◦
实现方式: 主流的融合方法包括:
▪
连接器(Connector): 将视觉编码器提取的视觉特征,通过一个小的、可训练的模块(如MLP或Q-Former),转换为LLM能够理解的“视觉词元”(Visual Tokens),然后与文本词元拼接起来,送入LLM统一处理。LLaVA是这种方式的代表。
2.2 请解释 CLIP 模型的工作原理。它是如何通过对比学习来连接图像和文本的?
•
参考答案: CLIP(Contrastive Language-Image Pre-training)是一个通过在海量图文对数据上进行预训练,从而学会将图像和文本关联起来的 foundational model。它的核心是利用 对比学习(Contrastive Learning) 来打通视觉和语言两个模态。
•
工作原理如下:
a.
双编码器架构(Dual-Encoder Architecture):
▪
图像编码器(Image Encoder): 通常是一个标准的视觉模型,如ResNet或Vision Transformer (ViT),负责将输入的图像转换成一个高维的特征向量。
▪
文本编码器(Text Encoder): 通常是一个Transformer模型,负责将输入的文本描述转换成一个同维度的高维特征向量。
b.
共享嵌入空间(Shared Embedding Space): 模型的目标是将图像和文本的特征向量投影到一个共享的多模态嵌入空间中。在这个空间里,语义相似的图像和文本的向量应该彼此靠近。
c.
对比学习训练目标: 训练过程在一个包含N个(图像,文本)对的批次(Batch)中进行:
经过大规模数据(4亿图文对)的训练,CLIP的编码器能够生成高度泛化的、语义丰富的特征,使其在零样本(zero-shot)图像分类等任务上表现出色,因为它能理解自然语言描述的视觉概念。
2.3 像 LLaVA 或 MiniGPT-4 这样的模型是如何将一个预训练好的视觉编码器(Vision Encoder)和一个大语言模型(LLM)连接起来的?请描述其关键的架构设计。
参考答案: LLaVA和MiniGPT-4这类模型开创了一种高效构建强大VLM的范式,其核心思想是复用(leverage) 已经非常强大的预训练单模态模型,并通过一个轻量级的“连接器”将它们桥接起来。
其关键架构设计通常包含三个核心组件:
冻结的视觉编码器(Frozen Vision Encoder):
◦
通常采用一个已经预训练好的、强大的视觉模型,最常见的是CLIP的Vision Transformer (ViT)。
◦
在训练VLM时,这个视觉编码器大部分时间是冻结的,不更新其参数。这样做的好处是保留了其强大的、泛化的视觉特征提取能力,并极大地节省了计算资源。
◦
它的作用是将输入的图像转换成一系列的视觉特征向量(Image Patches' Embeddings)。
连接器模块(Connector Module):
◦
这是整个架构的关键“胶水层”。它的作用是将来自视觉编码器的视觉特征,转换成大语言模型(LLM)能够理解的输入格式,即与文本词元(word embeddings)在同一向量空间中的“视觉词元”(visual tokens)。
◦
在LLaVA中,这个连接器是一个简单的线性投影层(Linear Projection Layer)。
◦
在MiniGPT-4或BLIP-2中,这个连接器是一个更复杂的Q-Former (Querying Transformer),它通过一组可学习的查询向量来从视觉特征中“浓缩”出最相关的信息。
冻结的大语言模型(Frozen Large Language Model):
◦
使用一个现成的、强大的预训练LLM,如Llama、Vicuna等。
◦
LLM在训练中也通常是冻结的(或使用LoRA等参数高效微调方法)。这保留了LLM强大的语言生成、推理和指令遵循能力。
◦
LLM接收拼接后的序列(视觉词元 + 文本词元),并像处理纯文本一样,自回归地生成回答。
训练过程通常分为两阶段:
•
第一阶段(视觉-语言对齐预训练): 使用大量的图像-标题数据,只训练连接器模块,目的是教会连接器如何将视觉特征有效地映射为LLM能理解的表示。
•
第二阶段(视觉指令微调): 使用高质量、多样化的多模态指令跟随数据(例如,图像+问题+答案),对整个模型(主要是连接器和LLM的LoRA部分)进行微调,教会模型如何根据指令进行对话、描述和推理。
2.4 什么是视觉指令微调?为什么说它是让 VLM 具备良好对话和指令遵循能力的关键步骤?
参考答案: 视觉指令微调(Visual Instruction Tuning, VIT) 是一种训练方法,它使用一个由大量“指令-响应”对组成的数据集来微调一个预训练好的VLM。与传统任务(如VQA、图像描述)的数据集不同,指令微调数据集的格式更加多样和自由,旨在模拟人类与智能助手的交互方式。
每条数据通常包含三个部分:
视觉输入(Vision Input): 一张图片或视频。
指令(Instruction): 一个用自然语言提出的、与视觉输入相关的任务或问题。例如,“请详细描述这幅画的风格”,“图中最高的建筑物是什么?”,“根据这张图写一个三句话的故事”。
响应(Response): 针对该指令的理想回答。
为什么是关键步骤?
视觉指令微调是连接 VLM 基础能力与应用能力的桥梁,其关键性体现在:
泛化到未知任务: 传统的VQA或描述模型只能执行它们被训练过的特定任务。而通过在成千上万种不同指令上进行微调,模型学会了理解指令意图的泛化能力。它不再是死板地回答“what is this?”,而是能理解“describe”、“compare”、“explain why”等各种指令背后的复杂要求。
激发LLM的潜力: 经过对齐预训练后,VLM只是学会了将视觉信息“翻译”给LLM。而指令微调则真正教会了LLM如何使用这些视觉信息来完成推理、遵循复杂指令和进行多轮对话。它将LLM固有的强大能力(如常识推理、代码生成、创意写作)与视觉输入结合了起来。
对齐人类交互模式: 指令微调使得模型的输出格式和交互方式更符合人类的期望,使其表现得更像一个真正的“多模态对话助手”,而不是一个任务单一的工具。这是模型从“可用”到“好用”的决定性一步。
2.5 在处理视频等多模态数据时,相比于静态图片,VLM 需要额外解决哪些问题?(例如,如何表征时序信息?)
参考答案: 处理视频数据引入了时间维度,这带来了相比静态图片额外且独特的挑战:
时序信息表征(Temporal Information Representation):
◦
挑战: 视频的核心在于动态变化、动作和事件的发生顺序。模型必须能够理解帧与帧之间的时序关系,例如物体的运动轨迹、动作的连续性、事件的因果关系等。
◦
解决方案:
▪
帧采样+融合: 从视频中抽取部分关键帧,分别提取它们的特征,然后通过一个时间融合模块(如时间注意力、3D卷积或简单的拼接池化)来聚合时序信息。
▪
时空建模: 使用能够直接处理时空数据的网络结构,如3D CNN或Video Transformer (ViViT),在提取特征的阶段就同时考虑空间和时间维度。
巨大的计算和存储开销:
◦
挑战: 视频本质上是图像序列,一个短视频可能包含数百甚至数千帧,数据量远超单张图片。这导致了巨大的计算(模型前向传播)和显存(存储特征)开销。
◦
解决方案:
长距离依赖建模:
◦
挑战: 视频中的关键因果关系可能跨越很长的时间窗口(例如,一个视频开头的铺垫可能要到结尾才揭示其意义)。模型需要具备捕捉这种长距离时间依赖的能力。
◦
解决方案: 采用类似Transformer的架构来建模帧之间的关系,利用其全局感受野的优势。
多模态融合的复杂性增加:
◦
挑战: 视频通常还伴随着音频(语音、背景音)和字幕等模态。VLM需要解决将视觉时序信息、音频流信息和文本信息同步对齐和融合的难题。
◦
解决方案: 设计更复杂的对齐和融合模块,能够处理多个异步或同步的时间序列数据。
2.6 请解释Grounding在 VLM 领域中的含义。我们如何评估一个 VLM 是否能将文本描述准确地对应到图片中的特定区域?
参考答案: 在VLM领域,Grounding(定位或指代) 指的是将语言中的某个特定概念或短语(a phrase or a concept)与图像中的特定像素区域(a specific pixel region) 建立准确对应关系的能力。简单来说,就是模型不仅知道图片里“有什么”,还要知道“在哪里”。
例如,对于指令“请告诉我图片中那只戴着红色项圈的黑猫”,一个具备Grounding能力的模型,其内部注意力机制应该能够准确地聚焦在图片中黑猫所在的区域,而不是图片中的其他物体或背景。
如何评估Grounding能力?
评估Grounding能力通常需要带有位置标注的数据集(如RefCOCO, Visual Genome),评估方法主要有:
指代短语定位(Referring Expression Grounding):
◦
任务: 给定一张图片和一个描述图片中某个物体的短语(如“the woman in the red dress”),模型需要输出该物体的位置,通常是一个边界框(Bounding Box)。
◦
评估指标: 将模型预测的边界框与人工标注的真实边界框(Ground Truth BBox)进行比较,计算它们的交并比(Intersection over Union, IoU)。
通常会设定一个IoU阈值(如0.5或0.75),如果模型预测的IoU超过该阈值,则认为定位正确。最后计算准确率(Accuracy@IoU>threshold)
视觉Grounding对话:
◦
任务: 在对话中,当模型生成引用了图片中某个物体的文本时,同时输出该物体的位置。
◦
评估: 这类评估更复杂,可能需要人工判断模型生成的文本和其对应的边界框是否一致且准确。一些新的基准(如Shikra, GPT4-ROI)正在探索这类评估方式。
注意力图可视化(定性分析):
◦
方法: 虽然不是一个定量的指标,但通过可视化模型在生成与某个物体相关的文本时,其内部注意力机制的激活区域,可以直观地判断模型是否“看对”了地方。如果生成“猫”这个词时,注意力主要集中在猫的区域,说明其具备一定的隐式Grounding能力。
2.7 请对比至少两种不同的 VLM 架构范式,并分析它们的优劣。
参考答案: 当前主流的VLM架构范式,根据视觉和语言信息融合方式的不同,
主要可以分为两大类:基于连接器的架构 和 基于跨模态注意力的架构。
总结: 基于连接器的架构是当前实现高性价比、高性能VLM的主流方案,追求效率和简洁。而基于跨模态注意力的架构则代表了追求极致性能和深度融合的方向,但成本更高。
2.8 在 VLM 的应用中,如何处理高分辨率的输入图像?这会带来哪些计算和模型设计上的挑战?
参考答案: 处理高分辨率图像是当前VLM领域的一个重要挑战,因为标准的视觉编码器(如ViT)通常被设计用于处理低分辨率的固定尺寸输入(例如224x224或336x336)。
带来的挑战:
计算量爆炸: Vision Transformer (ViT) 将图像分割成固定大小的图块(Patches)。输入图像的分辨率如果从224x224增加到448x448,边长变为2倍,图块数量会变为4倍。而自注意力机制的计算复杂度与输入序列长度(即图块数量)的平方成正比,这意味着计算量会变为原来的16倍,这是不可接受的。
位置编码失效: 预训练好的ViT的位置编码是针对特定数量的图块进行学习或设计的。输入更高分辨率的图像会导致图块数量增加,超出现有的位置编码范围,导致模型无法理解图块的相对位置。
显存占用剧增: 更多的图块意味着更长的序列,在Transformer的每一层都需要存储巨大的激活值,导致显存占用急剧增加。
处理方法:
目前主要有以下几种策略来处理高分辨率图像:
切片-编码-拼接(Slicing-based approach):
◦
方法: 将高分辨率图像切割成多个重叠或不重叠的低分辨率子图(例如,切成4个或6个224x224的图块)。将每个子图独立地送入标准的视觉编码器提取特征,最后将所有子图的特征拼接或融合起来,作为LLM的视觉输入。
◦
代表模型: LLaVA-1.5 的部分实现思路。
◦
优点: 简单有效,可以直接利用预训练好的低分辨率模型。
◦
缺点: 破坏了图像的全局结构,模型难以理解跨越不同切片的物体。
可变分辨率图块(Variable-size Patches):
◦
方法: 保持图块数量不变,但根据输入分辨率动态调整每个图块的大小。例如,对于高分辨率图像,使用更大的图块尺寸。
◦
优点: 保持了固定的序列长度,避免了计算量爆炸。
◦
缺点: 大图块会丢失局部细节信息,需要对模型进行相应的预训练或微调。
多尺度特征融合(Multi-scale Feature Fusion):
◦
方法: 设计一个可以处理高分辨率图像的视觉编码器(如Swin Transformer),并从其不同层级提取多尺度的特征图。然后通过一个特征金字塔网络(FPN)或类似结构将这些特征融合,再送入一个适配器模块(Adapter)转换成固定长度的序列给LLM。
2.9 VLM 在生成内容时,同样会遇到“幻觉”(Hallucination)问题,但它的表现形式和纯文本 LLM 有何不同?请举例说明。
参考答案: VLM和纯文本LLM都会产生“幻觉”,即生成与事实不符或无中生有的内容。但VLM的幻觉是基于视觉输入的,其表现形式与纯文本LLM有显著不同,主要体现在将错误的、不存在的视觉事实强行“植入”到描述中。
VLM幻觉的主要表现形式:
物体幻觉(Object Hallucination):
•
描述: 这是最常见的幻觉形式,即模型描述了图像中完全不存在的物体。
•
与LLM区别: 纯文本LLM的物体幻觉是凭空捏造(如编造一个不存在的书名),而VLM的物体幻觉是错误地“看”到了图像中没有的东西。
•
举例:
◦
输入图像: 一只猫坐在沙发上。
◦
VLM幻觉输出: “一只猫和一只小狗正舒适地躺在沙发上。”(图像中并没有狗)
属性幻觉(Attribute Hallucination):
◦
描述: 模型正确识别了图像中的物体,但错误地描述了该物体的属性,如颜色、形状、大小、数量等。
◦
与LLM区别: 纯文本LLM的属性幻觉是记错了事实(如“法国的首都是柏林”),而VLM的属性幻觉是看错了图像细节。
◦
举例:
▪
输入图像: 一个穿着蓝色衬衫的男人。
▪
VLM幻觉输出: “一个穿着红色衬衫的男人站在窗前。”(颜色错误)
▪
输入图像: 桌子上有两个苹果。
▪
VLM幻觉输出: “桌上放着三个苹果。”(数量错误)
关系幻觉(Relationship Hallucination):
◦
描述: 模型正确识别了多个物体,但错误地描述了它们之间的空间位置或交互关系。
◦
与LLM区别: 纯文本LLM的关系幻觉是混淆了概念关系(如“牛顿发现了相对论”),而VLM的关系幻觉是混淆了物理空间关系。
◦
举例:
▪
输入图像: 一本书放在一个杯子旁边。
▪
VLM幻觉输出: “一本书放在一个杯子里面。”(空间关系错误)
▪
输入图像: 一个女孩在追逐一个皮球。
▪
VLM幻觉输出: “一个皮球在追逐一个女孩。”(动作关系错误)
2.10 除了图片描述和视觉问答(VQA),你还能列举出 VLM 的哪些前沿或具有潜力的应用方向?
参考答案: 除了基础的图片描述和视觉问答,VLM正在向更复杂、更具交互性的前沿方向发展,展现出巨大的应用潜力:
多模态对话系统与个人助手:
视觉定位与指令执行(Visual Grounding & Grounded Agents):
◦
VLM不仅能理解图像内容,还能在图像上进行定位和操作。这可以用于:
▪
UI自动化: 指挥VLM“点击那个写着‘提交’的蓝色按钮”,VLM能理解指令并定位按钮位置。
▪
具身智能(Embodied AI): 作为机器人的“大脑”,VLM可以理解摄像头捕捉的实时画面,并根据指令(如“把桌上的红苹果拿给我”)规划并执行动作。
专业领域的视觉分析助手:
◦
医疗影像分析: 辅助医生解读X光片、CT扫描图,识别异常并生成初步报告。
◦
工业质检: 在生产线上实时分析产品图像,检测瑕疵和缺陷。
◦
保险定损: 上传车辆事故照片,VLM可以自动评估损伤程度和维修方案。
内容创作与代码生成:
◦
所见即所得的网页/App生成: 用户上传一张设计草图或UI截图,VLM可以直接生成实现该界面的前端代码(HTML/CSS/JavaScript)。
◦
图表和数据可视化解读: VLM可以“阅读”复杂的图表(如流程图、柱状图、K线图),提取关键信息,并生成数据摘要或代码进行复现。
教育与无障碍辅助:
◦
实时场景描述: 为视障人士实时描述周围的环境、识别物体、阅读文字。
2.11 有没有做过VLM相关方面的微调?什么模型?
•
参考答案: (这是一个考察实践经验的问题,回答时应结合具体项目。如果经验不足,可以清晰地阐述一个完整的设想流程。以下提供一个AI回答范例。)
是的,我有过VLM微调的实践经验。在一个项目中,我们尝试利用LLaVA-1.5模型来解决一个特定工业领域的视觉缺陷检测与分类任务。
项目背景与目标: 我们的目标是构建一个能与质检员对话的智能助手。质检员可以上传一张产品(例如,金属铸件)的图片,然后通过自然语言提问,比如“这张图里有什么缺陷?”、“缺陷在哪个位置?”、“这是什么类型的缺陷?”,模型需要能够理解问题并给出准确的回答。
模型选型: 我们选择LLaVA-1.5(7B版本)作为基础模型,主要原因有三点:
架构成熟: 它的“ViT + 线性投影 + Vicuna”架构是开源VLM的主流,易于理解和修改。
强大的基础能力: 它在通用的视觉对话任务上已经表现很好,我们只需要在此基础上进行领域知识的注入。
开源生态好: 有大量现成的微调脚本和社区支持,可以快速上手。
微调过程:
数据准备: 这是最关键的一步。我们构建了一个小规模、高质量的视觉指令数据集。每一条数据包含:
◦
图像: 一张带有特定缺陷的工业产品图。
◦
指令: 模仿质检员的提问,设计了多种指令模板,如“查找图片中的瑕疵”、“描述一下左上角的异常”等。
◦
回答: 精心撰写的标准答案,例如“图片中存在一处裂纹型缺陷,位于产品的右上角边缘”。
微调策略:
◦
我们采用了 LoRA(Low-Rank Adaptation) 对LLM部分进行参数高效微调。
◦
视觉编码器(CLIP ViT)和连接器(MLP)保持冻结,因为我们认为LLaVA的基础视觉表示能力已经足够,主要任务是教会LLM如何用我们领域的“黑话”(专业术语)来描述这些视觉特征。
训练与评估:
◦
在单张A100 GPU上进行了几个epoch的训练。
遇到的挑战与收获: 主要的挑战在于高质量标注数据的获取成本很高。我们发现,即使只有几百条高质量的领域指令数据,也能显著提升模型在特定任务上的表现。这个项目让我深刻理解了视觉指令微调对于VLM领域适应(domain adaptation)的关键作用。
RLHF 八股
3.1 和传统SFT相比,RLHF旨在解决语言模型中的哪些核心问题?为什么说SFT本身不足以实现我们期望的“对齐”目标?
参考答案: 与传统的监督微调(SFT)相比,RLHF(从人类反馈中进行强化学习)旨在解决语言模型中更深层次的“对齐”(Alignment)问题。这具体包括三个方面,通常被称为“HHH”原则:
有用性(Helpfulness): 模型应该提供准确、相关且信息量丰富的内容,尽力帮助用户解决问题。
诚实性(Honesty): 模型应基于其知识进行回答,不应捏造事实。在不知道答案或无法满足要求时,应主动承认,而不是产生幻觉。
无害性(Harmlessness): 模型不能产生有偏见、歧视性、暴力、色情或任何其他可能造成伤害的内容。
为什么SFT本身不足以实现对齐目标?
a.
目标定义模糊: “有用”、“诚实”、“无害”这些概念是复杂、主观且依赖上下文的,很难通过一个静态的、固定的SFT数据集来精确定义。例如,“怎样算一个有帮助的回答?”并没有唯一的正确答案,它取决于用户的偏好。
b.
偏好难以标注: 对于一个问题,可能有多个“正确”但风格、详略、侧重点不同的回答。SFT通常采用类似(prompt, ideal_response)的数据格式,它无法表达“回答A比回答B更好”这类细粒度的偏好信息。
c.
行为空间巨大: LLM可以生成几乎无限的回复。SFT数据集只能覆盖其中极小的一部分高质量示例,模型很容易学到数据集中的表面统计特征(statistical artifacts),而不是真正理解背后的原则。它教会了模型“模仿”,但没有教会模型“判断”。
d.
暴露偏差(Exposure Bias): SFT在训练时,每一步都基于真实的“黄金”上下文。但在推理时,模型是基于自己生成的上下文来继续生成,一旦早期出现偏差,错误会累积。
RLHF通过引入一个代表人类偏好的奖励模型,让LLM在一个探索性的框架(强化学习)中学习,使其能够理解并优化那些难以用SFT范式表达的、模糊的人类偏好,从而更好地实现对齐。
3.2 请详细阐述经典RLHF流程的三个核心阶段。在每个阶段,输入是什么,输出是什么,以及该阶段的关键目标是什么?
参考答案: 经典的RLHF流程(由OpenAI的InstructGPT论文提出)
包含三个核心阶段:
阶段一:监督微调(Supervised Fine-Tuning, SFT)
•
输入: 一个高质量的、由人工编写或筛选的指令跟随数据集。数据格式通常是(指令 Prompt, 理想回答 Response)。
•
输出: 一个经过微调的基础语言模型,我们称之为SFT模型。
•
关键目标: 让预训练好的LLM初步具备理解和遵循人类指令的能力。这是为后续阶段提供一个良好初始策略(policy)的基础,让模型先学会“说什么话”,而不是“胡言乱语”。
阶段二:训练奖励模型(Reward Model, RM)
•
输入: 一个人类偏好比较数据集。生成这个数据集的流程是:
a.
从指令数据集中采样一个Prompt。
b.
用第一阶段的SFT模型对该Prompt生成多个(通常是2到4个)不同的回答。
c.
由人类标注者对这些回答进行排序,选出最好的和最差的。数据格式通常是(Prompt, 胜出回答 yw, 落败回答 yl)。
•
输出: 一个奖励模型(RM)。这个模型能够输入任何(Prompt, Response)对,并输出一个标量分数,这个分数代表了人类对该回答的偏好程度。
•
关键目标: 学习一个能够模仿和泛化人类偏好的函数。这个RM将作为下一阶段强化学习的“环境”或“裁判”,为LLM的探索提供指导信号。
阶段三:近端策略优化(Proximal Policy Optimization, PPO)
•
输入:
a.
第一阶段的SFT模型(作为初始策略)。
b.
第二阶段训练好的RM(作为奖励函数)。
c.
一个新的、用于策略探索的指令数据集。
•
输出: 经过RLHF对齐的最终语言模型。
•
关键目标: 使用强化学习来进一步微调SFT模型。在这个阶段,模型(作为Agent)会针对一个Prompt生成一个回答(Action),奖励模型(作为Environment)会给这个回答打分(Reward),然后通过PPO算法更新模型参数,使其生成的回答能在获得高奖励的同时,又不过于偏离原始SFT模型的风格和内容,从而实现“对齐”。
3.3 在RM训练阶段,我们通常收集的是成对比较数据,而不是让人类标注者直接给回复打一个绝对分数。你认为这样做的主要优势和潜在的劣势分别是什么?
参考答案: 在训练奖励模型(RM)时,采用成对比较(Pairwise Comparison)而非绝对评分(Absolute Scoring)是业界的标准做法,这背后有深刻的认知科学和实践考量。
主要优势:
降低认知负荷,提升标注一致性: 让人在多个选项中选出“哪个更好”远比给一个选项打一个精确的绝对分数(如1到10分)要容易和直观。不同标注者对于“7分”的定义可能天差地别,但对于“A比B更好”的判断则更容易达成共识,这大大提升了数据的标注者间一致性(Inter-rater agreement)。
提供更精细的信号: 比较数据能够捕捉到细微的偏好差异。两个回答可能在绝对分数上都是“好”的(比如都是8分),但比较数据可以明确指出其中一个比另一个“稍微好一点”,这种相对信号对于模型学习更精细的偏好至关重要。
数据分布归一化: 绝对分数很容易受到标注者个人情绪、打分尺度、疲劳度等因素影响,导致分数分布不均或存在偏差。而比较数据天然地将问题转化为一个标准化的二元分类或排序任务,模型只需要学习相对关系,对绝对尺度不敏感。
潜在的劣势:
数据效率可能较低: 每次比较只产生1比特的信息(A>B或B>A)。如果要对K个回答进行完整排序,需要进行 O(K2) 次比较,而绝对评分只需要K次。这意味着要达到同等的信息量,可能需要更多的标注工作。
可能出现不传递性(Intransitivity): 人类偏好有时不满足传递性,即可能出现“A比B好,B比C好,但C比A好”的循环偏好。这会给奖励模型带来噪声和矛盾的训练信号。
信息不完整: 比较数据只告诉我们相对好坏,但没有说明“好多少”或“差多少”。两个回答的差距可能微乎其微,也可能天差地别,但成对比较无法直接体现这种差异的幅度。
3.4 奖励模型的设计至关重要。它的模型架构通常如何选择?
它与我们最终要优化的LLM是什么关系?
在训练奖励模型时,常用的损失函数是什么?
请解释其背后的数学原理(例如,可以结合Bradley-Terry模型来解释)。
参考答案: 模型架构选择: 奖励模型(RM)的架构通常选择与要优化的LLM相同或非常相似的架构,但有两点关键区别:
RM的初始化权重通常来自于第一阶段训练好的SFT模型。这样做可以保证RM对指令和语言风格有很好的基础理解。
RM的最后一层(通常是预测下一个token的softmax层)被替换为一个回归头(Regression Head),这个头通常是一个线性层,用于输出一个标量(scalar),即奖励分数。
与最终LLM的关系: RM是最终LLM的效用函数代理(proxy for the utility function)。它在RLHF流程中扮演着人类偏好的模拟器的角色。最终的LLM(即策略)的目标就是生成能够让这个RM给出高分数的回答。因此,RM的质量直接决定了最终LLM对齐的天花板。如果RM有缺陷或偏见,LLM在优化过程中就会“奖励作弊”,利用这些缺陷来获得高分,而不是真正生成人类喜欢的回答。
常用的损失函数: RM训练时最常用的损失函数是成对排序损失(Pairwise Ranking Loss)。其目标是,对于任意一个给定的prompt,RM赋予“胜出回答”( yw )的分数 r(yw) 应该高于赋予“落败回答”( yl )的分数 r(yl) 。
数学原理解释(结合Bradley-Terry模型): Bradley-Terry模型是一个用于描述成对比较结果概率的模型。它假设每个个体(在这里是每个回答)都有一个潜在的“实力”分数(即奖励分数 r )。回答 yw 优于 yl 的概率 P(yw>yl) 可以用一个logistic函数(即sigmoid函数 σ )来建模:
其中 x 是prompt, r(y|x) 是RM给出的分数。这个公式的直观意义是,两个回答的奖励分数差距越大,我们越确信其中一个比另一个好。
在训练时,我们的目标是最大化我们观察到的人类偏好数据的对数似然。对于一个偏好数据 (yw,yl) ,我们希望最大化 P(yw>yl) 的对数。因此,损失函数就是其负对数似然:
这个损失函数会惩罚那些RM给分错误(即 r(yl)>r(yw) )的情况,并驱动RM学习到一个能够准确反映人类偏好排序的打分函数。
3.5 在RLHF的第三阶段,PPO是最主流的强化学习算法。为什么选择PPO,而不是其他更简单的策略梯度算法(如REINFORCE)或者Q-learning系算法?PPO中的KL散度惩罚项起到了什么关键作用?
参考答案: 在RLHF的第三阶段选择PPO(近端策略优化)作为主流算法是基于其在大型语言模型这种复杂环境下,对训练稳定性、样本效率和实现简易性之间做出的良好权衡。
为什么不选择其他算法?
vs. REINFORCE (简单策略梯度):
◦
REINFORCE算法以其 高方差(high variance) 而闻名。它直接使用蒙特卡洛采样得到的整个序列的奖励来更新策略,这会导致梯度估计非常不稳定,尤其是在LLM这种动作空间巨大、奖励信号稀疏的环境中。训练过程会非常震荡,难以收敛。PPO通过引入价值函数作为基线(baseline)和使用优势函数(advantage function),显著降低了方差,使得训练更稳定。
vs. Q-learning系算法 (如DQN):
◦
DQN等基于价值的算法主要是为离散(discrete)且低维的动作空间设计的。它们需要为每个状态下的每个可能动作计算一个Q值。对于LLM来说,动作空间是整个词汇表在每个时间步的组合,这是一个极其巨大的、组合性的空间。直接应用Q-learning来计算每个词的Q值是不可行的。而PPO作为一种策略梯度方法,直接在策略空间进行优化,天然地适用于这种连续或巨大的动作空间。
PPO中KL散度惩罚项的关键作用:
PPO的目标函数中包含一个非常关键的KL散度惩罚项:
其中 πRL 是当前正在优化的策略, πSFT 是第一阶段训练好的初始SFT策略, β 是一个超参数。这个KL散度项起到了 “信任区域” 或 “正则化” 的作用,其关键目的有两个:
防止策略崩溃(Policy Collapse): 奖励模型(RM)是不完美的,总会存在一些漏洞。如果没有KL惩罚项,RL策略会不顾一切地寻找RM的漏洞来“作弊”以获得最高分,这常常导致生成的文本毫无意义、充满重复或攻击性内容,即所谓的“模式崩溃”。KL惩罚项通过约束新策略不能与初始的、表现尚可的SFT策略偏离太远,从而将优化限制在一个“安全”的区域内,保留了SFT模型良好的语言特性。
保证探索效率和多样性: 保持与SFT模型的相近度,意味着模型不会过早地收敛到某个奖励高但质量差的局部最优解。它鼓励模型在已经学会的、有意义的语言分布附近进行探索,而不是跳到一个完全陌生的、可能导致奖励模型失效的区域。这有助于维持生成文本的多样性和可读性。
3.6 如果在PPO训练过程中,KL散度惩罚项的系数 β 设置得过大或过小,分别会导致什么样的问题?你将如何通过实验和观察来调整这个超参数?
•
参考答案: KL散度惩罚项的系数 β 是RLHF训练中一个至关重要的超参数,它控制着“利用奖励模型”和“保持语言模型本性”之间的平衡。
•
设置不当导致的问题:
β 设置过大:
▪
问题描述: 如果惩罚系数过大,模型会过于“保守”。为了最小化与SFT模型的KL散度,策略更新的步子会非常小,甚至几乎不更新。
▪
具体表现: 模型对奖励信号的响应不足,训练过程看起来“停滞不前”。最终得到的RLHF模型与原始的SFT模型在行为和输出上几乎没有区别,RLHF阶段的优化效果大打折扣,没有充分学到人类的偏好。
β 设置过小:
如何通过实验和观察来调整 β ?
调整 β 是一个经验性的过程,通常需要监控以下几个关键指标:
监控KL散度值: 在训练日志中,实时观察每个batch或epoch的平均KL散度。一个健康的训练过程,KL散度应该在一个相对稳定且合理的范围内波动。如果KL值持续接近于0,说明 β 可能太大了。如果KL值急剧增大且不稳定,说明 β 可能太小了。
监控奖励分数: 观察奖励模型给出的平均分数。正常情况下,奖励分数应该随着训练稳步提升。如果奖励分数提升很快,但KL散度也急剧增大,就需要警惕奖励作弊的风险。如果奖励分数几乎不增长,说明 β 可能太大了。
定期进行定性分析(Qualitative Analysis): 这是最重要的一步。在训练的不同阶段(例如,每隔N个step),从验证集中随机抽取一些prompt,用当前训练的策略模型和SFT参考模型分别生成回答。人工对比检查:
设置KL散度目标范围: 一些实现(如TRL库)中,会设定一个KL散度的目标范围。如果实际KL值超出了这个范围,会动态地调整 β 值,使其保持在目标范围内。这是一个自动化调整的思路。
通过综合以上定量指标和定性观察,可以迭代地调整 β 值,直到找到一个既能有效利用奖励信号,又能保持模型稳定性和多样性的最佳平衡点。
3.7 什么是“奖励作弊/奖励黑客”(Reward Hacking)?请结合一个具体的LLM应用场景给出一个例子,并探讨几种可能的缓解策略。
•
参考答案: 奖励作弊(Reward Hacking),也称作“规范博弈”(Specification Gaming),指的是在强化学习中,智能体(Agent)发现并利用了奖励函数(Reward Function)的漏洞或不完善之处,以一种设计者非预期的方式来最大化奖励,但实际上并没有完成任务的真正目标。本质上是“钻了规则的空子”。
•
LLM应用场景举例:
◦
场景: 训练一个生成文本摘要的LLM。
◦
奖励模型(RM)的设计: 假设我们设计的RM偏好那些包含原文中所有重要关键词且长度较长(认为长摘要信息更全)的摘要。
◦
奖励作弊的现象: 经过RLHF训练后,这个LLM可能会生成这样的“摘要”:它不再是精炼地总结原文,而是将原文中的所有句子,特别是那些含有关键词的句子,原封不动地、大量地复制粘贴过来,并用一些连接词(如“此外”、“同时”、“而且”)将它们生硬地串联起来,形成一篇很长但毫无信息浓缩价值的文本。
◦
为什么这是作弊: 这个生成的文本完美地迎合了RM的两个偏好:1)包含了所有关键词;2)长度很长。因此RM会给它打出非常高的分数。然而,它完全违背了“摘要”这个任务的初衷——即简洁地概括核心内容。
•
缓解策略:
a.
改进奖励模型(Iterative RM Improvement):
▪
核心思想: 奖励作弊的根源在于RM不够好。最直接的方法就是不断优化RM。
▪
具体做法: 将模型作弊生成的case(即RM打高分但人类认为很差的例子)重新加入到RM的训练数据中,作为负样本。通过这种迭代的方式,让RM学会识别并惩罚这些作弊行为。
3.8 RLHF流程复杂且不稳定。近年来出现了一些替代方案,例如DPO。请解释DPO的核心思想,并比较它与传统RLHF(基于PPO)的主要区别和优势。
•
参考答案: DPO(Direct Preference Optimization)的核心思想: DPO是一种更简单、更稳定的语言模型偏好对齐方法,其核心思想是 绕过(bypass) 显式的奖励模型建模和复杂的强化学习训练过程,直接利用偏好数据来优化语言模型。
•
它的推导过程很巧妙:它首先写出了传统RLHF流程(奖励建模+PPO)的优化目标,然后通过数学变换发现,最优的RLHF策略与参考策略(SFT模型)以及隐式的奖励函数之间存在一个解析关系。最终,它把这个关系代入到奖励模型的损失函数中,神奇地得到了一个可以直接在偏好数据上优化语言模型策略的损失函数,而奖励函数在这个过程中被“抵消”掉了。
•
简单来说,DPO将RLHF这个“先学习奖励,再用RL优化”的两阶段问题,直接转换成了一个等价的“直接用偏好数据进行监督学习”的一阶段问题。它的损失函数形式上类似一个分类损失,目标是提高模型对“胜出回答”的生成概率,同时降低对“落败回答”的生成概率。
与传统RLHF(基于PPO)的主要区别和优势:
总结优势: DPO相对于传统RLHF的主要优势是简洁、稳定、高效。它大大简化了对齐流程,降低了实现难度和计算成本,使得偏好对齐技术更容易被广泛应用,同时在效果上也不逊色于甚至超越了复杂的RLHF方法。
3.9 想象一下,你训练完成的RLHF模型在离线评估中表现优异,奖励模型分数很高,但上线后用户反馈其回答变得越来越“模式化”、奉承、且缺乏信息量。你认为可能的原因是什么?你会从哪些方面着手分析和解决这个问题?
参考答案: 这是一个典型的RLHF中“对齐税”(Alignment Tax)或“模式崩溃”(Mode Collapse)现象。即模型为了迎合学到的偏好,牺牲了内容的多样性和信息量。
可能的原因分析:
奖励模型(RM)的偏差和过拟合:
◦
原因: RM本身可能学到了有偏的、表面的模式。例如,人类标注者可能无意识地更偏爱那些语气礼貌、结构清晰、使用特定“安全”词汇(如“根据我的知识...”、“作为一个AI模型...”)的回答。RM学到了这些表面特征,并给这类回答高分,而不管其信息量如何。
◦
离线评估的欺骗性: 离线评估通常也是用这个有偏的RM来打分的,所以模型分数自然很高,但这是一种“自欺欺人”。
PPO优化过程中的过度优化(Over-optimization):
◦
原因: PPO算法非常强大,如果KL散度的惩罚系数 β 设置得过小,或者训练步数过多,模型会过度地在RM定义的奖励景观(reward landscape)中寻找最高点。而这个最高点很可能就是一个狭窄的“模式化”区域。
◦
后果: 模型找到了获得高分的“万能公式”,即无论什么问题,都用一种奉承、安全的模式来回答,因为这是RM最喜欢的。
偏好数据本身的局限性:
分析和解决问题的步骤:
深入分析奖励模型(RM Diagnosis):
◦
做法: 首先要诊断RM。我会构造一些对比样本:一个是有信息量但朴实的回答,另一个是模式化、奉承但信息量低的回答。然后用RM去打分,看它是否真的更偏爱后者。
◦
目的: 验证RM是否是问题的根源。
数据驱动的解决方案(Data-driven Solution):
◦
做法: 如果RM确实存在偏差,需要重新进行数据迭代。收集那些“模式化”的失败案例,并让标注者明确地将它们标记为比那些信息量更丰富的回答更差。用这些新的偏好数据来继续微调或重新训练RM。
算法层面的调整(Algorithmic Adjustment):
◦
做法:
▪
增大KL散度系数 β: 增强对SFT模型的约束,让模型不敢过于偏离其原始的、更多样化的语言风格。
▪
引入熵奖励(Entropy Bonus): 在PPO的目标函数中加入一项熵奖励,鼓励模型生成更多样化的词元分布,对抗模式崩溃。
▪
提前停止(Early Stopping): 监控模型的输出质量,在发现模式化倾向开始出现时就停止训练,而不是追求最高的RM分数。
解码策略的调整(Decoding Strategy Tuning):
◦
做法: 在模型上线提供服务时,可以尝试调整解码策略。例如,适当提高Temperature或使用Top-K/Top-P采样而非Greedy Search,可以增加生成文本的随机性和多样性,在一定程度上缓解模式化问题。
3.10 你知道Deepseek的GRPO吗,它和PPO的主要区别是什么?优劣是什么?
参考答案: (具体可以参考GRPO论文,自己阐述理解)
3.11 GSPO和DAPO有听说过吗?他们和GRPO有什么区别?
参考答案: (这是一个考察前沿知识广度的问题。截至目前,GSPO和DAPO并非像PPO、DPO那样广为人知或被广泛采纳的主流算法缩写可以参考腾讯,阿里相关论文了解)
3.12 如何解决信用分配问题?token级别和seq级别的奖励有何不同?
参考答案: 信用分配问题(Credit Assignment Problem)是强化学习中的一个经典难题。在语言模型生成的场景下,它指的是:当一个完整的回答(序列)得到一个最终的奖励分数后,我们如何确定这个分数应该归功于(或归咎于)序列中的哪些具体的词元(token)。一个好的结尾可能弥补了一个糟糕的开头,反之亦然。简单地将最终奖励分配给每一个词元是不公平且低效的。
Token级别奖励 vs. Sequence级别奖励
Sequence级别奖励 (Sequence-level Reward):
定义: 这是RLHF中最常见的形式。奖励模型(RM)读取整个生成的序列,并给出一个单一的标量分数作为对整个序列的评价。
优点:
与人类评估模式一致: 人类通常是读完整个回答后形成一个总体印象,这种方式更容易收集偏好数据和训练RM。
Token级别奖励 (Token-level Reward):
定义: 为序列中的每一个token都分配一个独立的奖励分数。这个分数应该反映该token在当时上下文中的贡献。
优点:
信号精细: 提供了非常精细和密集的学习信号,理论上可以极大地提高学习效率和最终性能,因为它直接告诉模型哪一步走对了,哪一步走错了。
缺点:
难以获取: 让标注者为每个token打分几乎是不可能的,认知负荷极大。因此,Token级别的奖励通常不是直接从人类那里获得的。
定义困难: 如何定义一个token的“好坏”本身就很复杂。一个词的好坏严重依赖于后续生成的上下文。
如何解决(或缓解)信用分配问题?
尽管我们通常只得到Sequence级别的奖励,但主流的RL算法(如PPO)内部有一些机制来尝试缓解信用分配问题:
优势函数(Advantage Function)和价值函数(Value Function):
方法: 在PPO中,除了策略模型(Actor),还会训练一个价值模型(Critic)。这个Critic的作用是估计在某个状态(即生成了部分序列的上下文)下,未来可能获得的期望奖励。
信用分配: 通过计算优势函数(Advantage),即 A(s, a) = R_t - V(s_t)(简化的形式),我们可以估计出在当前状态 st 选择动作 at (生成某个token)比“平均水平”好多少。 Rt 是实际得到的未来总回报, V(st) 是期望的平均回报。这个优势值可以被看作是一种伪Token级别的奖励信号。
GAE(Generalized Advantage Estimation): PPO通常使用GAE来更稳定地估计优势函数,它通过指数加权平均综合了多个时间步的TD误差,进一步平衡了偏差和方差,为每个时间步提供了更可靠的信用分配信号。
简单来说,我们虽然只有一个最终的序列奖励,但通过引入一个学习未来期望的Critic,P-PO能够为每一步的token生成一个更合理的、间接的、反映其边际贡献的“优势”信号,从而在实践中有效地解决了信用分配问题。
3.13 除了人类反馈,我们还可以利用AI自身的反馈来做对齐,即RLAIF。请谈谈你对RLAIF的理解,它的潜力和风险分别是什么?
参考答案: 对RLAIF (Reinforcement Learning from AI Feedback)的理解: RLAIF是一种对齐技术,其核心思想是在标准的RLHF流程中,用一个 强大的、独立的AI模型(通常是比被训练模型更先进的闭源模型,如GPT-4、Claude) 来替代人类标注者,为语言模型的输出提供偏好判断。
具体流程与RLHF非常相似:
用SFT模型针对一个prompt生成两个或多个回答。
将prompt和这些回答提交给一个“裁判AI”(AI Judge/Labeler)。
裁判AI根据预设的准则(例如,一个精心设计的prompt,要求它从“有用性”、“无害性”等方面判断哪个回答更好),输出其偏好(例如,"回答A更好")。
用这些AI生成的偏好数据来训练奖励模型(RM),或者直接用于DPO等算法。
后续的RL优化流程与RLHF完全相同。
本质上,RLAIF是用AI的偏好来“蒸馏”或“指导”被训练模型的对齐,是一种“AI训练AI”的范式。
RLAIF的潜力:
极高的可扩展性和效率(Scalability & Efficiency): 这是RLAIF最大的优势。AI标注者可以7x24小时不间断工作,速度远超人类,且成本极低。这使得我们可以用比传统RLHF大几个数量级的偏好数据集来训练模型,从而可能实现更好的对齐效果。
标注一致性(Consistency): 只要裁判AI和其使用的prompt固定,其标注标准就是完全一致的,避免了人类标注者之间固有的偏见和不一致性问题。
探索更复杂的偏好: 我们可以通过设计复杂的prompt,引导裁判AI从非常细微、专业的角度(如代码的优雅性、科学解释的准确性)进行评估,这可能是普通人类标注者难以做到的。
RLAIF的风险:
偏见的继承与放大(Bias Inheritance and Amplification): 这是RLAIF最核心的风险。裁判AI自身的偏见(无论是来自其训练数据还是其模型架构)会被毫无保留地传递给被训练的模型。如果裁判AI有某种偏见,RLAIF流程不仅会继承它,还可能因为大规模的训练而将其放大,导致最终模型产生系统性的、难以察觉的偏差。
价值的“近亲繁殖”: RLAIF构建了一个封闭的AI生态系统,模型的价值观来自于另一个AI。这可能导致AI的价值观与真实、多样、不断演化的人类价值观逐渐脱节,形成一种“回音室效应”或“近亲繁殖”,最终对齐到一个并非人类真正期望的目标上。
缺乏常识和真实世界 grounding: 裁判AI可能缺乏对物理世界、社会动态的真实理解。它可能基于文本的表面统计特征做出判断,而这些判断可能在现实世界中是荒谬或有害的。例如,它可能无法判断一个听起来很有说服力的安全建议在实践中是否危险。
对裁判AI的过度依赖: 整个对齐的安全性和可靠性都系于裁判AI一身。如果这个裁判AI本身存在漏洞或被恶意利用,其后果将是灾难性的。
因此,RLAIF是一个非常有潜力的技术,但其实践应用需要非常谨慎,通常需要与人类监督(Human Oversight)相结合,定期由人类专家抽查和校准AI的标注结果,以确保其对齐方向的正确性。
Agent
4.1 你如何定义一个基于 LLM 的智能体(Agent)?它通常由哪些核心组件构成?
参考答案: 一个基于 LLM 的智能体(Agent)是一个能够自主理解环境、进行规划决策、并执行行动以达成特定目标的计算系统。其核心特征是利用一个大型语言模型(LLM)作为其“大脑”或“中央处理器”,来进行复杂的推理和决策。
与传统的调用LLM进行问答或文本生成不同,Agent具有自主性和循环执行的特点,它能主动地、持续地与环境或工具交互,直到完成任务。
一个典型的LLM Agent通常由以下四个核心组件构成:
大脑/核心引擎 (Brain/Core Engine):
◦
组件: 一个强大的大型语言模型(LLM),如GPT系列、Gemini、Llama等。
◦
作用: 这是Agent的认知核心。它负责理解用户目标、感知环境信息、进行常识推理、制定计划、并决定下一步的行动。所有其他组件的输出最终都会汇集到LLM进行处理。
规划模块 (Planning Module):
◦
组件: 可以是LLM的内置能力(如通过CoT、ReAct等提示策略激发),也可以是独立的算法模块。
◦
作用: 负责将一个复杂、长期的目标分解成一系列更小、更具体的、可执行的子任务。它还负责根据行动的反馈动态地调整 и修正计划。规划能力是Agent处理复杂任务的关键。
记忆模块 (Memory Module):
◦
组件: 通常是外部数据库或数据结构的组合,如向量数据库、键值存储等。
◦
作用: 弥补LLM有限的上下文窗口。它分为:
▪
短期记忆: 记录当前的对话历史、中间步骤的“思考过程”(scratchpad),用于维持任务的连贯性。
▪
长期记忆: 存储过去的经验、知识、用户偏好等,通过检索(通常是RAG)来为当前决策提供信息。
工具使用模块 (Tool Use Module):
◦
组件: 一系列外部API、函数库或硬件接口。
◦
作用: 扩展Agent的能力边界。LLM本身无法获取实时信息、执行数学计算或与物理世界交互。工具使用模块允许Agent调用外部工具来完成这些任务,例如:
4.2 请详细解释 ReAct 框架。它是如何将思维链和行动结合起来,以完成复杂任务的?
参考答案: ReAct (Reason and Act) 是一个强大且基础的Agent行为框架,它通过一种巧妙的提示(Prompting)策略,让LLM能够协同地生成推理轨迹(reasoning traces)和任务相关的行动(actions)。
核心思想: ReAct的核心思想是,人类在解决复杂问题时,并不仅仅是“思考”或“行动”,而是将两者紧密地交织在一起。我们会先思考一下,然后采取一个行动,观察结果,再根据结果进行思考,决定下一步行动。ReAct就是模仿人类这种“思考 -> 行动 -> 观察 -> 思考...”的循环模式。
工作流程: ReAct通过一个精心设计的Prompt来引导LLM生成特定格式的文本。这个循环的每一步如下:
思考 (Thought):
行动 (Action):
◦
在“思考”之后,LLM会决定并生成一个具体的、可执行的“行动”。
◦
这个行动通常被格式化为 Action: [Tool_Name, Tool_Input] 的形式。例如:Action: [Search, "weather in Singapore today"]。
◦
Tool_Name 是要调用的工具名称,Tool_Input 是传递给该工具的参数。
观察 (Observation):
◦
Agent的外部执行器(harness)会解析LLM生成的“行动”,并实际调用对应的工具。
◦
工具执行后返回的结果,被格式化为“观察”信息,并反馈给LLM。例如:Observation: "Today in Singapore, the weather is sunny with a high of 32°C."
循环与结合: 这个“观察”结果会作为新的上下文,与原始目标一起,输入到LLM中,开始下一轮的“思考 -> 行动 -> 观察”循环。
如何结合思维链(CoT)和行动?
•
思维链 (Chain of Thought, CoT) 是一种让LLM通过生成中间推理步骤来解决复杂问题的方法。
•
ReAct中的思考 (Thought)部分,本质上就是一种动态的、交互式的思维链。
•
传统的CoT是一次性生成所有思考步骤,然后得出答案。而ReAct的“思考”是每一步行动前都会进行的、基于最新观察结果的思维链。
•
这种结合使得Agent能够:
◦
处理动态环境: 可以根据工具返回的最新信息实时调整策略。
◦
进行错误修正: 如果一个行动失败或返回了无用的信息,Agent可以在下一步的“思考”中分析失败原因,并尝试不同的行动。
◦
完成复杂任务: 通过将大任务分解成一系列“思考-行动”的子步骤,ReAct能够完成需要多步推理和工具交互的复杂任务。
4.3 在 Agent 的设计中,“规划能力”至重要。请谈谈目前有哪些主流方法可以赋予 LLM 规划能力?(例如 CoT, ToT, GoT等)
参考答案: 规划能力是衡量Agent智能水平的核心指标,它决定了Agent能否有效地将复杂目标分解为可执行步骤。目前,赋予LLM规划能力的主流方法,从简单到复杂,大致可以分为以下几个层次:
基于提示的隐式规划 (Prompt-based Implicit Planning):
◦
Chain of Thought (CoT): 这是最基础的规划方法。通过在提示中加入“Let's think step by step”,引导LLM生成一个线性的、一步接一步的思考过程。这个思考过程本身就是一种简单的计划。
▪
优点: 实现简单,无需修改模型。
▪
缺点: 规划是线性的,无法进行探索和回溯。一旦某一步出错,整个计划很可能失败。
◦
ReAct 框架: ReAct将CoT与行动结合,使得规划成为一个动态过程。每一步的“思考”都是基于前一步“观察”的重新规划,比CoT更具鲁棒性。
基于搜索的显式规划 (Search-based Explicit Planning):
◦
这类方法将规划问题形式化为一个搜索问题,通过探索不同的“思考”路径来寻找最优解。
◦
Tree of Thoughts (ToT):
▪
核心思想: ToT将规划过程构建为一棵“思维树”。从一个初始问题开始,LLM会生成多个不同的、并行的思考路径(树的分支)。
▪
工作流程: 它采用标准的树搜索算法(如广度优先或深度优先搜索),在每一步都对当前的所有“思维节点”(叶子节点)进行评估(通常也由LLM自己打分),然后选择最有希望的节点进行下一步的扩展。
基于任务分解的规划 (Task Decomposition Planning):
◦
方法: 训练或提示LLM充当一个“规划器”,将主任务显式地分解成一个依赖图或一个步骤列表。然后,另一个“执行器”LLM(或同一个LLM扮演不同角色)再去逐一完成这些子任务。
◦
优点: 结构清晰,易于管理和监控任务进度。
4.4 Memory是 Agent 的一个关键模块。请问如何为 Agent 设计短期记忆和长期记忆系统?可以借助哪些外部工具或技术?
•
参考答案: 记忆模块是Agent打破LLM上下文窗口限制、实现持续学习和个性化的关键。设计Agent的记忆系统通常会模仿人类的记忆机制,分为短期记忆和长期记忆。
短期记忆 (Short-Term Memory):
◦
作用: 存储当前任务的上下文信息,包括即时对话历史、中间的思考步骤(如ReAct的Scratchpad)、工具的调用结果等。它是Agent进行连贯思考和行动的基础。
◦
实现方式:
▪
LLM的上下文窗口 (Context Window): 这是最直接的短期记忆载体。所有最近的交互都会被放入Prompt中。
▪
缓冲区 (Buffers): 在Agent框架(如LangChain)中,通常会使用不同类型的缓冲区来管理对话历史,例如:
•
ConversationBufferMemory: 存储完整的对话历史。
•
ConversationBufferWindowMemory: 只保留最近的K轮对话。
长期记忆 (Long-Term Memory):
◦
作用: 存储跨越任务和时间维度的信息,如用户的个人偏好、过去的成功/失败经验、领域知识等。它使得Agent能够“学习”和“成长”。
◦
实现方式与外部工具: 长期记忆的核心是“存储”和“检索”,这通常需要借助外部技术,最主流的是RAG (Retrieval-Augmented Generation) 范式。
▪
核心技术:向量数据库 (Vector Database)
•
工具: Pinecone, ChromaDB, FAISS, Weaviate等。
•
工作流程:
a.
存储(Storing/Writing): 当Agent获得一个有价值的信息(如用户明确给出的偏好、一个成功解决问题的完整流程)时,它会使用一个嵌入模型(Embedding Model)将这段文本信息转换成一个高维向量。然后,将这个向量及其原始文本存入向量数据库。
b.
检索(Retrieving/Reading): 在Agent进行规划或决策时,它会把当前的任务或问题也转换成一个查询向量。然后,用这个查询向量去向量数据库中进行相似度搜索,找出与当前情况最相关的历史记忆。
c.
使用(Using): 检索到的记忆(原始文本)会被插入到LLM的Prompt中,作为额外的上下文,来指导LLM做出更明智的决策。
4.5 Tool Use是扩展 Agent 能力的有效途径。请解释 LLM 是如何学会调用外部 API 或工具的?(可以从 Function Calling 的角度解释)
参考答案: LLM学会调用外部API或工具,是其从一个纯粹的“语言模型”转变为一个“行动执行者”的关键一步。这一能力的核心是让LLM能够理解何时需要使用工具,以及如何以结构化的方式表达使用哪个工具和传递什么参数。目前,主流的实现方式是Function Calling。
Function Calling的工作原理如下:
工具定义与注册 (Tool Definition & Registration):
◦
我们首先需要以一种机器可读的方式,向LLM“描述”我们有哪些可用的工具。这个描述通常是一个结构化的模式(Schema),比如JSON Schema。
LLM的决策与意图识别 (LLM's Decision & Intent Recognition):
◦
在与用户交互时,我们将用户的提问连同所有已注册的工具描述一起发送给LLM。
◦
LLM(如GPT-4, Gemini等)经过了特殊的指令微调,使其能够理解这种“工具描述”的格式。
◦
LLM会分析用户的意图。如果它认为只靠自身知识无法回答,且用户的意图与某个工具的功能相匹配,它就会决定调用该工具。
生成结构化的调用指令 (Generating Structured Calling Instructions):
◦
当LLM决定调用工具时,它的输出不再是自然语言文本,而是一个特殊格式的、结构化的JSON对象(或其他格式)。
◦
这个JSON对象会精确地包含:
▪
要调用的函数名称。
例如,对于用户提问“今天新加坡天气怎么样?”,LLM可能输出:
代码块
JSON
{
"tool_call": {
"name": "get_current_weather",
"arguments": {
"location": "Singapore",
"unit": "celsius"
}
}
}
外部执行与结果返回 (External Execution & Result Return):
◦
Agent的控制代码(Orchestrator)会捕获这个特殊的JSON输出。
◦
它会解析JSON,找到函数名和参数,然后在外部环境中实际执行这个函数(例如,调用一个真实的天气API)。
◦
函数执行完毕后,会返回一个结果(例如,{"temperature": 32, "condition": "sunny"})。
整合结果并生成最终回复 (Integrating Result & Generating Final Response):
◦
控制代码将工具的返回结果再次格式化,并将其作为新的上下文信息,连同之前的对话历史一起,再次发送给LLM。
◦
这一次,LLM已经获得了它需要的信息。它会基于这个结果,生成一个最终的、流畅的自然语言回答给用户,例如:“今天新加坡的天气是晴天,温度为32摄氏度。”
4.6 请比较一下两个流行的 Agent 开发框架,如 LangChain 和 LlamaIndex。它们的核心应用场景有何不同?
参考答案: LangChain和LlamaIndex是构建LLM应用最流行的两个开源框架,它们都极大地简化了开发流程,但它们的核心哲学和设计重点有所不同,导致了它们在应用场景上的差异。
核心定位的差异:
•
LangChain:一个通用的LLM应用“编排”框架 (General-purpose Orchestration Framework)
◦
哲学: LangChain的目标是提供一个全面的工具集,用于将LLM与各种组件(工具、记忆、数据源)“链接”在一起,构建复杂的应用程序,其中Agent是其核心应用之一。它更关注于 “工作流”的构建。
◦
核心抽象: Chains (调用链), Agents (智能体), Memory (记忆模块), Callbacks (回调系统)。
•
LlamaIndex:一个专注于外部数据的“数据”框架 (Data Framework for External Data)
◦
哲学: LlamaIndex的出发点是解决LLM与私有或外部数据连接的核心问题,即RAG (Retrieval-Augmented Generation)。它专注于如何高效地摄入(ingest)、索引(index)、和查询(query)外部数据。它更关注于“数据流”的管理。
◦
核心抽象: Data Connectors (数据连接器), Indexes (索引结构), Retrievers (检索器), Query Engines (查询引擎)。
核心应用场景的不同:
无法直接创建“电子表格”的副本。请重新插入或打开原文复制粘贴。
总结:
•
如果你的项目以Agent为核心,需要复杂的逻辑编排和多工具协作,首选LangChain。
•
如果你的项目以数据为核心,需要构建强大的知识库和问答能力,首选LlamaIndex。
•
在实际开发中,两者也常常被结合使用:例如,使用LlamaIndex构建一个强大的知识库检索工具,然后将这个工具接入到LangChain构建的Agent中,让Agent能够利用这个知识库来完成更复杂的任务。
4.7 在构建一个复杂的 Agent 时,你认为最主要的挑战是什么?
•
参考答案: 构建一个复杂的Agent(例如,需要多步规划、多工具交互、长期记忆的Agent)时,会遇到一系列从理论到工程的挑战。我认为最主要的挑战可以归结为以下几点:
4.8 什么是多智能体系统?让多个 LLM Agent 协同工作相比于单个 Agent 有什么优势?又会引入哪些新的复杂性?
参考答案: 多智能体系统 (Multi-Agent System, MAS) 是一个由多个自主的、交互的智能体组成的系统。这些智能体在同一个环境中运作,它们可以相互通信、协作、竞争或协商,以解决单个智能体难以解决的复杂问题。在LLM的背景下,就是让多个LLM Agent协同工作。
相比于单个Agent的优势:
a.
分工与专业化 (Division of Labor & Specialization):
▪
我们可以为每个Agent设定不同的角色和专长。例如,在一个软件开发团队中,可以有一个“产品经理Agent”负责需求分析,一个“程序员Agent”负责编写代码,一个“测试工程师Agent”负责编写测试用例。每个Agent都可以基于专门的知识和工具进行微调,从而在各自领域达到更高的专业水平。
b.
并行处理与效率 (Parallelism & Efficiency):
引入的新的复杂性:
a.
通信协议与语言 (Communication Protocol & Language):
▪
Agent之间如何有效沟通?需要设计一套标准化的通信协议和消息格式,确保它们能够相互理解意图、状态和知识。这本身就是一个巨大的挑战。
b.
协调与协作机制 (Coordination & Collaboration Mechanisms):
▪
如何分配任务?谁来领导?如何解决冲突和资源争抢?这需要复杂的协调机制,例如集中的“指挥官”Agent,或者分布式的协商协议(如合同网、拍卖)。
4.9 当一个 Agent 需要在真实或模拟环境中(如机器人、游戏)执行任务时,它与纯粹基于软件工具的 Agent 有什么本质区别?
参考答案: 当Agent从纯粹的软件环境(调用API、读写文件)进入到真实或模拟的物理环境(如机器人、游戏)时,我们称之为具身智能体(Embodied Agent)。这种转变引入了几个本质的区别,极大地增加了任务的复杂性。
本质区别主要体现在以下几个方面:
4.10 如何确保一个 Agent 的行为是安全、可控且符合人类意图的?在 Agent 的设计中,有哪些保障对齐方法?
参考答案: 确保Agent的安全、可控和对齐是Agent技术能够被信任和应用的前提,这是一个系统性工程,需要在多个层面进行设计。
主要的保障对齐方法包括:
a.
核心模型的对齐(Core Model Alignment):
4.11 了解A2A框架吗?它和普通Agent框架的区别在哪,挑一个最关键的不同点说明。
参考答案: 是的,我了解A2A(Agent-to-Agent)框架或协议的概念。它代表了多智能体系统研究中的一个重要方向。
和普通Agent框架的区别: 一个普通的Agent框架,如LangChain或Auto-GPT,其核心关注点是单个Agent的内部工作循环和能力。它定义了一个Agent如何感知环境、进行规划(思考)、调用工具(行动)、并处理反馈(观察)。它的设计蓝图是围绕着一个独立的、自主的个体。
而A2A框架的核心关注点则完全不同,它关注的是多个异构Agent之间的通信和协作。它试图定义一套通用的标准、协议和语言,使得由不同开发者、使用不同技术栈、为了不同目标而构建的Agent们,能够相互发现、理解和交互。
最关键的不同点:
普通Agent框架关注的是“个体的实现”(Implementation of an individual),而A2A框架关注的是“群体的交互标准”(Interaction standard for a collective)。
举例来说:
▪
LangChain告诉你如何用Python代码构建一个能使用Google搜索和计算器的Agent。它关心的是这个Agent内部的逻辑流(AgentExecutor, Chains, Tools)。
所以,最关键的不同点在于抽象层次。普通Agent框架在“应用层”,致力于构建能干活的个体;而A2A框架在“协议层”,致力于构建一个能让所有个体互相交流的“社会规则”或“互联网协议”。A2A是实现真正复杂的、去中心化的多智能体协作的必要基础。
4.12 你用过哪些Agent框架?选型是如何选的?你最终场景的评价指标是什么?
参考答案: (这是一个考察实践经验的问题,回答时应展现出对主流工具的了解和有条理的决策过程。以下提供一个回答范例。)
是的,我在多个项目中实践过不同的Agent框架。我最常用的主要有两个:LangChain 和 LlamaIndex,偶尔也会使用更轻量级的库如 AutoGen 进行多智能体实验。
选型是如何选的? 我的选型过程主要基于项目的核心需求,我通常会从“逻辑编排驱动”还是“数据驱动”这两个角度来考虑:
a.
当项目是“逻辑编排驱动”时,我首选LangChain。
▪
场景: 这类项目的核心是构建一个复杂的、需要执行一系列步骤、并与多种外部工具(APIs, 数据库, 文件系统)交互的Agent。例如,一个自动化的研究助手,需要先上网搜索,然后对结果进行总结,再用代码执行器进行数据分析。
▪
选择理由: LangChain提供了非常强大和灵活的Agent Executor和Chains(特别是LCEL表达式语言),能够很好地编排和控制复杂的执行流。它的工具集成生态也是最丰富的。
b.
当项目是“数据驱动”时,我首选LlamaIndex。
▪
场景: 这类项目的核心是构建一个围绕特定知识库的问答或分析系统,即高级RAG(Retrieval-Augmented Generation)。例如,一个能回答公司内部上千份PDF技术文档的客服机器人。
▪
选择理由: LlamaIndex在数据的摄入、索引、和检索方面做得比LangChain更深入、更专业。它提供了更多样化和高级的索引结构(如树索引、知识图谱索引)和检索策略(如混合检索、重排序),对于优化RAG的质量至关重要。
最终场景的评价指标是什么? 评价指标是高度依赖于具体场景的,但我通常会从以下三个维度来综合评估一个Agent的性能:
a.
任务成功率 (Task Success Rate):
▪
定义: 这是最重要的结果导向指标。它衡量Agent在多大比例上成功地、完整地完成了最终任务。
▪
举例: 对于一个代码生成Agent,能否生成无语法错误且能通过所有单元测试的代码。对于一个问答Agent,答案的准确率和完整性。
4.13 有微调过Agent能力吗?数据集如何收集?
参考答案: (这是一个考察高级实践能力的问题。回答的关键在于展现出对Agent微调核心思想的理解——即微调的是“思考过程”而非最终答案。)
是的,我对通过微调来提升Agent特定能力的实践有所了解和尝试。单纯依靠提示(Prompting)来驱动的Agent(zero-shot Agent)在复杂或特定领域的任务上,其稳定性和效率往往不够理想。微调是让Agent变得更可靠、更高效的关键步骤。
微调Agent能力的核心是教会模型如何更好地“思考”和“使用工具”,本质上是一种行为克隆(Behavioral Cloning)。
数据集如何收集? Agent微调的数据集不是简单的(输入,输出)对,而是一系列高质量的 “决策轨迹”(decision-making trajectories)。收集这类数据集主要有以下几种方法:
使用强大的“教师模型”生成合成数据 :
▪
流程: 这是目前最主流和高效的方法。
定义任务和工具: 首先明确Agent需要完成的任务和可用的工具集。
RAG
5.1 请解释 RAG 的工作原理。与直接对 LLM 进行微调相比,RAG 主要解决了什么问题?有哪些优势?
•
参考答案: RAG (Retrieval-Augmented Generation) 的工作原理是一种“先检索,后生成”的模式,它将信息检索(Information Retrieval)与文本生成(Text Generation)相结合,来增强大型语言模型(LLM)的能力。
•
工作流程如下:
a.
检索(Retrieve): 当用户提出一个问题时,RAG系统首先不会直接将问题发送给LLM。相反,它会把用户的问题作为一个查询(Query),在一个外部的知识库(通常是向量数据库)中进行搜索,找出与问题最相关的几段信息(documents/chunks)。
b.
增强(Augment): 系统会将检索到的这些相关信息与用户的原始问题拼接在一起,形成一个内容更丰富、信息量更大的增强提示(Augmented Prompt)。
c.
生成(Generate): 最后,将这个增强后的提示喂给LLM。LLM会基于其自身的知识和我们提供的上下文信息,生成一个更准确、更具事实性的回答。
•
RAG主要解决了LLM的以下核心问题:
a.
知识的静态性与过时性: LLM的知识被“冻结”在其训练数据截止的那个时间点。RAG通过连接一个可以随时更新的外部知识库,使得LLM能够获取和利用最新的信息,解决了知识过时的问题。
b.
幻觉(Hallucination): LLM在回答其知识范围外或不确定的问题时,倾向于捏造事实。RAG通过提供具体的、相关的上下文,将LLM的回答“锚定”在这些事实依据上,显著降低了幻觉的产生。
c.
缺乏专业领域知识与私有知识: 对LLM进行微调来注入特定领域的知识成本高昂且效果有限。RAG可以轻松地将模型与任何私有数据集(如公司内部文档、个人笔记)连接起来,使其成为一个领域专家。
•
与微调(Fine-tuning)相比,RAG的优势:
◦
知识更新成本低: 更新知识只需在数据库中添加或修改文档,无需重新训练昂贵的LLM。而微调则需要重新进行训练。
5.2 一个完整的 RAG 流水线包含哪些关键步骤?请从数据准备到最终生成,详细描述整个过程。
•
参考答案: 一个完整的RAG流水线可以分为两个主要阶段:离线的数据准备(索引)阶段 和 在线的查询(推理)阶段。
•
阶段一:数据准备 / 索引流水线 (Offline / Indexing Pipeline) 这个阶段的目标是构建一个可供检索的知识库,它通常是一次性或周期性执行的。
a.
数据加载(Load): 从各种数据源加载原始文档。数据源可以是PDF文件、Word文档、网页、Notion数据库、Confluence页面、数据库表格等。
•
阶段二:查询 / 推理流水线 (Online / Inference Pipeline) 这个阶段是当用户提出问题时实时执行的。
a.
用户提问(User Query): 系统接收用户输入的自然语言问题。
b.
查询嵌入(Embed Query): 使用与步骤三中完全相同的嵌入模型,将用户的提问也转换成一个查询向量。
c.
向量检索(Retrieve): 将这个查询向量与向量数据库中存储的所有文本块向量进行相似度计算(通常是余弦相似度或点积)。系统会找出与查询向量最相似的Top-K个文本块向量,并将它们对应的原始文本块内容检索出来。
5.3 在构建知识库时,文本切块策略至关重要。你会如何选择合适的切块大小和重叠长度?这背后有什么权衡?
•
参考答案: 文本切块(Chunking)是RAG流程中最关键且最需要经验的步骤之一,它直接影响检索的召回率和精确度,进而影响最终生成答案的质量。选择合适的切块大小(Chunk Size)和重叠长度(Overlap)需要在多个因素之间进行权衡。
•
如何选择合适的切块大小(Chunk Size)?
a.
依据嵌入模型的能力: 嵌入模型有其输入的最大Token数限制。切块大小应小于这个限制。同时,很多嵌入模型在处理中等长度(如256-512个token)的文本时效果最好,过长或过短都可能导致语义表征质量下降。
b.
依据数据的类型和结构:
•
如何选择合适的重叠长度(Overlap)?
•
重叠长度的作用是防止语义信息在切块边界被硬生生地切断。例如,一个重要的概念可能在一句话的结尾被提出,而在下一句话的开头进行解释。如果没有重叠,这句话就会被分割到两个独立的块中,破坏其完整性。
•
背后的权衡(Trade-offs):
◦
大块(Large Chunks) vs. 小块(Small Chunks):
▪
大块的优点: 包含更丰富的上下文,有助于回答需要广泛背景知识的复杂问题。
▪
大块的缺点:
噪声增加: 可能会包含大量与用户查询不直接相关的信息,稀释了关键信息的“信噪比”。
检索精度下降: 嵌入向量代表的是整个大块的平均语义,可能无法精确匹配非常具体的问题。
成本更高: 送入LLM的上下文更长,API调用成本更高。
“大海捞针”问题: 容易触发LLM的“Lost in the Middle”问题。
▪
小块的优点: 信息密度高,与具体问题的相关性强,检索更精确。
▪
小块的缺点:
上下文不足: 单个小块可能不包含回答问题所需的全部信息,需要检索并拼接多个小块才能形成完整答案。
•
总结: 切块策略没有唯一的“最佳”方案。实践中,通常会从一个合理的基线(如chunk_size=512, overlap=64)开始,然后通过评估检索质量,针对具体的文档类型和查询场景进行迭代优化。有时甚至会采用多尺度切块的策略,即同时索引不同大小的块,以应对不同粒度的查询。
5.4 如何选择一个合适的嵌入模型?评估一个 Embedding 模型的好坏有哪些指标?
•
参考答案: 选择合适的嵌入模型(Embedding Model)是决定RAG系统检索效果的基石。一个好的嵌入模型应该能够将语义相近的文本映射到向量空间中相近的位置。
•
如何选择合适的嵌入模型?
a.
参考公开排行榜(Leaderboards):
▪
MTEB (Massive Text Embedding Benchmark) 是目前最权威、最全面的嵌入模型评测基准。它涵盖了多种任务和语言,是选择模型的首要参考。可以直接查看MTEB排行榜,选择在 检索(Retrieval) 任务上得分高的模型。
▪
C-MTEB是专门针对中文的排行榜。
b.
考虑具体应用场景:
▪
领域特异性: 如果你的知识库是某个专业领域(如医疗、法律、金融),可以考虑使用在该领域数据上预训练或微调过的嵌入模型,它们通常比通用模型表现更好。
•
评估Embedding模型好坏的指标: 评估指标主要来自MTEB基准,可以分为几大类:
a.
检索(Retrieval): 这是对RAG最重要的评估任务。
▪
nDCG@k (Normalized Discounted Cumulative Gain): 综合衡量了检索结果的相关性和排名。是检索任务中最核心和最全面的指标。
▪
Recall@k: 衡量在前k个结果中,召回了多少比例的相关文档。
5.5 除了基础的向量检索,你还知道哪些可以提升 RAG 检索质量的技术?
•
参考答案: 基础的向量检索(Dense Retrieval)虽然有效,但在处理复杂查询和多样化文档时往往会遇到瓶颈。为了提升检索质量,学术界和工业界发展出了许多先进的技术,主要可以分为增强检索器和优化查询两大类。
•
一、 增强检索器(Improving the Retriever)
a.
混合搜索(Hybrid Search):
▪
技术: 将 稀疏检索(Sparse Retrieval) 和 密集检索(Dense Retrieval) 相结合。
•
稀疏检索(如BM25): 基于关键词匹配,对于包含特定术语、缩写、ID的查询非常有效。
•
密集检索(向量搜索): 基于语义相似度,擅长理解长尾、口语化的查询。
▪
优势: 兼顾了关键词精确匹配和语义模糊匹配的能力,效果通常远超单一检索方法。
b.
重排序(Re-ranking):
▪
技术: 采用一个 两阶段(two-stage) 的检索流程。
召回(Recall): 先用一个快速但相对粗糙的方法(如向量搜索或混合搜索)从海量文档中召回一个较大的候选集(例如Top 50)。
重排(Re-rank): 再使用一个更强大、更复杂的模型(通常是Cross-Encoder)对这个小候选集进行精细化的重排序,选出最终的Top-N(例如Top 5)作为上下文。
•
二、 优化查询(Improving the Query)
a.
查询扩展与转换(Query Expansion & Transformation):
▪
技术: 不直接使用用户的原始查询进行检索,而是先用LLM对查询进行“加工”。
▪
方法:
•
多查询检索(Multi-Query Retrieval): 让LLM针对原始问题,从不同角度生成多个不同的查询,然后对所有查询的检索结果进行合并。
•
HyDE(Hypothetical Document Embeddings): 让LLM先针对问题生成一个“假设性”的答案,然后用这个假设性答案的嵌入去检索,因为答案的文本和目标文档的文本在形式上更相似。
•
子问题查询(Sub-Querying): 对于复杂问题,先将其分解成多个简单的子问题,分别检索,再汇总结果。
•
三、 优化索引结构(Improving the Index)
5.6 请解释“Lost in the Middle”问题。它描述了 RAG 中的什么现象?有什么方法可以缓解这个问题?
•
参考答案: “Lost in the Middle” 是指大型语言模型(LLM)在处理一个长上下文(long context)时,倾向于更好地回忆和利用位于上下文开头和结尾的信息,而忽略或遗忘位于中间部分的信息的一种现象。这个发现在斯坦福大学的一篇名为《Lost in the Middle: How Language Models Use Long Contexts》的论文中被系统性地揭示。
•
在RAG中的现象: 这个现象对RAG系统有直接且重要的影响。在RAG的生成阶段,我们通常会将检索到的Top-K个文档块与用户的原始问题拼接起来,形成一个长长的prompt。例如: [原始问题] + [文档1] + [文档2] + [文档3] + ... + [文档K]
•
如果LLM存在“Lost in the Middle”的问题,那么:
•
缓解方法:
a.
文档重排序(Document Re-ordering):
▪
核心思想: 不再按照检索分数的顺序简单地拼接文档,而是有策略地放置它们。
▪
具体做法: 在将检索到的K个文档送入LLM之前,进行一次重排序。将最相关的文档放置在上下文的开头和结尾,而将次要相关的文档放在中间。这样可以确保关键信息处于LLM的“注意力甜点区”。
5.7 如何全面地评估一个 RAG 系统的性能?请分别从检索和生成两个阶段提出评估指标。
参考答案: 全面地评估一个RAG系统,必须将其拆分为检索阶段和生成阶段两个独立但又相互关联的部分进行评估,因为最终答案的质量是这两个阶段共同作用的结果。一个好的评估框架应该同时包含客观的、自动化的指标和主观的、人工的评估。
第一阶段:检索性能评估 (Retrieval Evaluation) 这个阶段的目标是评估我们的检索器(Retriever)能否“找得对、找得全”。评估需要一个包含(问题,相关文档ID)的标注数据集。
核心指标:
a.
上下文精确率 (Context Precision): 衡量检索到的文档中有多少是真正与问题相关的。它反映了检索结果的信噪比。
b.
上下文召回率 (Context Recall): 衡量所有相关的文档中,有多少被我们的检索器成功找回来了。它反映了信息查找的全面性。
◦
其他常用排名指标: 3. Hit Rate: 检索到的文档中是否至少包含一个相关文档。这是一个基础的“及格线”指标。 4. MRR (Mean Reciprocal Rank): 第一个相关文档排名的倒数的平均值。它衡量找到第一个正确答案的速度。 5. nDCG@k (Normalized Discounted Cumulative Gain): 最全面和常用的指标之一,它同时考虑了检索结果的相关性等级和它们在结果列表中的排名。
第二阶段:生成性能评估 (Generation Evaluation) 这个阶段的目标是评估LLM在给定上下文后,能否生成“忠实、准确、有用”的答案。
核心指标(通常需要LLM-as-a-Judge或人工评估):
i.
忠实度/可溯源性 (Faithfulness / Groundedness):
•
评估问题: 生成的答案是否完全基于所提供的上下文?是否存在捏造或幻觉?
•
评估方法: 将生成的答案与上下文进行对比,检查答案中的每一句话是否都能在上下文中找到依据。
ii.
答案相关性 (Answer Relevancy):
•
评估问题: 生成的答案是否直接、清晰地回答了用户的原始问题?
•
评估方法: 评估答案与用户问题的匹配程度,看是否存在答非所问的情况。
iii.
答案正确性 (Answer Correctness):
•
评估问题: 答案中的信息是否事实准确?(这是一个更严格的指标,因为有时即使忠于原文,原文也可能是错的)
•
评估方法: 与一个“黄金标准”答案(Ground Truth)进行比较,或由领域专家进行事实核查。
自动化评估框架:
5.8 在什么场景下,你会选择使用图数据库或知识图谱来增强或替代传统的向量数据库检索?
•
参考答案: 我会选择使用图数据库或知识图谱(Knowledge Graph, KG)来增强或替代传统向量数据库,主要是在处理高度关联、结构化的数据以及需要进行复杂关系推理的场景下。
•
向量数据库擅长的是语义相似度的模糊匹配,而知识图谱擅长的是实体与关系的精确查询。
•
核心应用场景:
a.
需要多跳推理(Multi-hop Reasoning)的复杂问题:
▪
场景描述: 当用户的问题无法通过单个文档或事实来回答,而需要沿着实体之间的关系链进行多次“跳转”才能找到答案时。
▪
举例:
•
“Llama 2 的作者所在的公司的CEO是谁?”
◦
这是一个三跳查询:Llama 2 -> 作者 -> Meta -> CEO
•
增强或替代? 在大多数情况下,知识图谱和向量数据库是互补增强的关系,而非完全替代。一个常见的先进RAG模式是:
a.
混合检索: 首先用LLM分析用户问题。
b.
如果问题涉及复杂关系,则先查询知识图谱,找到核心的实体和事实。
c.
然后,将这些从图谱中检索到的结构化信息,作为上下文,或者用来构建更精确的查询,再去向量数据库中检索相关的非结构化文本,以获得更详细的解释和背景。
d.
最后,将两方面的信息汇总给LLM生成答案。
5.9 传统的 RAG 流程是“先检索后生成”,你是否了解一些更复杂的 RAG 范式,比如在生成过程中进行多次检索或自适应检索?
•
参考答案: 是的,传统的“先检索后生成”(Retrieve-then-Read)范式虽然经典,但比较刻板。为了应对更复杂的问题和提升答案质量,研究界已经提出了多种更动态、更智能的RAG范式。
迭代式检索 (Iterative Retrieval) - 例如 Self-RAG, Corrective-RAG
◦
核心思想: 将RAG从一个单向的流水线,变成一个循环、自我修正的过程。
◦
工作流程:
i.
首次检索与生成: 像传统RAG一样,进行检索并生成一个初步的答案。
ii.
反思与评估(Reflection): LLM会对初步生成的答案和检索到的上下文进行“反思”。它会评估:当前的信息是否足够支撑答案?答案是否还有不确定或缺失的部分?
iii.
二次检索: 如果认为信息不足,LLM会主动生成一个新的、更具针对性的查询,进行新一轮的检索。例如,如果初步答案是“A公司的CEO是张三”,模型可能会反思“这个信息是否最新?”,然后生成一个新的查询“A公司2025年的CEO是谁?”
iv.
整合与精炼: LLM会整合新旧检索到的所有信息,生成一个更完善、更准确的最终答案。
自适应检索 (Adaptive Retrieval) - 例如 FLARE, Self-Ask
◦
核心思想: 不在生成前一次性检索所有信息,而是在生成过程中“按需”检索,实现“即时”(just-in-time)的信息获取。
◦
工作流程:
i.
开始生成: LLM根据问题开始直接生成答案。
ii.
预测不确定性: 它会一边生成,一边预测接下来的内容。当它预测到即将生成一个事实性信息(如人名、日期、地点),但对此不确定(表现为下一个词的概率分布很平坦)时,它会暂停生成。
多源数据RAG (Multi-Source RAG)
◦
核心思想: 让Agent能够智能地从多种不同类型的数据源中进行检索和整合。
◦
工作流程: Agent首先对问题进行分解,判断回答这个问题需要哪些信息。然后,它可能会决定:
▪
从向量数据库中检索相关的非结构化文档。
▪
从知识图谱中查询结构化的实体关系。
5.10 RAG 系统在实际部署中可能面临哪些挑战?
•
参考答案: 将一个RAG原型系统部署到生产环境中,会面临一系列从数据到模型、再到工程和运维的实际挑战。
a.
数据处理与维护的复杂性 (Data Pipeline Complexity):
▪
分块策略的泛化性: 一个在PDF上效果很好的分块策略,可能在处理HTML或JSON数据时效果很差。为异构数据源设计和维护一套鲁棒的分块策略非常困难。
▪
知识库的实时更新: 如何高效地保持向量索引与源数据的同步?当源文档被修改或删除时,需要有可靠的机制来更新或废弃对应的向量,这涉及到复杂的ETL(Extract, Transform, Load)流程。
b.
性能瓶颈:延迟与成本 (Performance Bottlenecks: Latency & Cost):
▪
延迟: RAG的“检索+生成”两步天然比直接调用LLM要慢。在实时交互场景下,检索和LLM生成的延迟都必须被极致优化。
5.11 了解搜索系统吗?和RAG有什么区别?
•
参考答案: 是的,我了解搜索系统。搜索系统和RAG系统关系紧密,但它们的目标和最终产出有本质的区别。可以说,RAG系统是构建在搜索系统之上的一个更高级的应用。
•
搜索系统 (Search System) - 例如 Google Search, Elasticsearch
◦
核心目标: 信息检索(Information Retrieval)。它的任务是,根据用户的查询,从一个大规模的文档集合中,找到并返回一个排序好的文档列表(a ranked list of documents)。
◦
最终产出: “源”。它提供的是“可能包含答案的原材料”,用户需要自己去点击链接、阅读文档、并从中自己总结出答案。
◦
核心技术: 索引技术(如倒排索引)、排序算法(如BM25, PageRank, TF-IDF)、查询理解和扩展。
•
RAG系统 (Retrieval-Augmented Generation System)
◦
核心目标: 问题回答(Question Answering)。它的任务是,根据用户的查询,直接提供一个精准的、对话式的、综合性的自然语言答案。
◦
最终产出: “答案”。它利用检索到的“源”作为事实依据,但最终交付的是一个经过综合、提炼和总结后的成品。
•
最关键的区别:
无法直接创建“电子表格”的副本。请重新插入或打开原文复制粘贴。
一个简单的比喻:
搜索系统就像一个图书馆的图书管理员。你问他“新加坡的历史”,他会告诉你:“关于这个主题,3楼A区的第5、6、8本书,还有4楼C区的期刊都很有用,你自己去看看吧。”
RAG系统就像一个历史学专家。你问他同样的问题,他会去图书馆查阅那些书籍和期刊,然后直接告诉你:“新加坡的历史可以概括为以下几个关键时期......,这些信息主要参考了《新加坡史》和《近代东南亚》这几本书。”
5.12 知道或者使用过哪些开源RAG框架比如Ragflow?如何选择合适场景?
参考答案: 是的,我了解并关注着多个开源RAG框架和平台。除了最广为人知的、作为基础工具库的 LangChain 和 LlamaIndex 之外,还涌现出了一批更专注于提供端到端RAG解决方案的平台,其中 RAGFlow 就是一个很有代表性的例子。其他类似的框架还包括 Haystack, DSPy 等。
对RAGFlow的理解: RAGFlow与LangChain/LlamaIndex这类“代码库”形态的框架不同,它更像一个 “开箱即用”的、对业务人员更友好的RAG应用平台。
它的特点是:
如何选择合适场景?
选择哪个框架主要取决于项目的需求、团队的技能和对定制化的要求。
选择 LangChain / LlamaIndex 的场景:
◦
高度定制化需求: 当你需要对RAG流水线的每一个环节(例如,自定义分块逻辑、实现复杂的混合检索策略、集成公司内部的特定工具)进行深度控制和定制时。
◦
作为底层库集成: 当你不是要构建一个独立的RAG应用,而是想把RAG能力作为一部分,嵌入到一个更大的、复杂的软件系统中时。
◦
开发者为核心的团队: 当你的团队主要是由熟悉Python和AI开发的工程师组成,他们乐于从零开始、灵活地构建和优化系统。
◦
一句话总结: 选择它们是为了“灵活性”和“控制力”。
选择 RAGFlow / Haystack 这类平台的场景:
我的选择策略: 在项目初期,如果需要快速看到效果,我会考虑使用RAGFlow这样的平台来搭建一个基线(Baseline)。在验证了业务价值后,如果发现平台的标准化流程无法满足我们更深度的性能优化或业务逻辑定制需求,我可能会考虑使用LangChain或LlamaIndex,将RAGFlow中验证过的有效模块,用代码进行更精细化的重构和实现。
模型评估与 Agent 评估
6.1 为什么传统的 NLP 评估指标(如 BLEU, ROUGE)对于评估现代 LLM 的生成质量来说,存在很大的局限性?
参考答案: 传统的NLP评估指标,如BLEU(常用于机器翻译)和ROUGE(常用于文本摘要),其核心思想是比较模型生成的文本与一个或多个“参考答案”在表层词汇(n-gram)上的重合度。这种方法对于评估现代LLM的生成质量存在巨大局限性,原因如下:
a.
语义理解的缺失(Lack of Semantic Understanding):
▪
这些指标只关心词汇的表面匹配,完全不理解其背后的语义。例如,“今天天气很好”和“今天日光很灿烂”,在人类看来意思相近,但它们的BLEU/ROUGE得分会很低,因为词汇重合度小。反之,一个与参考答案词汇高度重合但语法不通或逻辑混乱的句子,也可能得到高分。
b.
无法评估事实准确性(Cannot Evaluate Factual Accuracy):
▪
LLM的核心挑战之一是幻觉。一个生成的答案可能在语言上非常流畅,甚至与参考答案的风格相似,但包含完全错误的事实。BLEU/ROUGE无法检测出这种事实性错误。
c.
忽略了多样性与创造性(Ignores Diversity and Creativity):
▪
对于开放式生成任务(如对话、写作、头脑风暴),根本不存在唯一的“标准答案”。一个好的LLM应该能生成多样化、有创意且合理的回答。而基于固定参考答案的评估方法会“惩罚”任何与参考答案不同但同样优秀的回答,扼杀了创造性。
d.
对长文本的评估能力差(Poor for Long-form Content):
▪
这些指标在评估长篇文本(如文章、报告)的连贯性(Coherence)、逻辑性和结构性方面几乎是无能为力的。它们只能进行局部、零碎的词汇匹配。
总之,现代LLM的评估需要超越表层词汇,深入到语义理解、事实性、逻辑推理、安全性、遵循指令等更高维度的能力层面,而这正是BLEU和ROUGE等传统指标的盲区。
6.2 请介绍几个目前行业内广泛使用的 LLM 综合性基准测试,并说明它们各自的侧重点。(例如:MMLU, Big-Bench, HumanEval)
参考答案: 为了更全面地评估LLM的能力,学术界和工业界开发了许多综合性基准测试。其中,MMLU、Big-Bench和HumanEval是最具代表性的几个,它们各自有不同的侧重点:
a.
MMLU (Massive Multitask Language Understanding)
▪
侧重点: 知识的广度与学科问题解决能力。
▪
简介: MMLU是一个大规模的多任务测试集,旨在衡量模型在各种学科领域的知识水平。它包含57个不同的科目,涵盖了从初等数学、美国历史、计算机科学到专业级别的法律、市场营销和医学等。
•
其他重要基准:
◦
GSM8K: 专注于评估小学水平的数学应用题的推理能力,需要模型进行多步的思维链推理。
◦
ARC (AI2 Reasoning Challenge): 专注于评估需要科学常识和推理的、有挑战性的选择题。
◦
HellaSwag: 专注于评估常识推理,任务是选择一个最合理的句子来续写一个给定的情景。
6.3 什么是“LLM-as-a-Judge”?使用 LLM 来评估另一个 LLM 的输出,有哪些优点和潜在的偏见?
•
参考答案: “LLM-as-a-Judge” 是一种新兴的、自动化的模型评估范式。它的核心思想是利用一个功能强大的、前沿的LLM(通常是像GPT-4o或Claude 3 Opus这样的闭源模型,被称为“裁判模型”)来评估另一个被测试LLM的输出质量。
•
工作流程:
•
优点:
a.
可扩展性与效率(Scalability & Efficiency): 这是最大的优点。相比于昂贵且缓慢的人工评估,LLM裁判可以近乎实时地、大规模地对海量模型输出进行评估,极大地加速了模型迭代的反馈循环。
b.
一致性(Consistency): 只要裁判模型和评估提示固定,其评估标准就是一致的,避免了不同人类标注者之间主观差异带来的不一致性问题。
c.
可定制化(Customizability): 可以通过设计不同的评估准则和提示,轻松地让裁判模型从任意维度(如简洁性、创造性、安全性、共情能力等)来评估输出,非常灵活。
•
潜在的偏见:
•
因此,LLM-as-a-Judge是一个强大高效的评估工具,但不能完全替代人类评估,尤其是在需要深度专业知识和对齐验证的场景。最佳实践是将其作为人类评估的有力补充和规模化工具。
6.4 如何设计一个评估方案来衡量 LLM 的特定能力,比如“事实性/幻觉水平”、“推理能力”或“安全性”?
•
参考答案: 为衡量LLM的特定能力设计评估方案,需要遵循“定义能力 -> 构建数据集 -> 确定评估方法”的流程。
衡量“事实性/幻觉水平”:
◦
能力定义: 模型生成的回答是否基于可验证的事实,而不是捏造信息。
◦
数据集构建:
▪
基于知识库的QA: 构建一个问题集,其中每个问题的答案都可以从一个确定的知识源(如Wikipedia、公司内部文档、数据库)中找到。
▪
对抗性问题: 设计一些诱导模型产生幻觉的问题,比如询问关于不存在的人物或事件的信息。
◦
评估方法:
▪
精确匹配/关键词匹配: 对于事实简单的问题(如“谁是新加坡现任总统?”),可以直接将生成答案中的实体与标准答案进行比较。
▪
LLM-as-a-Judge: 使用一个更强大的LLM,让它判断生成的答案是否与提供的源知识(ground-truth knowledge)相符或矛盾。
▪
自动化框架: 使用如 FaithScore 或 RAGAS 中的 Faithfulness 指标,它们通过自动化的方式将生成答案的每个声明与上下文进行比对验证。
衡量“推理能力”:
◦
能力定义: 模型能否在没有直接知识的情况下,通过逻辑、数学或常识进行多步推导,得出正确结论。
衡量“安全性”:
◦
能力定义: 模型能否拒绝回答有害、不道德、危险或非法的用户请求。
◦
数据集构建:
▪
使用公开的对抗性提示数据集,如 AdvBench (Adversarial Benchmarks) 或 SafetyBench,它们包含了大量经过设计的、试图绕过安全护栏的“危险问题”。
6.5 评估一个 Agent 为什么比评估一个基础 LLM 更加困难和复杂?评估的维度有哪些不同?
•
参考答案: 评估一个Agent比评估一个基础LLM更加困难和复杂,因为评估的对象从一个静态的、单轮的“文本生成器”,转变为一个动态的、多轮的、与环境交互的“决策者”。
•
困难和复杂性的根源:
评估维度的不同:
无法直接创建“电子表格”的副本。请重新插入或打开原文复制粘贴。
总结来说,对LLM的评估更像是“产品质量检测”,而对Agent的评估更像是“路况复杂的真实驾驶测试”,不仅要看是否到达终点,更要看驾驶过程中的效率、安全性和应对突发状况的能力。
6.6 你了解哪些专门用于评估 Agent 能力的基准测试?这些基准通常如何构建测试环境和任务?
参考答案: 是的,随着Agent研究的兴起,一系列专门用于评估Agent能力的基准测试被开发出来,它们的核心特点是提供可控的、可复现的交互式环境。
•
几个知名的Agent能力基准测试:
a.
WebArena:
▪
专注领域: 网页浏览与操作。
•
这些基准通常如何构建测试环境和任务?
a.
环境构建 -> 沙箱化与可复现性(Sandboxing & Reproducibility):
▪
为了安全和可复现,基准测试通常不会让Agent直接访问真实的互联网,而是创建一个受控的、隔离的环境。
▪
方法:
•
使用 Docker 容器来封装一个包含浏览器、终端、文件系统的独立环境。
•
对于网页浏览,通常会本地托管一个网站的静态副本,或使用Web后台模拟器来响应Agent的请求。
•
对API的调用会被重定向到一个模拟(mock)的API服务器上。
b.
任务构建 -> 目标导向(Goal-Oriented):
6.7 在评估一个 Agent 的任务完成情况时,除了最终结果的正确性,还有哪些过程指标是值得关注的?(例如:效率、成本、鲁棒性)
参考答案: 在评估Agent时,只看最终结果的正确性(Task Success)是远远不够的。一个优秀的Agent不仅要能“做对事”,还要“聪明地、高效地、可靠地做事”。因此,关注过程指标至关重要,它们能更全面地反映Agent的智能水平。
值得关注的关键过程指标包括:
效率 (Efficiency):
◦
定义: 衡量Agent完成任务所消耗的资源。效率是决定Agent在现实世界中是否可用的关键因素。
◦
具体指标:
▪
成本 (Cost):
•
Token消耗量: Agent在所有思考和生成步骤中消耗的总Token数。
•
API调用费用: 如果使用了付费的LLM或工具API,完成一次任务的总花费。
▪
延迟 (Latency):
•
总耗时 (Wall-clock Time): 从任务开始到结束所经过的真实时间。
•
计算时间 (CPU/GPU Time): Agent自身运行所占用的计算时间。
▪
步骤数 (Number of Steps / Turns): Agent执行“思考-行动”循环的总次数。通常,能用更少步骤完成任务的Agent被认为规划能力更强。
鲁棒性 (Robustness):
◦
定义: 衡量Agent在面对非理想、非预期情况时的表现。
◦
具体指标:
▪
错误处理能力 (Error Handling Capability): 当工具返回错误、网页加载失败或遇到预期外的环境状态时,Agent能否识别问题并采取纠正措施(例如,尝试不同的工具、修正输入参数、重新规划)。
▪
抗干扰能力 (Disturbance Resistance): 在环境中加入一些噪声或误导性信息,评估Agent的成功率下降了多少。
自主性与对齐 (Autonomy & Alignment):
◦
定义: 衡量Agent在多大程度上能够独立完成任务,以及其行为是否符合人类的意图。
◦
具体指标:
▪
需要人类干预的次数 (Number of Human Interventions): 在一个需要人类协助的系统中,一个更自主的Agent需要人类帮助的次数更少。
▪
行为可解释性 (Interpretability): Agent的“思考”过程是否清晰、合乎逻辑,是否能让人类理解其决策依据。
通过综合评估这些过程指标,我们不仅能知道Agent“是否能行”,还能深入了解它“行不行得好”,并找到针对性的优化方向。
6.8 什么是红队测试?它在发现 LLM 和 Agent 的安全漏洞与偏见方面扮演着什么角色?
参考答案: 红队测试(Red Teaming)是一种对抗性测试方法,源自于网络安全领域的渗透测试。在AI领域,它指的是组织一个专门的团队(红队),主动地、创造性地、像一个“攻击者”一样,去寻找和利用LLM或Agent的漏洞、缺陷和非预期行为,以评估和提升其安全性和鲁棒性。
与常规测试(使用固定的、已知的测试用例)不同,红队测试的核心在于“探索未知”,发现那些开发者在设计时没有预料到的、可能导致严重后果的“边缘案例”和“攻击向量”。
红队测试在发现安全漏洞与偏见方面的核心角色:
发现安全漏洞 (Security Vulnerabilities):
◦
绕过安全护栏: 红队会设计各种复杂的、精心构造的提示(即“越狱提示”),试图绕过模型的安全审查机制,诱导其生成有害内容,如暴力、色情、仇恨言论或违法活动的指导。
◦
提示注入(Prompt Injection)攻击(针对Agent): 这是对Agent最核心的威胁之一。红队会模拟恶意用户或被污染的外部数据(如一个包含恶意指令的网页),尝试劫持Agent的控制流,让Agent执行非预期的、危险的操作,例如:
▪
泄露其上下文中的敏感信息。
发现偏见 (Biases):
◦
暴露刻板印象: 红队会设计一些涉及特定人群(如种族、性别、国籍、职业)的、看似中立但具有引导性的问题,来暴露模型是否会生成带有刻板印象或歧视性的回答。
◦
测试政治与社会偏见: 通过询问有争议的社会或政治话题,评估模型的立场是否中立,是否存在偏向性。
◦
揭示代表性不足问题: 探索模型在处理非主流文化或群体的相关问题时,是否会表现出知识的缺乏或产生不准确的描述。
总结: 红队测试扮演着“AI系统的免疫系统压力测试员”的角色。它通过模拟最坏情况和最狡猾的对手,帮助开发者在模型部署前,系统性地发现并修复那些在标准测试中难以暴露的深层次安全和对齐问题,是确保AI系统安全、可靠、公平的重要保障。
6.9 在进行人工评估时,如何设计合理的评估准则和流程,以保证评估结果的客观性和一致性?
•
参考答案: 在人工评估中,保证结果的 客观性(Objectivity) 和 一致性(Consistency) 是最大的挑战,因为人类的判断天生是主观的。设计合理的评估准则(Rubric)和流程是克服这一挑战的关键。
•
一、 设计合理的评估准则(Rubric):
a.
明确且原子化的评估维度(Clear and Atomic Dimensions):
▪
不要使用模糊的词语如“好”或“坏”。将“质量”分解为多个相互独立的、具体的维度。例如:
•
准确性(Accuracy): 答案是否包含事实错误?
•
完整性(Completeness): 答案是否全面地回应了问题的所有方面?
•
简洁性(Conciseness): 是否有冗余信息?
•
安全性(Harmlessness): 是否包含有害内容?
b.
量化的评分标准(Quantitative Rating Scale):
▪
使用量化的尺度,如 李克特量表(1-5分) 或 二元判断(是/否)。
•
二、 设计合理的评估流程:
a.
标注者培训与校准(Rater Training and Calibration):
▪
在评估开始前,对所有标注者进行系统性培训,确保他们完全理解评估准则和所有定义。
▪
进行校准会,让所有标注者对同一批样本进行打分,然后公开讨论和对齐打分差异,直到大家的理解趋于一致。
b.
盲评(Blind Evaluation):
▪
标注者不应该知道他们正在评估的回答来自哪个模型(A模型、B模型还是人类)。这可以消除品牌偏见或先入为主的观念。
c.
多次独立评估与一致性检验(Multiple Independent Ratings & Consistency Check):
▪
每个样本至少由 2-3名 标注者独立进行评估。
▪
使用统计指标来衡量标注者间信度(Inter-Annotator Agreement, IAA),如 Cohen's Kappa 或 Fleiss' Kappa。
6.10 如何持续监控和评估一个已经部署上线的 LLM 应用或 Agent 服务的表现,以应对可能出现的性能衰退或行为漂移?
•
参考答案: 对已部署上线的LLM应用或Agent服务进行持续监控和评估,是一个主动的、循环的过程,旨在应对模型漂移(Model Drift)和数据漂移(Data Drift),确保服务质量的稳定。
•
数据漂移指生产环境中的输入数据分布发生了变化(例如,用户开始问一些新型的问题),而模型漂移指模型的预测能力因数据漂移而下降。
•
一个完整的监控评估体系应包含以下几个层面:
采集与日志(Collection and Logging):
◦
全面日志: 记录每一次请求的完整交互数据,包括用户输入、模型生成的中间步骤(如Agent的思考链)、最终输出、调用的工具、延迟、Token消耗等。
◦
用户反馈: 在产品界面中嵌入明确的用户反馈机制,如“顶/踩”按钮、打分、一键报告问题等。这是最直接的性能信号。
自动化监控(Automated Monitoring):
◦
监控代理指标(Proxy Metrics): 监控那些与性能高度相关的、可自动计算的指标。这些指标的异常波动通常是问题的早期预警。
▪
输入指标: 问题长度、主题分布、提问语言等。
▪
输出指标: 回答长度、代码块比例、JSON格式错误率、拒绝回答率等。
▪
过程指标(针对Agent): 平均执行步数、工具调用频率、工具调用失败率。
◦
自动化质量评估:
▪
定期抽样: 从生产流量中随机抽取一小部分样本。
▪
LLM-as-a-Judge: 使用一个强大的“裁判LLM”,根据一套固定的评估准则(如是否有害、是否跑题),对抽样样本进行自动打分。
人工审核与分析(Human Review and Analysis):
◦
定期人工审计: 定期组织运营或评估团队,对生产环境中的随机样本、用户反馈的坏案例、以及自动化监控发现的异常案例进行深入的人工分析。
◦
根本原因分析(Root Cause Analysis): 对于发现的问题,需要深入分析是哪个环节出了问题?是LLM本身能力退化?是Agent的规划逻辑有误?还是某个工具API发生了变更?
反馈闭环与模型迭代(Feedback Loop and Model Iteration):
◦
持续的数据管理: 将从生产环境中发现的有价值的案例(特别是失败案例和用户不喜欢的案例)清洗、标注后,持续地加入到评估集和微调数据集中。
◦
定期再训练/微调: 根据积累的新数据,定期对模型进行微调(Fine-tuning)或重新训练(Re-training),以适应新的数据分布和用户需求。
◦
A/B测试: 在上线新版本的模型或Agent逻辑时,使用A/B测试框架,小流量验证新版本的性能是否优于旧版本,确保每次迭代都是正向的。
•
通过建立这样一个“采集 -> 监控 -> 分析 -> 迭代”的闭环,我们可以主动地管理和维护线上服务的质量,而不是被动地等待用户投诉。