自编码器(Autoencoder)
自编码器(Autoencoder,AE)是一种无监督学习的神经网络,通过学习将输入数据压缩到低维潜在空间,再从压缩表示重构原始数据。
自编码器广泛应用于数据降维、特征提取、异常检测、图像去噪、生成模型等场景。
自编码器基础原理
自编码器的基本结构包含三个部分:
•
编码器(Encoder):将输入数据 映射到低维潜在表示
•
潜在空间(Latent Space):编码器输出的低维向量,也称为瓶颈层
•
解码器(Decoder):将潜在表示 重构为输出
1.1 网络结构
自编码器的目标是让输出 x^x^ 尽可能接近输入 xx:
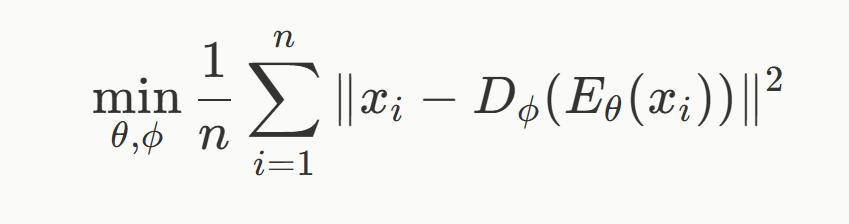
其中 θθ 是编码器参数,ϕϕ 是解码器参数。
1.2 降维效果
自编码器通过强制数据通过比输入维度更小的瓶颈层,从而学习数据的压缩表示。这种压缩保留了数据的主要信息。
与主成分分析(PCA)相比,自编码器可以学习非线性降维,能够捕捉更复杂的数据结构。
基础自编码器实现
2.1 简单自编码器
代码块
Python
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
# ── 自编码器模型 ─────────────────────────────────
class Autoencoder(nn.Module):
"""
基础自编码器:对称结构
"""
def __init__(self, input_dim, hidden_dim, latent_dim):
super().__init__()
2.2 卷积自编码器
对于图像数据,使用卷积层的自编码器效果更好:
代码块
Python
import torch
import torch.nn as nn
class ConvAutoencoder(nn.Module):
"""
卷积自编码器:适用于图像
"""
def __init__(self, channels=3, latent_dim=128):
super().__init__()
# 编码器:逐步减小尺寸,增加通道数
2.3 训练与重构
代码块
Python
import torch
import torch.nn as nn
import torch.optim as optim
# ── 训练配置 ─────────────────────────────────────
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = ConvAutoencoder(channels=3, latent_dim=128).to(device)
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)
# ── 训练循环 ─────────────────────────────────────
def train_autoencoder(model, dataloader, criterion, optimizer, num_epochs=10):
model.train()
for epoch in range(num_epochs):
去噪自编码器 (DAE)
去噪自编码器(Denoising Autoencoder,DAE)在训练时给输入添加噪声,然后学习去除噪声恢复原始输入。这使模型学到更鲁棒的特征表示。
3.1 去噪自编码器实现
代码块
Python
import torch
import torch.nn as nn
class DenoisingAutoencoder(nn.Module):
"""
3.2 其他噪声类型
代码块
Python
def salt_pepper_noise(x, prob=0.1):
"""盐椒噪声"""
random_mask = torch.rand_like(x)
noisy = x.clone()
noisy[random_mask < prob / 2] = 0.0
noisy[random_mask > 1 - prob / 2] = 1.0
return noisy
def mask_noise(x, prob=0.1):
"""遮挡噪声(随机置零)"""
mask = torch.rand_like(x) > prob
变分自编码器 (VAE)
变分自编码器(Variational Autoencoder,VAE)是一种生成模型,它将数据编码为潜在空间中的概率分布,而非固定向量。这使得我们可以从潜在空间中采样生成新数据。
4.1 VAE 核心原理
VAE 的关键创新是学习潜在变量的概率分布:
•
编码器输出均值 μμ 和标准差 σσ
•
从正态分布 N(μ,σ)N(μ,σ) 中采样得到潜在向量 zz
•
解码器从 zz 重构数据
为了实现可微的采样过程,使用了重参数化技巧(Reparameterization Trick):
4.2 VAE 实现
代码块
Python
import torch
import torch.nn as nn
import torch.optim as optim
class VAE(nn.Module):
"""
变分自编码器
"""
4.3 VAE 生成与可视化
代码块
Python
import matplotlib.pyplot as plt
def visualize_latent_space(model, dataloader, device):
"""可视化潜在空间"""
model.eval()
all_mu = []
VAE 的潜在空间是连续的,可以在潜在空间中进行插值,生成平滑过渡的图像。但 VAE 生成的图像通常较模糊,这是因为它优化的是下界而非精确的对数似然。
稀疏自编码器
稀疏自编码器(Sparse Autoencoder)在损失函数中加入稀疏性约束,限制潜在向量的激活数量。这使模型能够学习更有意义的特征。
5.1 稀疏自编码器实现
代码块
Python
import torch
import torch.nn as nn
import torch.nn.functional as F
class SparseAutoencoder(nn.Module):
"""
稀疏自编码器
"""
def __init__(self, input_dim, hidden_dim, latent_dim):
super().__init__()
# 编码器
序列到序列自编码器
对于序列数据(如文本、时间序列),使用 RNN/LSTM 作为编码器和解码器。
6.1 序列自编码器实现
代码块
Python
import torch
import torch.nn as nn
class Seq2SeqAutoencoder(nn.Module):
"""
序列到序列自编码器:用于序列数据
"""
def __init__(self, input_size, hidden_size, latent_size, num_layers=2):
自编码器的应用场景
7.1 异常检测
自编码器可以用于检测异常数据。正常数据的重构误差小,异常数据的重构误差大:
代码块
Python
import torch
import torch.nn as nn
7.2 图像着色与风格迁移
代码块
Python
class ColorizationAutoencoder(nn.Module):
"""
图像着色自编码器
输入:灰度图像 (batch, 1, H, W)
输出:彩色图像 (batch, 2, H, W) (ab 色彩空间)
"""
def __init__(self):
super().__init__()
7.3 数据降维可视化
代码块
Python
import matplotlib.pyplot as plt
def visualize_latent_2d(model, dataloader, device, num_samples=1000):
"""
使用自编码器将数据降到 2 维进行可视化
"""
API 快速参考
8.1 常见自编码器类型
8.2 损失函数选择
8.3 潜在维度选择
代码块
Python