2026 年 10 月该选哪个 AI 模型?AI 模型 A–Z 完全指南与价格一览
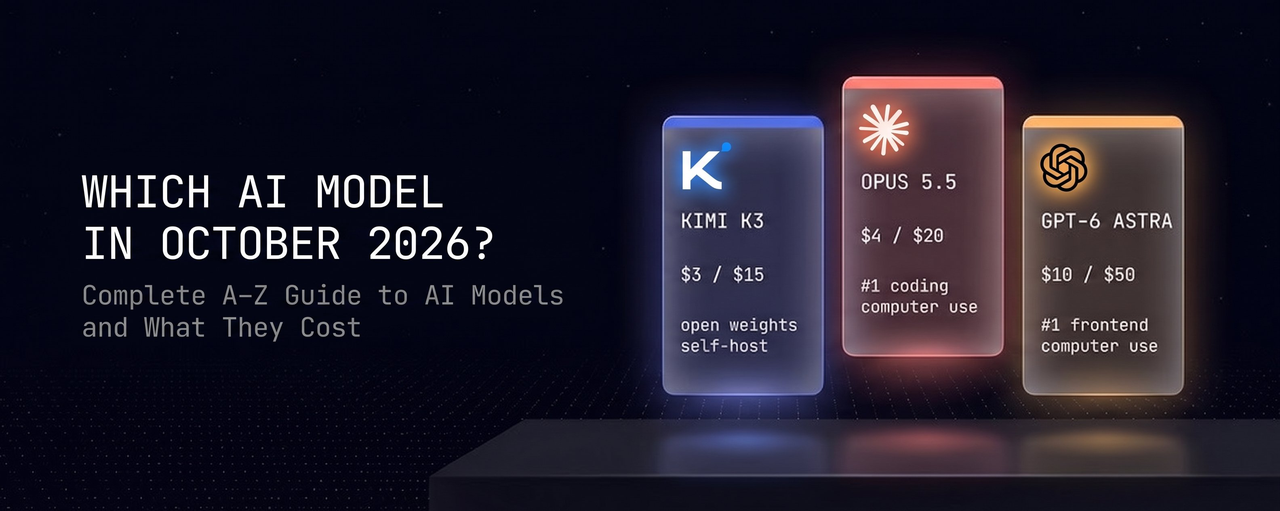
2026 年 9 月,「该用哪个模型」这个问题的答案被改写了三次。
9 月 3 日发布了 GPT-6 Astra;同一周发布了 Claude Fable 5.1;前一天发布了 Gemini 3.8 Flash 和 Meta 的 Muse Spark 1.3。
然后是 9 月 22 日的 Claude Opus 5.5、GPT-6 Sol 和 GPT-6 Luna。
7 月发布的 Kimi K3 现在是这份名单上最老的模型——但它仍然是每一场对比都会拿来当基准的那个。
以下是完整的模型地图:每个模型到底擅长什么,以及你要为此付多少钱。
趁还没忘,先把这篇文章收藏起来。
一图速览
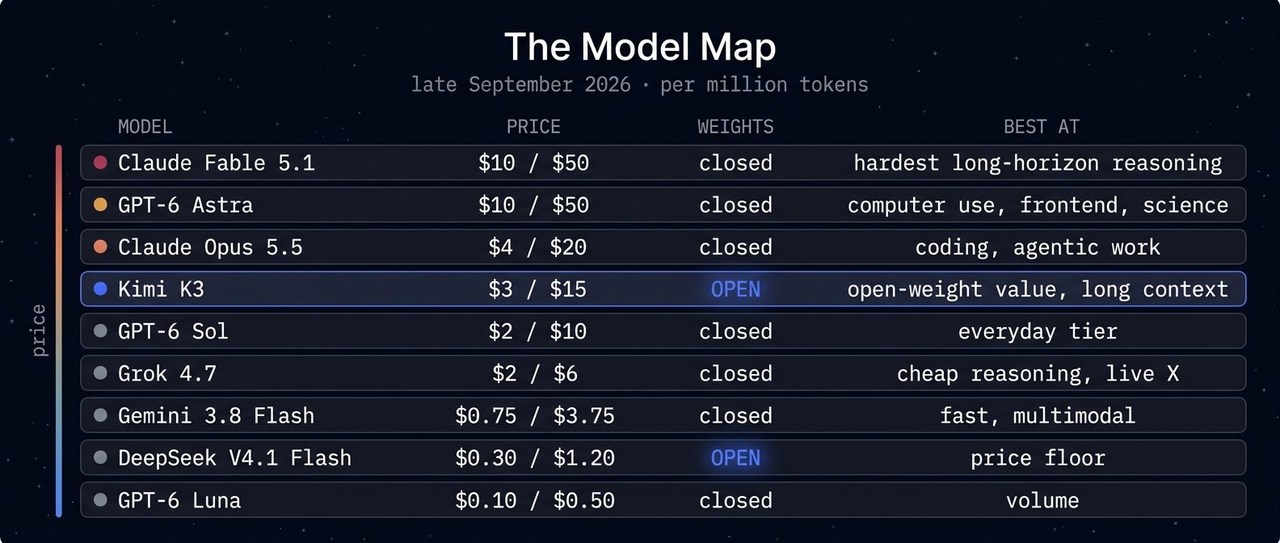
价格为每百万 token 的输入 / 输出价格,截至 2026 年 9 月底。
在看任何基准测试之前,有两件事非常扎眼。
旗舰模型又回到了 $10/$50。Astra 和 Fable 5.1 价格相同;Opus 5.5 的 $4/$20 不到两者的一半。
Kimi K3 不再是最便宜的选择,而是开放的选择。它 $3/$15 的定价只比 Opus 5.5 略低。真正的差别已经不在价格上,而在于你可以下载它。
| | |
| | |
| | |
| | |
| | |
| | |
| | |
| | |
| | |
7 月以来发生了什么变化
如果你看过更早的对比,有三项事实已经变了。
Kimi K3 丢掉了前端榜首。发布时 K3 在 Frontend Code Arena 排名第一。9 月 GPT-6 Astra 拿下第一,K3 现在排在第七——它仍然是该榜单上最强的开源权重模型,也是 Agent Arena 上开源权重中的第一。
Opus 5.5 成了编程的默认选择。在 Terminal-Bench 4.0(如今前沿模型真正拉开差距的榜单)上,厂商报告的数字是:Opus 5.5 66.4%、Astra 57.9%、Fable 5.1 55.8%。一个 $4/$20 的模型在智能体编程上领先两个 $10/$50 的模型,是本月的头条新闻。
SWE-bench Verified 不再重要。Vals AI 在 9 月把它归档了,不再用它对新模型进行测试。它已经饱和了。
| |
| |
| |
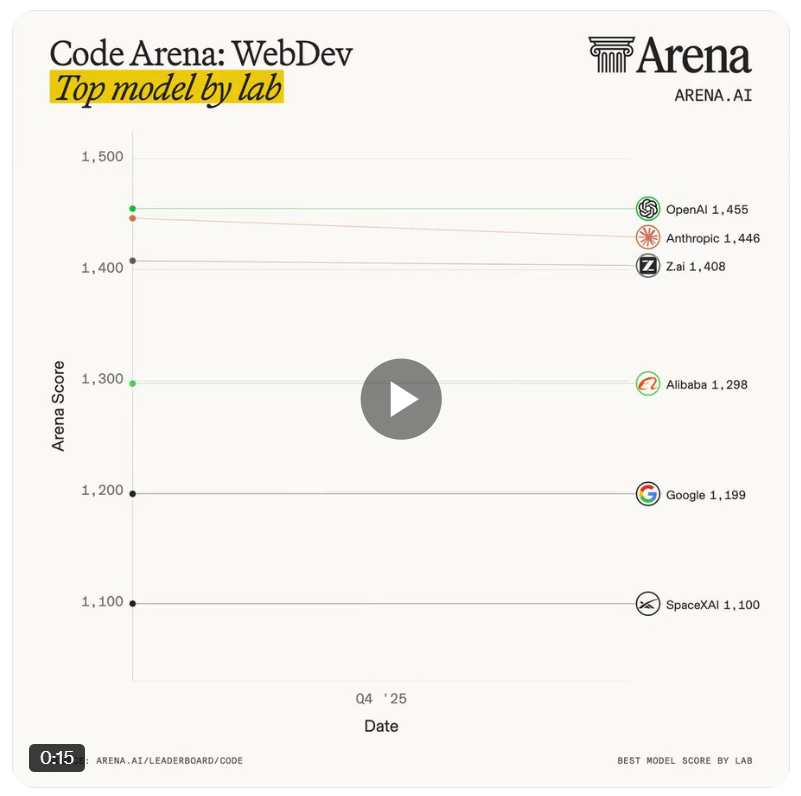
如果有人还用 SWE-bench Verified 来给 10 月的模型排名,那他们用的是一把已经退役的尺子。不过 K3 在它上面的 93.4% 仍然是判断 K3 水平的一个有效参考。
Kimi K3 —— 开放的那个
它是什么:2.8 万亿参数、100 万上下文,7 月 16 日发布,权重随后公开。
《Kimi K3:击败 Fable 5 的开源模型 A–Z 完全指南》——这是关于 Kimi K3 究竟是什么、能做什么,以及它为什么正在悄悄成为「还没人谈论的最重要编程模型」的完整拆解。收藏这一页,以免错过……
它处于什么位置:在 Artificial Analysis 智能指数上得分为 57——当时在 189 个模型中排名第四,是开源权重模型有史以来的最高名次,大致与 Claude Opus 4.8 相当。
在 GPQA Diamond(难度较高的研究生级科学基准)上,它拿到 93.5%,对比 Astra 的 96.0%——后者是 OpenAI 公开发布过的最高分。
所以 K3 在推理能力上距离前沿只有几分之差,价格却只是零头,而且你可以自己运行它。
它赢在哪里:
•
任何涉密内容。自托管后,客户数据永远不会离开你的安全边界。这份名单上没有任何闭源模型能做到这一点,无论出价多少。
•
微调。你可以让它适配自己的领域。Opus 5.5 和 Astra 则做不到。
•
每完成一个任务的成本。独立分析估算约为每个任务 0.94 美元,大约是 Claude Opus 做同样工作成本的一半。
•
长上下文统一定价。K3 无论上下文多长都按同样标准计费,不像某些竞品在超过一定 token 数后采用阶梯定价。
它输在哪里:在综合榜单上它落后于 9 月的旗舰模型,而且它没有计算机操作能力。如果任务需要「上手操作屏幕」,K3 不是合适的工具。
Claude Opus 5.5 —— 新的编程默认选择
它是什么:Anthropic 5.5 系列的第一个模型,9 月 22 日发布。Anthropic 将它在大多数任务上的表现定位为约等于 Fable 5.1,而运行成本比 Opus 5 低 40%。
「隆重推出 Claude Opus 5.5,这是我们全新 Claude 5.5 系列的第一个模型。它在大多数任务上的表现达到 Claude Fable 5.1 的水平,运行成本比 Opus 5 低 40%。」
它赢在哪里:
•
智能体编程。Terminal-Bench 4.0 得分 66.4%,领先两个 $10/$50 的旗舰。9 月底发布的编程对比将之评为目前最好的编程模型。
•
性价比。价格不到 Astra 或 Fable 5.1 的一半,在大多数任务上表现却与它们相当或接近。
•
计算机操作。它能驱动应用程序,K3 做不到。
它输在哪里:闭源权重,无法自托管。而且它不是最便宜的闭源选项——日常工作中 GPT-6 Sol 的价格只有它的一半。
说句实在话:Terminal-Bench 的数字是厂商自己报告的。在独立测试证实之前,66.4 对 57.9 的差距只能作为方向性参考。
GPT-6 Astra —— 昂贵的专家
它是什么:自 9 月 3 日起成为 OpenAI 的旗舰。在计算机操作上处于业界领先水平,也是 OpenAI 首个被认定为达到其「关键网络安全阈值」的模型。
它赢在哪里:
•
前端。Frontend Code Arena 第一名。
•
抽象推理。GPQA Diamond 得分 96.0%;在 ARC Prize 的标准 ARC-AGI-3 测试上得分 62.7%——是 Opus 5 的 30.2% 的两倍多。
•
计算机操作。能操作 Blender、Final Cut、浏览器和各类旧版软件。
它输在哪里:价格。$10/$50 的定价是 Opus 5.5 的 2.5 倍,是 Kimi K3 的 3 倍多。而且具体到智能体编程,更便宜的 Opus 5.5 反而领先。
什么时候值得选它:需要「第一名」的前端工作、全新的推理难题,以及任何需要当下最强计算机操作能力的任务。
Claude Fable 5.1 —— 天花板
它是什么:Anthropic 的 Mythos 级旗舰,$10/$50。
它现在的定位:Opus 5.5 在大多数任务上达到约 Fable 5.1 的水平,挤压了 Fable 的角色。它剩下的用武之地是最难的长周期自主任务——多天连续运行的智能体任务,在那里多出来的能力会在整个会话期间不断累积增值。
对大多数读到这里的读者来说,Opus 5.5 用 40% 的价格就能做到 Fable 5.1 做的事。只有当 Opus 5.5 确实不够用时,才升级到 Fable。
其他选手
GPT-6 Sol($2/$10)——OpenAI 的日常档,与 Opus 5.5 同期发布。对不需要顶级模型的常规工作,价格只有 Opus 5.5 的一半。
Grok 4.7($2/$6)——这里按输出价格算最便宜的、具备推理能力的闭源模型,也是原生接入 X 实时数据的那个。当实时社交语境重要时选它。
Gemini 3.8 Flash($0.75/$3.75)——谷歌最新模型,9 月 2 日发布。快、便宜、多模态。注意谷歌目前仍没有比 Gemini 3.1 Pro Preview 更新的 Pro 模型,所以当前没有谷歌旗舰可以和第一梯队对位。
DeepSeek V4.1 Flash($0.30/$1.20)——价格地板上的开源权重模型。适合成本压倒一切的海量任务。
GPT-6 Luna($0.10/$0.50)——几乎免费。适合超大规模的分类、抽取和简单转换。
实际要花多少钱
以一个混合月度工作负载为例:1 亿输入 token、4000 万输出 token。
| |
| |
| |
| |
| |
| |
| |
| |
| |
在相信这张表之前先提醒一句:token 单价不等于任务单价。推理时间更长的模型,完成同样的任务会消耗更多输出 token。
这就是为什么 K3 每完成一个任务的成本大约只有 Claude Opus 的一半——不只是因为它的 token 单价低,还因为它在完成任务过程中消耗的 token 数量。请在你自己的工作负载上实测。
分流选择表
规律是:只有在前沿能力能改变结果的地方,才为前沿价格买单。其他地方,总有一个价格只有零头的模型能把活儿干好。
| |
| |
| |
| |
| |
| |
| |
| |
自己动手测一测 —— 3 条提示词
厂商基准是厂商自己跑的。下面这些测试能让你在自己的工作上看到差异。
1 —— 编程正面对决(Opus 5.5 对 K3 对 Astra)
代码块
Plain Text
这是我代码库里的一个真实任务:
[粘贴一个真实的 bug 或功能需求,附上相关文件]
修复它。然后:
- 运行测试并报告结果
- 列出你改了什么、为什么改
- 说一件如果有更多时间你会做得不一样的事
衡量标准:是否通过、消耗了多少 token、尝试了几次。用成功完成的次数除以总成本。
2 —— 开源权重之问
代码块
Plain Text
[你最敏感、最常重复的任务——客户数据、
内部文档、任何有隐私要求的内容]
这不是能力测试,而是政策测试。如果这些数据不能离开你的安全边界,那么只有 K3 和 DeepSeek 有资格入选。比较还没开始就已经结束了。
3 —— 例行工作检验
代码块
Plain Text
[一项你每周要跑 50 次的任务——总结、
分类、起草标准回复]
分别在 Opus 5.5 和 GPT-6 Sol 或 Luna 上跑一遍。如果便宜模型的输出无法区分,那说明你在用量最大的那条线上一直在多付钱。
常见错误
条件反射地选了旗舰。这是这份名单上最贵的错误。Astra 和 Fable 5.1 的价格是 Opus 5.5 的 2.5 倍。除非任务正好是它们的强项,否则你就是在为用不上的余量付费。
只相信单一基准。Terminal-Bench 4.0、Frontend Code Arena、GPQA 和 ARC-AGI-3 对模型的排名各不相同。没有模型能赢下所有榜单。选一个最接近你工作的基准。
比的是 token 单价而不是任务成本。一个推理时间两倍长的便宜模型并不便宜。要衡量每个完成任务的成本。
引用 SWE-bench Verified。它已经退役了。改用 Terminal-Bench 4.0 或你自己的测试。
需要「上手操作」却选了 Kimi K3。它没有计算机操作能力。任何要在屏幕上操作的任务,选 Astra 或 Opus 5.5。
客户不允许云端处理。那这张表大部分都不适用。自托管的 K3 或 DeepSeek,就这么简单。
结论
三个月前,问题是开源模型能否接近前沿。Kimi K3 给出了回答:Artificial Analysis 指数第四、GPQA 93.5%、推理能力与最强模型只差几分,而且权重可以下载。
9 月回答了另一个问题。前沿再次移动:Astra 和 Fable 5.1 来到 $10/$50,随后 Opus 5.5 以不到一半的价格登场,并在智能体编程上同时领先两者。
所以 10 月的模型地图是这样的:Opus 5.5 是编程的默认选择;Astra 是前端和计算机操作的专家。
当数据不能离开、或者模型必须归你所有时,就选 Kimi K3。一切例行工作交给 Sol、Luna 或 Flash。
最强大的模型很少是正确的模型。正确的模型,是能达标完成任务的最便宜的那个。
按任务分流。只有在前沿价格能改变结果的地方才为它买单。
教育性内容。除特别注明外,基准数据均为厂商报告,且变化频繁。价格为 2026 年 10 月的公开 API 费率,部分属于首发优惠价。第三方托管方可能采用不同定价。在投入生产架构前,请先在自己的工作负载上实测。