什么是 Guardrails?如何为 Agent 设置安全护栏?
难度:基础 分类:Safety & Alignment
简短回答
Guardrails(安全护栏)是放置在 LLM/Agent 输入和输出之间的规则和过滤器,用于确保 AI 系统的安全性、合规性和可靠性。它们就像 Agent 和外部世界之间的"安检门"——在请求到达 LLM 之前检查输入是否安全(输入护栏),在 LLM 生成回答后检查输出是否合规(输出护栏)。护栏可以防御六大类威胁:Prompt Injection(恶意注入)、数据泄露(PII 暴露)、Jailbreak(绕过安全限制)、偏见和毒性(有害内容)、幻觉(虚假信息)、隐私违规。实现方式分为两种:规则型(正则、关键词匹配——快速低成本)和模型型(用 LLM/分类器语义理解——更智能但更慢更贵)。主流工具:Guardrails AI(开源验证框架)、NVIDIA NeMo Guardrails(状态机+可编程 rails)、LangChain Middleware(中间件模式)。最佳实践是组合使用规则型和模型型护栏,形成多层防御。
详细解析
护栏的工作位置
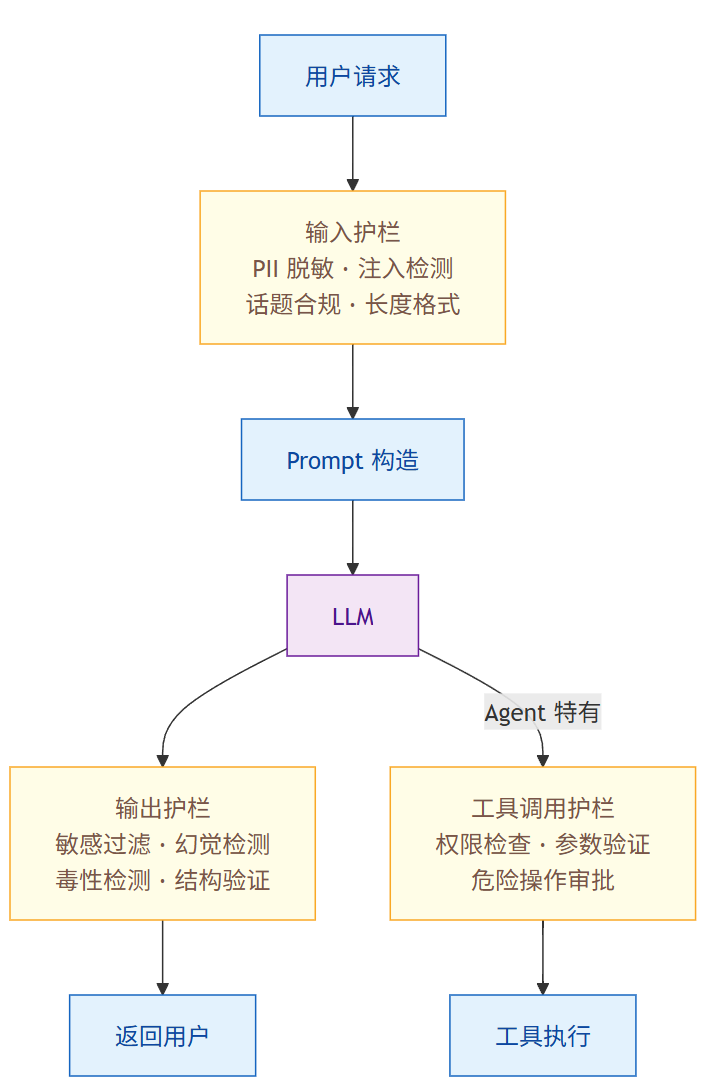
护栏设三道卡:进 LLM 前、出 LLM 后、工具执行前——Agent 比聊天机器人多一道工具调用护栏。
两种实现方式
代码块
Python
# 方式 1:规则型护栏(Rule-based)
class RuleBasedGuardrail:
"""基于规则的护栏——快速、可预测、低成本"""
def __init__(self):
self.pii_patterns = {
"email": r'\b[\w.-]+@[\w.-]+\.\w+\b',
"phone": r'\b\d{3}[-.]?\d{4}[-.]?\d{4}\b',
"id_card": r'\b\d{17}[\dXx]\b',
}
self.blocked_keywords = ["密码是", "信用卡号", "DROP TABLE"]
self.topic_whitelist = ["技术咨询", "产品使用", "账户管理"]
def check_input(self, text):
"""输入检查"""
# PII 检测
for pii_type, pattern in self.pii_patterns.items():
if re.search(pattern, text):
return {"blocked": True, "reason": f"包含 {pii_type}"}
# 关键词过滤
for keyword in self.blocked_keywords:
if keyword in text:
return {"blocked": True, "reason": f"包含敏感关键词"}
return {"blocked": False}
def check_output(self, text):
"""输出检查"""
# 检查输出中是否泄露 PII
for pii_type, pattern in self.pii_patterns.items():
text = re.sub(pattern, f"[{pii_type}_REDACTED]", text)
return text
# 方式 2:模型型护栏(Model-based)
class ModelBasedGuardrail:
"""基于模型的护栏——语义理解更强,但更慢更贵"""
async def check_input(self, text):
"""用 LLM 判断输入是否安全"""
result = await self.classifier.classify(
text=text,
categories=[
"prompt_injection",
"jailbreak_attempt",
"off_topic",
"toxic_content",
],
)
return {
"blocked": any(r.score > 0.8 for r in result),
"details": result,
}
async def check_output(self, question, answer):
"""用 LLM 检查输出质量"""
prompt = f"""
检查以下回答是否存在问题:
问题:{question}
回答:{answer}
检查项:
1. 是否包含虚假信息(幻觉)
2. 是否包含有害或偏见内容
3. 是否泄露了不应公开的信息
4. 是否偏离了问题主题
输出 JSON:{{"safe": true/false, "issues": [...]}}
"""
return await self.judge.invoke(prompt)
主流工具对比
代码块
Python
# 1. Guardrails AI(开源验证框架)
guardrails_ai = {
"核心能力": "Input/Output Guards,检测和量化特定风险",
"特色": [
"Guardrails Hub:预构建的验证器市场",
"Guardrails Index:首个护栏性能基准(24 个护栏 × 6 类风险)",
"支持自定义验证器",
],
"使用示例": """
from guardrails import Guard
Agent 专用护栏
代码块
Python
class AgentGuardrails:
"""Agent 特有的护栏——超越简单的输入输出过滤"""
def tool_call_guard(self, tool_name, params, context):
"""工具调用护栏"""
# 1. 权限检查:Agent 是否有权调用此工具
if tool_name not in context.allowed_tools:
return {"blocked": True, "reason": "未授权的工具"}
# 2. 参数验证:参数是否合法且安全
护栏设计最佳实践
表格加载中...
毒性检测与内容过滤
前面的护栏是通用安全机制,而毒性检测(Toxicity Detection)与内容过滤(Content Filtering)是其中最专门的子领域——针对暴力、仇恨、色情、自伤等有害内容做实时拦截。它有两个关键技术点值得单独讲:用什么模型(开源安全模型横评)和怎么编排(多层级联架构)。
开源安全模型横评
过去做毒性检测多依赖商业 API(如 Perspective API),2025 年起开源安全模型已达到商用水准,可本地部署、自定义策略、不外泄数据:
表格加载中...
选型建议:需要多类别精细分类且可微调,选 Llama Guard 3;要兼顾幻觉检测,选 Granite Guardian;只做基础脏话/仇恨过滤且对延迟敏感,选 Granite HAP 这类轻量分类器。
多层级联架构
单靠一个模型很难同时做到"快、准、便宜",生产系统的最佳实践是级联(Cascading)——按成本由低到高分层,前一层挡住的就不进下一层:
代码块
Python
class CascadingContentFilter:
"""多层级联过滤——平衡速度、准确性和成本"""
async def filter(self, text, context=None):
这与前文"规则型做第一道门、模型型做第二道门"是同一思路的深化——把模型型再细分成轻量分类器 → 安全大模型 → 通用 LLM 三档,按需逐级升级。其中第 4 层的 LLM 上下文审核本质是 LLM-as-Judge 在安全场景的应用,能理解"医疗讨论中的'注射'不是暴力"这类上下文,但成本最高,只在高风险场景启用。
反直觉实证:38M 小分类器的召回率优于通用 LLM
一个常被引用的发现:在边界清晰的毒性分类任务上,传统轻量 NN 分类器(Granite HAP,仅 38M 参数)的召回率显著优于 8B 参数 LLM 的 in-context learning——0.96 vs 0.78,且计算成本低一个数量级。
由此得出一条选型原则:分类任务别盲目上大模型。对于类别固定的检测(脏话、仇恨言论、PII),专用小模型更快、更准、更便宜;LLM 的优势在于需要上下文理解的灰区判断(隐喻、双关、跨文化差异),这正是级联架构把 LLM 放在最后一层的原因。
常见误区 / 面试追问
误区:"护栏会让 Agent 变得很慢" — 规则型护栏(正则、关键词)延迟通常 < 5ms,几乎无感。模型型护栏延迟较高(100-500ms),但可以异步执行(先返回结果,后台评估并在发现问题时追回)。关键是选择合适的护栏组合。
误区:"护栏只需要加在输入端" — 输入护栏防不住间接注入(恶意指令隐藏在检索内容中)和模型自身的幻觉。必须同时有输出护栏。对于 Agent,还需要工具调用护栏和轨迹护栏。
追问:"如何评估护栏的有效性?" — (1) 用 Guardrails AI Index 基准测试性能;(2) 计算两个关键指标:拦截率(真正拦截了多少攻击)和误报率(错误拦截了多少正常请求);(3) 定期进行 Red Team 测试验证护栏的鲁棒性。
追问:"规则型和模型型如何搭配?" — 推荐的组合模式:规则型做"第一道门"(快速拦截明确的违规:PII、SQL 注入、关键词黑名单),模型型做"第二道门"(处理需要语义理解的问题:Prompt Injection 变体、隐含毒性、话题偏离)。两层串联,规则型过滤掉 80% 的问题,模型型处理剩余 20% 的边界情况。