基于Agent的智能自动驾驶系统
智能自动驾驶
基于AI技术的智能自动驾驶系统实现,按照主流车企智能自动驾驶项目做1v1脱敏实现。
端到端自动驾驶工作原理
48%
52%
💾
Input:
输入是一幅或多幅图像,可能经过预处理以适应模型的需求,例如归一化、缩放等。
Backbone:
特征提取网络的核心部分,负责从输入图像中提取高层次的特征。它通常基于经典的卷积神经网络(CNN)结构,比如AlexNet、VGGNet、ResNet,这些网络通过一系列卷积层和池化层逐层抽象并压缩信息。
Neck:
在主干网络之后,这部分网络对不同层级的特征进行整合与优化,有时称为“中间层”或“特征融合层”。
Detection Head:
此部分用于预测最终的物体位置和类别。在特征提取(骨干)之后,提供输入的特征图表示。
Output:
输出通常是物体检测的结果,包括每个对象的类别标签、置信度分数以及精确的边界框坐标。
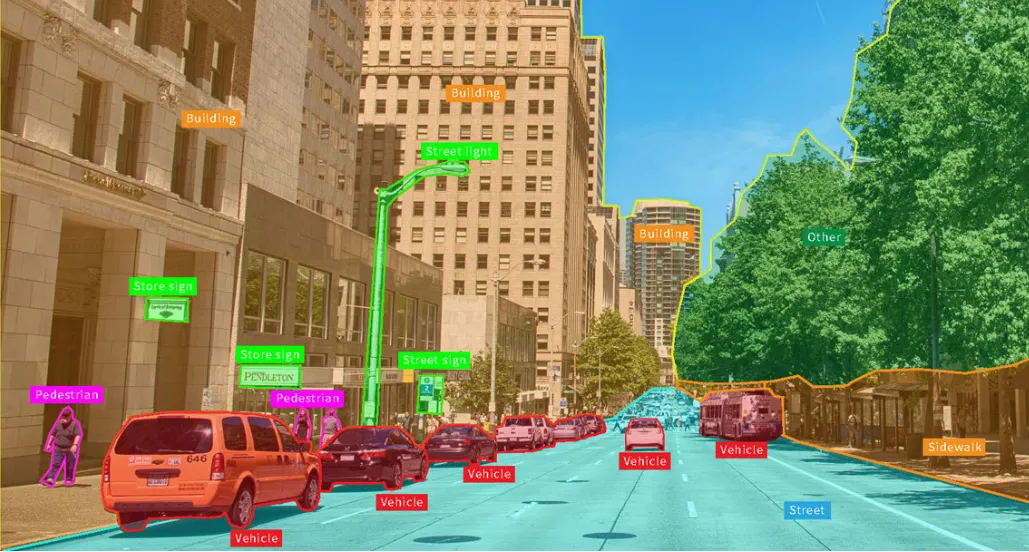
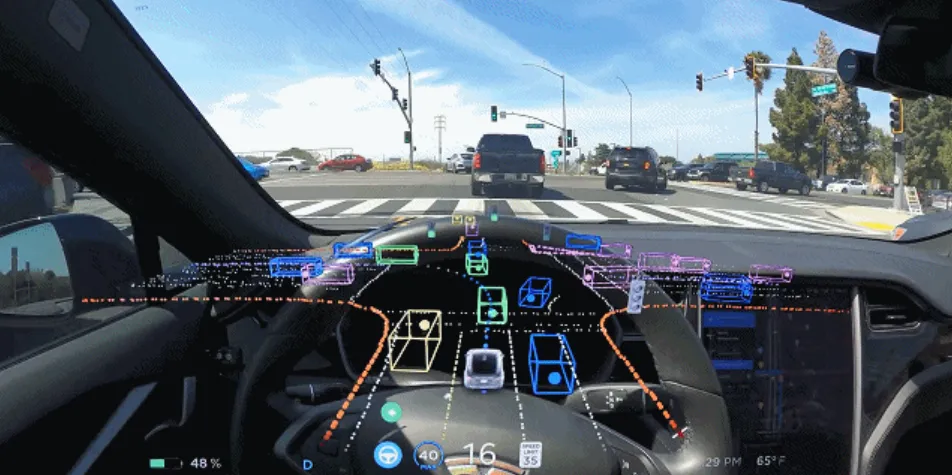
HydraNet自动驾驶网络,用于视觉感知任务,这是一种多任务学习神经网络架构,通过一个统一的神经网络模型来并行处理多种不同的感知任务。在自动驾驶场景下,车辆需要同时完成多个复杂环境下的理解任务,涵盖目标检测(如识别其他车辆、行人、交通标志等)、车道线检测、可行驶区域分割以及深度估计等。
💾
•
在HydraNet中,为了同时完成多种感知任务,例如车道线检测、车辆和行人检测与追踪、交通信号灯识别等,设计了多个并行的“任务头”(task-specific heads)。
•
每个任务头都连接到共享的基础特征提取层(backbone),从而可以从同一份输入数据中抽取不同层次的语义信息,并分别对特定任务进行处理。其构建了这样一个流程:
📌
1.2、路径规划层
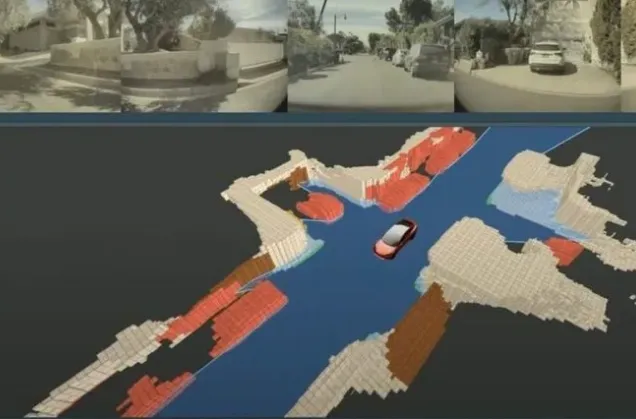
Occupancy Network通过处理摄像头捕捉到的多视图图像数据,来预测三维空间中每个点被物体占据的概率。这一网络模型旨在实现对车辆周围环境的精确建模,从而帮助车辆在没有使用超声波传感器或雷达的情况下(纯视觉方案),也能有效地理解道路场景和进行路径规划。
📌
在特斯拉端到端的自动驾驶系统规划模块中,引入占据网络(Occupancy Network)。
系统的感知和规划决策过程可以概述如下:
感知阶段:
💾
•
第 1 步:视觉测量—某斯拉车辆利用其8个摄像头收集环境数据。
包括车道线、静态和动态物体的位置以及空间中的占用率信息。占用网络负责处理这些图像数据,以生成三维空间的占用概率图,即预测环境中哪些区域可能被其他车辆、行人或其他障碍物占据。
轨迹生成与评估阶段:
💾
•
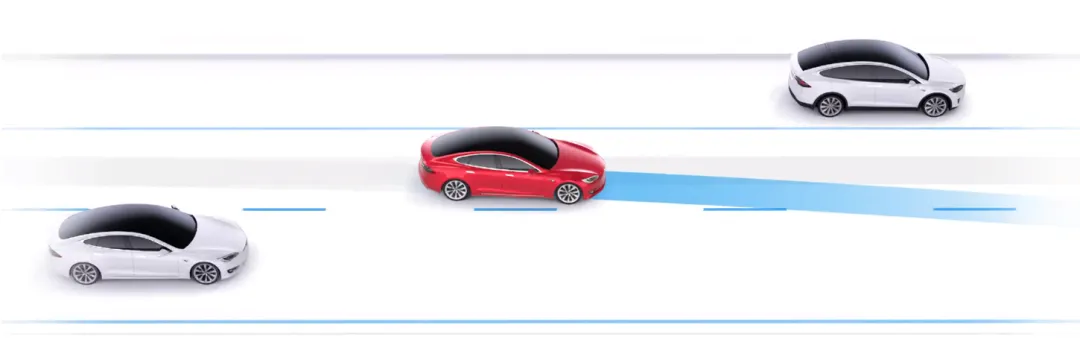
第 2-3 步:候选目标和轨迹生成—根据占用率网络和其他感知模块(如车道检测)的输出,规划器会生成一系列潜在驾驶轨迹,每个轨迹对应一个不同的行驶决策或目标。
•
第 4-5 步:选择评估—对于每一个生成的轨迹,规划器会进行规则驱动的选择评估,例如考虑“行人让行”与“获取行驶权”的情况,以及“右侧来车让行”等交通规则。每条轨迹都会根据一套人工设计的成本函数进行打分,该函数综合考虑碰撞概率、舒适度(比如加速度变化)、是否需要人为干预的可能性以及行为模式与人类驾驶员的相似程度等因素。
决策阶段:
成本优化—在生成的多条轨迹中,规划器会选择成本最低的那一条作为最优解决方案,以决定车辆接下来的行驶动作,输出规划行驶轨迹。
端到端自动驾驶的优点
💾
(1)更高的技术潜力:端到端结构允许模型从原始输入直接推导出最终控制输出,能够通过联合优化各个部分来提升整体性能,从而可能达到比模块化系统更高的技术上限。
端到端自动驾驶的缺点
💾
(1)可解释性较差:端到端模型的内部机制往往过于复杂,难以直观理解和解释其决策过程,这给调试、改进和法规合规带来了一定挑战。
(2)对海量高质量数据的高度依赖:端到端自动驾驶需要极其庞大的高质量数据支持,包括多样化的道路场景、天气条件以及交通行为样本。获取、标注和清洗这些数据需要巨大的资源投入,同时训练这样的大型神经网络也需要高性能计算设备和大量的算力支持。
小米智能驾驶工作原理
一、变焦bev
三个应用场景:
泊车
33%
城区
33%
高速
33%
二、超分辨率占用网络技术
SIREN
💾
正弦表示网络(sinusoidal representation network:SIREN),用周期性的激活函数来作为隐式神经表达,用他来解决特定的Eikonal方程的边值问题,简单来说就是用来在点云上拟合隐式神经表达参数化的符号距离函数就可以产生下面的效果
LODE
Locally Conditioned Eikonal Implicit Scene Completion from Sparse LiDAR
💾
SIREN提出一种从点云到3D mesh补全方法,LODE提出了利用GT来监督SDF。
xiaomi ev
引入了一种基于查询的方法,并利用Eikonal公式约束的SDF来准确描述障碍物的表面。
📌
此外,考虑到缺乏精确的SDF基本事实,提出了一种新的SDF弱监督范式,称为Sandwich-Eikonal公式,它强调在表面两侧应用正确和密集的约束,从而提高表面的感知精度。
实验表明,该方法在nu-Scenes数据集上实现了占用预测和3D场景重建任务的SOTA。
💾
•
a.在提供SDF GT的情况下,对SDF进行理想的监督。
•
b.SIREN监督,使用LIDAR点对表面进行监督。
•
c.基于占用GT的LODE监管。
•
d.我们的监管范式结合了LiDAR GT和占用GT,更接近理想的监管
三、雪天自动降噪
💾
对输入的数据先过降噪算法再进网络。这类的算法就太多太多了,大家应该随处都可以找到。例如去arxiv网站上搜索rainy 或者snowy可以看到非常多的相关算法。
降噪可以单做,也可以嵌入网络,至于小米的智驾是如何做到的。难点在于降噪部分与后续环节的连接与耗时。
道路大模型
prologue
HDMapNet
💾
paper,算是早期做hdmap的网络。思路也比较简单,和bevfusion(mit版本)的工作挺像,分图像和雷达两支,分别提取特征到bev空间,过bev decoder后做了语义分割,朝向预测和实例编码(instance embedding),最后形成矢量高清地图还是靠后处理来完成。
📌
dbscan + nms,其实就是用实例化聚类 + 属性分配(朝向 + 分类)来构造矢量化表达。
STSU
VectorMapNet
💾
如图所示上面有三块,bev feature这部分就不说了,主要是地图元素检测和Polyline 生成。地图元素检测也是detr的路子,一个query查一个关键点,多个关键点来表示一个地图元素。Polyline 生成也是使用了transformer来做,对输入的element keypoints用自回归来做细化,出polyline。
MapTR
50%
MapTR V2
50%
51%
49%
💾
maptr v2 对maptr 的改进版本,但主要关注于降低计算量,原理思路并没有进行修改
Online Vectorized HD Map Construction using Geometry
Leveraging Enhanced Queries of Point Sets for Vectorized Map Construction
五、端到端感知决策大模型
cvpr的端到端:Planning-oriented Autonomous Driving
50%
50%
统一自动驾驶(Uni AD):
💾
•
它是按照以规划为导向的理念精心设计的。与简单的任务堆栈不同,我们研究了每个模块在感知和预测方面的效果,利用从前面节点到最终驾驶场景规划的联合优化的好处。所有感知和预测模块都采用变压器解码器结构设计,任务查询作为连接各个节点的接口。最后利用一个简单的基于注意力的规划器,结合所提取的知识来预测自驾车未来的路径点
•
大家看pipline也能看出来这个端到端其实是有很多组件构成,每个环节都通过任务查询来连接,前面的流程都是为了最后的规划而服务
50%
50%
💾
•
Graph AD的特点是驾驶环境中结构化实例之间基于图的交互,包括动态交通代理和静态地图元素。
💾
•
Graph AD首先在鸟瞰图上构建时空场景特征,作为下游任务的统一表示。
💾
•
Graph AD然后,通过Track Former和Map Former提取结构化实例。以这些实例为图节点,graph AD提出了交互场景图,通过考虑代理间和代理映射的交互,迭代细化动态节点的特征。最后,将处理后的节点特征用于运动预测和端到端规划。
💾
•
Graph AD 的github可以看到Our code is based on UniAD and DGCNN,还是借鉴了UniAD的工作,用图的形式来做交互上的优化无疑是更好的。但代码目前还没有开源,大家可以mark一下。