循环神经网络
写在前面
循环神经网络(RNNs)是神经网络中一个大家族,主要用于文本、信号等序列相关的数据。
常见的循环神经网络有长短期记忆网络(LSTM)、门控循环单元网络(GRU)等。而这些循环神经网络都是在最早的一种神经网络基础之上改进而来的。
本文讲解的是循环神经网络家族中最早的一种神经网络——循环神经网络(RNN)
并在RNN的基础上介绍双向循环网络(Bidirectional RNN,BRNN)与深层循环网络(Deep RNN,DRNN)。
一、循环神经网络概念拆解
循环神经网络(Recurrent Neural Network, RNN)是一类具有内部环状连接的人工神经网络,用于处理序列数据。
其最大特点是网络中存在着环,使得信息能在网络中进行循环,实现对序列信息的存储和处理。
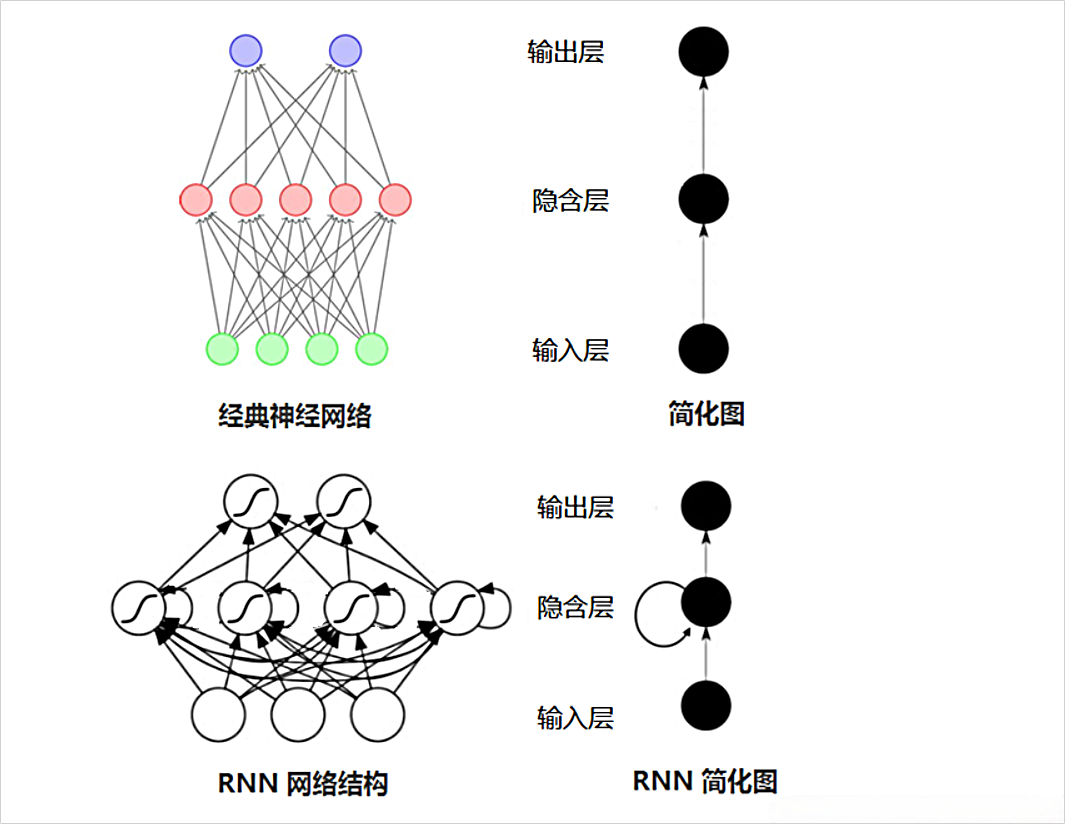
经典神经网络与循环神经网络对比
(一)工作框架
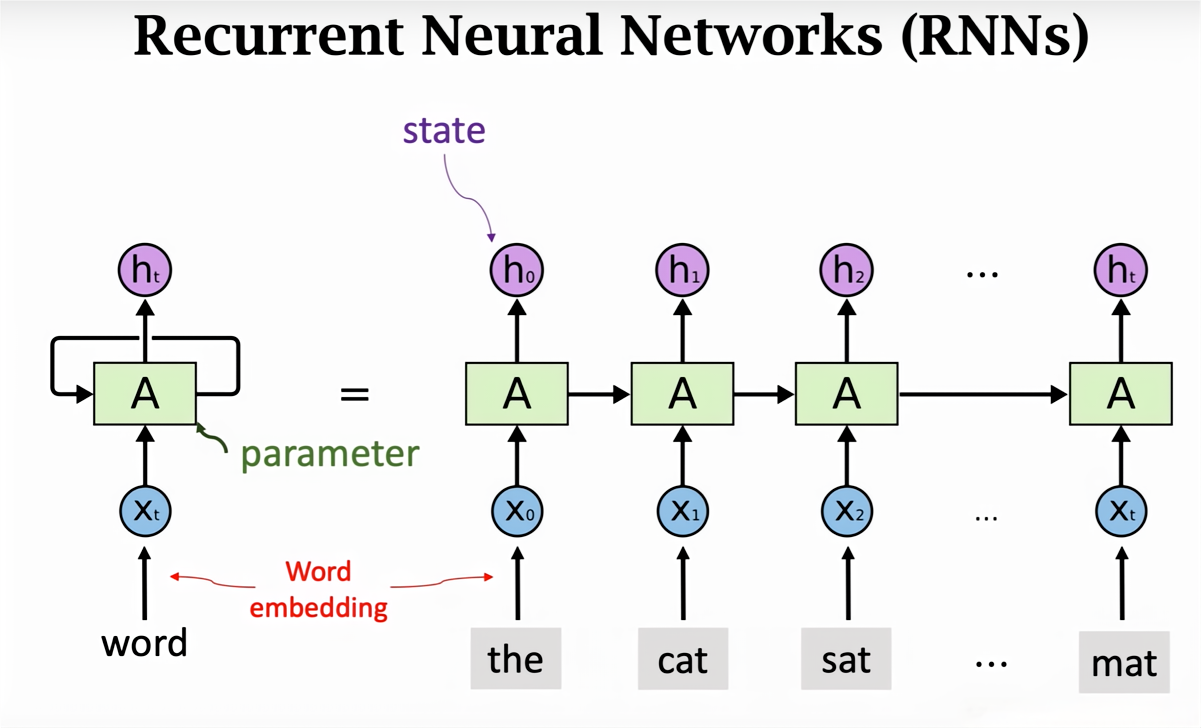
•
输入层:RNN能够接受一个输入序列(例如文字、股票价格、语音信号等)并将其传递到隐藏层。
•
隐藏层:隐藏层之间存在循环连接,使得网络能够维护一个“记忆”状态,包含过去信息。
•
输出层:RNN可以有一个或多个输出,例如在序列生成任务中,每个时间步都会有一个输出。
(二)数学模型
◽
对应数学模型可以通过以下数学方程表示:
•
输入到隐藏层的转换:
•
隐藏层到输出层的转换:
() 表示在时间 () 的隐藏层状态,() 表示在时间 () 的输入,() 表示在时间 () 的输出。
(三)RNN的优缺点
◽
优点:
能够处理不同长度的序列数据。
能够捕捉序列中的时间依赖关系。
◽
缺点:
对长序列的记忆能力较弱,可能出现梯度消失或梯度爆炸问题。
训练可能相对复杂和时间消耗大。
二、循环神经网络结构全解
(一)循环神经网络整体结构
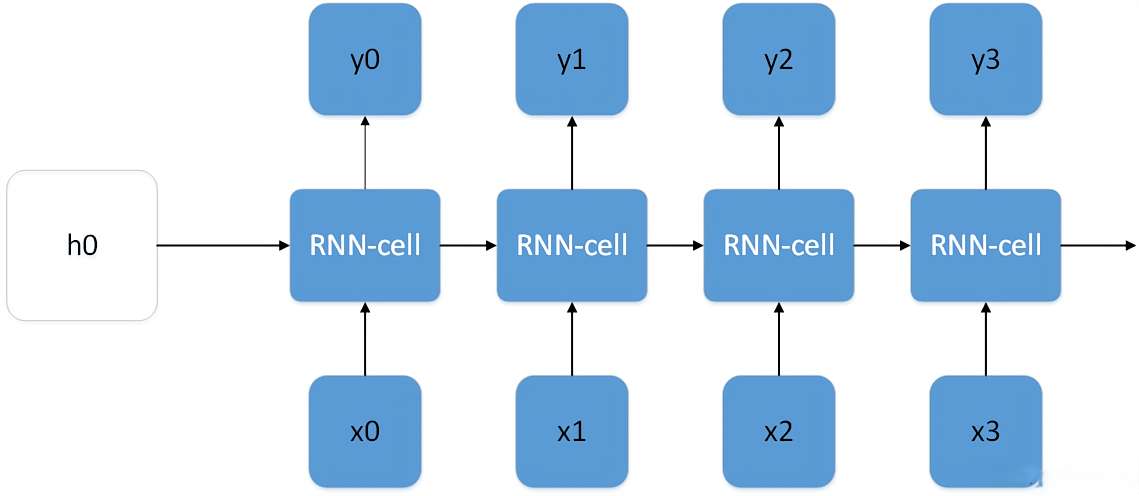
时序数据示意1
50%
对于时序数据,图中表示时刻的输入,表示时刻的输入。
以此类推,表示时刻输入。
所以RNN-cell的个数是不固定的。
根据实际需要来设定,并且输入的个数和输出的个数也并非固定。
50%
例如,根据前4天的平均来预测第5天的温度,那么RNN可以设计如下:
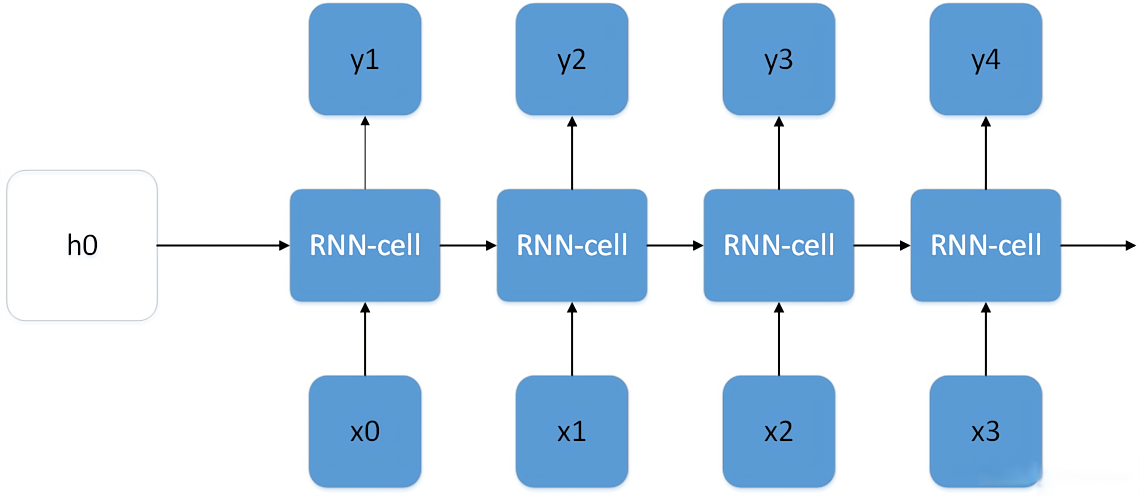
时序数据示意2
50%
图中表示的模型可以理解为:
每次输入14天的平均温度,输出为25的平均温度。
50%
当然,对于这个问题,也可以设计成多对一的形式的,如下图所示,此时就是用前3天的数据来预测第4天的数据。
时序数据示意3
47%
时序数据示意4
53%
对于语言翻译,输入和输出句子含有的单词都是多个,所以对于这类问题可以设计成多对多形式。
时序数据示意5
50%
对于图片描述、音乐生成等问题,
通常根据一个输入,来产生多个输出,
对于这类问题可以设计成一对多的形式,
如图所示。
50%
前面介绍了RNN具有时间"记忆"的功能, 那么它是怎么实现所谓的"记忆"的?
◽
如图, 可以看到RNN层级结构较CNN相对简单, 它主要有输入层,Hidden Layer, 输出层组成。
并且会发现在Hidden Layer 有一个箭头表示数据的循环更新, 这个就是实现时间记忆功能的方法。
RNN层级结构
44%
hidden layer层级展开示意
56%
◽
如图为Hidden Layer的层级展开图。t-1,t, t+1表示时间序列。 X表示输入的样本. 表示样本在时间t处的的记忆,。 W表示输入的权重, U表示此刻输入的样本的权重, V表示输出的样本权重。
在t =1时刻, 一般初始化输入, 随机初始化W,U,V, 进行下面的公式计算:
◽
其中,f和g均为激活函数. 其中f可以是tanh,relu,sigmoid等激活函数,g通常是softmax也可以是其他。
时间就向前推进,此时的状态
s1
作为时刻1的记忆状态将参与下一个时刻的预测活动,也就是:
h2=Ux2+Ws1s2=f(h2)o2=g(Vs2)
以此类推, 可以得到最终的输出值为:
ht=Uxt+Wst−1st=f(ht)ot=g(Vst)
◽
注意:
(二)循环神经网络具体结构
RNN-cell结构
这里先介绍第1个RNN cell。
RNN-cell结构
上图中绿色的为激活函数,在RNN中这两个位置通常用tanh和softmax激活函数,当然用其它是激活函数理论上也是可以的;
◽
x0
为
t0
时刻输入,
dim=(p×1)
;
ht
表示隐藏层状态,维度
dim=(p×1)
,初始时刻的
h0
有一般设为全0向量,
dim=(q×1)
;紫色的U、V、W是模型需要学习的参数,U的维度
dim=(q×p)
,W的维度为
dim=(q×q)
,V的维度为(q×q);输出
yt
的维度为
dim=(q×1)
。在大多数情况,由于输入输出数据类型相同,p和q相等。
所以,对于上图,在黄色的加号部分,运算为:
◽
和为两部分偏置,有的时候也可以不需要。对于下面或左边部分,矩阵与输入向量相乘再加上偏置b,实际上就相当于一个全连接层。
通过第一个激活函数,得到的
h1
为:
h1=Tanh(U.x0+bu+W.h0+bw)
◽
h1
为得到的隐藏状态,它可以继续像
h0
输入到第一个RNN cell那样输入到第二个RNN cell。如果第一个RNN需要输出,那么
h1
还要与V相乘并经过Softmax激活函数得到output。
y0=Softmax(V.h1)
为了降低模型的复杂度,对于整个RNN,所有的RNN都共用相同的参数U、V、W。
对于之后的RNN cell,与之完全相同,
h0
、
x0
、
y0
换成对应的
ht
、
xt
、
yt
即可。
RNN-cell结构示意
(三)深度循环神经网络
前面的RNN,隐藏层是从左向右单向传递。而对于双向RNN,其隐藏层既有从左向右的传递,也有从右向左的传递,并且这两个方向的传递完全独立,所以模型参数为正向的W、U、V、、与反向的W'、U'、V'、、,参数数量为单向RNN的二倍。双向RNN每个RNN cell会有两个输出,所以最终输出结果为这两个输出的拼接。如一个输出,最终得到输出为()。
深度RNN
◽
对于深层RNN,则是在RNN的基础上增加多层RNN,每一层的RNN的输出作为下一层RNN的输入。
下图即为一个层数为3的深层循环神经网络。
层数为3的深度循环神经网络
当然,深层神将网络中每一层也可以是一个BRNN,此时是深层双向RNN。
三、循环神经网络工作机制拆解
循环神经网络(RNN)的工作原理是通过网络中的环状连接捕获序列中的时间依赖关系。
下面将详细解释其工作机制。
(一)RNN的时间展开
RNN的一个重要特点是可以通过时间展开来理解。
◽
这意味着,虽然网络结构在每个时间步看起来相同,但我们可以将其展开为一系列的网络层,每一层对应于序列中的一个特定时间步。
(二)信息流动
循环神经网络结构
输入到隐藏:每个时间步,RNN从输入层接收一个新的输入,与隐藏状态结合,生成新隐藏状态。
隐藏到隐藏:隐藏层间循环连接使得信息可以在时间步之间传播,从而捕捉序列依赖关系。
隐藏到输出:每个时间步的隐藏状态都会传递到输出层,以生成对应的输出。
(三)实现示例
代码块
Python
# RNN的PyTorch实现
import torch.nn as nn
class SimpleRNN(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(SimpleRNN, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
梯度问题:梯度消失和爆炸
◽
由于RNN的循环结构,在训练中可能会出现梯度消失或梯度爆炸的问题。
长序列可能导致训练过程中梯度变得非常小(消失)或非常大(爆炸),从而影响模型学习效率。
四、循环神经网络反向传播
前面介绍了RNN的前向传播的方式, 那么RNN的权重参数W,U,V都是怎么更新的?
每一次的输出值都会产生一个误差值, 则总的误差可以表示为:
则损失函数可以使用交叉熵损失函数也可以使用平方误差损失函数。
◽
由于每一步的输出不仅仅依赖当前步的网络,并且还需要前若干步网络的状态,那么这种BP改版的算法叫做Backpropagation Through Time(BPTT) , 也就是将输出端的误差值反向传递,运用梯度下降法进行更新。
也就是要求参数的梯度:
50%
50%
首先我们求解W的更新方法, 由前面的W的更新可以看出它是每个时刻的偏差的偏导数之和。
◽
在这里我们以 t = 3 时刻为例, 根据链式求导法则可以得到 t = 3 时刻的偏导数为:
◽
此时, 根据公式我们会发现, 除了和W有关之外, 还和前一时刻有关。
对于直接展开得到下面的式子:
对于直接展开得到下面的式子:
对于直接展开得到下面的式子:
◽
将上述三个式子合并得到:
这样就得到了公式:
◽
这里要说明的是: 表示的是对W直接求导, 不考虑的影响。
其次是对U的更新方法. 由于参数U求解和W求解类似,这里就不在赘述了,最终得到的具体的公式如下:
最后,给出V的更新公式(V只和输出O有关):
五、循环神经网络改进算法
前面介绍了RNN的算法, 它处理时间序列的问题的效果很好, 但是仍然存在着一些问题, 其中较为严重的是容易出现梯度消失或者梯度爆炸的问题(BP算法和长时间依赖造成的)。
◽
注意: 这里的梯度消失和BP的不一样,这里主要指由于时间过长而造成记忆值较小的现象.
因此, 就出现了一系列的改进的算法, 这里介绍主要的两种算法: LSTM 和GRU。
LSTM 和 GRU对于梯度消失或者梯度爆炸的问题处理方法主要是:
◽
对于梯度消失: 由于它们都有特殊的方式存储"记忆",那么以前梯度比较大的”记忆”不会像简单的RNN一样马上被抹除,因此可以一定程度上克服梯度消失问题。
对于梯度爆炸: 用来克服梯度爆炸的问题就是gradient clipping,也就是当你计算的梯度超过阈值c或者小于阈值-c的时候,便把此时的梯度设置成c或-c。
(一)LSTM算法(Long Short Term Memory, 长短期记忆网络
--- 重要的目前使用最多的时间序列算法
LSTM算法结构图
如图为LSTM算法的结构图。
和RNN不同的是: RNN中
ht=Uxt+Wst−1
◽
就是个简单的线性求和的过程。而LSTM可以通过“门”结构来去除或者增加“细胞状态”的信息,实现了对重要内容的保留和对不重要内容的去除. 通过Sigmoid层输出一个0到1之间的概率值,描述每个部分有多少量可以通过,0表示“不允许任务变量通过”,1表示“运行所有变量通过 ”。
用于遗忘的门叫做"遗忘门", 用于信息增加的叫做"信息增加门", 最后是用于输出的"输出门"。
此外, LSTM算法的还有一些变种。
如图, 它增加“peephole connections”层 , 让门层也接受细胞状态的输入.
LSTM算法变种
50%
LSTM算法的一个变种
50%
如图为LSTM的另外一种变种算法。它是通过耦合忘记门和更新输入门(第一个和第二个门);也就是不再单独的考虑忘记什么、增加什么信息,而是一起进行考虑。
(二)GRU算法
GRU是2014年提出的一种LSTM改进算法. 它将忘记门和输入门合并成为一个单一的更新门, 同时合并了数据单元状态和隐藏状态, 使得模型结构比之于LSTM更为简单。
GRU算法
其各个部分满足关系式如下:
zt=σ(Wz⋅[ht−1,xt])rt=σ(Wr⋅[ht−1,xt])ht=tanh(W⋅[rt∗ht−1,xt])ht=(1−zt)∗ht−1+zt∗ht
六、循环神经网络应用场景
循环神经网络(RNN)因其在捕获序列数据中的时序依赖性方面的优势,在许多应用场景中都得到了广泛的使用。
(一)文本分析与生成
1.自然语言处理
◽
RNN可用于词性标注、命名实体识别、句子解析等任务。通过捕获文本中的上下文关系,RNN能够理解并处理语言的复杂结构。
2.机器翻译
◽
RNN能够理解和生成不同语言的句子结构,使其在机器翻译方面特别有效。
3.文本生成
◽
利用RNN进行文本生成,如生成诗歌、故事等,实现了机器的创造性写作。
(二)语音识别与合成
1.语音到文本
RNN可以用于将语音信号转换为文字,即语音识别(Speech to Text),理解声音中的时序依赖关系。
2.文本到语音
RNN也用于文本到语音(Text to Speech)的转换,生成流畅自然的语音。
(三)时间序列分析
1.股票预测
通过分析历史股票价格和交易量等数据的时间序列,RNN可以用于预测未来的股票走势。
2.气象预报
RNN通过分析气象数据的时间序列,可以预测未来的天气情况。
(四)视频分析与生成
1.动作识别
RNN能够分析视频中的时序信息,用于识别人物动作和行为模式等。
2.视频生成
RNN还可以用于视频内容的生成,如生成具有连续逻辑的动画片段。
(五)总结
◽
六、循环神经网络主要变体
(一)长短时记忆网络(LSTM)
长短时记忆网络
长短时记忆网络
70%
长短时记忆网络(Long Short-Term Memory,LSTM)
是一种特殊的RNN结构,
由Hochreiter和Schmidhuber提出。
LSTM旨在解决传统RNN在训练长序列时遇到的梯度消失问题。
30%
(二)门控循环单元(GRU)
门控循环单元(Gated Recurrent Unit,GRU)是一种特殊的RNN结构,由Cho等人于2014年提出。GRU与LSTM相似,但其结构更简单,计算效率更高。
门控循环单元
(三)双向循环神经网络(Bi-RNN)
双向循环神经网络(Bidirectional Recurrent Neural Network,Bi-RNN)是一种能够捕获序列数据前后依赖关系的RNN架构。通过结合正向和反向的信息流,Bi-RNN可以更全面地理解序列中的模式。
双向循环神经网络