第一章 大语言模型基础
1.1 基于统计方法的语言模型
🧠
语言模型通过对语料库(Corpus)中的语料进行统计或学习来获得预测语言符号概率的能力。通常,基于统计的语言模型通过直接统计语言符号在语料库中出现的频率来预测语言符号的概率。
其中,n-grams 是最具代表性的统计语言模型。n-grams 语言模型基于马尔可夫假设和离散变量的极大似然估计给出语言符号的概率。本节首先给出 n-grams 语言模型的计算方法,然后讨论 n-grams 语言模型如何在马尔可夫假设的基础上应用离散变量极大似然估计给出语言符号出现的概率。
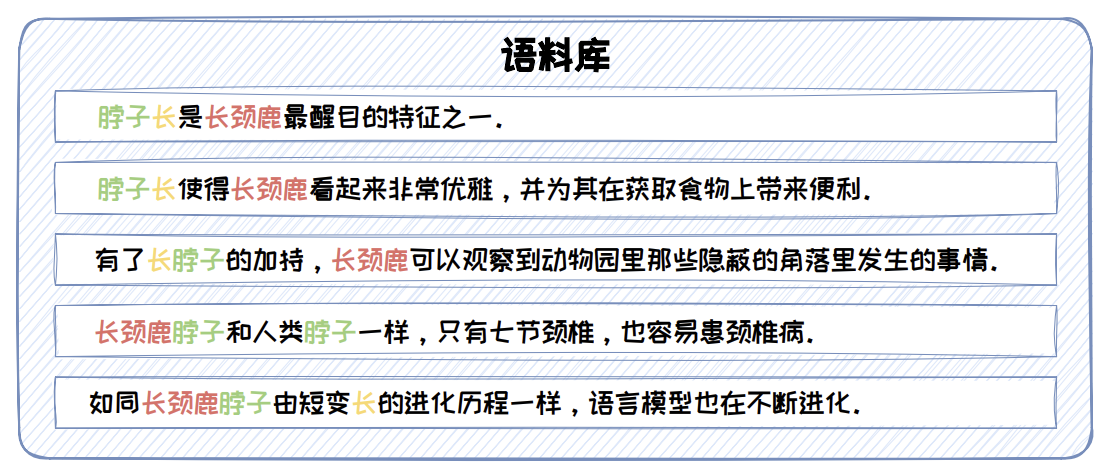
图 1.1: n-grams 示例语料库
1.1.1 n-grams 语言模型
设包含 N 个元素的语言符号可以表示为 。可以代表文本,也可以代表音频序列等载有语义信息的序列。为了便于理解,本章令语言符号 代表文本,其元素 代表词,。在真实语言模型中,可以是 Token 等其他形式。关于 Token 的介绍将在第三章中给出。
n-grams 语言模型中的 n-gram 指的是长度为 n 的词序列。n-grams 语言模型通过依次统计文本中的 n-gram 及其对应的 (n-1)-gram 在语料库中出现的相对频率来计算文本 出现的概率。计算公式如下所示:
下面通过一个 bigrams 语言模型的例子来展示 n-grams 语言模型对文本出现概率进行计算的具体方式。假设语料库中包含 5 个句子,如图 1.1 所示。基于此语料库,应用 bigrams 对文本 “长颈鹿脖子长”(其由 {长颈鹿,脖子,长} 三个词构成)出现的概率进行计算,如下式所示:
在此语料库中,,故有:
在此例中,我们可以发现虽然 “长颈鹿脖子长” 并没有直接出现在语料库中,但是 bigrams 语言模型仍可以预测出 “长颈鹿脖子长” 出现的概率有 。由此可见,n-grams 具备对未知文本的泛化能力。这也是其相较于传统基于规则的方法的优势。但是,这种泛化能力会随着 n 的增大而逐渐减弱。应用 trigrams 对文本 “长颈鹿脖子长” 出现的概率进行计算,将出现以下 “零概率” 的情况:
因此,在 n-grams 语言模型中,n 代表了拟合语料库的能力与对未知文本的泛化能力之间的权衡。当 n 过大时,语料库中难以找到与 n-gram 一模一样的词序列,可能出现大量 “零概率” 现象;在 n 过小时,n-gram 难以承载足够的语言信息,不足以反应语料库的特性。因此,在 n-grams 语言模型中,n 的值是影响性能的关键因素。上述的 “零概率” 现象可以通过平滑(Smoothing)技术进行改善,具体技术可参见文献 [11]。
n-grams 语言模型是在 n 阶马尔可夫假设下,对语料库中出现的长度为 n 的词序列出现概率的极大似然估计。本节首先给出 n 阶马尔可夫假设的定义(见定义 1.1)和离散型随机变量的极大似然估计的定义(见定义 1.2),然后分析 n-grams 如何在马尔可夫假设的基础上应用离散变量极大似然估计给出语言符号出现的概率。
🧠
定义 1.1 (n阶马尔可夫假设) 对序列 ,当前状态 出现的概率只与前 n 个状态 有关,即:
🧠
定义 1.2 (离散型随机变量的极大似然估计) 给定离散型随机变量 X 的分布律为 ,设 为来自 X 的样本,为对应的观察值,为待估计参数。在参数 下,分布函数随机取到 的概率为:
构造似然函数为:
离散型随机变量的极大似然估计旨在找到 使得 取最大值。
在上述两个定义的基础上,对 n-grams 的统计原理进行讨论。设文本 出现的概率为 。根据条件概率的链式法则,可由下式进行计算。
根据 n 阶马尔可夫假设,n-grams 语言模型令 近似 。然后,根据离散型随机变量的极大似然估计,令 近似 。从而,得到 n-grams 语言模型的输出 是对 的近似。即,
下面,以 bigrams 为例,介绍 与极大似然估计间的关系。假设语料库中共涵盖 M 个不同的单词,出现的概率为 ,对应出现的频率为 ,则其出现的似然函数为:
其中,。根据条件概率公式 ,有
其对应的对数似然函数为:
因为 ,所以最大化对数似然函数可建模为如下的约束优化问题:
其拉格朗日对偶为:
L(λ,Llog)=Llog(θ)+i=1∑Mλi(j=1∑MP(wj∣wi)−1)。(1.14)
对其关于 的偏导,可得:
当导数为 0 时,有:
因 ,可取值为 ,即
上述分析表明 bigram 语言模型中的 是对语料库中的长度为 2 的词序列的 的极大似然估计。该结论可扩展到 的其他 n-grams 语言模型中。
n-grams 语言模型通过统计词序列在语料库中出现的频率来预测语言符号的概率。其对未知序列有一定的泛化性,但也容易陷入 “零概率” 的困境。随着神经网络的发展,基于各类神经网络的语言模型不断被提出,泛化能力越来越强。基于神经网络的语言模型不再通过显性的计算公式对语言符号的概率进行计算,而是利用语料库中的样本对神经网络模型进行训练。本章接下来将分别介绍两类最具代表性的基于神经网络的语言模型:基于 RNN 的语言模型和基于 Transformer 的语言模型。
1.2 基于 RNN 的语言模型
循环神经网络(Recurrent Neural Network, RNN)是一类网络连接中包含环路的神经网络的总称。给定一个序列,RNN 的环路用于将历史状态叠加到当前状态上。沿着时间维度,历史状态被循环累积,并作为预测未来状态的依据。因此,RNN 可以基于历史规律,对未来进行预测。基于 RNN 的语言模型,以词序列作为输入,基于被循环编码的上文和当前词来预测下一个词出现的概率。本节将先对原始 RNN 的基本原理进行介绍,然后讲解如何利用 RNN 构建语言模型。
1.2.1 循环神经网络 RNN
按照推理过程中信号流转的方向,神经网络的正向传播范式可分为两大类:前馈传播范式和循环传播范式。在前馈传播范式中,计算逐层向前,“不走回头路”。而在循环传播范式中,某些层的计算结果会通过环路被反向引回前面的层中,形成 “螺旋式前进” 的范式。采用前馈传播范式的神经网络可以统称为前馈神经网络(Feed-forward Neural Network, FNN),而采用循环传播范式的神经网络被统称为循环神经网络(Recurrent Neural Network, RNN)。以包含输入层、隐藏层、输出层的神经网络为例。图 1.2 中展示了最简单的 FNN 和 RNN 的网络结构示意图,可见 FNN 网络结构中仅包含正向通路。而 RNN 的网络结构中除了正向通路,还有一条环路将某层的计算结果再次反向连接回前面的层中。
图 1.2: 前馈传播范式与循环传播范式的对比
设输入序列为
{x1,x2,x3,...,xt}
,隐状态为
{h1,h2,h3,...,ht}
,对应输出为
{o1,o2,o3,...,ot}
,输入层、隐藏层、输出层对应的网络参数分别为
WI,WH,WO
。
g(⋅)
为激活函数,
f(⋅)
为输出函数。将输入序列一个元素接着一个元素地串行输入时,对于 FNN,当前的输出只与当前的输入有关,即
ot=f(WOg(WIxt))。(1.18)
此处为方便对比,省去了偏置项。独特的环路结构导致 RNN 与 FNN 的推理过程完全不同。RNN 在串行输入的过程中,前面的元素会被循环编码成隐状态,并叠加到当前的输入上面。其在 t 时刻的输出如下:
ht=g(WHht−1+WIxt)=g(WHg(WHht−2+WIxt−1)+WIxt)=⋯ ot=f(WOht)。(1.19)
其中,
t>0
,
h0=0
。将此过程按照时间维度展开,可得到 RNN 的推理过程,如图 1.3 所示。注意,图中展示的 t 时刻以前的神经元,都是过往状态留下的 “虚影” 并不真实存在,如此展开只是为了解释 RNN 的工作方式。
可以发现,在这样一个元素一个元素依次串行输入的设定下,RNN 可以将历史状态以隐变量的形式循环叠加到当前状态上,对历史信息进行考虑,呈现出螺旋式前进的模式。但是,缺乏环路的 FNN 仅对当前状态进行考虑,无法兼顾历史状态。以词序列 {长颈鹿,脖子,长} 为例,在给定 “脖子” 来预测下一个词是什么的时候,FFN 将仅仅考虑 “脖子” 来进行预测,可能预测出的下一词包含 “短”,“疼” 等等;而 RNN 将同时考虑 “长颈鹿” 和 “脖子”,其预测出下一词是 “长” 的概率将更高,历史信息 “长颈鹿” 的引入,可以有效提升预测性能。
图 1.3: RNN 推理过程从时间维度拆解示意图
如果 FNN 想要做到对历史信息进行考虑,则需要将所有元素同时输入到模型中去,这将导致模型参数量的激增。虽然,RNN 的结构可以让其在参数量不扩张的情况下实现对历史信息的考虑,但是这样的环路结构给 RNN 的训练带来了挑战。在训练 RNN 时,涉及大量的矩阵联乘操作,容易引发梯度衰减或梯度爆炸问题。具体分析如下:
设 RNN 语言模型的训练损失为:
L=L(x,o,WI,WH,WO)=i=1∑tl(oi,yi)。(1.20)
其中,
l(⋅)
为损失函数,
yi
为标签。
损失 L 关于参数 的梯度为:
其中,
并且,
其中,。综上,有
从上式中可以看出,求解 的梯度时涉及大量的矩阵级联相乘。这会导致其数值被级联放大或缩小。文献 [17] 中指出,当 的最大特征值小于 1 时,会发生梯度消失;当 的最大特征值大于 1 时,会发生梯度爆炸。梯度消失和爆炸导致训练上述 RNN 非常困难。为了解决梯度消失和爆炸问题,GRU [4] 和 LSTM [8] 引入门控结构,取得了良好效果,成为主流的 RNN 网络架构。
1.2.2 基于 RNN 的语言模型
对词序列
{w1,w2,w3,...,wN}
,基于 RNN 的语言模型每次根据当前词
wi
和循环输入的隐藏状态
hi−1
,来预测下一个词
wi+1
出现的概率,即
P(wi+1∣w1:i)=P(wi+1∣wi,hi−1)。(1.25)
其中,当
i=1
时,
P(wi+1∣wi,hi−1)=P(w2∣w1)
。基于此,
{w1,w2,...,wN}
整体出现的概率为:
P(w1:N)=i=1∏N−1P(wi+1∣wi,hi−1)。(1.26)
在基于 RNN 的语言模型中,输出为一个向量,其中每一维代表着词典中对应词的概率。设词典 D 中共有
∣D∣
个词
{w^1,w^2,w^3,...,w^∣D∣}
,基于 RNN 的语言模型的输出可表示为
oi={oi[w^d]}d=1∣D∣
,其中,
oi[w^d]
表示词典中的词
w^d
出现的概率。因此,对基于 RNN 的语言模型有
P(w1:N)=i=1∏N−1P(wi+1∣w1:i)=i=1∏Noi[wi+1]。(1.27)
图 1.1: n-grams 示例语料库。 语料库内容: 脖子长是长颈鹿最醒目的特征之一。 脖子长使得长颈鹿看起来非常优雅,并为其在获取食物上带来便利。 有了长脖子的加持,长颈鹿可以观察到动物园里那些隐藏的角落里发生的事情。 长颈鹿脖子和人类脖子一样,只有七节颈椎,也容易患颈椎病。 如同长颈鹿脖子由短变长的进化历程一样,语言模型也在不断进化。
图 1.2: 前馈传播范式与循环传播范式的对比。 左:前馈:
x→WI→h→WO→o
右:循环:
x→WI→h
,h 通过
WH
环路回接到自身输入,再到
WO→o
图 1.4: RNN 计算词序列概率示意图
以下举例对上述过程进行说明。假设词表
D={
脖子,头部,吃,长,疼,吃,短
}
,基于 RNN 的语言模型计算 “长颈鹿脖子长” 的概率的过程如图 1.4 所示。
P(长颈鹿脖子长)=P(脖子∣长颈鹿)⋅P(长∣脖子,h1)=0.2×0.6=0.12。(1.28)
基于以上预训练任务,对 RNN 语言模型进行训练时,可选用如下交叉熵函数作为损失函数。
lCE(oi)=−d=1∑∣D∣I(w^d=wi+1)logoi[wi+1]=−logoi[wi+1],(1.29)
其中,
I(⋅)
为指示函数,当
w^d=wi+1
时等于 1,当
w^d=wi+1
时等于 0。
设训练集为 S,RNN 语言模型的损失可以构造为:
L(S,WI,WH,WO)=N∣S∣1s=1∑∣S∣i=1∑NlCE(oi,s),(1.30)
其中,
oi,s
为 RNN 语言模型输入第s个样本的第i个词时的输出。此处为方便表述,假设每个样本的长度都为N。在此损失的基础上,构建计算图,进行反向传播,便可对 RNN 语言模型进行训练。上述训练过程结束之后,我们可以直接利用此模型对序列数据进行特征抽取。抽取的特征可以用于解决下游任务。此外,我们还可以对此语言模型的输出进行解码,在 “自回归” 的范式下完成文本生成任务。 在自回归中,第一轮,我们首先将第一个词输入给 RNN 语言模型,经过解码,得到一个输出词。然后,我们将第一轮输出的词与第一轮输入的词拼接,作为第二轮的输入,然后解码得到第二轮的输出。接着,将第二轮的输出和输入拼接,作为第三轮的输入,以此类推。每次将本轮预测到的词拼接到本轮的输入上,输入给语言模型,完成下一轮预测。在循环迭代的 “自回归” 过程中,我们不断生成新的词,这些词便构成了一段文本。
由于 RNN 模型循环迭代的本质,其不易进行并行计算,导致其在输入序列较长时,训练较慢。下节将对容易并行的基于 Transformer 的语言模型进行介绍。
1.3 基于 Transformer 的语言模型
Transformer 是一类基于注意力机制(Attention)的模块化构建的神经网络结构。给定一个序列,Transformer 将一定数量的历史状态和当前状态同时输入,然后进行加权相加。对历史状态和当前状态进行 “通盘考虑”,然后对未来状态进行预测。基于 Transformer 的语言模型,以词序列作为输入,基于一定长度的上文和当前词来预测下一个词出现的概率。本节将先对 Transformer 的基本原理进行介绍,然后讲解如何利用 Transformer 构建语言模型。
1.3.1 Transformer
Transformer 是由两种模块组合构建的模块化网络结构。两种模块分别为:(1) 注意力(Attention)模块;(2) 全连接前馈(Fully-connected Feedforwad)模块。其中,自注意力模块由自注意力层(Self-Attention Layer)、残差连接(Residual Connections)和层正则化(Layer Normalization)组成。全连接前馈模块由全连接前馈层,残差连接和层正则化组成。两个模块的结构示意图如图 1.5 所示。以下详细介绍每个层的原理及作用。
图 1.5: 注意力模块与全连接前馈模块
1. 注意力层(Attention Layer)
注意力层采用加权平均的思想将前文信息叠加到当前状态上。Transformer 的注意力层将输入编码为 query,key,value 三部分,即将输入编码为。其中,query 和 key 用于计算自注意力的权重,value 是对输入的编码。具体的,
其中,
其中,用于度量两个输入之间的相关程度,softmax 函数用于对此相关程度进行归一化。此外,
其中,分别为 query,key,value 编码器的参数。以包含三个元素的输入为例,Transformer 自注意力的实现图 1.6 所示。
图 1.6: 注意力机制示意图
2. 全连接前馈层(Fully-connected Feedforward Layer)
全连接前馈层占据了 Transformer 近三分之二的参数,掌管着 Transformer 模型的记忆。其可以看作是一种 Key-Value 模式的记忆存储管理模块 [7]。全连接前馈层包含两层,两层之间由 ReLU 作为激活函数。设全连接前馈层的输入为v,全连接前馈层可由下式表示:
其中,和分别为第一层和第二层的权重参数,和分别为第一层和第二层的偏置参数。其中第一层的可看作神经记忆中的 key,而第二层可看作 value。
3. 层正则化(Layer Normalization)
层正则化用以加速神经网络训练过程并取得更好的泛化性能 [1]。设输入到层正则化层的向量为
v={vi}i=1n
。层正则化层将在v的每一维度
vi
上都进行层正则化操作。具体地,层正则化操作可以表示为下列公式:
LN(vi)=δα(vi−μ)+β。(1.35)
其中,
α
和
β
为可学习参数。
μ
和
δ
分别是隐藏状态的均值和方差,可由下列公式分别计算。
4. 残差连接(Residual Connections)
引入残差连接可以有效解决梯度消失问题。在基本的 Transformer 编码模块中包含两个残差连接。第一个残差连接是将自注意力层的输入由一条旁路叠加到自注意力层的输出上,然后输入给层正则化。第二个残差连接是将全连接前馈层的输入由一条旁路引到全连接前馈层的输出上,然后输入给层正则化。
上述将层正则化置于残差连接之后的网络结构被称为 Post-LN Transformer。与之相对的,还有一种将层正则化置于残差连接之前的网络结构,称之为 Pre-LN Transformer。
图 1.7: Transformer 结构示意图
Transformers。对比两者,Post-LN Transformer 应对表征坍塌 (Representation Collapse) 的能力更强,但处理梯度消失略弱。而 Pre-LN Transformers 可以更好的应对梯度消失,但处理表征坍塌的能力略。
Transformer 的 Encoder 部分和 Decoder 部分都可以单独用于构造语言模型,分别对应 Encoder-Only 模型和 Decoder-Only 模型。Encoder-Only 模型和 Decoder-Only 模型的具体结构将在第二章中进行详细介绍。
1.3.2 基于 Transformer 的语言模型
在 Transformer 的基础上,可以设计多种预训练任务来训练语言模型。
对词序列
{w1,w2,w3,...,wN}
,基于 Transformer 的语言模型根据
{w1,w2,...,wi}
预测下一个词
wi+1
出现的概率。在基于 Transformer 的语言模型中,输出为一个向量,其中每一维代表着词典中对应词的概率。设词典D中共有
∣D∣
个词
{w^1,w^2,...,w^∣D∣}
。基于 Transformer 的语言模型的输出可表示为
oi={oi[w^d]}d=1∣D∣
,其中,
oi[w^d]
表示词典中的词
w^d
出现的概率。因此,对 Transformer 的语言模型对词序列
{w1,w2,w3,...,wN}
整体出现的概率的预测为:
与训练 RNN 语言模型相同,Transformer 语言模型也常用如下交叉熵函数作为损失函数。
其中,为指示函数,当时等于 1,当时等于 0。
设训练集为 S,Transformer 语言模型的损失可以构造为:
L(S,W)=N∣S∣1s=1∑∣S∣i=1∑NlCE(oi,s)(1.39)
其中,
oi,s
为 Transformer 语言模型输入样本s的第i个词时的输出。在此损失的基础上,构建计算图,进行反向传播,便可对 Transformer 语言模型进行训练。
相较于 RNN 模型串行的循环迭代模式,Transformer 并行输入的特性,使其容易进行并行计算。但是,Transformer 并行输入的范式也导致网络模型的规模随输入序列长度的增长而平方次增长。这为应用 Transformer 处理长序列带来挑战。
1.4 语言模型的采样方法
语言模型的输出为一个向量,该向量的每一维代表着词典中对应词的概率。在采用自回归范式的文本生成任务中,语言模型将依次生成一组向量并将其解码为文本。将这组向量解码为文本的过程被成为语言模型解码。解码过程显著影响着生成文本的质量。当前,两类主流的解码方法可以总结为 (1). 概率最大化方法;(2). 随机采样方法。两类方法分别在下面章节中进行介绍。
1.4.1 概率最大化方法
设词典为D,输入文本为
{w1,w2,w3,...,wN}
,第i轮自回归中输出的向量为
oi={oi[wd]}d=1∣D∣
,模型在M轮自回归后生成的文本为
{wN+1,wN+2,wN+3,...,wN+M}
。生成文档的出现的概率可由下式进行计算。
P(wN+1:N+M)=i=N∏N+M−1P(wi+1∣w1:i)=i=N∏N+M−1oi[wi+1](1.40)
基于概率最大化的解码方法旨在最大化
P(wN+1:N+M)
,以生成出可能性最高的文本。该问题的搜索空间大小为
MD
,是 NP-Hard 问题。现有概率最大化方法通常采用启发式搜索方法。本节将介绍两种常用的基于概率最大化的解码方法。
1. 贪心搜索(Greedy Search)
贪心搜索在在每轮预测中都选择概率最大的词,即
wi+1=argw∈Dmaxoi[w](1.41)
贪心搜索只顾 “眼前利益”,忽略了 “远期效益”。当前概率大的词有可能导致后续的词概率都很小。贪心搜索容易陷入局部最优,难以达到全局最优解。以图 1.8 为例,当输入为 “生成一个以长颈鹿开头的故事:长颈鹿” 时,预测第一个词为 “是” 的概率最高,为 0.3。但选定 “是” 之后,其他的词的概率都偏低。如果按照贪心搜索的方式,我们最终得到的输出为 “是草食”。其概率仅为 0.03。而如果我们在第一个词选择了概率第二的 “脖子”,然后第二个词选到了 “长”,最终的概率可以达到 0.1。通过此例,可以看出贪心搜索在求解概率最大的时候容易陷入局部最优。为缓解此问题,可以采用波束搜索(Beam Search)方法进行解码。
2. 波束搜索(Beam Search)
波束搜索在每轮预测中都先保留b个可能性最高的词
Bi={wi+11,wi+12,...,wi+1b}
,即:
min{oi[w] for w∈Bi}>max{oi[w] for w∈D−Bi}。(1.42)
图 1.8: 贪心搜索与波束搜索对比以及概率最大化解码的潜在问题
在结束搜索时,得到M个集合,即
{Bi}i=1M
。找出最优组合使得联合概率最大,即:
{wN+1,...,wN+M}=arg{wi∈Bi for 1≤i≤M}maxi=1∏MoN+i[wi]。(1.43)
继续以上面的 “生成一个以长颈鹿开头的故事” 为例,从图 1.8 中可以看出如果我们采用
b=2
的波束搜索方法,我们可以得到 “是草食”,“是反刍”,“脖子长”,“脖子优雅” 四个候选组合,对应的概率分别为:0.03,0.027,0.1,0.04。我们容易选择到概率最高的 “脖子长”。
但是,概率最大的文本通常是最为常见的文本。这些文本会略显平庸。在开放式文本生成中,无论是贪心搜索还是波束搜索都容易生成一些 “废话文学”— 重复且平庸的文本。其所生成的文本缺乏多样性 [19]。如在图 1.8 中的例子所示,概率最大的方法会生成 “脖子长”。“长颈鹿脖子长” 这样的文本新颖性较低。为了提升生成文本的新颖度,我们可以在解码过程中加入一些随机元素。这样的话就可以解码到一些不常见的组合,从而使得生成的文本更具创意,更适合开放式文本任务。在解码过程中加入随机性的方法,成为随机采样方法。下节将对随机采样方法进行介绍。
1.4.2 随机采样方法
为了增加生成文本的多样性,随机采样的方法在预测时增加了随机性。在每轮预测时,其先选出一组可能性高的候选词,然后按照其概率分布进行随机采样,采样出的词作为本轮的预测结果。当前,主流的 Top-K 采样和 Top-P 采样方法分别通过指定候选词数量和划定候选词概率阈值的方法对候选词进行选择。在采样方法中加入 Temperature 机制可以对候选词的概率分布进行调整。接下来将对 Top-K 采样、Top-P 采样和 Temperature 机制分别展开介绍。
Top-K 采样
Top-K 采样在每轮预测中都选取 K 个概率最高的词
{wi+11,wi+12,…,wi+1K}
作为本轮的候选词集合,然后对这些词的概率用 softmax 函数进行归一化,得到如下分布函数
p(wi+11,…,wi+1K)={∑j=1Kexp(oi[wi+1j])exp(oi[wi+11]),…,∑j=1Kexp(oi[wi+1j])exp(oi[wi+1K])}.(1.44)
然后根据该分布采样出本轮的预测的结果,即
wi+1∼p(wi+11,…,wi+1K)。(1.45)
Top-K 采样可以有效的增加生成文本的新颖度,例如在上述图 1.8 所示的例子中选用 Top-3 采样的策略,则有可能会选择到 “看着躲在”。“长颈鹿看着躲在” 可能是一个极具戏剧性的悬疑故事的开头。
图 1.9: Top-K 采样的潜在问题及其与 Top-P 方法的对比
Top-P 采样
为了解决固定候选集所带来的问题,Top-P 采样(即 Nucleus 采样)被提出 [9]。其设定阈值 p 来对候选集进行选取。其候选集可表示为
Sp={wi+11,wi+12,…,wi+1∣Sp∣}
,其中,对
Sp
有,
w∈Sp∑oi[w]≥p
。候选集中元素的分布服从
p(wi+11,…,wi+1∣Sp∣)={∑j=1∣Sp∣exp(oi[wi+1j])exp(oi[wi+11]),…,∑j=1∣Sp∣exp(oi[wi+1j])exp(oi[wi+1∣Sp∣])}.(1.46)
然后根据该分布采样出本轮的预测的结果,即
wi+1∼p(wi+11,…,wi+1∣Sp∣)。(1.47)
应用阈值作为候选集选取的标准之后,Top-P 采样可以避免选到概率较小、不符合常理的词,从而减少 “胡言乱语”。例如在图 1.9 (a) 所示例子中,我们若以 0.9 作为阈值,则就可以很好的避免 “长颈鹿有四条裤子” 的问题。并且,其还可以容纳更多的具有相近概率的词,增加文本的丰富度,改善 “枯燥无趣”。例如在图 1.9 (b) 所示的例子中,我们若以 0.9 作为阈值,则就可以包含打架、睡觉等长颈鹿脖子鲜为人知的用途。
Temperature 机制
Top-K 采样和 Top-P 采样的随机性由语言模型输出的概率决定,不可自由调整。但在不同场景中,我们对于随机性的要求可能不一样。比如在开放文本生成中,我们更倾向于生成更具创造力的文本,所以我们需要采样具有更强的随机性。而在代码生成中,我们希望生成的代码更为保守,所以我们需要较弱的随机性。引入 Temperature 机制可以对解码随机性进行调节。Temperature 机制通过对 Softmax 函数中的自变量进行尺度变换,然后利用 Softmax 函数的非线性实现对分布的控制。设 Temperature 尺度变换的变量为 T。
引入 Temperature 后,Top-K 采样的候选集的分布如下所示:
p(wi+11,…,wi+1K)=⎩⎨⎧∑j=1Kexp(Toi[wi+1j])exp(Toi[wi+11]),…,∑j=1Kexp(Toi[wi+1j])exp(Toi[wi+1K])⎭⎬⎫.(1.48)
引入 Temperature 后,Top-P 采样的候选集的分布如下所示:
p(wi+11,…,wi+1∣Sp∣)=⎩⎨⎧∑j=1∣Sp∣exp(Toi[wi+1j])exp(Toi[wi+11]),…,∑j=1∣Sp∣exp(Toi[wi+1j])exp(Toi[wi+1∣Sp∣])⎭⎬⎫.(1.49)
容易看出,当 时,Temperature 机制会使得候选集中的词的概率差距减小,分布变得更平坦,从而增加随机性。当 时,Temperature 机制会使得候选集中的元素的概率差距加大,强者越强,弱者越弱,概率高的候选词会容易被选到,从而随机性变弱。Temperature 机制可以有效的对随机性进行调节来满足不同的需求。
1.5 语言模型的评测
得到一个语言模型后,我们需要对其生成能力进行评测,以判断其优劣。评测语言模型生成能力的方法可以分为两类。第一类方法不依赖具体任务,直接通过语言模型的输出来评测模型的生成能力,称之为内在评测(Intrinsic Evaluation)。第二类方法通过某些具体任务,如机器翻译、摘要生成等,来评测语言模型处理这些具体生成任务的能力,称之为外在评测(Extrinsic Evaluation)。
1.5.1 内在评测
在内在评测中,测试文本通常由与预训练中所用的文本独立同分布的文本构成,不依赖于具体任务。最为常用的内部评测指标是困惑度(Perplexity)[10]。其度量了语言模型对测试文本感到 “困惑” 的程度。设测试文本为
stest=w1:N
。语言模型在测试文本上的困惑度 PPL 可由下式计算:
PPL(stest)=P(w1:N)−N1=Ni=1∏NP(wi∣w<i)1。(1.50)
由上式可以看出,如果语言模型对测试文本越 “肯定”(即生成测试文本的概率越高),则困惑度的值越小。而语言模型对测试文本越 “不确定”(即生成测试文本的概率越低),则困惑度的值越大。由于测试文本和预训练文本同分布,预训练文本代表了我们想要让语言模型学会生成的文本,如果语言模型在这些测试文本上越不 “困惑”,则说明语言模型越符合我们对其训练的初衷。因此,困惑度可以以一定程度上衡量语言模型的生成能力。
对困惑度进行改写,其可以改写成如下等价形式。
PPL(stest)=exp(−N1i=1∑NlogP(wi∣w<i))。(1.51)
其中,
−N1i=1∑NlogP(wi∣w<i)
可以看作是生成模型生成的词分布与测试样本真实的词分布间的交叉熵,即
−N1i=1∑Nd=1∑∣D∣I(w^d=wi)logoi−1[wi]
,其中 D 为语言模型所采用的词典。因为
P(wi∣w<i)≤1
,所以此交叉熵是生成模型生成的词分布的信息熵的上界,即
−N1i=1∑NP(wi∣w<i)logP(wi∣w<i)≤−N1i=1∑NlogP(wi∣w<i)。(1.52)
因此,困惑度减小也意味着熵减,意味着模型 “胡言乱语” 的可能性降低。
1.5.2 外在评测
在外在评测中,测试文本通常包括该任务上的问题和对应的标准答案,其依赖于具体任务。通过外在评测,我们可以评判语言模型处理特定任务的能力。外在评测方法通常可以分为基于统计指标的评测方法和基于语言模型的评测方法两类。以下对此两类方法中的经典方法进行介绍。
基于统计指标的评测
基于统计指标的方法构造统计指标来评测语言模型的输出与标准答案间的契合程度,并以此作为评测语言模型生成能力的依据。BLEU(BiLingual Evaluation Understudy)和 ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是应用最为广泛的两种统计指标。其中,BLEU 是精度导向的指标,而 ROUGE 是召回导向的指标。以下分别对这两个指标展开介绍。
BLEU 被提出用于评价模型在机器翻译(Machine Translation, MT)任务上的效果 [6]。其在词级别上计算生成的翻译与参考翻译间的重合程度。具体地,BLEU 计算多层次 n-gram 精度的几何平均。设生成的翻译文本的集合为
Sgen={Sgeni}i=1∣Sgen∣
,对应的参考翻译集合为
Sref={Srefi}i=1∣Sref∣
,其中,
Sgeni
与
Srefi
一一对应,且
∣Sref∣=∣Sgen∣
。原始的 n-gram 精度的定义如下:
Pr(gn)=∑i=1∣Sgen∣∑gn∈SgeniCount(gn)∑i=1∣Sgen∣∑gn∈SgeniCountmatch(gn,Srefi)。(1.53)
其中,
gn
代表 n-gram。上式的分子计算了生成的翻译与参考翻译的重合的 n-gram 的个数,分母计算了生成的翻译中包含的 n-gram 的总数。例如,MT 模型将 “大语言模型” 翻译成英文,生成的翻译为 “big language models”,而参考文本为 “large language models”。当
n=1
时,
Pr(g1)=32
。当
n=2
时,
Pr(g2)=21
基于 n-gram 精度,BLEU 取 N 个 n-gram 精度的几何平均作为评测结果:
BLEU=Nn=1∏NPr(gn)=exp(n=1∑NlogPr(gn))。(1.54)
例如,当
N=3
时,BLEU 是 unigram 精度,bigram 精度,trigram 精度的几何平均。在以上原始 BLEU 的基础上,我们还可以通过对不同的 n-gram 精度进行加权或对不同的文本长度设置惩罚项来对 BLEU 进行调整,从而得到更为贴近人类评测的结果。
ROUGE 被提出用于评价模型在摘要生成(Summarization)任务上的效果 [13]。常用的 ROUGE 评测包含 ROUGE-N, ROUGE-L, ROUGE-W, 和 ROUGE-S 四种。其中,ROUGE-N 是基于 n-gram 的召回指标,ROUGE-L 是基于最长公共子序列(Longest Common Subsequence, LCS)的召回指标。ROUGE-W 是在 ROUGE-L 的基础上,引入对 LCS 的加权操作后的召回指标。ROUGE-S 是基于 Skip-bigram 的召回指标。下面给出 ROUGE-N、ROUGE-L 的定义。ROUGE-W 和 ROUGE-S 的具体计算方法可在 [13] 中找到。
ROUGE-N 的定义如下:
ROUGE−N=∑s∈Sref∑gn∈sCount(gn)∑s∈Sref∑gn∈sCountmatch(gn,sgen)。(1.55)
ROUGE-L 的定义如下:
ROUGE−L=Rrg+β2Rgr(1+β2)RrgRgr。(1.56)
其中,
Rrg=∣sref∣LCS(sref,sgen),(1.57)
Rgr=∣sgen∣LCS(sref,sgen),(1.58)
是模型生成的摘要 与参考摘要 间的最大公共子序列的长度,。
基于统计指标的评测方法通过对语言模型生成的答案和标准答案间的重叠程度进行评分。这样的评分无法完全适应生成任务中表达的多样性,与人类的评测相差甚远,尤其是在生成的样本具有较强的创造性和多样性的时候。为解决此问题,可以在评测中引入一个其他语言模型作为 “裁判”,利用此 “裁判” 在预训练阶段掌握的能力对生成的文本进行评测。下面对这种引入 “裁判” 语言模型的评测方法进行介绍。
基于语言模型的评测
目前基于语言模型的评测方法主要分为两类:(1) 基于上下文词嵌入(Contextual Embeddings)的评测方法;(2) 基于生成模型的评测方法。典型的基于上下文词嵌入的评测方法是 BERTScore [24]。典型的基于生成模型的评测方法是 G-EVAL [14]。与 BERTScore 相比,G-EVAL 无需人类标注的参考答案。这使其可以更好的适应到缺乏人类标注的任务中。
BERTScore 在 BERT 的上下文词嵌入向量的基础上,计算生成文本
sgen
和参考文本
sref
间的相似度来对生成样本进行评测。BERT 将在第二章给出详细介绍。设生成文本包含
∣sgen∣
个词,即
sgen={wgi}i=1∣sgen∣
。设参考文本包含
∣sref∣
个词,即
sref={wri}i=1∣sref∣
。利用 BERT 分别得到
sgen
和
sref
中每个词的上下文词嵌入向量,即
vgi=BERT(wgi∣sgen)
,
vri=BERT(wri∣sref)
。利用生成文本和参考文本的词嵌入向量集合
vgen={vgi}i=1∣vgen∣
和
vref={vri}i=1∣vref∣
便可计算 BERTScore。BERTScore 从精度(Precision),召回(Recall)和 F1 量度三个方面对生成文档进行评测。其定义分别如下:
PBERT=∣vgen∣1i=1∑∣vgen∣vr∈vrefmaxvgi⊤vr,(1.59)
RBERT=∣vref∣1i=1∑∣vref∣vg∈vgenmaxvri⊤vg,(1.60)
FBERT=PBERT+RBERT2PBERT⋅RBERT。(1.61)
相较于统计评测指标,BERTScore 更接近人类评测结果。但是,BERTScore 依赖于人类给出的参考文本。这使其无法应用于缺乏人类标注样本的场景中。得益于生成式大语言模型的发展,G-EVAL 利用 GPT-4 在没有参考文本的情况下对生成文本进行评分。G-EVAL 通过提示工程(Prompt Engineering)引导 GPT-4 输出评测分数。Prompt Engineering 将在本书第三章进行详细讲解。
如下图所示,G-EVAL 的 Prompt 分为三部分:(1) 任务描述与评分标准;(2) 评测步骤;(3) 输入文本与生成的文本。在第一部分中,任务描述指明需要评测的任务式什么(如摘要生成),评分标准给出评分需要的范围,评分需要考虑的因素等内容。第二部分的评测步骤是在第一部分内容的基础上由 GPT-4 自己生成的思维链(Chain-of-Thoughts, CoT)。本书的第三章将对思维链进行详细讲解。第三部分的输入文本与生成的文本是源文本和待评测模型生成的文本。例如摘要生成任务中的输入文本是原文,而生成的文本就是生成摘要。将上述三部分组合在一个 prompt 里面然后输入给 GPT-4,GPT-4 便可给出对应的评分。直接将 GPT-4 给出的得分作为评分会出现区分度不够的问题,因此,G-EVAL 还引入了对所有可能得分进行加权平均的机制来进行改进 [14]。
图 1.10: G-EVAL 评测流程
除 G-EVAL 外,近期还有多种基于生成模型的评测方法被提出 [12]。其中典型的有 InstructScore [23],其除了给出数值的评分,还可以给出对该得分的解释。基于生成模型的评测方法相较于基于统计指标的方法和基于上下文词嵌入的评测方法而言,在准确性、灵活性、可解释性等方面都具有独到的优势。可以预见,未来基于生成模型的评测方法将得到更为广泛的关注和应用。