什么是 Context Engineering?它与 Prompt Engineering 有何本质区别?
难度:高级 分类:Prompt Engineering
简短回答
Context Engineering 是一种从"如何写好单条 Prompt"到"如何为 LLM 构建完整、精准上下文"的范式转变。它关注的核心问题不再是措辞技巧,而是上下文的选择、组装与管理。一个 LLM 调用的效果,70% 取决于喂给它的上下文质量,而非 Prompt 本身的遣词造句。Context Engineering 将上下文视为四大来源的动态组合:System Prompt、Tool Results、Conversation History 和 External Knowledge(RAG / API)。其核心挑战在于上下文窗口是有限的"房地产"——必须在有限的 token 预算内,为当前任务挑选信息密度最高的上下文片段。在 Agentic 场景中,这一挑战尤为突出:多轮 tool call 会持续积累上下文,若不加管理,关键信息会被淹没在噪声中,导致 Agent 性能急剧下降。
详细解析
从 Prompt Engineering 到 Context Engineering
Prompt Engineering 聚焦于"怎么问",Context Engineering 聚焦于"用什么信息去问"。这是一个维度的跃升:
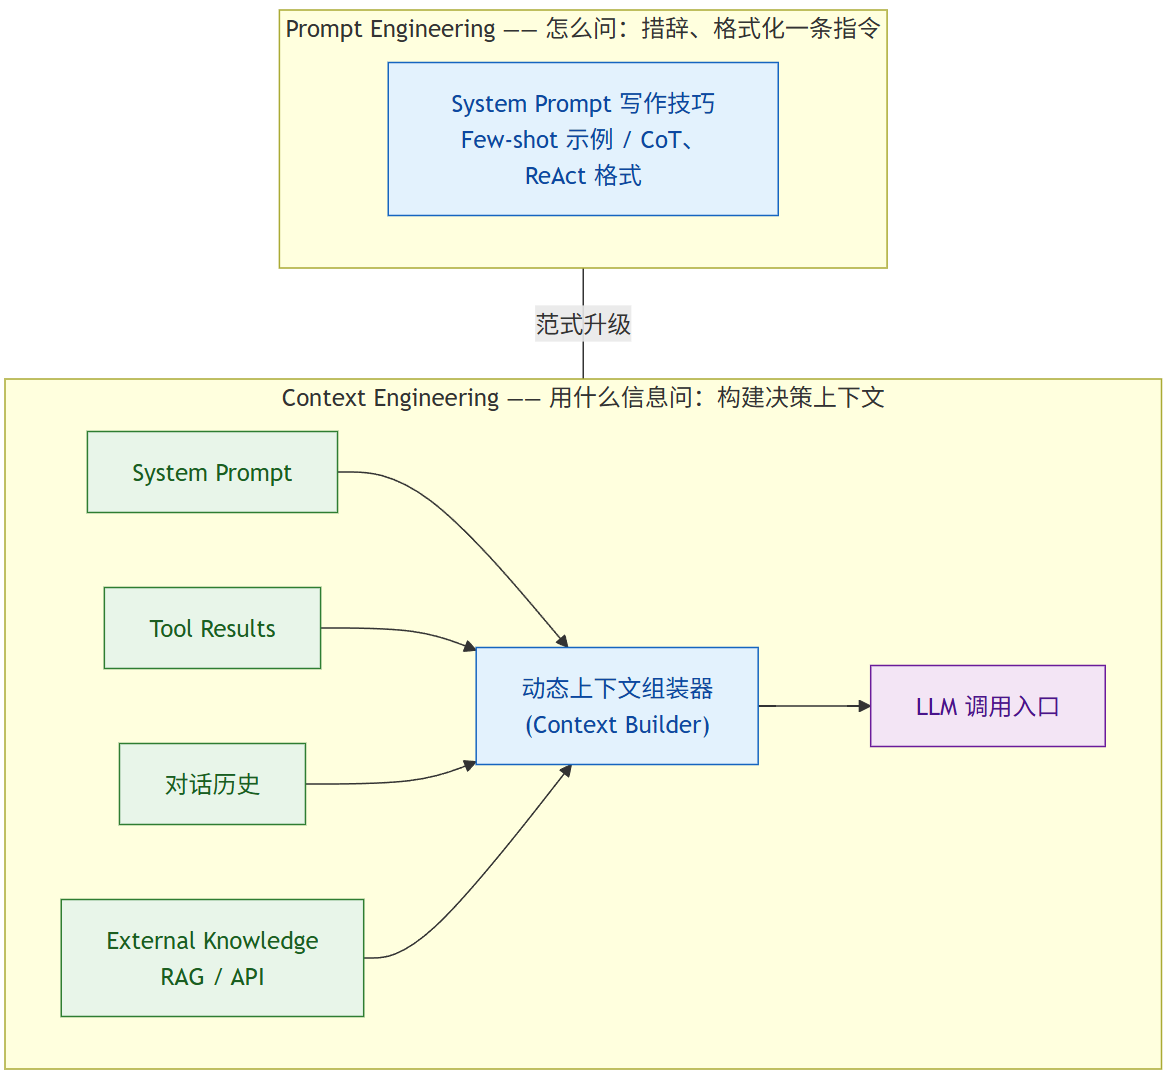
Context Engineering:四路上下文经组装器按预算与优先级合流进 LLM,而非打磨单条 Prompt。
四大上下文来源
#cGnWrPBzBgUT text { white-space: pre; }#cGnWrPBzBgUT .fb0 { stroke: var(--N900-FG, 0.15); }#cGnWrPBzBgUT .fb0 {stroke: rgba(31,35,41, 0.15)}#cGnWrPBzBgUT .fx0 { stroke-miterlimit: 10; }#cGnWrPBzBgUT .fx0 {stroke-miterlimit: 10}#cGnWrPBzBgUT .fa1 { fill: rgb(187, 191, 196); }#cGnWrPBzBgUT .fa1 {fill: rgb(187, 191, 196)}#cGnWrPBzBgUT .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#cGnWrPBzBgUT .fx1 {font-style: normal}#cGnWrPBzBgUT .fx2 { text-anchor: middle; }#cGnWrPBzBgUT .fx2 {text-anchor: middle}#cGnWrPBzBgUT .fx3 { dominant-baseline: central; }#cGnWrPBzBgUT .fx3 {dominant-baseline: central}#cGnWrPBzBgUT .fx4 { stroke: none; }#cGnWrPBzBgUT .fx4 {stroke: none}#cGnWrPBzBgUT .fc0 { fill: var(--text-caption); }#cGnWrPBzBgUT .fc0 {fill: #646a73}#cGnWrPBzBgUT .fa2 { fill: var(--text-link-disabled); }#cGnWrPBzBgUT .fa2 {fill: rgb(187, 191, 196)}#cGnWrPBzBgUT .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#cGnWrPBzBgUT .fx5 {font-style: normal}#cGnWrPBzBgUT .fx6 { text-anchor: start; }#cGnWrPBzBgUT .fx6 {text-anchor: start}#cGnWrPBzBgUT .fx7 { dominant-baseline: alphabetic; }#cGnWrPBzBgUT .fx7 {dominant-baseline: alphabetic}#cGnWrPBzBgUT .fc1 { fill: rgb(0, 0, 0); }#cGnWrPBzBgUT .fc1 {fill: rgb(0, 0, 0)}#cGnWrPBzBgUT .fb1 { fill: var(--N900-FG, 0.15); }#cGnWrPBzBgUT .fb1 {fill: rgba(31,35,41, 0.15)}#cGnWrPBzBgUT .fb2 { fill: rgb(209, 217, 224); }#cGnWrPBzBgUT .fb2 {fill: rgb(209, 217, 224)}#cGnWrPBzBgUT .fa3 { fill: var(--bg-body); }#cGnWrPBzBgUT .fa3 {fill: #fff}ABCD12345来源System PromptTool ResultsConversation HistoryExternal Knowledge内容角色定义、工具描述、输出格式、约束规则搜索结果、API 返回、代码执行输出用户多轮对话、之前的 Agent 推理过程RAG 检索文档、知识库、用户画像特征静态、每次调用都携带动态生成、体积不可控线性增长、含大量噪声按需注入、相关性参差管理策略精简压缩,避免冗余截断 / 摘要 / 选择性保留滑动窗口 / 摘要压缩相关性排序 + top-k 截断
上下文窗口的"房地产"管理
代码块
Plain Text
┌────────────────── Context Window (128K tokens) ──────────────────┐
│ │
│ ┌──────────────┐ 固定区域:~10% │
│ │ System Prompt│ 角色 + 工具描述 + 格式要求 │
│ └──────────────┘ │
│ ┌──────────────┐ 弹性区域:~30% │
│ │ RAG / 知识库 │ 根据查询动态检索 │
Prompt Engineering vs Context Engineering 对比
动态上下文组装器:Python 实现
代码块
Python
from dataclasses import dataclass, field
from enum import Enum
from typing import Optional
class ContextSource(Enum):
"""上下文来源类型"""
SYSTEM = "system"
TOOL_RESULT = "tool_result"
HISTORY = "history"
KNOWLEDGE = "knowledge"
Agentic 场景的特殊挑战
在 Agent 多轮执行过程中,上下文管理面临独特挑战:
代码块
SQL
Agent 执行循环中的上下文膨胀问题:
在 Multi-Agent 系统中,挑战进一步放大:每个 Agent 有独立的上下文窗口,Agent 之间的信息传递需要精心设计——传太多导致 token 浪费,传太少导致信息丢失。Context Engineering 在此扮演的是信息路由器的角色,决定哪些信息传递给哪个 Agent、以什么粒度传递。
Context Engineering 的行业共识:Anthropic 官方工程指南
2026 年,Context Engineering 已从"新概念"成长为行业共识与独立工程学科。Anthropic 发布的官方工程指南将其定义为"为 LLM 的上下文窗口填入恰好够用的信息"的精密工程,核心是把上下文窗口视为一个需要持续维护的有限资源,而非静态容器。
上下文是工作台不是档案柜:写入 → 窗口内压缩管理 → 外化为跨会话记忆。
三个关键认知升级:
上下文窗口 ≠ 记忆。窗口是 Agent 的"工作台"(scratchpad),用完即清;长期信息必须外化到窗口之外的文件、数据库、知识图谱。这与 041 — 上下文窗口管理与压缩 讨论的压缩策略一脉相承。
Agentic Memory:Agent 定期把学到的经验写成笔记(如 .md 文件),持久化到上下文窗口外,下次会话开始时读回。这把"记忆"从一次性 token 变成可累积的资产(详见 043 — 持久化记忆)。
信息衰减是常态。长程 Agent 运行中,早期轮次的工具结果、已完成子任务的细节会从"有用"变成"噪声"。Context Engineering 要求主动清理(context editing / compaction),而非被动等待窗口溢出。
参考资料:Effective Context Engineering for AI Agents (Anthropic 官方工程指南)
Prompt Caching:上下文缓存的经济学
当 Agent 在多轮执行中反复携带相同的 System Prompt、工具定义、知识库前缀时,Prompt Caching(上下文缓存)能把这些稳定前缀的计算结果缓存起来,命中时以极低成本读取——这是 Context Engineering 在"成本维度"的关键杠杆,也是长程 Agent 能"烧得起 token"的根本原因。
核心机制:前缀匹配
代码块
Plain Text
Prompt 渲染顺序(Anthropic):tools → system → messages
┌─ tools ──────────────┐ 位置 0(最稳定)
│ 工具定义(确定性排序) │
├─ system ─────────────┤
│ System Prompt(冻结) │ ◄── cache_control 断点①
├─ messages ───────────┤
│ 对话历史(逐轮增长) │ ◄── cache_control 断点②(最新轮)
│ ... │
│ 当前用户问题(易变) │ 位置 N(最不稳定)
└──────────────────────┘
缓存命中 = 从 prompt 开头到断点的每一个字节完全一致
任何一个字节的改变 → 该断点之后的所有缓存全部失效
Anthropic vs OpenAI 缓存机制对比
⚠️ 上述折扣率与 TTL 为公开 API 文档截至 2026.7 的参数;各厂商可能随定价调整,使用前以官方文档为准。
成本/延迟收益量化
以一个携带 20K token System Prompt + 10K token 知识库前缀的 Agent 为例(Anthropic):
代码块
Plain Text
无缓存 有缓存(命中后)
输入 token 30,000 30,000(其中 ~28,000 命中缓存)
输入成本(相对值) 1.0× ≈ 0.19× (28000×0.1 + 2000×1) / 30000
首字延迟(TTFT) 基线 显著降低(跳过前缀的 prefill 计算)
盈亏平衡点:
· 5 分钟 TTL:2 次请求即回本 (1.25× + 0.1× = 1.35× vs 2× 无缓存)
· 1 小时 TTL:至少需 3 次请求 (2× + 0.2× = 2.2× vs 3× 无缓存)
对于 Agentic 场景(同一会话内 10+ 轮调用,每轮都携带相同 System Prompt + 累积历史),缓存命中率通常可达 80%+——没有 Prompt Caching,多轮 Agent 的 token 成本将高到难以承受。
缓存失效管理:静默杀手
缓存失效不报错——cache_read_input_tokens 静默归零,你只会在账单上发现成本飙升。常见"静默失效"根因:
工程实践:把动态内容(时间、用户 ID、会话状态)放到 messages 末尾,绝不要插进 System Prompt;工具列表按 name 确定性排序;构建 prompt 后用 count_tokens 比对前后两次请求的字节差异来排查静默失效。
Agent 多轮场景的断点策略
代码块
Python
# Anthropic: 冻结前缀 + 最新轮各放一个断点
# 每次请求复用之前所有轮次的前缀缓存
response = client.messages.create(
进阶陷阱:单个断点最多回溯 20 个 content block 找前一次缓存。长 Agent 轮次(一轮内大量 tool_use/tool_result)若超过 20 个 block,下一个断点会静默 miss——需每 ~15 个 block 补一个中间断点。冷启动场景可用 max_tokens=0 的空请求预热缓存,消除首次请求的 prefill 延迟。
常见误区 / 面试追问
误区:"Context Engineering 就是写更好的 Prompt" — 这是最常见的混淆。Prompt Engineering 是 Context Engineering 的一个子集。Context Engineering 不仅关注 Prompt 本身,更关注 Prompt 之外的所有信息——工具返回值如何裁剪、对话历史如何压缩、外部知识如何检索与排序。类比来说,Prompt Engineering 是写好一封邮件,Context Engineering 是管理整个项目的信息流。
误区:"上下文越多越好,反正模型支持 128K" — 研究表明 LLM 存在"Lost in the Middle"现象:当上下文过长时,模型对中间位置信息的注意力显著下降。此外,无关上下文会稀释模型对关键信息的注意力,降低输出质量。正确的做法是追求高信噪比而非高信息量——每一段上下文都应该对当前任务有明确的边际贡献。
追问:"如何衡量上下文质量?" — 可以从三个维度评估:(1) 相关性——上下文中每段信息与当前任务的相关度(可用 embedding 相似度量化);(2) 充分性——是否包含完成任务所需的全部关键信息(通过 ablation test 验证);(3) 效率——信息密度,即有效 token 占总 token 的比例。实践中常用 A/B 测试对比不同上下文策略对最终输出质量的影响。
追问:"Context Engineering 在 Multi-Agent 中如何应用?" — 在 Multi-Agent 架构中,Context Engineering 承担三重角色:(1) 上下文隔离——每个 Agent 只接收与其职责相关的上下文,避免信息过载;(2) 上下文传递——设计 Agent 之间的信息传递协议,决定传递摘要还是原始数据;(3) 共享上下文管理——维护全局状态(如 Blackboard 模式),让多个 Agent 读写共享的结构化上下文,而非互相透传完整历史。