核心框架(AI Agent 面试八股文 · 模块二)
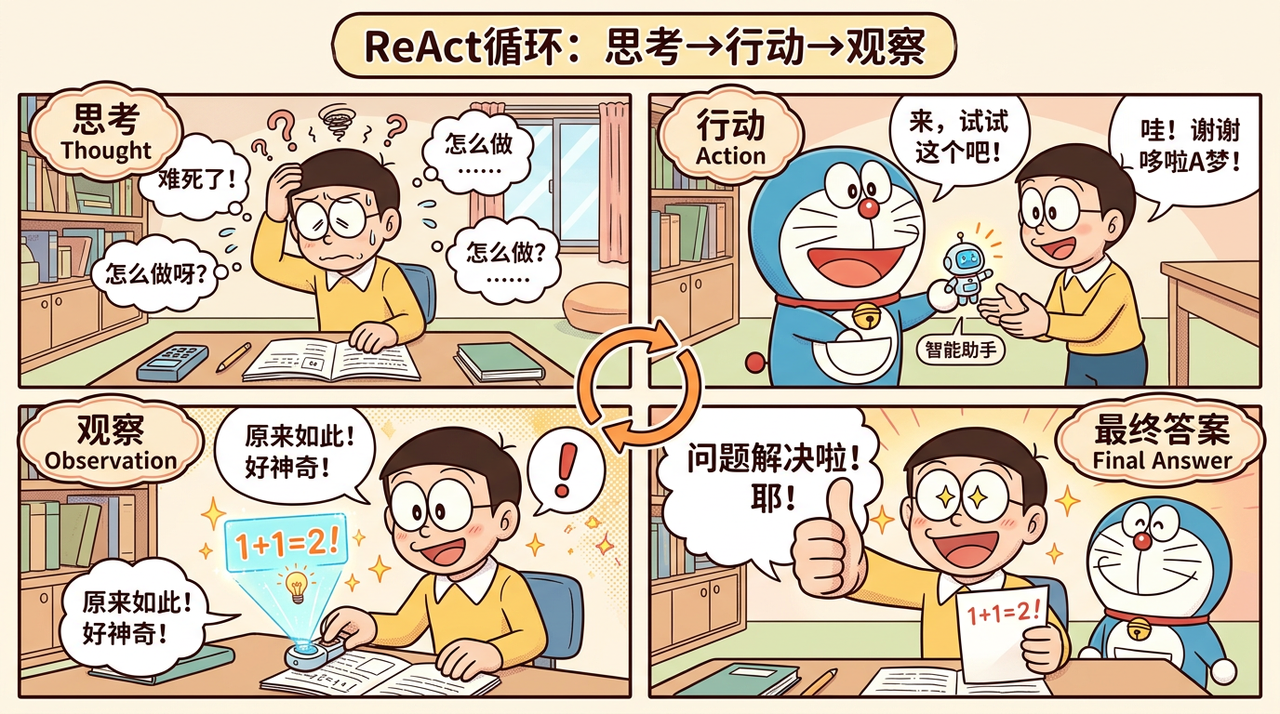
面向零基础读者:本模块系统梳理主流 Agent「推理—行动—编排」框架。建议先理解 ReAct 的「一步想、一步做」,再对比 Plan-and-Execute 的「先想全局、再分步做」,最后把 LangChain / LangGraph / 多 Agent 当作「工程落地方式」来记忆。
目录
LATS(Language Agent Tree Search)
ReAct 框架(重点中的重点)
1.1 概念解释(通俗易懂)
ReAct 的全称是 Reasoning + Acting(推理 + 行动)。可以把它想象成:一个会做题的学生,不是一口气写完答案,而是 边想边做——先在心里说一句「我接下来要干什么」(推理),然后真的去查资料、用计算器、调 API(行动),看到结果后再继续想下一步。
和传统「只输出最终答案」的提示不同,ReAct 要求模型在文本里 显式交替 写出:
•
推理(Thought):为什么要这么做、下一步选什么工具、预期看到什么。
•
行动(Action):调用某个工具(如搜索、代码执行),并给出参数。
•
观察(Observation):环境/工具返回的结果。
循环多次,直到模型给出 Final Answer。
一句话:ReAct = 把「思考过程」和「工具使用」写进同一条轨迹里,让推理可监督、可纠错、可复现。
1.2 原理详解(技术细节)
1.2.1 核心思想:交替推理与行动
单轮问答时,模型容易「幻觉」事实;ReAct 通过 行动 把模型锚定在外部证据上。其关键不是「更会想」,而是 想与做的闭环:
代码块
Plain Text
用户问题
→ Thought:拆解子目标
→ Action:选择工具并执行
→ Observation:获得外部反馈
→ Thought:根据观察修正计划
→ …
→ Final Answer
1.2.2 标准工作流程(伪代码)
代码块
Python
解析要点(面试常问):
•
Thought / Action / Observation 通常用 固定前缀 或 结构化格式(如 JSON)便于程序解析。
•
Observation 只能来自工具,不能由模型自己编造(工程上要校验)。
•
停止条件:出现 Final Answer,或步数上限,或检测到重复无效循环。
1.2.3 Prompt 模板设计(完整示例)
下面是一个 可直接用于教学 的英文模板(业界常用英文工具名;面试时说明「中文任务可把指令改为中文」即可)。
代码块
YAML
You are a helpful assistant that can use tools to answer questions.
You must follow this format strictly:
Question: the input question you must answer
Thought: think step by step about what you should do next
Action: the action to take, must be one of [{tool_names}]
Action Input: the input to the action
Observation: the result of the action
... (this Thought/Action/Action Input/Observation can repeat)
Thought: I now know the final answer
若采用 单段 Action 行(不少论文与开源实现风格):
代码块
YAML
Use the following format:
Question: ...
Thought: ...
Action: Search[query]
Observation: ...
Thought: ...
Action: Calculator[expression]
设计要点:
•
工具清单与参数格式要写清,减少模型胡写工具名。
•
强调「Observation 由系统填充」,避免模型在提示里自己续写假 Observation。
•
Few-shot:给 1~3 个完整轨迹示例,能显著提高格式遵从率。
1.3 面试问题(Q)+ 标准答案(A)
Q1:ReAct 和「普通 CoT 提示」有什么本质区别?
A: 普通 CoT 只在模型内部展开推理链,不强制与外部环境交互;ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。
Q2:ReAct 为什么要显式写出 Thought?
A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。在工程上,Thought 也帮助模型在下一步更稳定地选择 Action。
1.4 追问及应对
1.5 代码示例(Python,简化版 ReAct 循环)
代码块
Python
from dataclasses import dataclass
from typing import Callable, Dict, List, Tuple
@dataclass
class Tool:
name: str
run: Callable[[str], str]
def build_prompt(question: str, history: List[Tuple[str, str, str]], tool_names: str) -> str:
lines = [
"You solve tasks with tools. Use EXACTLY this format each turn:",
"Thought: ...",
f"Action: one of {tool_names}",
"Action Input: ...",
"Stop when you can answer:",
"Final Answer: ...",
"",
1.6 优缺点分析
优点
•
可解释:轨迹可读,便于调试与评测中间步骤。
•
接地:通过工具把答案锚定在可验证数据上。
•
通用:与具体工具解耦,易于替换搜索/代码/SQL 等。
缺点
•
多轮调用:成本高、延迟大。
•
格式脆弱:模型若偏离模板,需要解析器与重试策略。
•
规划能力有限:逐步贪心,复杂任务上可能缺「全局最优计划」(对比 Plan-and-Execute)。
1.7 与 Chain-of-Thought(CoT)的区别
一句话总结: CoT 让模型「更会想」;ReAct 让模型「在想的同时能动手,并用真实结果纠正自己」。
Plan-and-Execute 框架
2.1 概念解释(通俗易懂)
Plan-and-Execute 是 两阶段:先 制定计划(Planner),再 逐步执行(Executor)。像旅行前先列行程单,再按天去玩;执行中若发现「景点关门」,再 改行程(Re-planning)。
它与 ReAct 的差别可以记成:ReAct 常常是「走一步看一步」;Plan-and-Execute 先有一张「总蓝图」,再落地,适合步骤多、依赖关系清晰的任务。
2.2 原理详解(技术细节)
2.2.1 两阶段模式
代码块
Plain Text
输入任务
→ Planner:输出计划 P = [step1, step2, ...]
→ Executor:for each step:
执行(可调用工具/子 Agent)
更新状态 state
若失败或信息不足 → 触发 Re-planning
→ 输出最终结果
2.2.2 Planner 组件设计(要点)
•
输入:用户目标、约束(时间/预算/格式)、当前已知上下文。
•
输出:结构化计划(步骤列表、每步子目标、依赖、所需工具类型)。
•
技巧:计划 粒度适中;过细易 brittle,过粗难执行。
伪代码:
代码块
Plain Text
plan = LLM_planner(task, constraints)
validate_plan(plan) # 可选:检查是否包含非法步骤/循环依赖
2.2.3 Executor 组件设计(要点)
•
输入:当前步骤、state(已完成结果、中间变量)。
•
输出:步骤产物 + 新 state。
•
工具路由:每一步可选用不同工具(搜索、代码、数据库)。
伪代码:
代码块
Plain Text
state = {}
2.2.4 重规划(Re-planning)机制
触发条件常见有:
•
工具失败、返回空、超时;
•
Observation 与假设冲突;
•
新信息使原计划步骤多余或顺序错误。
Re-planning 做法:
•
局部修复:只替换失败步骤之后的子计划;
•
全局重规划:回到目标重新生成计划(成本高但更稳)。
代码块
Plain Text
2.3 面试问题(Q)+ 标准答案(A)
Q3:Plan-and-Execute 相比 ReAct 什么时候更占优?
A: 当任务 步骤多、结构清晰、需要全局分解(如多文件代码改动、数据分析流水线、复杂调研提纲)时,Planner 先给出路线图能减少「短视」;ReAct 更擅长 动态工具交互、逐步探索。
Q4:Re-planning 会不会导致「计划抖动」?怎么缓解?
A: 会。频繁重规划可能让执行轨迹不稳定。缓解方式包括:限制重规划次数、局部重规划优先、在 state 中保留已验证事实、对计划变更加 一致性检查(新旧计划差异说明)。
2.4 追问及应对
2.5 代码示例(Python,极简 Planner + Executor)
代码块
Python
from typing import Any, Dict, List
def plan(task: str, llm) -> List[str]:
prompt = f"""
Break the task into 3-7 concrete steps. Return ONE step per line.
Task: {task}
"""
text = llm(prompt)
2.6 与 ReAct 的对比与适用场景
适用场景小结:
•
ReAct:工具交互密集、环境反馈关键、路径不确定。
•
Plan-and-Execute:任务可分解、流程强、需要可审计的计划书。
Reflexion 框架
3.1 概念解释(通俗易懂)
Reflexion 的核心是:做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试。像考试做错后写错题本,而不是盲目刷同一道题。
它强调 语言化反思(自然语言反思条目),而不是只改参数;反思作为 记忆,影响后续尝试的策略。
3.2 原理详解(技术细节)
3.2.1 自我反思机制
典型角色分工(概念上):
•
Actor:生成行动/答案(可接工具)。
•
Evaluator:给反馈(对/错、评分、缺失项)。
•
Reflector:根据反馈写 反思文本(指出错误原因与改进策略)。
反思不是泛泛的「我要更仔细」,而是 可执行 的指导,例如:「应先确认单位换算」「应先检索最新数据而非凭记忆」。
3.2.2 反思记忆的存储与使用
常见存储形式:
•
短期:同一任务多轮尝试中维护 reflections: List[str]。
•
长期:写入向量库/键值库,按任务类型检索相似反思(进阶)。
使用方式:
代码块
Plain Text
attempt_k:
3.2.3 工作流程:Action → Evaluation → Reflection → Retry
代码块
Plain Text
初始化 reflections = []
repeat until success or max_trials:
Action: 基于任务 + reflections 生成输出(可含工具)
Evaluation: 规则/模型评估(可给二元成功或细粒度批评)
Reflection: 生成改进建议文本
将 reflection 追加到 memory
3.3 面试问题(Q)+ 标准答案(A)
Q5:Reflexion 和「让模型自己检查一遍」有什么不同?
A: 自检往往是一次性的;Reflexion 把评估与反思 显式化、结构化,并 跨尝试复用 反思文本,形成可累积的「策略记忆」。工程上更易控制与评测。
3.4 追问及应对
3.5 代码示例(Python)
代码块
Python
def reflexion_loop(task: str, actor, evaluator, reflector, max_trials: int = 3) -> str:
reflections: list[str] = []
for t in range(max_trials):
mem = "\n".join(f"- {r}" for r in reflections) or "(none)"
out = actor(f"Task: {task}\nReflections:\n{mem}\n")
score, feedback = evaluator(out) # 例如 (0.0~1.0, str)
if score >= 0.9:
return out
r = reflector(f"Output:\n{out}\nFeedback:\n{feedback}\nWrite concise lessons.")
reflections.append(r)
return out
3.6 适用场景
•
可验证任务:代码、数学、有测试用例的生成。
•
易犯系统性错误 的任务:格式、约束、工具选择。
•
预算允许多轮尝试 的场景(反思会增加调用次数)。
LATS(Language Agent Tree Search)
4.1 概念解释(通俗易懂)
LATS 把 Agent 的决策看成在 树 上搜索:每个节点是一种「状态/中间思路」,分支是不同行动。任务复杂、存在多条可能路径时,与其一次走到底,不如 探索多条路,用评估函数判断哪条路更有希望。
它常与 蒙特卡洛树搜索(MCTS) 思想结合:通过 选择—扩展—模拟—回传 在探索与利用之间折中,把「语言推理」嵌进搜索节点。
4.2 原理详解(技术细节)
4.2.1 树搜索 + Agent
•
节点:包含当前上下文、已执行动作历史、可选下一步。
•
边:一次 Thought/Action 或一个子目标步骤。
•
叶节点评估:是否完成任务、奖励分数、是否需继续扩展。
4.2.2 MCTS 思想(与 Agent 结合的直觉)
经典 MCTS 四步(可简化为面试版描述):
代码块
Plain Text
while budget remains:
Select: 从根沿策略选到叶(UCB 等平衡探索/利用)
Expand: 生成若干可能的下一步(语言分支)
Simulate/Rollout: 用启发式或模型快速评估结果潜力
Backpropagate: 把评估回报回传到路径上的节点统计量
在 LATS 中,「扩展」常由 LLM 生成多个候选行动;「模拟」可用更便宜模型或短 rollouts。
4.3 面试问题(Q)+ 标准答案(A)
Q6:LATS 相比单次 ReAct 多在哪里成本?换来什么收益?
A: 成本主要来自 多分支扩展 与 多次评估/模拟。收益是 更系统的探索,降低「一条路径走到黑」的局部最优风险,适合决策点多的任务。
4.4 追问及应对
4.5 代码示例(Python,极度简化的「多候选一步扩展」)
代码块
Python
import random
from typing import List
def expand_candidates(state: str, llm, k: int = 3) -> List[str]:
prompt = f"State:\n{state}\nPropose {k} distinct next actions (one line each)."
text = llm(prompt)
return [line.strip("- ") for line in text.splitlines() if line.strip()][:k]
def score_action(state: str, action: str, scorer) -> float:
return scorer(state, action) # 可用启发式或小型模型
def lats_one_step(state: str, llm, scorer) -> str:
cands = expand_candidates(state, llm, k=3)
4.6 适用于需要探索多条路径的复杂任务
•
策略游戏、规划 puzzle、代码修复(多方案补丁)。
•
研究型问题:需要先提出多种假设再验证。
LangChain Agent 实现
5.1 概念解释(通俗易懂)
LangChain 把 LLM、提示模板、工具、记忆、解析器等拼成可运行程序。Agent 在这里通常指:由 LLM 决定下一步调用哪个工具 的循环执行体;AgentExecutor 负责「跑这个循环直到结束」。
5.2 原理详解(技术细节)
5.2.1 LangChain 中与 Agent 相关的核心抽象(面试口径)
不同版本命名略有变化,但面试常考概念层:
•
Tools:对外部能力的封装(name、description、args schema、执行函数)。
•
LLM / ChatModel:生成下一步决策与内容。
•
Agent(推理策略):如何把工具、提示、中间步骤组合起来(ReAct、OpenAI tools 等)。
•
AgentExecutor:驱动循环:调用 Agent → 若有 tool_calls 则执行工具 → 回填消息 → 直到停止。
5.2.2 AgentExecutor 工作原理(流程)
代码块
Plain Text
inputs → AgentExecutor
loop:
agent.plan(messages/tools) -> next message / tool_calls
if final answer: return
else: run tools -> append tool messages
(optional) trim memory / handle parsing errors
关键点:停止条件(达到最终答案)、解析错误处理、最大迭代次数。
5.2.3 自定义 Agent 的步骤(通用 checklist)
定义 Tools(清晰 description 与 schema)。
选择 提示模板(ReAct JSON / OpenAI tool calling)。
选择 模型 与 输出解析器(防止格式漂移)。
组装 Agent + AgentExecutor(设置 max_iterations、handle_parsing_errors)。
评测与加固(日志、重试、工具超时)。
5.3 面试问题(Q)+ 标准答案(A)
Q7:LangChain 里 AgentExecutor 解决的核心问题是什么?
A: 把「模型决策 → 工具执行 → 结果回填 → 再决策」的 控制流 标准化,统一处理 迭代限制、错误处理、中间消息结构,让开发者专注工具与提示。
Q8:工具描述为什么重要?
A: Agent 依赖描述进行 工具选择;描述不清会导致错选工具或参数幻觉。应包含 用途、输入输出、边界条件、示例。
5.4 追问及应对
5.5 代码示例(Python,示意:以「工具调用风格」组织循环)
代码块
Python
# 示意代码:突出 AgentExecutor 的“循环本质”
def simple_agent_executor(llm, tools, user_input: str, max_iterations: int = 5):
messages = [{"role": "user", "content": user_input}]
for _ in range(max_iterations):
resp = llm.chat(messages, tools=tools) # 伪 API
if resp.final_text and not resp.tool_calls:
return resp.final_text
for call in resp.tool_calls:
name = call.name
LangGraph 状态机
6.1 概念解释(通俗易懂)
如果把 LangChain Agent 看成「一套默认的循环」,LangGraph 则是把 Agent 工作流画成 图:节点是处理步骤(调用模型、调工具、审核),边是流转关系。复杂业务往往需要分支、循环、人工确认——用图更直观。
6.2 原理详解(技术细节)
6.2.1 基于图的 Agent 编排
•
Graph / StateGraph:节点函数读取共享 state,返回 state 更新。
•
编排优势:显式控制 并行、条件分支、回退、人机协同。
6.2.2 节点(Node)和边(Edge)
•
Node:state -> partial_state_update。
•
Edge:A -> B 表示执行完 A 后执行 B。
6.2.3 条件边(Conditional Edge)
根据 state 决定下一步去哪个节点,例如:
代码块
Plain Text
if needs_human_review(state): goto human
elif tool_error(state): goto repair
else: goto continue
6.2.4 状态管理
•
通常定义 TypedDict 或 dataclass 描述 state schema。
•
多个节点可 增量合并 更新(reducer),避免全局覆盖冲突(具体机制依实现)。
6.2.5 与 LangChain Agent 的区别(面试高频)
6.3 面试问题(Q)+ 标准答案(A)
Q9:什么时候选 LangGraph 而不是 AgentExecutor?
A: 当流程不是「单一工具循环」,而是需要 多阶段流水线、条件路由、回环修复、人工审核节点、并行任务 时,用图编排更清晰可维护。
Q10:LangGraph 的状态更新为什么要谨慎设计?
A: 多节点写入同一字段可能冲突;需要 schema 约束、归约策略(append vs replace)、明确每个节点的写入职责。
6.4 追问及应对
6.5 代码示例(Python,最小状态机草图)
代码块
Python
from typing import TypedDict, Literal
class AgentState(TypedDict):
task: str
notes: str
route: str
def planner_node(state: AgentState) -> AgentState:
return {**state, "notes": "plan: step1...", "route": "exec"}
def exec_node(state: AgentState) -> AgentState:
return {**state, "notes": state["notes"] + " | executed", "route": "end"}
AutoGen / CrewAI 等多 Agent 框架
7.1 概念解释(通俗易懂)
多 Agent 框架把任务拆给多个「角色」:有人负责写代码,有人负责审查,有人负责检索。它们通过 对话 或 结构化消息 协作。AutoGen 偏 可编程的对话与工具;CrewAI 偏 角色驱动的团队流程(Crew)。
7.2 原理详解(技术细节)
7.2.1 核心设计理念
•
分权:降低单模型负载,让角色专注子任务。
•
对抗/互补:审查者发现生成者问题,提高质量。
•
可组合:工作流可由对话路由或 DAG/图编排。
7.2.2 角色定义与对话
•
角色(Role):system prompt + 工具权限 + 目标。
•
对话拓扑:一对一、群聊、星型(manager)、分层。
极简伪代码:
代码块
Plain Text
agents = [Researcher, Writer, Reviewer]
for round in 1..N:
msg = Researcher.step(thread)
msg = Writer.step(thread)
msg = Reviewer.step(thread)
if Reviewer.approved: break
7.2.3 适用场景
•
内容生产流水线(调研→写作→校对)。
•
软件工程(需求→设计→实现→Code review)。
•
需要 强分工 与 过程质量控制 的组织化任务。
7.3 面试问题(Q)+ 标准答案(A)
Q11:多 Agent 一定比单 Agent 更强吗?
A: 不一定。更多 Agent 可能带来 协调成本、错误级联、对话冗长。当任务可清晰分工且有评估机制时收益大;否则单 Agent + 强工具可能更简单高效。
Q12:如何避免多 Agent「互相附和」?
A: 引入 独立审查角色、基于规则的检查、外部工具验证(测试、检索),并明确 停止条件 与 异议处理流程。
7.4 追问及应对
7.5 代码示例(Python,概念演示:多角色轮询)
代码块
Python
def run_crew(task: str, roles: dict, llm, rounds: int = 2) -> str:
模块综合:15+ 道高频面试题速查
下列题目覆盖全模块,可在复习时自问自答;每题后附 标准答法要点。
Q13:请用一句话解释 ReAct。
A: 让模型交替输出推理与可执行行动,并用工具返回的 Observation 闭环纠错,从而把推理接地到外部环境。
Q14:ReAct 轨迹里,哪一部分必须由系统生成?为什么?
A: Observation 必须由工具/环境生成,防止模型伪造证据导致「看似合理但错误」的答案。
Q15:Plan-and-Execute 的最大风险是什么?如何缓解?
A: 风险是 错误计划污染全局;缓解是 可验证子步骤、重规划、强 Planner 约束输出 与 执行期监控。
Q16:Reflexion 的关键产出是什么?它如何提升下一轮?
A: 关键是 高质量反思文本;它作为记忆进入下一轮提示,指导 Actor 改变策略而非重复错误。
Q17:LATS 与 ReAct 在「探索能力」上如何对比?
A: ReAct 通常主路径贪心推进;LATS/MCTS 通过 多分支搜索与价值回传 更系统探索决策空间(成本更高)。
Q18:LangChain AgentExecutor 中为什么要限制 max_iterations?
A: 防止工具循环、解析失败导致的 无限循环,并控制成本与延迟。
Q19:描述 LangGraph 的条件边解决的业务问题。
A: 根据中间状态动态路由,例如失败重试、需要人工审核、不同客户等级走不同流程。
Q20:什么时候更建议「单 Agent + 强工具」,而不是多 Agent?
A: 任务边界清晰、无需组织化分工、协调成本可能大于收益时;或延迟/成本敏感场景。
Q21:多 Agent 系统的「评估器」可以有哪些实现?
A: 单元测试/静态规则、更强模型评审、人工审核节点、外部检索核对事实等。
Q22:ReAct Prompt 为什么要给 few-shot 示例?
A: 提升模型对 固定格式 的遵从度,降低解析失败率,稳定工具调用。
Q23:Re-planning 与 Reflexion 都「改正错误」,区别是什么?
A: Re-planning 偏 计划结构 的调整(下一步怎么走);Reflexion 偏 策略/经验 的语言化总结并跨轮复用。
Q24:LangGraph 相比普通脚本编排的核心收益?
A: 把流程 显式化 为图,分支/回环/人机节点一等公民,更易维护与观测。
Q25:如果工具返回噪声很大,ReAct 可能出什么问题?怎么改进?
A: 模型可能被噪声误导;改进包括 工具侧清洗/结构化输出、二次检索、在 Thought 里强制 引用证据片段、增加 校验工具。
Q26:你如何为一个企业场景选择 ReAct vs Plan-and-Execute?
A: 看任务是否 强流程、是否需要 可审计计划书、是否允许 前期规划成本;需要强工具交互与动态环境用 ReAct,强分解与多步骤交付用 Plan-and-Execute。
Q27:为什么说「工具描述」是 Agent 的接口设计?
A: LLM 靠描述做路由与填参;描述就是 人机接口,直接影响成功率。