RAG 技术(面试八股文 · 模块三)
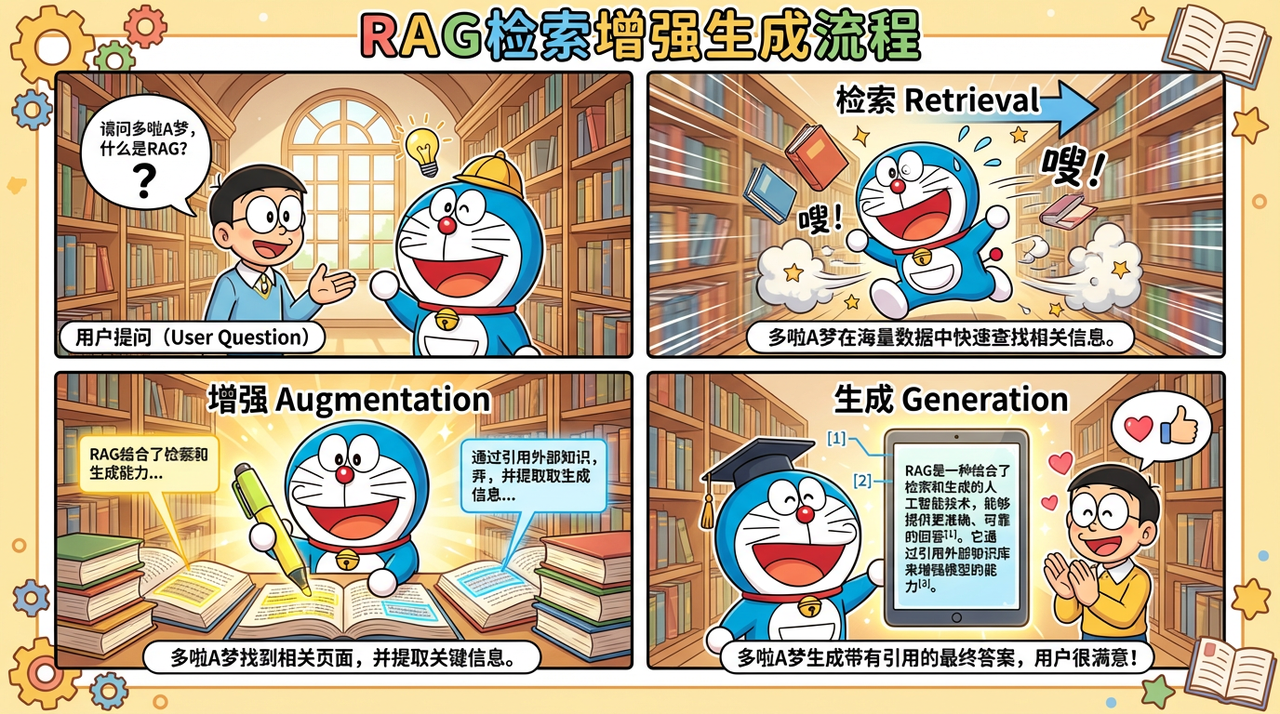
面向初学者的系统梳理:每个主题尽量包含 概念、原理、面试问答、追问应对 与 Python 代码示例。
建议配合动手实验:同一批文档,对比「仅向量 / 混合检索 / +重排」的答案质量差异。
目录
检索策略
RAG 基础
1.1 RAG(Retrieval-Augmented Generation)定义与原理
概念解释
RAG(检索增强生成)指:在让大语言模型(LLM)生成答案 之前,先从 外部知识库(文档、数据库、网页等)中 检索 与用户问题相关的片段,再把这些片段作为 上下文 一并输入模型,从而 约束 模型的输出依据。
原理详解
离线阶段:把原始文档解析、清洗、分块 → 用 Embedding 模型转成向量 → 存入向量索引(或配合关键词索引)。
在线阶段:用户提问 →(可选)查询改写 → 检索 Top-K 相关块 →(可选)重排序 → 将块拼进 Prompt → LLM 基于「问题 + 检索上下文」生成答案。
核心思想:把「记忆」从模型参数里搬到「可更新的外部存储」,生成时按需取用。
面试 Q1:请用一句话解释 RAG。
标准答案 A: RAG 是在生成前先从外部知识库检索相关证据,再把证据作为上下文交给大模型,以减少幻觉并支持实时更新的知识增强范式。
追问应对
•
问:RAG 和「把文档全文塞进 Prompt」有什么区别?
答: 全文往往超长、噪声大、成本高;RAG 通过检索只取 最相关的一小部分,在 效果、延迟、费用 上更可控,也更适合大规模知识库。
1.2 为什么需要 RAG(知识截止、幻觉、实时性)
概念解释
•
知识截止(Knowledge Cutoff):预训练/基座模型只在某个时间点之前的数据上学习,之后发生的事实它「天然不知道」。
•
幻觉(Hallucination):模型在缺乏依据时仍会「编得像真的」。
•
实时性:业务数据(工单、库存、政策)每分钟都在变,仅靠静态模型参数无法反映。
原理详解
RAG 通过 可检索的外部证据 提供「当下可查」的依据,让模型 少凭空捏造;同时索引可 增量更新,不必频繁全量微调模型。
面试 Q2:为什么企业落地常选 RAG 而不是只靠更大的基座模型?
标准答案 A: 大模型再强也有知识截止与领域盲区;企业私域数据往往不能用于预训练。RAG 把私域知识以索引形式接入,可审计、可更新,并在同样上下文窗口下聚焦 高相关片段,性价比更高。
追问应对
•
问:RAG 能完全消除幻觉吗?
答: 不能。若检索错、块质量差、或模型忽略证据,仍可能幻觉。需要检索、重排、引用约束、评估与人工审核配合。
1.3 RAG vs 微调 vs 长上下文 的对比
原理简述
三者不是互斥:常见做法是 RAG 提供事实依据 + 轻量微调改善领域表达 + 长上下文处理单篇超长材料。
面试 Q3:什么时候优先微调而不是 RAG?
标准答案 A: 当目标主要是 行为与格式(如输出 JSON、口吻、工具调用习惯),或训练数据 稳定且可标注,而不仅是「塞事实」;事实类仍建议 RAG 或可检索记忆。
1.4 Native RAG 完整流程图(文字描述)
可用以下 自上而下 的文字流程在面试中口述:
面试 Q4:离线与在线的职责分别是什么?
标准答案 A: 离线负责 把非结构化知识变成可检索的索引(解析、分块、向量化、建索引、更新);在线负责 理解用户意图、检索、融合、约束生成,并保证延迟与成本可控。
1.5 代码示例:最小 RAG 流水线(概念级)
下面用 伪代码级 展示「嵌入 + 向量库 + 调用 LLM」的最小闭环(实际项目请替换为真实 API Key 与错误处理)。
代码块
Python
# 最小概念示例:Embedding + 向量检索 + LLM(需安装 openai 等依赖)
from typing import List
def embed_texts(texts: List[str], model: str = "text-embedding-3-small") -> List[List[float]]:
说明: 生产环境应对 chunks 批量嵌入并缓存;检索应用 ANN 索引(见第 5 节),不要暴力两两算相似度。
文档解析与预处理
2.1 PDF、Word、HTML、Markdown 解析工具
概念解释
解析是把 二进制或标记格式 变成 可切分的纯文本(并尽量保留标题层级、表格位置等结构信息)。
常见工具
表格加载中...
原理详解
PDF 本质是 排版指令,不是「自然段落」;同一页可能多栏、页眉页脚会混入。解析后要 按逻辑顺序 重组,否则分块会乱序。
面试 Q5:PDF 解析常见坑有哪些?
标准答案 A:
1)扫描件无文本层,必须 OCR;
2)多栏、脚注、页码混入正文;
3)表格被拆成无序碎片;
4)字体编码异常导致乱码。
对策:版面分析(layout)、表格专用解析、人工抽检与清洗规则。
追问应对
•
问:为什么很多团队推荐 Unstructured?
答: 它把文档分成带类型的元素(Title、NarrativeText、Table 等),便于 按结构分块 和后续路由(表格走表格策略)。
2.2 OCR 处理
概念解释
OCR(光学字符识别)把 图像中的文字 变成可检索文本,用于扫描 PDF、拍照、截图。
原理简述
典型流程:图像预处理(纠偏、二值化)→ 文字检测(框出文本行)→ 识别(CRNN/Transformer)→ 后处理(词典纠错)。
常用方案
•
云服务:Azure Document Intelligence、Google Document AI、阿里云 OCR
•
开源:Tesseract、PaddleOCR(中文友好)、EasyOCR
面试 Q6:OCR 结果对 RAG 有什么影响?
标准答案 A: OCR 会引入错字、断行、丢标点,导致 检索词不匹配 与 embedding 语义偏移。需要在清洗阶段做规范化,并考虑 关键词 + 向量混合检索 提高鲁棒性。
2.3 表格和图片的处理策略
概念解释
•
表格:结构化信息密集,拆成纯文本易丢行列关系。
•
图片:含流程图、架构图时,纯 OCR 往往不够,需要 多模态模型 生成描述。
策略
表格:保留为 Markdown/HTML 表格字符串;或转为 JSON 行记录 存两份索引(自然语言版 + 结构化版)。
图片:用 Caption 模型(如 BLIP、多模态大模型)生成描述文本再入库;或对关键图做 人工标注。
图文混排:按阅读顺序拼接「图注 + OCR/Caption + 相邻段落」为一个块或父子块。
面试 Q7:表格为什么难做 RAG?
标准答案 A: 表格语义依赖 行列关系 与 表头;固定长度切分易切断行列。应用 表头感知分块、SQL/结构化检索 或 专用表格问答模型 辅助。
2.4 数据清洗与标准化
要点清单
•
统一编码(UTF-8)、去除不可见字符
•
合并多余空白与断行
•
全角半角、数字与单位格式统一
•
去重(MinHash/SimHash 或 embedding 聚类)
•
PII 脱敏(电话、身份证)按合规要求
代码示例:基础清洗
代码块
Python
import re
import unicodedata
代码示例:PyPDF / Unstructured(按需安装:pip install pypdf unstructured)
代码块
Python
# --- 方式 A:pypdf 读取纯文本 PDF ---
from pypdf import PdfReader
def extract_pdf_pypdf(path: str) -> str:
reader = PdfReader(path)
parts = []
for page in reader.pages:
parts.append(page.extract_text() or "")
return normalize_text("\n".join(parts))
追问应对
•
问:Apache Tika 在 Python 里怎么用?
答: 常见做法是 Java 起 Tika Server,Python 用 HTTP 调用;或在 JVM 服务内解析后把文本推给 Python 流水线。适合已有 Java 中间件、需统一解析多种 Office 格式的企业。
文档分块策略(Chunking)
3.1 固定长度分块(Fixed Size)
概念解释
按字符数或 token 数切分,例如每 512 字符一块,简单高效。
原理与缺陷
实现简单,但常在 句子中间 切断,语义不完整;对代码、Markdown 结构不友好。
3.2 递归字符分割(RecursiveCharacterTextSplitter)
概念解释
LangChain 中常见:按 分隔符优先级 递归切分,例如 ["\n\n", "\n", " ", ""],尽量在段落、句子边界断开。
原理
先找高优先级分隔符;若块仍超长,再用下一级分隔符切,直到满足 chunk_size,并用 chunk_overlap 保留上下文衔接。
3.3 语义分块(Semantic Chunking)
概念解释
按 语义相似度变化 切分:相邻句子/段落嵌入向量,若相似度骤降则认为话题转换,在此处断开。
原理
更贴近「话题边界」,但 计算成本高,需设定阈值与最小块长度,避免过碎。
3.4 按文档结构分块(Markdown Header、HTML Section)
概念解释
利用 # 标题 或 HTML 的
原理
保证块内主题一致;检索命中时可返回 完整小节。
3.5 滑动窗口分块
概念解释
以窗口长度 (W) 和步长 (S)((S < W))滑动切分,相邻窗口重叠 (W-S)。
原理
减少边界信息丢失;代价是 存储膨胀 与 冗余检索,常配合去重或 MMR。
3.6 chunk_size 与 chunk_overlap 选择策略
经验法则(需实测)
•
chunk_size:应覆盖 完整命题(一条规定、一个步骤),常见几百到一两千 token 量级;太小上下文不足,太大噪声多。
•
chunk_overlap:通常为 size 的 10%–20%,避免切断关键句;overlap 越大,索引越大。
•
以评估为准:同一数据集扫网格,看 召回率与答案质量。
面试 Q8:分块太大或太小分别会怎样?
标准答案 A: 太小 → 语义不完整、检索片段缺主语或条件;太大 → 混入无关内容、噪声干扰生成、embedding 语义模糊、费用上升。
3.7 父子文档分块(Parent-Child Chunking)
概念解释
子块(小,用于检索embedding)+ 父块(大,用于喂给 LLM),检索命中子块后取回其父块全文。
原理
兼顾 检索精度(细粒度匹配)与 生成上下文完整性(父块提供更多句子)。
面试 Q8a:父子块在向量库里怎么建索引?
标准答案 A: 仅对 子块 写入向量与 child_id;元数据中存 parent_id 与父块全文或父块存储路径。检索命中子块后,用 parent_id 取父块 拼进 Prompt。若父块过长,可对父块再 摘要 后送入。
代码示例:父子块数据结构(最小示意)
代码块
Python
from dataclasses import dataclass
from typing import List
@dataclass
class ParentChunk:
parent_id: str
text: str
children: List["ChildChunk"]
3.8 代码示例:LangChain 各种 TextSplitter
需安装:pip install langchain langchain-text-splitters
代码块
Python
from langchain_text_splitters import (
CharacterTextSplitter,
RecursiveCharacterTextSplitter,
MarkdownHeaderTextSplitter,
)
追问应对
•
问:为什么生产常用 Recursive 而不是 Fixed?
答: Recursive 尽量在 自然边界 断开,减少半句半段,提高检索与阅读连贯性。
向量化(Embedding)
4.1 什么是文本嵌入(Embedding)
概念解释
Embedding 把离散文本映射为 固定维度的稠密向量,语义相近的文本在向量空间中 距离更近(常用余弦相似度或内积)。
原理详解
训练目标多为 对比学习:同义句拉近、无关句推远。下游用向量近似 语义检索。
4.2 常用 Embedding 模型
4.3 Embedding 模型选型标准
语言与领域:中文优先中文强化模型;医疗/法律可看领域微调版。
序列长度:长文档需更长上下文 embedding 或先分段再聚合。
许可证与部署:云端 API vs 私有化。
与重排/生成模型一致性:有时同一厂商链路更省心(非必须)。
4.4 维度、速度、效果的权衡
•
维度高:通常表达能力更强,但索引更大、ANN 更慢。
•
速度:批量推理、GPU、量化(INT8)可加速。
•
效果:以 检索召回@K 与 端到端问答 为准。
面试 Q9:同一个 Embedding 用于中英文混合文档要注意什么?
标准答案 A: 选 多语言模型 或分别建索引;单语模型可能导致跨语言语义空间不一致。混合检索(BM25)可补关键词。
代码示例:sentence-transformers(本地 BGE)
代码块
Python
# pip install sentence-transformers
from sentence_transformers import SentenceTransformer
model = SentenceTransformer("BAAI/bge-large-zh-v1.5")
sentences = ["RAG 检索增强生成", "大模型需要外部知识库"]
emb = model.encode(sentences, normalize_embeddings=True) # 归一化后余弦=点积
print(emb.shape) # (2, dim)
向量数据库
5.1 什么是向量数据库
概念解释
面向 高维向量 的存储与 近似最近邻(ANN) 查询系统,支持 insert/delete/query,常附带元数据过滤(时间、租户、标签)。
原理
暴力精确检索在高维下不可行;用 ANN 算法 换 略微精度 换 数量级加速。
5.2 主流选型对比
面试 Q10:FAISS 和 Milvus 本质区别?
标准答案 A: FAISS 是 ANN 算法库,需自建存储、服务、容灾;Milvus 是 向量数据库系统,提供分布式存储、运维能力与数据管理接口。
5.3 ANN 算法:HNSW、IVF、PQ
•
HNSW(分层导航小世界图):图索引,查询延迟低,内存占用偏高;高召回常用。
•
IVF(倒排文件):聚类划分桶,查询只搜部分桶;需训练,适合大规模。
•
PQ(乘积量化):向量压缩,省内存、加速距离计算;有损,精度略降。
面试 Q5a:HNSW 与 IVF 如何取舍?
标准答案 A: 数据量 中等、追求低延迟高召回、内存可接受时优先 HNSW;数据量 极大、内存紧张、可接受离线训练与调参时考虑 IVF(常与 PQ 组合)。实际要在 召回率、QPS、内存、建索引时间 上做压测。
追问应对
•
问:efSearch 调大有什么效果?
答: HNSW 查询时访问更多邻居,召回上升、延迟上升;需在精度与 SLA 间折中。
5.4 索引选择策略
数据量小、要简单:HNSW + 精确参数调优。
数据量大、内存紧:IVF + PQ 组合(如 IVF_PQ)。
要磁盘级大规模:DiskANN 类方案(视产品支持)。
强过滤:选对 元数据索引友好 的实现(Qdrant、Milvus 过滤能力强)。
代码示例:FAISS + sentence-transformers(最小示例)
代码块
Python
import faiss
import numpy as np
from sentence_transformers import SentenceTransformer
model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
texts = ["条款A", "条款B", "无关内容C"]
检索策略
6.1 向量检索(语义相似度)
概念解释
Query 与文档块 embedding 后做 Top-K 最近邻。
短板
专有名词、型号、编号等 精确匹配 不如关键词检索。
6.2 关键词检索(BM25)
概念解释
BM25 是经典 词频-逆文档频率 加权排序函数,擅长 精确词匹配。
6.3 混合检索(Hybrid Search)
概念解释
BM25 分数 + 向量分数 线性加权或归一化后融合,兼顾语义与字面。
代码思路(概念)
代码块
Python
def min_max_norm(scores):
s_min, s_max = min(scores), max(scores)
if s_max == s_min:
return [1.0 for _ in scores]
6.4 多路检索与结果融合(RRF)
概念解释
RRF(Reciprocal Rank Fusion):不依赖原始分数尺度,把多路检索的 排名 融合:
(\text{RRF}(d) = \sum_r \frac{1}{k + \text{rank}_r(d)}),常取 (k=60)。
原理
各路检索分数不可比时,RRF 更稳健。
面试 Q11:为什么混合检索比单路向量更有效?
标准答案 A: 向量捕获语义,但可能漏掉 专有名词与编号;BM25 补精确匹配。二者融合提高鲁棒性,尤其在技术文档与电商场景。
面试 Q11a:RRF 与加权分数融合各适合什么?
标准答案 A: 当两路分数 量纲一致或已可靠归一化 时,加权融合直观可调;当一路是 排名、一路是 概率、或分数 不可比 时,RRF 更稳,且少调参(经典 (k=60))。
代码示例:RRF 多路排名融合
代码块
Python
from typing import Dict, List, Sequence
def rrf_fuse(
ranked_lists: Sequence[Sequence[str]],
k: int = 60,
) -> List[tuple[str, float]]:
"""ranked_lists: 多路检索结果,每路为 doc_id 从优到劣的列表。"""
scores: Dict[str, float] = {}
for ranks in ranked_lists:
for rank, doc_id in enumerate(ranks, start=1):
scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
return sorted(scores.items(), key=lambda x: x[1], reverse=True)
6.5 查询改写(Query Rewriting)
概念解释
把用户原始问句改写成 更易被检索匹配 的形式,或生成 多条查询变体 做多路召回。
原理详解
口语与文档书面语不一致(「咋办」vs「处理流程」);改写可 对齐术语。可用规则、同义词表,或用 LLM 生成「检索专用 Query」。
策略
•
同义扩展、拆问句、补全主语
•
用 LLM 生成 检索友好 的 query 变体多条,多路检索再融合
面试 Q11b:查询改写会不会引入噪声?
标准答案 A: 会。LLM 可能 篡改实体 或 添加未提及条件。对策:多路检索 + RRF、重排、引用校验,高敏场景用 人工词表 + 模板 优先。
追问应对
•
问:需要保留原 Query 吗?
答: 需要。常 原句 + 改写句 同时检索再融合,避免改写跑偏。
6.6 HyDE(假设文档嵌入)
概念解释
让 LLM 先写 假想的答案文档(可能含错),再对假想文档做 embedding 去检索。
原理
拉近查询与文档在向量空间的距离,缓解 查询与文档表述风格不一致。
风险
假想文档可能引入错误主题,需 重排与引用校验。
6.7 子问题分解
概念解释
对 多跳、多条件 问题,先由 LLM 或规则拆成 子问题序列,对每个子问题检索,再 拼接或图式合并 证据。
原理详解
单句 embedding 难以覆盖「先 A 再 B」的复合语义;分解后每步检索更 聚焦,类似 多步检索增强。
面试 Q11c:子问题分解的典型失败模式?
标准答案 A: 分解错误(实体指代错)、子问题遗漏约束、或 合并时矛盾未检测。需要 一致性检查 与 重排 过滤无关块。
追问应对
•
问:和 Agent 多步检索有什么区别?
答: 子问题分解可以是 固定模板/一次 LLM 调用;Agentic 更强调 动态决定是否再检索,工具边界更宽。
6.8 Step-back Prompting
概念解释
先让模型生成 更抽象的后退一步的问题(背景原理),再并行检索「具体问题 + 抽象问题」,合并上下文。
原理
补充 背景知识,减少只抓到细枝末节的可能。
面试 Q12:HyDE 适合什么场景?不适合什么?
标准答案 A: 适合 表述差距大、短查询难对齐长文档;不适合 强事实约束 且模型易胡编的领域,除非加强校验与拒答。
面试 Q12a:Step-back Prompting 与 HyDE 有何异同?
标准答案 A: 二者都试图 拉近查询与文档的语义距离。HyDE 用 假想答案文档 做 embedding;Step-back 用 更抽象的问题 再检索 原理/背景类 段落。HyDE 更激进(易引入虚构事实),Step-back 相对 克制(仍停留在问题空间)。实践中可 并行检索 后由重排裁决。
代码示例:Step-back(两次检索拼上下文,示意)
代码块
Python
重排序(Reranking)
7.1 为什么需要重排序
概念解释
向量检索(Bi-Encoder)为速度对 query-doc 独立编码,交互信息不足;Cross-Encoder 把 query 与 doc 拼在一起 打分,精度更高但慢,故放在 Top-K 之后做小范围重排。
7.2 Cross-Encoder vs Bi-Encoder
7.3 常用重排序模型
•
Cohere Rerank API
•
BGE Reranker(如 bge-reranker-large)开源可本地部署
7.4 MMR(最大边际相关性)
概念解释
在相关性与 多样性 间权衡,避免 Top-K 几乎重复的段落:迭代选择与 query 相关、但与已选集合 冗余度低 的文档。
原理简述
设已选集合 (S),候选 (d),MMR 常写作:
(\text{MMR} = \arg\max_d [\lambda \cdot \text{sim}(q,d) - (1-\lambda)\cdot \max_{s\in S}\text{sim}(d,s)])。
(\lambda) 大则偏 相关,小则偏 多样。
面试 Q13:重排放在检索后哪一步?
标准答案 A: 一般在 召回 Top-K(几十到几百)→ Cross-Encoder 精排取 Top-N(3–10)→ 再生成,平衡延迟与效果。
代码示例:MMR 贪心选择(向量已归一化时 sim 可用点积)
代码块
Python
import numpy as np
def mmr_select(query_vec: np.ndarray, doc_vecs: np.ndarray, top_k: int, lambda_mult: float = 0.5):
代码示例:CrossEncoder 重排(sentence-transformers)
代码块
Python
from sentence_transformers import CrossEncoder
cross = CrossEncoder("BAAI/bge-reranker-base")
query = "员工年假天数"
docs = ["本公司年假为15天...", "报销应提交发票原件..."]
pairs = [[query, d] for d in docs]
scores = cross.predict(pairs)
ranked = sorted(zip(scores, docs), key=lambda x: x[0], reverse=True)
print(ranked)
RAG 高级模式
8.1 GraphRAG(基于知识图谱的 RAG)
概念解释
从文本抽取 实体与关系 构建图,检索时沿 子图 或 社区摘要 获取证据,适合 多跳关系 与 全局问题(「整体主题是什么」)。
对比普通 RAG
普通向量 RAG 擅 局部相似块;GraphRAG 强化 关系推理与全局聚合(微软 GraphRAG 等工作)。
8.2 Agentic RAG(Agent 驱动的 RAG)
概念解释
由 Agent 决定何时检索、检索什么、是否再检索,可调用 多工具(搜索、数据库、代码执行)。
原理
把 RAG 从「一次检索」变为 多步决策循环,适合复杂任务。
8.3 Self-RAG(自我反思的 RAG)
概念解释
模型在生成过程中插入 反思 token:是否需要检索、检索内容是否有用、生成是否支持等,形成 自我批评与修正 循环。
8.4 Corrective RAG(纠正性 RAG)
概念解释
当检索质量 不达标 时,触发 额外检索(如网页搜索)或 改写查询,纠正证据不足。
8.5 Adaptive RAG
概念解释
按问题类型 路由 到不同链路:有的只需单跳向量检索,有的需多跳或工具,避免 过度检索 浪费成本。
原理详解
常见实现:用 轻量分类器 或 小模型 判断「需不需要检索 / 需要 SQL 还是文档 / 是否需要多跳」,再 分发 到不同子管道;与 Agentic RAG 的边界在于:Adaptive 强调 路由策略,Agentic 强调 循环决策与工具调用。
面试 Q14:GraphRAG 的成本与挑战?
标准答案 A: 构图与抽取 成本高、抽取错误会污染图;运维复杂。适合关系密集、愿意投入工程化的场景。
面试 Q14a:Agentic RAG 与 Self-RAG 有什么共同点?
标准答案 A: 都引入 多步决策与反思;区别在于 Agentic 常外显为 工具调用与规划,Self-RAG 用 反思 token/标签 把「要不要检索、证据是否支持」内嵌在生成格式中,更偏 训练与解码策略。
面试 Q14b:Corrective RAG 典型触发信号?
标准答案 A: 检索置信度低(Top1 与 Top2 差距小)、检索结果与问题实体不一致、重排后仍低分、或 生成与引用冲突(可做一致性检测)。触发后执行 查询改写、换索引源、或联网搜索。
面试 Q14c:Adaptive RAG 如何避免路由误判?
标准答案 A: 混合路由(并行短路与完整链路)、置信度阈值 + 默认安全策略(不确定则走更强检索)、持续用 线上反馈 迭代分类器。
追问应对
•
问:小公司是否值得上 GraphRAG?
答: 若数据以 说明文、FAQ 为主,向量 RAG + 混合检索 + 重排 通常足够;图适合 关系问题占比高 且团队有 图谱与评测 能力时再投入。
RAG 评估
9.1 评估指标:忠实度、相关性、答案正确性
•
忠实度(Faithfulness):答案是否可由检索上下文推出,不编造。
•
上下文相关性(Context Relevance):检索块与问题是否相关。
•
答案正确性 / 有用性:是否真正解决问题(可用人工或强模型裁判)。
9.2 RAGAS 框架
概念解释
RAGAS 提供一组 基于 LLM 的指标(如 faithfulness、answer relevancy、context precision/recall),自动化评估 RAG 管道。
使用注意
裁判模型本身有偏差,应 抽样人工复核。
9.3 评估数据集构建
从真实日志 脱敏 抽样问题
标注 标准答案 或 支持文档 ID
覆盖 简单事实、多跳、拒答、无答案 等类型
面试 Q15:为什么说「只看最终答案对错」不够?
标准答案 A: 可能 猜对 或 上下文不相关仍生成;需同时评 检索质量 与 忠实度,定位瓶颈在检索还是生成。
代码示例:RAGAS 最小调用形态(示意)
代码块
Python
# pip install ragas datasets
# 以下为结构示意,版本差异请以官方文档为准
from ragas import evaluate
RAG 生产优化
10.1 索引优化
•
选择合适的 ANN 参数(HNSW 的 M、efConstruction、efSearch)
•
分段分区(按租户、时间、产品线)减少搜索空间
•
定期重建 vs 增量插入 权衡
10.2 缓存策略
•
Query 级缓存:相同问题直接返回答案(注意权限与 TTL)
•
Embedding 缓存:热门 query 的向量
•
LLM 响应缓存:对低敏场景可缩短延迟
10.3 增量更新
•
文档变更 版本化;删除旧向量 按 doc_id
•
大批量用 离线任务 重建分区索引,小批量 实时 upsert
10.4 多租户设计
•
逻辑隔离:tenant_id 元数据强制过滤
•
物理隔离:大客户独立集群或命名空间
•
配额与限流:按租户限制 QPS 与存储
10.5 Token 成本控制
•
控制 检索条数与块长度
•
选用 更小上下文模型 做摘要与路由
•
压缩检索结果(抽取句子级证据再喂给主模型)
面试 Q16:多租户下最常见的安全事故是什么?
标准答案 A: 检索 未带租户过滤 导致 跨租户数据泄露;必须在数据库层与查询层 双重校验。
综合面试题库(20+ 题)
下列每题均可作为「概念 + 落地」题;追问应对 见各节括号提示。
Q1:简述 RAG 两步流水线(离线与在线)。
A: 离线:解析→清洗→分块→嵌入→建索引;在线:Query(可选改写)→检索→(可选重排)→拼 Prompt→生成。追问:增量更新怎么做?(见 10.3)
Q2:RAG 与微调如何配合?
A: 微调改善 格式与领域表达,RAG 提供 可更新事实;事实类优先 RAG。追问:何时单独微调?(数据稳定且任务行为化)
Q3:为什么需要 chunk_overlap?
A: 防止关键句被切断在两块边界,检索时丢上下文;代价是存储增加。
Q4:RecursiveCharacterTextSplitter 的分隔符顺序为什么重要?
A: 优先在更大语义单元(段落)断开,再退到句子、空格,减少碎片化。
Q5:语义分块比递归分块更好吗?
A: 不一定;语义分块成本高、阈值敏感。应用数据 A/B 测试。
Q6:父子文档如何存储?
A: 子块带 parent_id,检索子块→映射父块文本再生成。
Q7:Embedding 是否需要归一化?
A: 若用 内积/余弦 且框架假设归一化向量,应归一化以稳定相似度。
Q8:FAISS IndexFlatIP 与 IndexHNSW 区别?
A: Flat 精确但慢;HNSW 近似快,适合大规模。
Q9:混合检索权重 alpha 怎么定?
A: 验证集网格搜索;或 RRF 避免调权。
Q10:RRF 为什么鲁棒?
A: 只用排名融合,规避不同路分数尺度问题。
Q11:HyDE 的风险如何缓解?
A: 重排序、引用约束、拒答、对比多条检索结果。
Q12:BM25 在中文要不要分词?
A: 依赖引擎;中文常需 分词或 n-gram,否则粒度不当影响效果。
Q13:Cross-Encoder 为何不能替代向量索引?
A: 需对 每个 doc 与 query 运行,复杂度高,无法对百万级全库实时扫描。
Q14:MMR 的 lambda 参数含义?
A: 调节 相关性 vs 多样性;lambda 大更偏相关。
Q15:GraphRAG 解决普通 RAG 的什么痛点?
A: 多跳关系与部分 全局聚合类 问题。
Q16:Agentic RAG 与一次性 RAG 差异?
A: 多步工具决策与再检索,更灵活更高成本。
Q17:Self-RAG 核心思想?
A: 生成中 自我评估 是否需要检索与证据是否充分。
Q18:Corrective RAG 触发条件?
A: 检索置信度低或证据矛盾时 改查或换源。
Q19:RAGAS 的局限?
A: 依赖裁判模型,可能有 偏好与盲区。
Q20:如何做低成本在线评估?
A: 采样 + 用户反馈(点赞/纠错)+ 弱监督信号(是否点击引用)。
Q21:索引频繁更新如何保持一致性?
A: 版本号、双写切换、后台重建与灰度;读写分离。
Q22:如何防止 Prompt 注入污染 RAG?
A: 文档清洗、权限隔离、输出引用限制、检测异常指令模式。
Q23:长上下文模型出现后 RAG 会消失吗?
A: 不会;私域数据规模与成本、检索聚焦证据、合规审计仍需要 RAG 范式。
Q24:多模态 RAG 要点?
A: 图像/表格编码、跨模态对齐、与文本混合索引与路由。
附录:LangChain 向量存储检索(LCEL 示意)
代码块
Python
# pip install langchain langchain-openai langchain-community faiss-cpu
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings
小结
RAG 的本质是 用检索把「可更新证据」接到生成模型上;落地胜负手常在 解析与分块、混合检索、重排、评估与多租户安全。建议你在简历项目里准备 一条可量化指标(如:Top-5 召回提升、成本下降比例)与 一次失败案例分析(检索错还是生成胡编),面试会非常有说服力。