第九节:如何给AI提供可靠建议
很多团队以为接上一个大模型 API,就算做出了 Agent;但真实企业最怕的,是 AI “自作主张”。
🔔
企业真正关心的问题是:模型引用的是不是本轮真正检索到的知识?它会不会补充没有依据的退款、改单或外发承诺?模型判断“低风险”时,能不能跳过本该由人确认的环节?模型服务超时或限流时,工单还能不能继续处理?
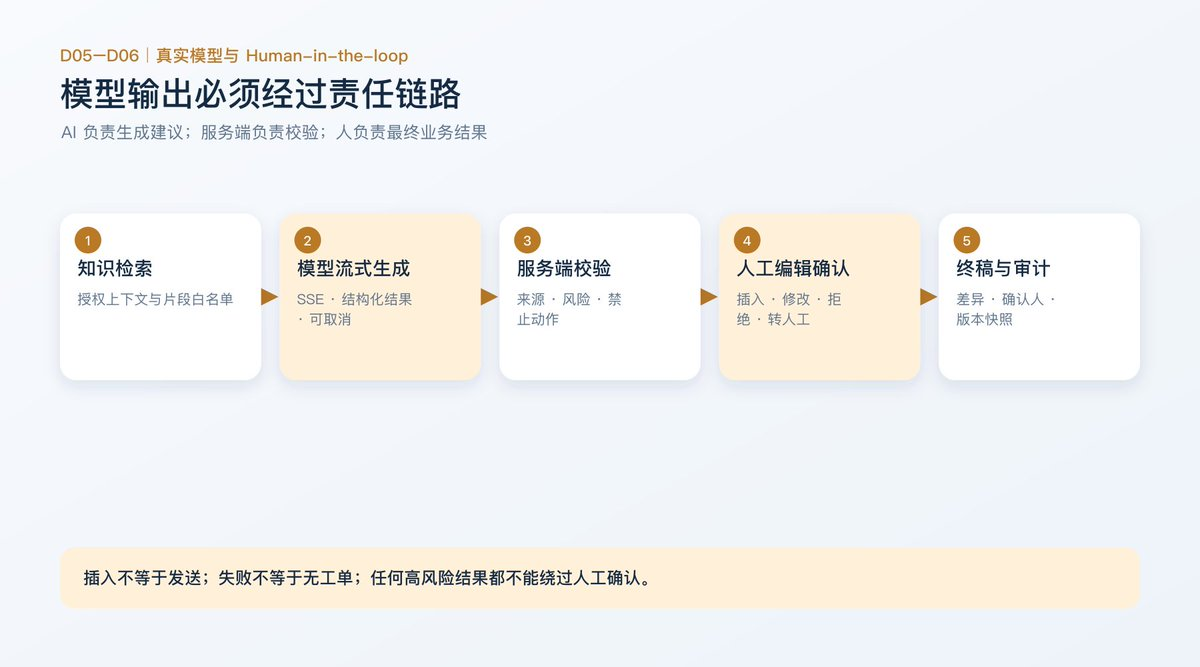
AI 建议进入业务结果前的完整责任链路
流式输出不是逐字动画,而是一份运行协议
前端通过 SSE 接收模型运行事件:
代码块
Plain Text
start
→ text_delta
→ structure
→ complete
text_delta 让用户看到草稿逐步生成;structure 携带分类、风险、来源和下一步;complete 只有在结构、来源和风险全部通过服务端校验后才出现。
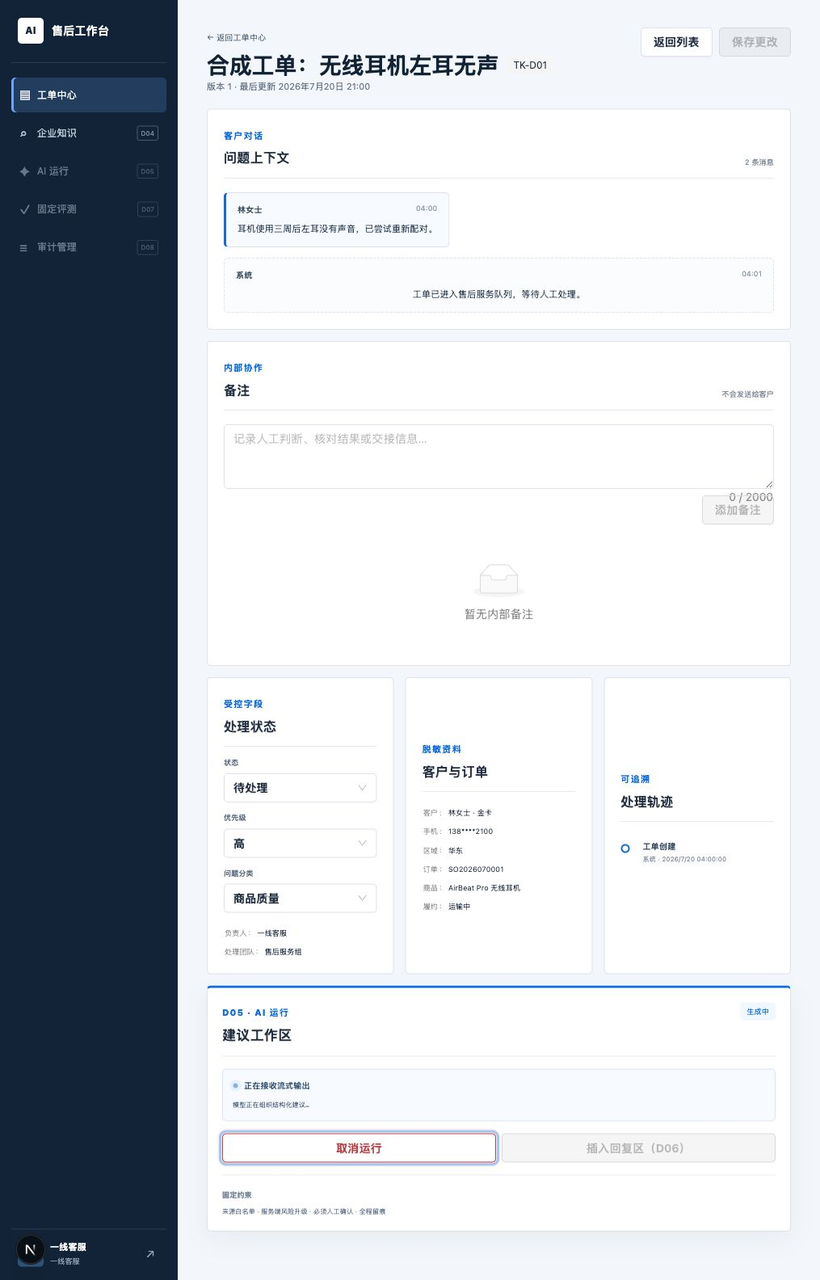
运行中页面显示流式状态,并提供取消入口
用户取消、浏览器断开、模型超时、供应商限流、结构解析失败和非法来源都有独立终态。已经接收到的部分文本可以作为运行证据保存,但不能伪装成已完成建议。
真实模型的输出必须再次经过服务端规则
模型只能看到后端提供的脱敏、授权上下文。它不能直接读数据库,也不能自行调用退款、改单或外发工具。
服务端会重新检查:
•
来源是否属于本轮 D04 检索白名单;
•
分类和风险是否符合固定规则;
•
是否包含虚假的完成性承诺;
•
是否涉及质量、退换货、安全、补偿、个人信息或外发;
•
是否必须进入人工确认。
即使模型判断“低风险”,只要服务端规则命中高风险场景,状态仍然强制进入 WAIT_CONFIRM。
大模型完成生成,但状态仍是待人工确认
模型擅长生成建议,不负责定义企业责任。
AI 原稿和人工终稿必须是两个对象
D06 采用前面原型阶段选定的 R1:AI 建议留在右侧证据区,客服点击“一键插入”后,内容才进入可编辑的最终回复区。
AI 建议插入为可编辑终稿,同时显示高风险影响
插入不是发送,编辑也不是确认。
客服可以修改措辞,但在保存前必须看到:将保存什么文本、影响哪张工单、是否包含外部动作、当前系统实际不会执行什么,以及谁会留下审计记录。
系统分别保存:
•
AI 原稿;
•
人工终稿;
•
修改差异;
•
确认人和确认时间;
•
模型、Prompt、知识和工单版本;
•
风险判断与引用来源。
确认后可以比较 AI 原稿、人工终稿和审计信息
这让“AI 帮助过”变成可复盘的事实,而不是一句无法追踪的描述。
Human-in-the-loop 不只有一个确认按钮
第一版实现了五种人工结果:
插入并编辑;
确认最终稿;
拒绝 AI 建议并记录原因;
退回补充信息;
转入人工主管队列。
转人工会保存目标队列、原因、已有草稿、检索来源和失败记录。由于 Demo 不连接真实通知渠道,页面明确说明“不会向真实人员发送通知”。
企业产品不能用一个绿色提示伪装外部动作已经发生。
模型不可用时,工单仍然必须可处理
我们专门验证了没有模型凭证、模型拒绝、429、超时、结构损坏和运行中取消。
模型服务不可用时保留工单内容,并禁止插入不完整结果
失败后,页面保留工单、客户上下文和已经检索到的知识;禁止插入未完成草稿;允许安全重试或转人工。
AI 是工作台的一项能力,不应该成为整个业务的单点故障。
我们怎样证明这不是一个“假 AI 页面”
D05 最终保存了一条真实 DeepSeek 完整链路:登录、读取工单、D04 检索、SSE、结构化输出、来源白名单、风险升级、数据库落库和审计。
同时又把确定性协议测试和真实模型证据分开标注。确定性执行器用于稳定复现超时、非法来源和结构损坏;真实调用只用于证明外部模型协议和真实业务链路。
自动测试共覆盖 65 项;D06 完成后,全工作区 74 项测试通过。数字本身不是重点,重点是每一个“完成”都能回到运行记录、数据库或页面截图。
可以直接交给 AI 的实现要求:
代码块
Plain Text
到这里,我们已经能安全地产生并确认 AI 建议。但这一次没有越权,不代表下一次修改后仍然安全。