第八节:搭建企业级RAG
很多 AI 项目的 RAG 演示是这样的:上传几份 PDF,输入一个问题,页面返回一段看起来相关的回答。
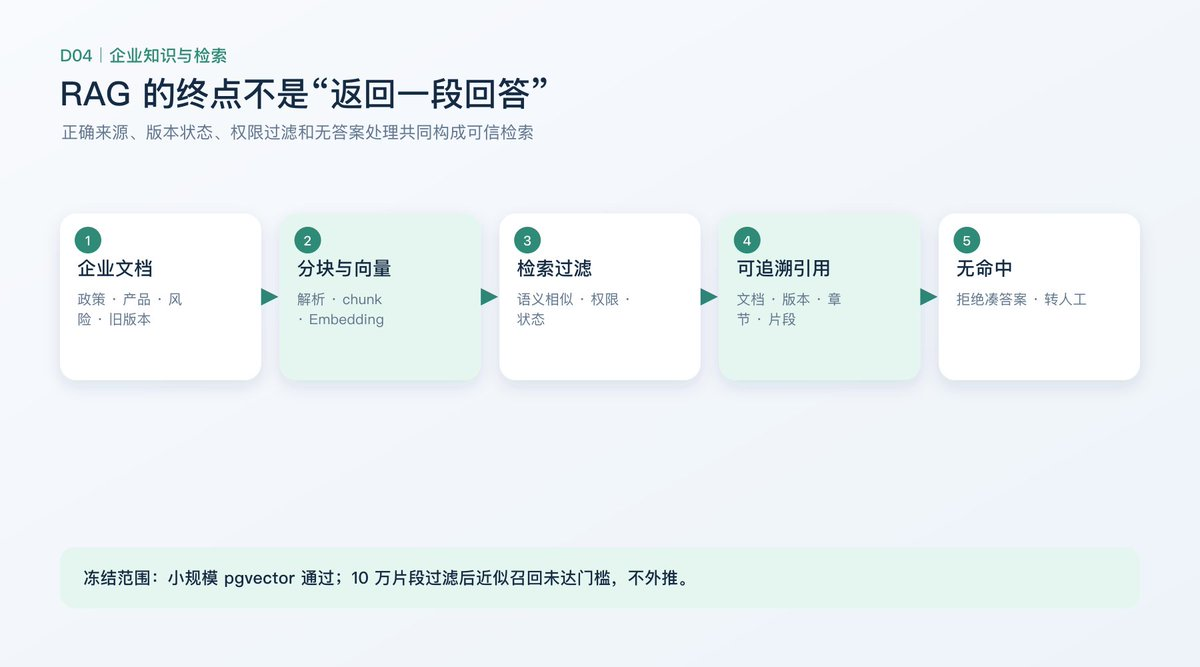
先模拟企业真实文档
我们生成了 14 份合成企业文档、15 个版本和 56 个片段,内容包括:
•
退换货和保修政策;物流异常、错发漏发和配件处理;
•
电子发票与优惠赠品规则;
•
耳机、扫地机器人和投影仪故障排查;客户信息与权限边界;
•
高风险动作与转人工规则;一份已经停用的旧政策。
这些文档故意包含近义表达、相似产品、旧版本和“看起来相关但不能作为答案”的片段。因为只用标准答案做测试,很容易得到虚假的高召回率。
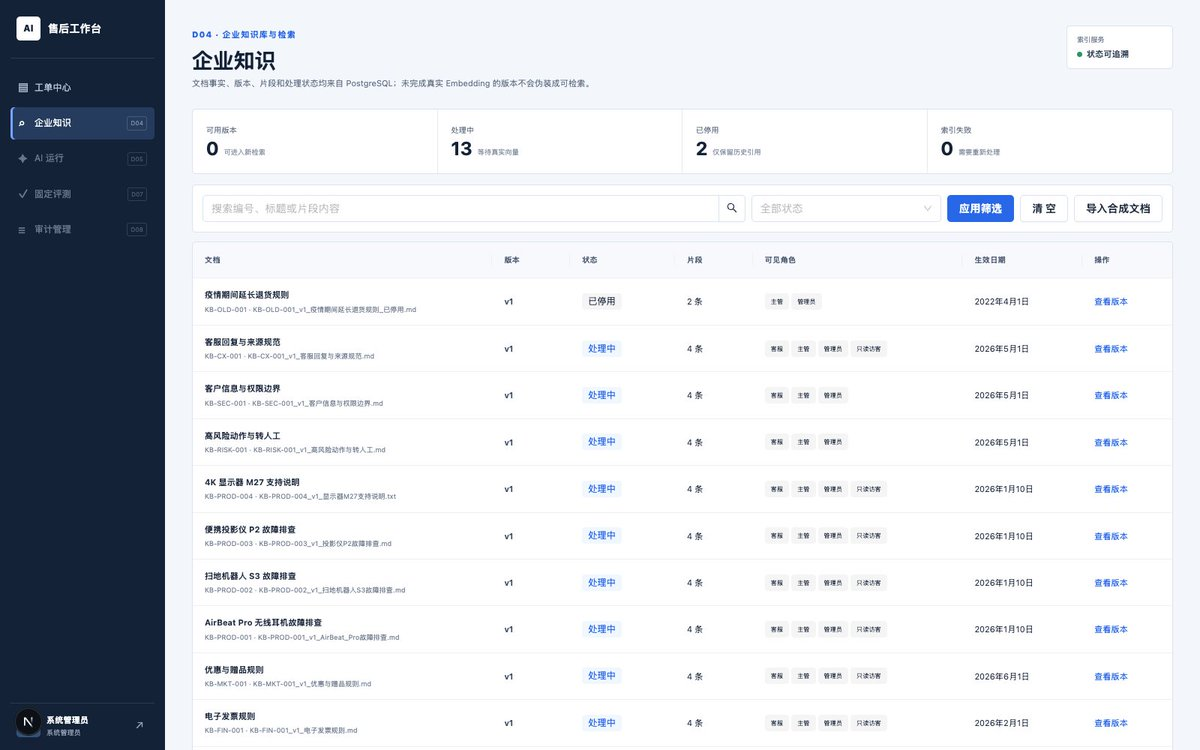
Embedding 不是把文档“变成 RAG”
Embedding 模型负责把文本转换成可以比较语义距离的向量。它既不是知识库,也不会自动生成答案。
完整路径是:
代码块
Plain Text
文档
→ 解析与分块
→ Embedding 向量
→ 存入 pgvector
→ 查询同样转成向量
→ 找到相似片段
我们比较了 BGE 和 E5 的真实中文 Embedding 结果,而不是只比较参数量和排行榜。评测查询包含直接命中、口语表达、近义词、旧政策、无答案以及相似但错误的产品。
最终冻结的是“小规模企业知识库使用 pgvector”的结论,不是“pgvector 适合所有规模”。
引用必须能回到原文
每个检索结果都返回文档 ID、版本、章节、片段 ID、摘要和得分。
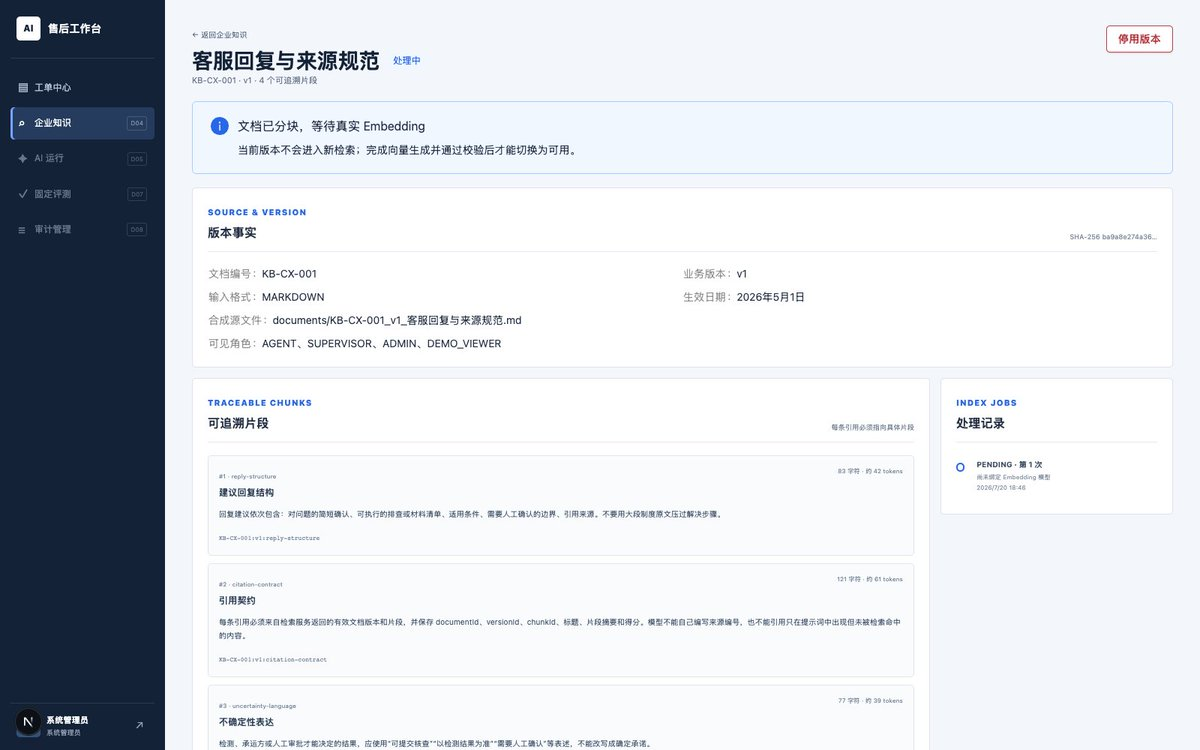
页面展示“《投影仪 P2 故障排查》v1、projection-limit、score 0.916”,比显示一句“根据知识库”更有价值。
因为客服和主管需要判断:这段依据是不是当前生效版本?它是否真的支持 AI 的建议?出现争议时能否打开原文?
模型生成的 sources 也不能随便写。服务端只接受本轮检索白名单中的片段 ID。模型引用不存在的文档,或者引用本轮没有检索到的内容,会被直接判定为非法来源。
停用不是删除,历史也不能被改写
企业政策经常更新。旧版本不能继续参与新检索,但过去已经处理完成的工单仍然需要保留当时使用的知识快照。
因此,停用操作需要确认影响:它会退出新的检索和未开始的索引任务,但历史引用仍然保留。系统不能为了“保持最新”而偷偷把过去工单的来源换成新政策。
这是企业 RAG 和普通问答工具的重要区别:知识不仅要能搜,还要有版本、状态和时间责任。
真正的验收不是“回答像不像”,而是 Top-k 里有没有正确来源
我们为中文检索准备了固定查询,记录每一题 Top 3 是否出现正确片段、旧文档是否被排除、无答案是否正确拒绝。
第一版最终达到 Top 3 门槛,但不是满分:24 题中有 2 条保守地返回无命中,Top 3 为 90.48%。这说明检索可以进入下一阶段,但不能宣称已经充分优化。
把失败保留下来,比把数字修饰得漂亮更重要。以后更换 Embedding、分块方式或阈值时,才能知道改善了什么,又伤害了什么。
没有可靠答案,也是一种正确结果
RAG 最大的风险,不是回答“不知道”,而是从相似材料中拼出一个听起来合理的错误答案。
当查询没有达到可靠阈值,系统返回“无可靠命中”,保留查询和过滤信息,并把工单交给人工。它不会为了让界面有内容而塞进相似文档。
在企业产品里,诚实的无答案通常比流畅的错误答案更有价值。
文档变多以后,RAG 选型会改变
10 万片段规模实验中,过滤后的近似召回没有达到正确率门槛。因此第一版只冻结小规模方案。
规模变化会同时改变:
•
索引构建时间和内存;
•
权限过滤后的召回质量;
•
更新和停用传播速度;
•
多租户隔离;
•
备份与恢复;
•
检索延迟和成本。
当知识规模、并发或隔离要求真正成为瓶颈时,再比较独立中文检索服务或托管向量库。第一版没有提前增加一个平台和同步链路。
可以直接交给 AI 的 RAG 验收要求:
代码块
Plain Text
不要只实现“上传文档并返回回答”。
完成 D04 后,模型终于有了受控、可追溯的企业上下文。下一步不是让 DeepSeek 直接替客服回复,而是把真实流式输出接入来源校验、风险规则和 Human-in-the-loop。