为什么 Claude Code 等主流 Agent 工具不使用 RAG了
一、为什么 Claude Code 等主流 Agent 工具不使用传统 RAG
核心原因:代码场景下"精确匹配"比"语义相似"更重要
Claude Code 的创始人 Boris Cherny(Anthropic 工程师)明确表示:早期版本确实尝试过 RAG + 本地向量数据库,但最终发现 Agentic Search overwhelmingly better(压倒性更优)。
在代码场景中:
•
RAG 擅长语义搜索,但代码更需要的是精确匹配(比如函数名、变量名、文件路径的完全匹配)
•
语义相近的代码片段往往是噪音,会干扰模型判断
Agentic Search 的工作方式
🔔
Claude Code 采用的是 Agentic Search(智能体搜索),本质上是让 AI 自主决定如何搜集信息:
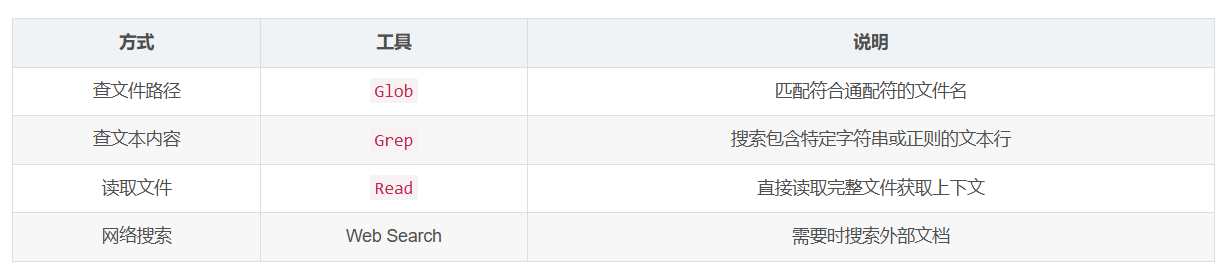
这种方式不需要预处理和索引,AI 像人类工程师一样实时探索代码库。
传统 RAG 在代码场景的具体缺陷
根据 Anthropic 的实践经验:
准确性问题:返回的信息经常"差那么一点",引用的是过时或无关的代码片段
索引新鲜度:代码变更频繁,向量索引很快过时,维护成本高
安全隐患:代码存入向量数据库可能带来信息泄露或数据投毒风险
运维复杂度:预处理、索引管理、向量数据库维护都是隐性成本
Coding Agent 领域的技术路线分化
•
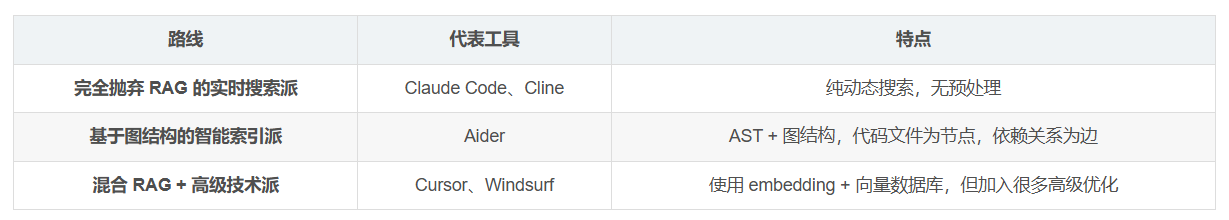
目前 Coding Agent 领域存在三种路线:
二、什么场景才需要使用 RAG?
🔔
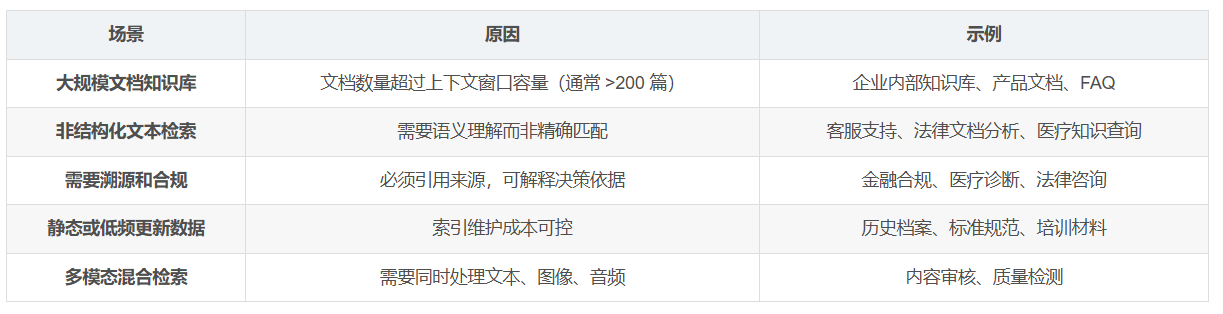
虽然 Claude Code 放弃了标准 RAG(Embedding + 向量数据库 + 相似性搜索),但 RAG 在以下场景仍然是最优解:
适合使用 RAG 的场景
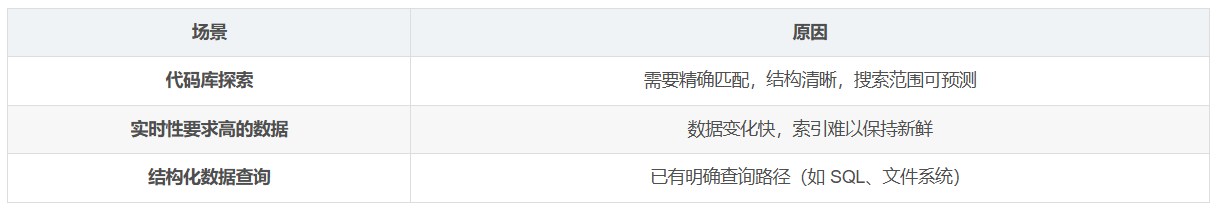
不适合 RAG、更适合 Agentic Search 的场景
三、关键洞察:RAG 并没有"死",只是被重新定义
🔔
•
广义上,Agentic Search 也是一种 RAG
—— 它仍然是在"检索外部信息并基于其生成",只是检索方式从向量相似性搜索变成了智能体自主探索
🔔
•
上下文窗口的扩大削弱了部分 RAG 需求
—— 像 Claude 200K、Gemini 2M 的上下文窗口,可以直接塞入整个代码库或大量文档,减少了对复杂检索系统的依赖
🔔
•
混合架构是趋势
—— 实际生产环境中,往往不是二选一,而是结合使用:RAG 处理大规模文档知识,Agentic Search 处理代码和结构化数据
四、总结
•
Claude Code 不用传统 RAG 的核心逻辑:在代码这个特定领域,维护向量索引的成本和复杂性,超过了它带来的收益。让 AI 像程序员一样用 grep、glob 实时搜索,反而更准确、更灵活、运维更简单。
•
使用 RAG 的黄金法则:当你的数据是大规模、非结构化、静态文档,且语义相似性比精确匹配更重要时,RAG 仍然是最佳选择。对于代码、结构化数据、实时变化的数据,Agentic Search 或长上下文窗口通常是更好的方案。