Agent Skills 完全指南:从原理到实战
一、 Skills 入门理解
1.1 Skills 到底是什么?
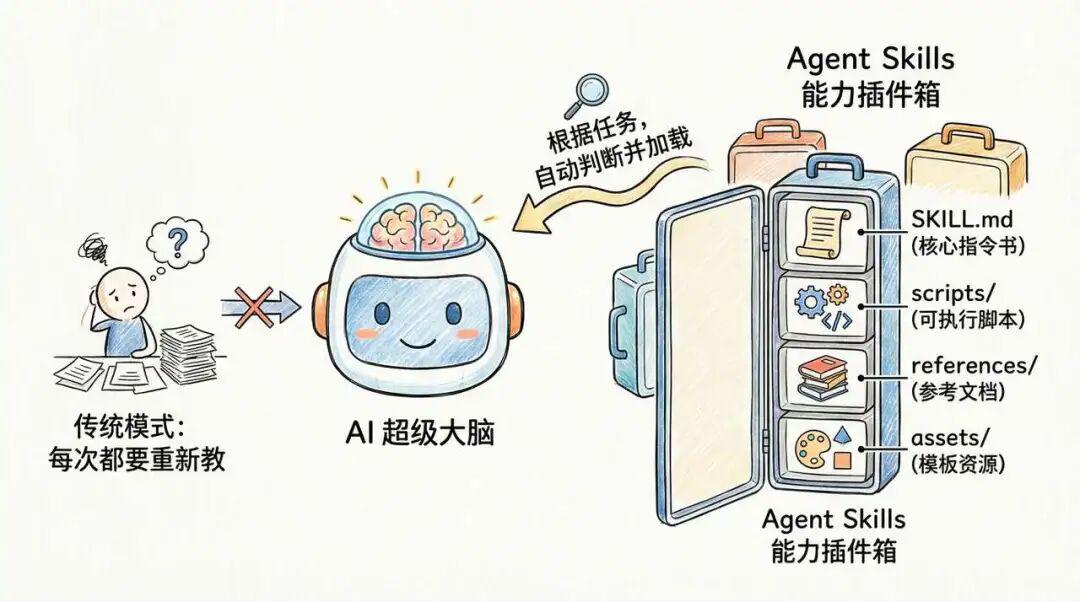
你可以把 Codex 想象成一个超级大脑,而 Agent Skills 就是给这个大脑安装的外接工具箱。
49%
51%
这个工具箱里不仅有工具本身,还包含了详细的 “官方使用说明书”,大脑不需要理解具体有哪些工具以及工具的用法是什么,只需要在需要使用某个工具时查看工具说明书,再把工具拿出来用。
1.2 Skills 长什么样?
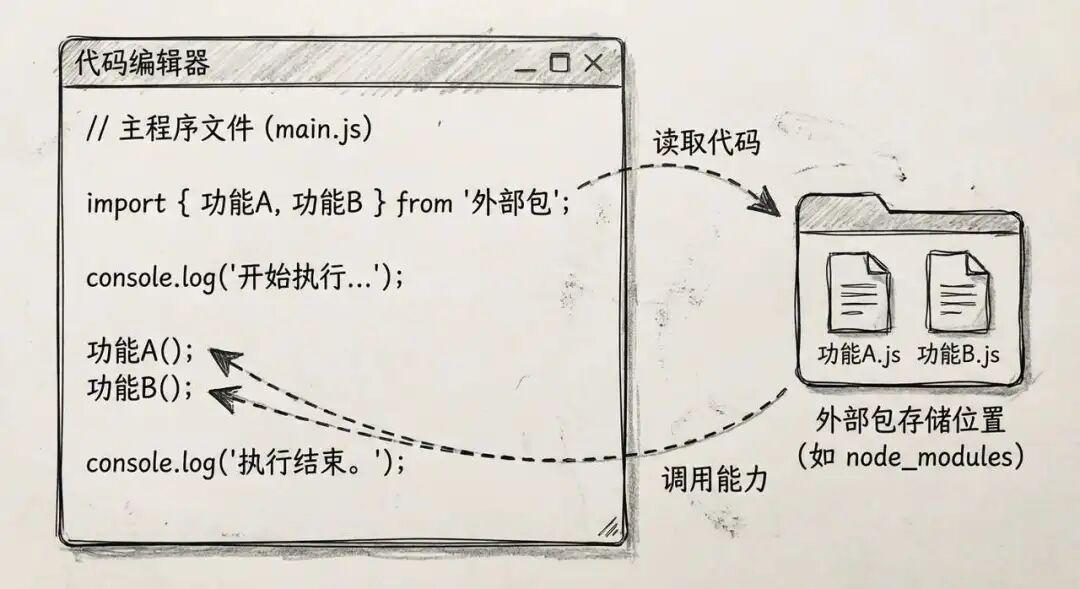
Agent Skills 的官方文档中强调了一个核心关键词:File-system based(基于文件系统)。如果你写过代码,可能很容易理解。要编写一个程序,并不一定所有代码都是我们自己写的。
当程序需要调用这些包的能力时,就会从指定文件夹取出对应的代码然后执行。
📚
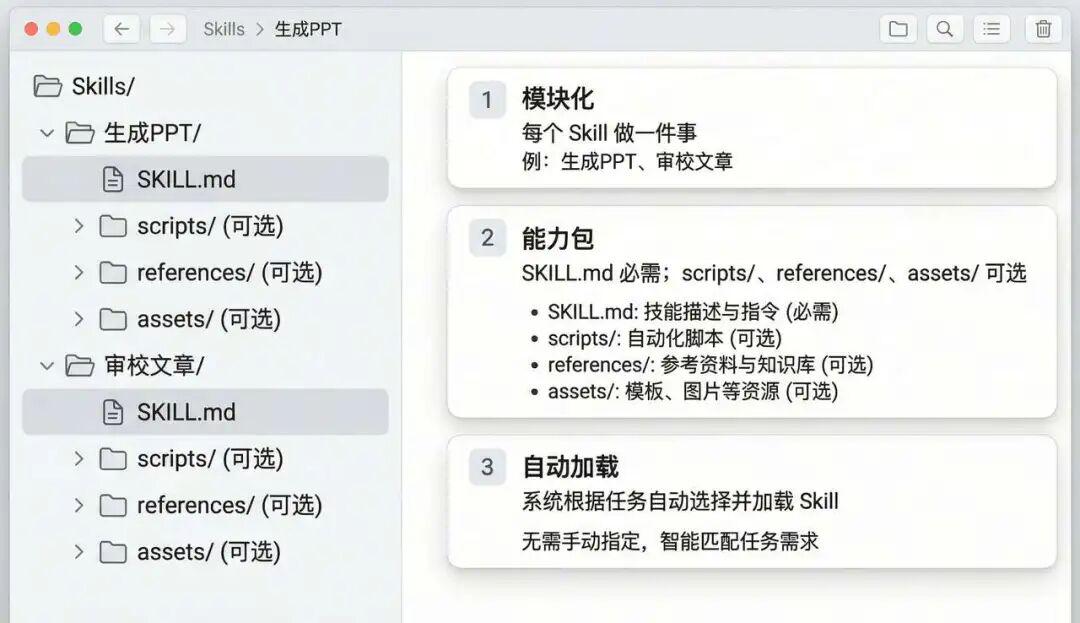
Agent Skills 也是类似的逻辑,每个 Skill 都是一个实实在在存在的文件夹,它存放在一个固定的位置(如 .codex/skills)这个文件夹里装着下面几样东西:
指令SKILL.md: 告诉 AI 怎么干活的 SOP
参考reference: 更详细的参考文档(可选)
脚本scripts: 比如 Python 代码,让 Skill 也能调用外部能力(可选)
资源assets:图片、模版等可能使用到的资源(可选)
54%
46%
🥇
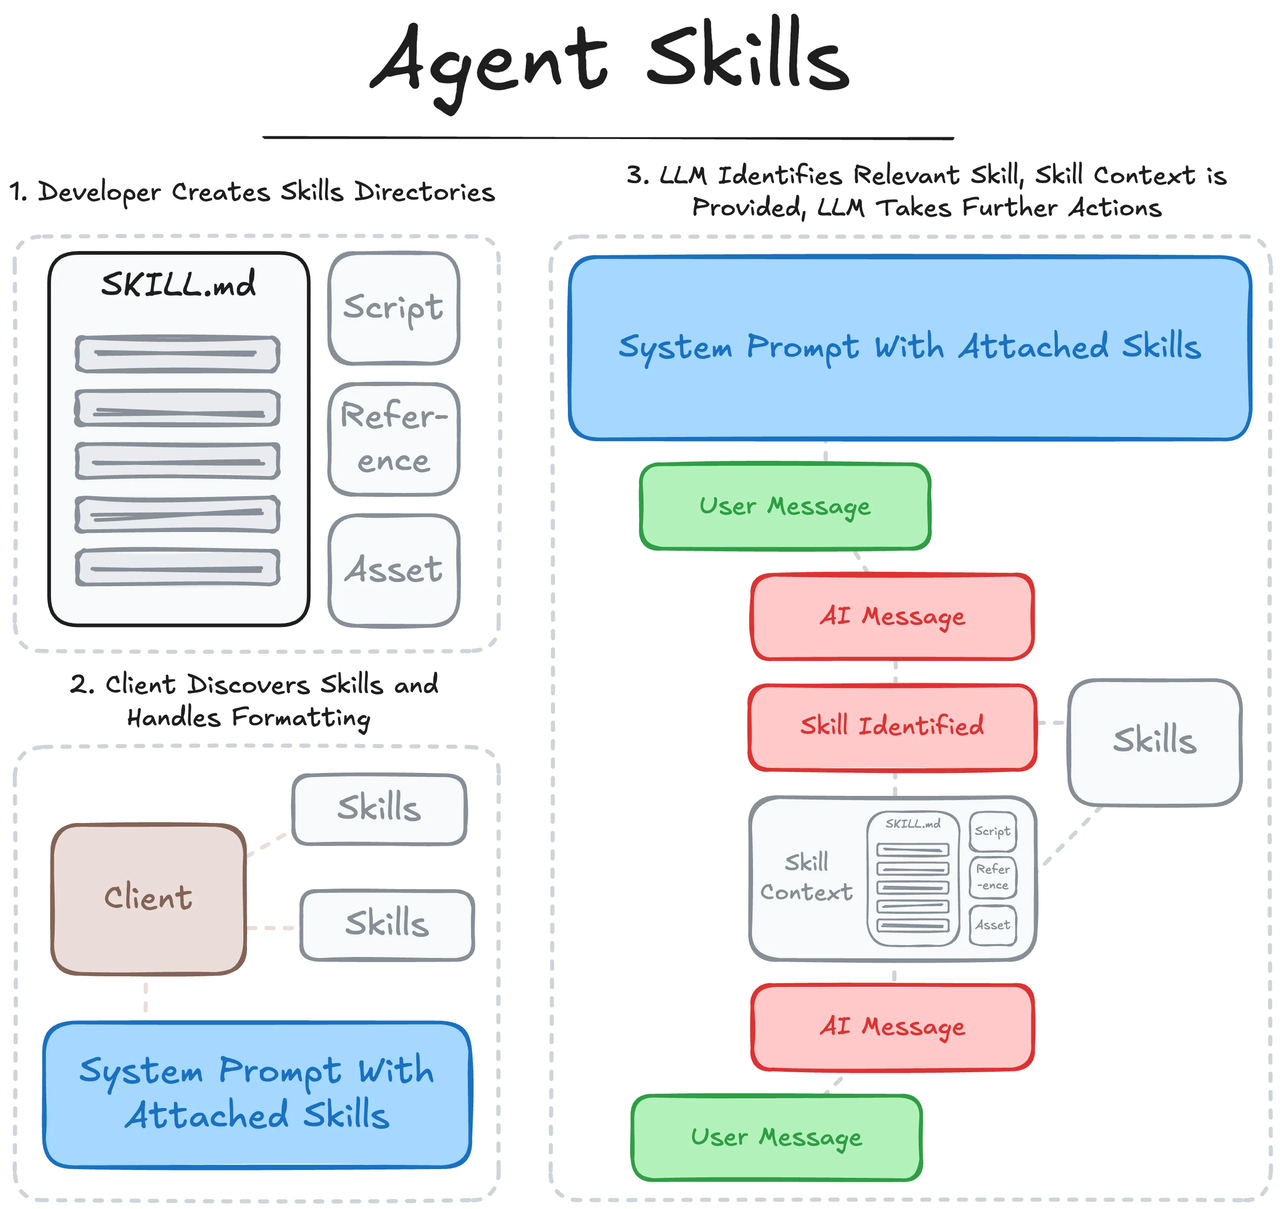
如果你在你的 Agent(如 Claude Code)执行目录(如你的项目代码目录)下放了这个文件夹,那下次和 Agent 对话的时候就能自动根据你的需求匹配到这个 Skill,不需要再进行任何额外的配置。
比如,你希望 Agent 帮你润色文章,就可以编写一个下面这样的 Skill:
上面的三根短横线部分相当于 Skill 的「身份证」:
•
name 是它的唯一标识,起个简单好记的英文名字就行
•
description 则决定什么时候会触发这个 Skill,描述这个 Skills 是做什么的、遇到什么样的用户请求应该用它、提醒读者:描述越具体,越容易在正确场景被调用
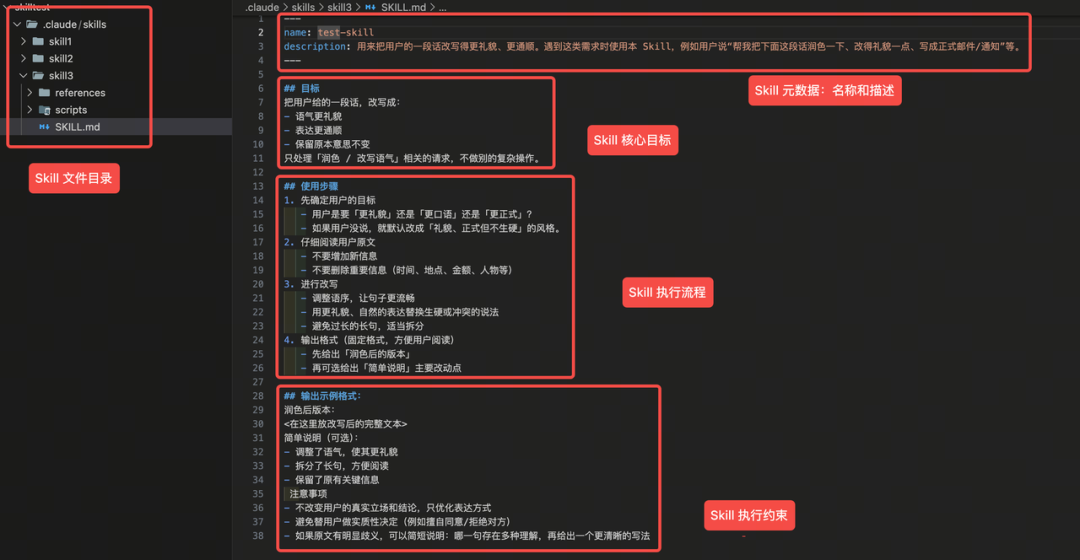
下面就是 Skill 的正文部分:
•
目标:简单描述清楚这个 Skill 要做的事情
•
使用步骤:列出 Skill 的操作流程(先搞清楚想要什么风格、再读原文、再改写、最后规定输出格式)
•
注意事项:告诉模型「什么不要做」(不要乱加内容、不要替用户做决定、有歧义要提醒)
看起来挺普通的?似乎很多能力都可以做这件事?
•
可以把这段文字和要润色的文章直接发给大模型?
•
可以把这段文字放到系统提示词?
•
可以把这段固定的流程封装为一个 Workflow?
•
可以把这段文字编写为一个 Agent.md 或者项目级的 Rules?
这些方式看似不同,但本质上只是把提示词放在了不同的位置,你给 AI 的每次对话都会带上这些提示词。
🧠
在真实的业务场景中,一个 Agent 不可能只干一件这么简单的事。大家试想一下,如果你要给 AI 装 50 个技能,每个技能都有几千字的说明书,要是系统一启动就把这些全塞进 AI 的脑子(Context Window)里
那么就会:
•
成本爆炸,每次对话可能都会消耗几万 Token。
•
AI 的注意力也会被分散,变得“这也想干,那也想干”。
Skill 的出现就是为了解决这种问题,它有一个非常核心的机制,叫渐进式披露(Progressive Disclosure)。说人话就是:按需加载,用多少拿多少。
1.3 Skills 的核心机制
这是我觉得 Agent Skills 设计得最聪明的地方。你可以把它想象成我们在图书馆查资料的三个步骤,非常直观:
第一层:先看目录(元数据 Metadata)
•
什么时候加载? 系统刚启动的时候。
•
加载什么? 只加载每个技能的名字和一段简短的描述。
•
有什么用? 这一层占用的资源极少,可能就几百个 Token。它的作用就是告诉 Claude:“嘿,你的工具箱里有‘查周报’、‘处理 Excel’ 这几个工具哦。”
•
结果: Claude 知道自己 “会什么”,但还不知道 “具体怎么做”。
第二层:翻开手册(指令 Instructions)
•
什么时候加载? 当你说 “帮我把这个 Excel 处理一下” 的时候。
•
加载什么? Claude 发现这事儿归 “Excel 处理” 这个技能管,于是它才会通过后台命令,去读取那个文件夹里的 SKILL.md 文件。
•
有什么用? 只有在这个时候,那些详细的操作步骤、注意事项才会进入 AI 的脑子。
第三层:动手干活(运行时资源 Runtime Resources)
什么时候加载? 真正执行具体步骤的时候。加载什么?
参考(reference): 用户下达的任务可能是分析 Excel,也可能是创建 Excel,这两个操作可能有完全不同的处理步骤,详细的步骤不一定都在 SKILL.md 中,可以分开放在不同的参考文献(reference)下,当 Claude 识别到你要做的是分析 Excel 时,才会去查阅分析 Excel 的 reference。
🗂️
这意味着:一个 Skill 可以打包整套说明文档、大量的执行脚本,但只要任务不需要,这些内容就永远不会占用上下文。
二、Skills VS MCP
看到这,你可能会觉得 Skills 和 MCP 有点像?
它们似乎都可以做到按需加载、给 AI 扩展外部能力?
这也是很多同学可能会弄混的问题。
2.1 MCP 有什么问题
🔌
所以 MCP 的本质,还是在做 “标准化”,它让给 AI 扩展外部能力这件事更 “标准化”。
假如你的 Agent 连接了多个 MCP,它似乎也能实现 “按需加载”(根据用户的意图决定调用哪个工具)。
但这个 “按需加载” 背后的代价是非常巨大的,在 MCP 的架构下,仅仅是“连接”这个动作,就已经在透支你的额度了。
这是由 LLM 的工具调用机制决定的。为了让 AI 知道它有哪些能力可用,每一个连接的 MCP Server 必须在对话开始前,将其所有工具的完整定义(名称、详细描述、参数 Schema、使用示例)一次性注入 LLM 的上下文中。
每个 MCP Server 一般都会包含大量的工具,比如 Github MCP ,它自己就包含了 30 多个工具:
假如每个工具消耗 500 个 Token,那只链接这一个工具就需要消耗将近 20000 Token。
在真实环境下,一个 Agent 不会仅链接一个 MCP Server。
假如你只问了 AI 一个非常简单的问题(1+1=?),Agent 已经烧掉了大几万的 Token,这个成本是非常恐怖的。
更深层的问题在于链接过多的 MCP Server 可能导致 LLM 的 “注意力” 下降,从而降低工具调用的准确性。
模型必须自己发现合适的工具、正确调用,并把多步结果汇总成最终答案。目前最强的 Claude Opus 4.5 也只能拿到 62% 的准确率,这个值还会随着工具的增多而进一步下降。
而我们上面讲到的 Skills 的核心机制:渐进式披露 ,恰好可以解决这两个问题:
•
节省 Token:首次链接时,相比 MCP 需要将 40 多个 MCP Server 下 300 个工具全部塞进模型上下文(消耗数万 Token),模型只需要加载 40 个 Skills 的元数据(几千 Token)。
•
提升注意力: 面对几百个工具,AI 很容易分心。Skills 采用的是“漏斗式”引导:先通过目录判断大方向,确认要干活了,再加载具体的说明,最后通过说明找到详细的文档和脚本最后再执行。让 AI 每次只专注于当前任务。即使是能力稍弱的模型,在这种机制下也能保持极高的调用准确率。
2.2 MCP 会被淘汰吗?
看到这你可能会问了,Skills 看起来更智能、更节省资源,那 MCP 会被淘汰吗?
📌
结论是:MCP 不会被完全淘汰,但对它的需求会大幅减少!
首先,MCP 协议层的价值不可替代: MCP 的真正价值不在于它如何把文本塞进 Prompt,而在于它制定了一套标准接口。
它统一了 AI 连接世界的方式。如果你是一个通用的三方平台(高德地图、Notion 等),想发布一个工具让其他 Agent 都能用上你的能力,那首先选择的还是 MCP。
但是,如果你有一些重复性的工作流,比如要以固定的流程读写本地文件、要用一个标准的范式来 Review 代码、有一套固定的风格来编写文章,这些场景都推荐使用 Skill 来实现。
在过去这几个需求中的本地文件读写、链接 Github、给文章生成图片这些需要链接外部世界的能力都得通过 MCP 去实现,但现在你可以都把它们打包到 Skill 里。
未来的格局可能是这样的(来自宝玉老师):
•
Agent 本身内置部分核心能力(bash、read、edit、write)
•
少数通用 MCP Server 负责远程连接(数据库、云 API、SaaS 集成)
•
大量 Skills 负责封装标准工作流、连接本地知识库
•
两者在必要时协作,但 Skills 会承担绝大部分 “教 AI 怎么做事” 的工作(这其中也包含教 AI 怎么用 McpServer、怎么用其他 Skills、怎么更好的调用核心能力)
三、Skills 的初步尝试
3.1 去哪找 Skills?
和 MCP 一样,Skills 成了开放标准后开始爆发式增长,社区出现了大量的开源 Skills,很多 Skills 开放市场也应运而生,之前大部分 MCP Market 也都增加了 Skills 的分类:
我们可以看到 skillsmp 中的 Skills 数量在最近经历着爆发式增长,这就不得不提 Skills 的另一大优点:编写门槛低!
•
MCP 虽然有一套标准的规范,但终究还是要靠代码编写的,即便有了 AI 辅助,对于小白来讲还是有一定的门槛的。
•
而 Skills 就不一样了,只要你会写提示词,就能写 Skill,可以预见的是,之前那些大量的固定工作流在未来可能都会被编写为 Skill。
3.2 怎么使用 Skills?
我们随便进入一个 MCP ,然后搜索我们要使用的 Skills,比如这里我们还以绘图软件 Excalidraw 为例:
可以看到社区已经有大量 Excalidraw 的 Skill 了,我们这里选择 Star 最多的一款:
进入详情后,我们选择一个最简单的安装方式,直接把这个 Skill 下载到本地,点击 wget skill.zip:
然后我们把这个压缩包解压,你就会看到熟悉的目录。接下来,你只需要把这个目录下载到指定的位置:
不同客户端的目录大同小异,基本上都是 .agentName/skills 目录,这里我们使用最近比较火的 OpenCode 进行演示(大家看可以自行选择 Cusor、Codex 等支持 skills 的客户端),所以我们创建一个新的文件夹,然后把刚刚下载的文件夹放到 .opencode/skills 目录下:
接下来,我们在这个目录下打开 opencode 客户端,输入下面的提示词:
代码块
Python
帮我绘制一个架构图,讲解什么是 5W2H 分析法,直接帮我在当前目录下生成一个 excalidraw 文件。
你不需要手动去 “安装” 或 “运行” Skill,只要文件放对位置了,OpenCode 的 AI 就会自动根据用户的需求判断要调用这个 Skill,然后帮我生成了代码:
我们将生成的代码粘贴到 https://excalidraw.com/,就可以看到已经生成好的架构图:
3.3 创建你的第一个 Skill
下面,我们一起来尝试做第一个 Skill,虽然 Skill 的开发门槛低,但这不意味着我们就要自己写!
Anthropic 官方直接给我们提供了一个 生产 Skills 的 Skill:Skill Creator。你不需要写一行代码或配置文件,只需要用自然语言告诉它你想做什么,它就会自动为你生成一个符合标准的 Skill 包。
接下来,按照刚才的流程,我们把这个 Skill 下载下来,放到 .opencode/skills 目录下:
然后我们给出下面的提示词:
代码块
Python
帮我创建一个可以准确获取当前系统时间的 Skill,描述使用中文,脚本使用 Node.js。
然后,opencode 识别到我们的需求,开始调用 skill-creator:
然后我们打开本地的 .opencode/skills 目录,发现多了一个 current-time-node skill,包含一个 SKILL.md 加一个获取准确时间的 Node.js 脚本:
接下来,我们询问 opencode:“获取当前系统时间”,然后它就会自动找到刚刚生成的 Skill 并调用里面的脚本: