第五章 动手搭建大模型
Meta(原Facebook)于2023年2月发布第一款基于Transformer结构的大型语言模型LLaMA,并于同年7月发布同系列模型LLaMA2。我们在第四章已经学习和了解了LLM,以及如何训练LLM等内容。本小节我们就来学习如何动手实现一个LLaMA2模型。
LLaMA2 模型结构如下图5.1所示:
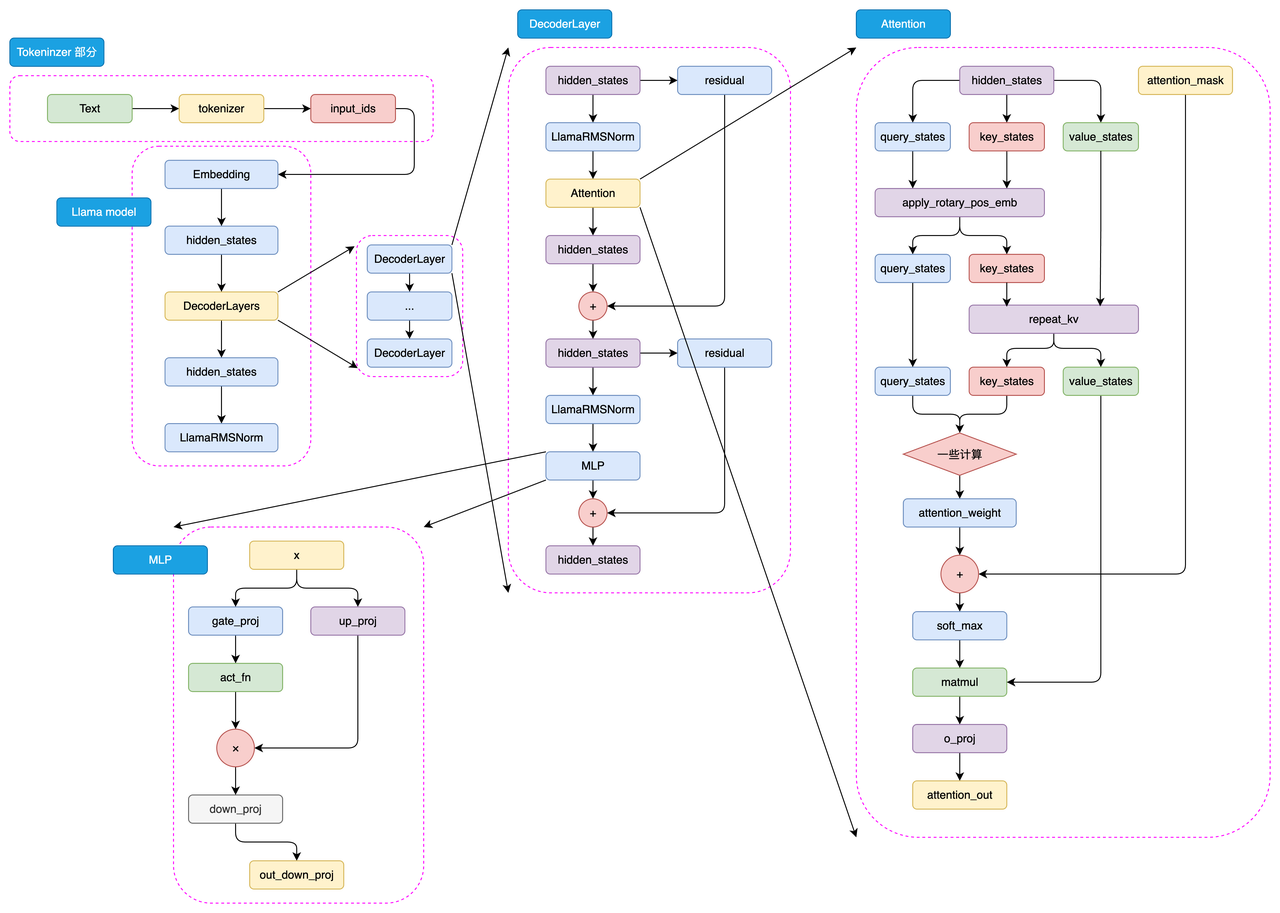
图 5.1 LLaMA2结构
首先我们需要定义一些超参数,这些超参数包括模型的大小、层数、头数、词嵌入维度、隐藏层维度等等。这些超参数可以根据实际情况进行调整。
这里我们自定义一个ModelConfig类,来存储和记录我们的超参数,这里我们继承了PretrainedConfig类,这是transformers库中的参数类,我们可以通过继承这个类来方便的使用transformers库中的一些功能,也方便在后续导出Hugging Face模型。
代码块
Plain Text
from transformers import PretrainedConfig
class ModelConfig(PretrainedConfig):
model_type = "Tiny-K"def __init__(
self,
dim: int = 768, # 模型维度
n_layers: int = 12, # Transformer的层数
n_heads: int = 16, # 注意力机制的头数
n_kv_heads: int = 8, # 键值头的数量
vocab_size: int = 6144, # 词汇表大小
hidden_dim: int = None, # 隐藏层维度
multiple_of: int = 64,
在以下代码中出现 args 时,即默认为以上 ModelConfig 参数配置。
我们来看一下其中的一些超参数的含义,比如dim是模型维度,n_layers是Transformer的层数,n_heads是注意力机制的头数,vocab_size是词汇表大小,max_seq_len是输入的最大序列长度等等。上面的代码中也对每一个参数做了详细的注释,在后面的代码中我们会根据这些超参数来构建我们的模型。
RMSNorm可以用如下的数学公式表示:
其中:
•
xixi 是输入向量的第 ii 个元素
•
γγ 是可学习的缩放参数(对应代码中的 self.weight)
•
nn 是输入向量的维度数量
•
ϵϵ 是一个小常数,用于数值稳定性(以避免除以零的情况)
这种归一化有助于通过确保权重的规模不会变得过大或过小来稳定学习过程,这在具有许多层的深度学习模型中特别有用。
我们可以通过如下代码实现RMSNorm:
代码块
Python
class RMSNorm(nn.Module):def __init__(self, dim: int, eps: float):super().__init__()# eps是为了防止除以0的情况
self.eps = eps
# weight是一个可学习的参数,全部初始化为1
self.weight = nn.Parameter(torch.ones(dim))def _norm(self, x):# 计算RMSNorm的核心部分# x.pow(2).mean(-1, keepdim=True)计算了输入x的平方的均值# torch.rsqrt是平方根的倒数,这样就得到了RMSNorm的分母部分,再加上eps防止分母为0# 最后乘以x,得到RMSNorm的结果return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)def forward(self, x):# forward函数是模型的前向传播# 首先将输入x转为float类型,然后进行RMSNorm,最后再转回原来的数据类型# 最后乘以weight,这是RMSNorm的一个可学习的缩放因子
output = self._norm(x.float()).type_as(x)return output * self.weightCopy to clipboardErrorCopied
并且,我们可以用下面的代码来对RMSNorm模块进行测试,可以看到代码最终输出的形状为torch.Size([1, 50, 768]),与我们输入的形状一致,说明模块的实现是正确的,归一化并不会改变输入的形状。
代码块
Python
norm = RMSNorm(args.dim, args.norm_eps)
x = torch.randn(1, 50, args.dim)
output = norm(x)print(output.shape)
out:
torch.Size([1, 50, 768])Copy to clipboardErrorCopied
在 LLaMA2 模型中,虽然只有 LLaMA2-70B模型使用了分组查询注意力机制(Grouped-Query Attention,GQA),但我们依然选择使用 GQA 来构建我们的 LLaMA Attention 模块,它可以提高模型的效率,并节省一些显存占用。
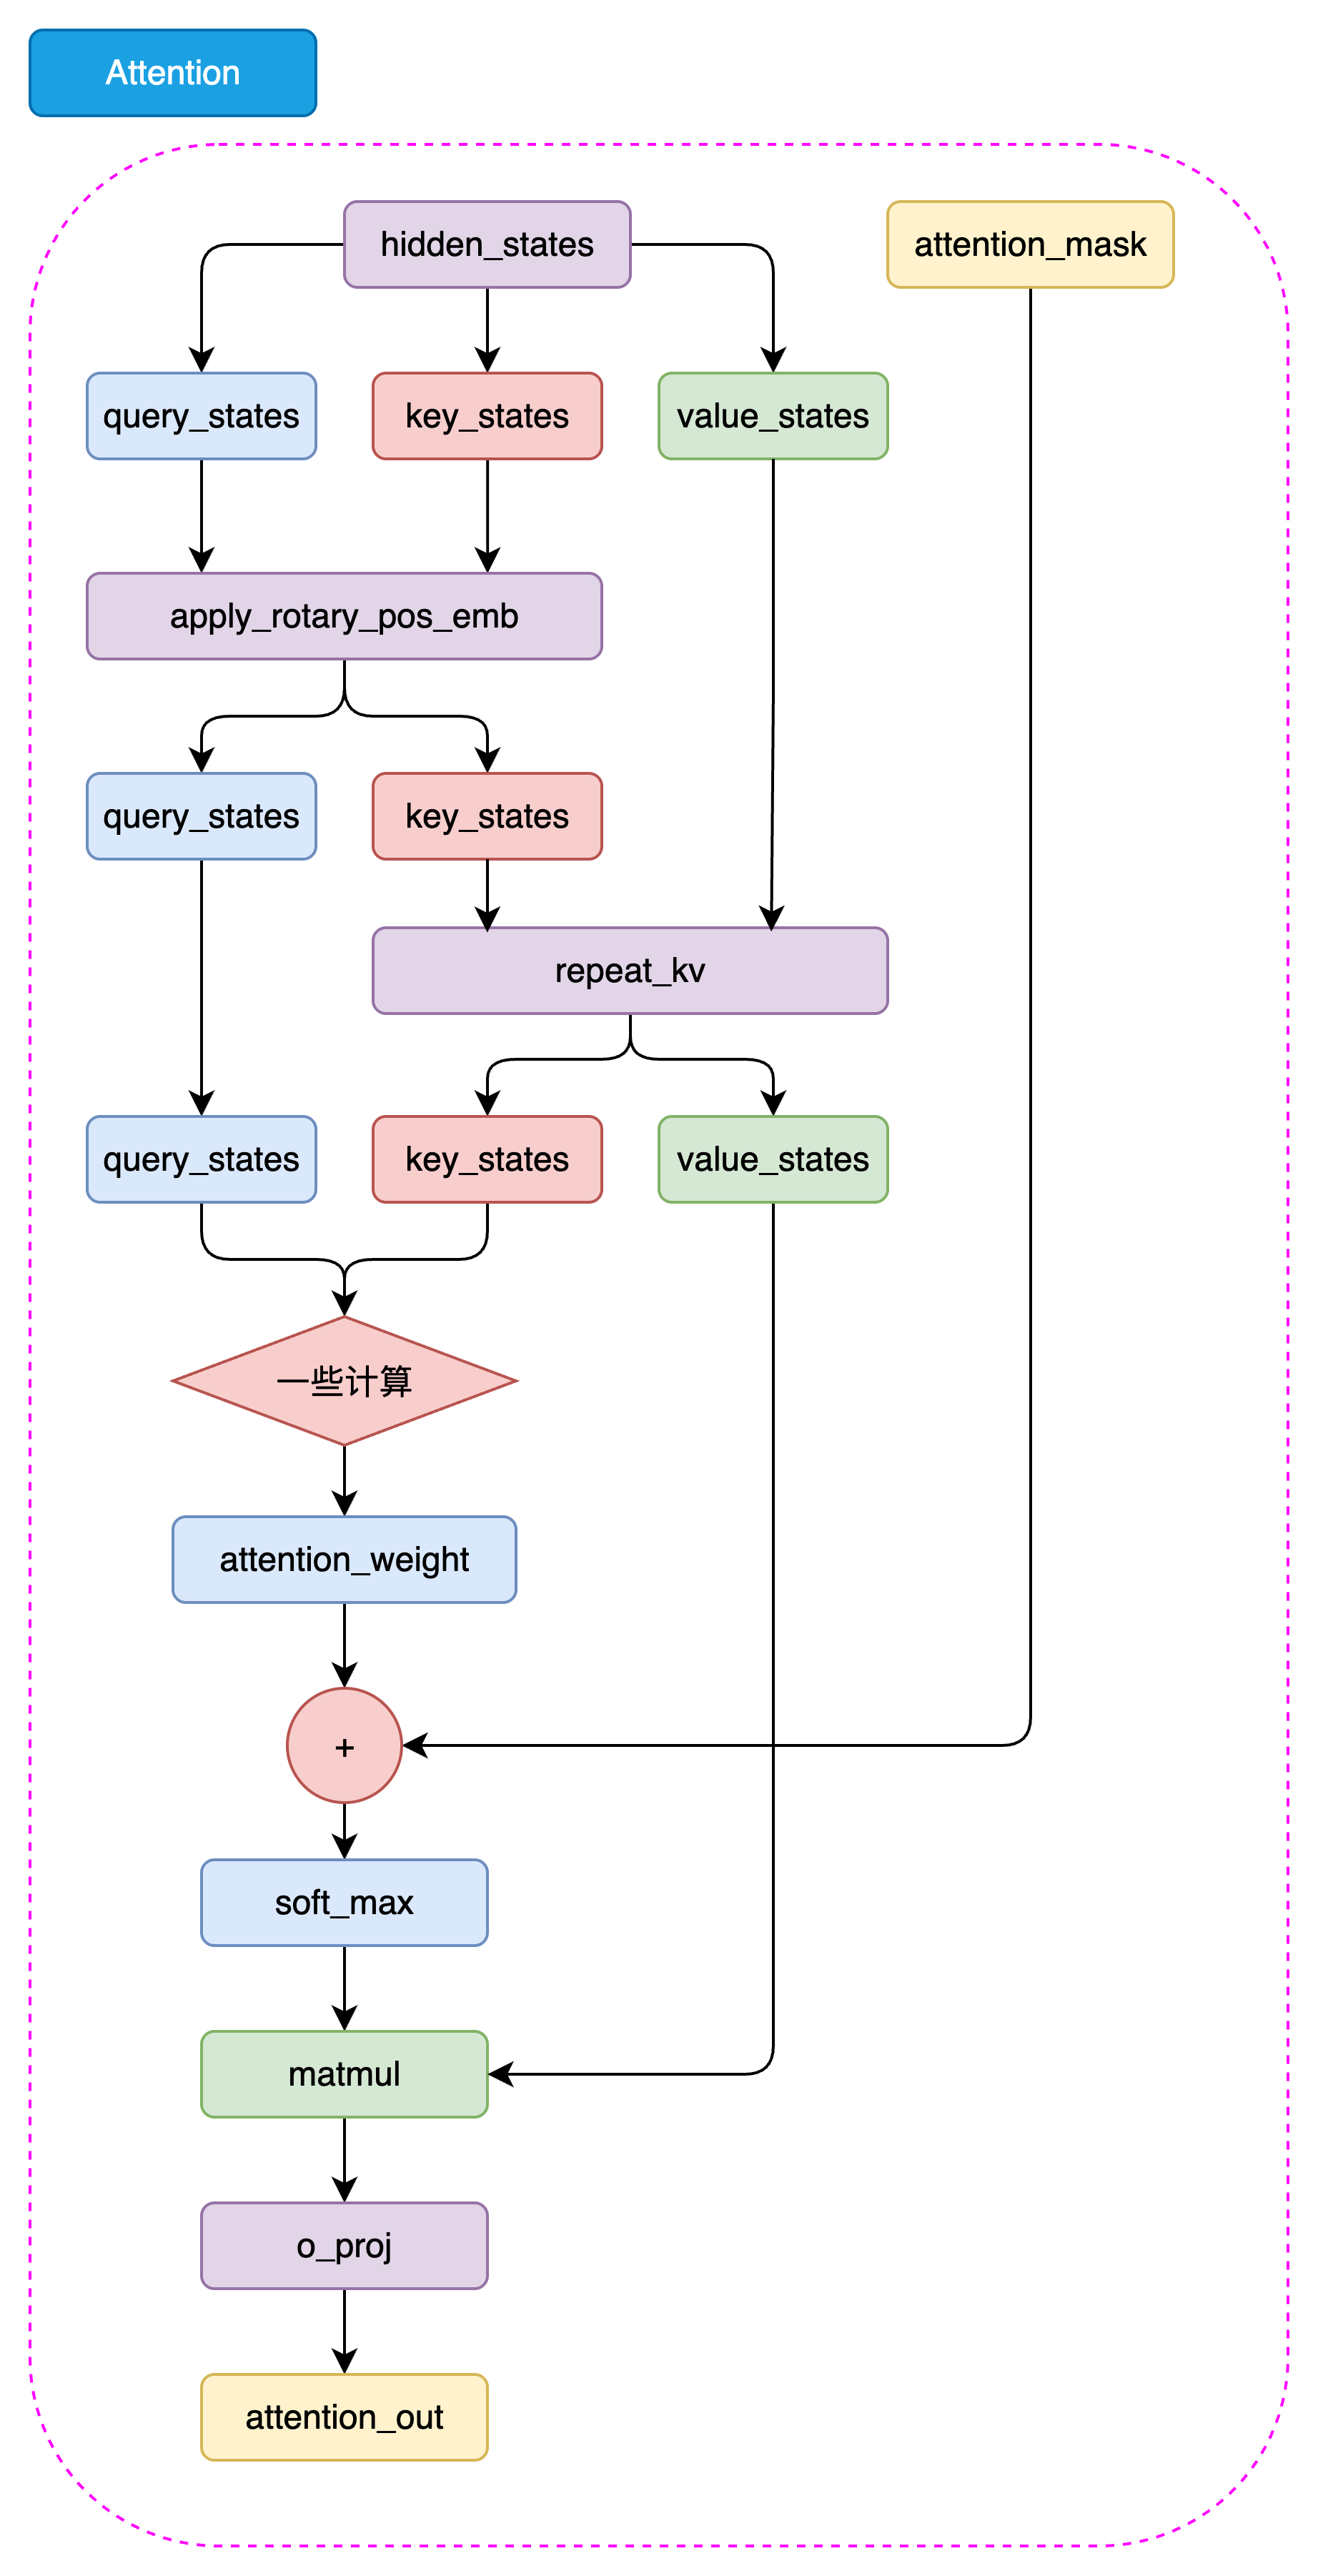
图 5.2 LLaMA2 Attention 结构
在 LLaMA2 模型中,我们需要将键和值的维度扩展到和查询的维度一样,这样才能进行注意力计算。我们可以通过如下代码实现repeat_kv:
代码块
Python
def repeat_kv(x: torch.Tensor, n_rep: int) -> torch.Tensor:# 获取输入张量的形状:批量大小、序列长度、键/值对头的数量、每个头的维度大小
bs, slen, n_kv_heads, head_dim = x.shape
# 如果重复次数为1,则不需要重复,直接返回原始张量if n_rep == 1:return x
# 对张量进行扩展和重塑操作以重复键值对return (
x[:, :, :, None, :] # 在第四个维度(头的维度前)添加一个新的维度.expand(bs, slen, n_kv_heads, n_rep, head_dim) # 将新添加的维度扩展到n_rep大小,实现重复的效果.reshape(bs, slen, n_kv_heads * n_rep, head_dim) # 重新塑形,合并键/值对头的数量和重复次数的维度)Copy to clipboardErrorCopied
在上述代码中:
•
首先,获取输入张量的形状:首先,代码通过 x.shape 获取输入张量的形状,包括批量大小(bs)、序列长度(slen)、键/值对头的数量(n_kv_heads)以及每个头的维度大小(head_dim)。
•
然后,检查重复次数:接着,代码检查重复次数 n_rep 是否为1。如果是1,则说明不需要对键和值进行重复,直接返回原始张量 x。
•
最后,扩展和重塑张量:
◦
在第三个维度(即键/值对头的维度)之后添加一个新的维度,形成 x[:, :, :, None, :]。
◦
使用 expand 方法将新添加的维度扩展到 n_rep 大小,实现键/值对的重复效果。
◦
最后,通过 reshape 方法重新塑形,将扩展后的维度合并回键/值对头的数量中,即 x.reshape(bs, slen, n_kv_heads * n_rep, head_dim),这样最终的张量形状就达到了与查询维度一致的效果。
接着我们来实现旋转嵌入,旋转嵌入是 LLaMA2 模型中的一个重要组件,它可以为注意力机制提供更强的上下文信息,从而提高模型的性能。
首先,我们要构造获得旋转嵌入的实部和虚部的函数:
代码块
Python
# 注意:此处的dim应为 dim//n_head,因为我们是对每个head进行旋转嵌入def precompute_freqs_cis(dim: int, end: int, theta: float = 10000.0):# torch.arange(0, dim, 2)[: (dim // 2)].float()生成了一个从0开始,步长为2的序列,长度为dim的一半# 然后每个元素除以dim,再取theta的倒数,得到频率
freqs = 1.0 / (theta ** (torch.arange(0, dim, 2)[: (dim // 2)].float() / dim))# 生成一个从0到end的序列,长度为end
t = torch.arange(end, device=freqs.device)# 计算外积,得到一个二维矩阵,每一行是t的元素乘以freqs的元素
freqs = torch.outer(t, freqs).float()# 计算频率的余弦值,得到实部
freqs_cos = torch.cos(freqs)# 计算频率的正弦值,得到虚部
freqs_sin = torch.sin(freqs)return freqs_cos, freqs_sinCopy to clipboardErrorCopied
•
计算频率序列:
◦
torch.arange(0, dim, 2)[: (dim // 2)].float() 生成了一个从0开始,步长为2的序列,其长度为dim的一半。
◦
每个元素除以dim后取theta的倒数,得到一个频率序列 freqs。这一步是为了生成适合旋转嵌入的频率。
•
生成时间序列:
◦
t = torch.arange(end, device=freqs.device) 生成一个从0到end的序列,长度为end。end通常是序列的最大长度。
•
计算频率的外积
◦
freqs = torch.outer(t, freqs).float() 计算时间序列 t 和频率序列 freqs 的外积,得到一个二维矩阵 freqs。每一行是时间序列 t 的元素乘以频率序列 freqs 的元素。
•
计算实部和虚部
◦
freqs_cos = torch.cos(freqs) 计算频率矩阵 freqs 的余弦值,得到旋转嵌入的实部。
◦
freqs_sin = torch.sin(freqs) 计算频率矩阵 freqs 的正弦值,得到旋转嵌入的虚部。
最终,该函数返回两个矩阵 freqs_cos 和 freqs_sin,分别表示旋转嵌入的实部和虚部,用于后续的计算。
接着,我们来构造调整张量形状的reshape_for_broadcast函数,这个函数的主要目的是调整 freqs_cis 的形状,使其在进行广播操作时与 x 的维度对齐,从而能够进行正确的张量运算。
代码块
Python
def reshape_for_broadcast(freqs_cis: torch.Tensor, x: torch.Tensor):# 获取x的维度数
ndim = x.ndim
# 断言,确保1在x的维度范围内assert 0 <= 1 < ndim
# 断言,确保freqs_cis的形状与x的第二维和最后一维相同assert freqs_cis.shape == (x.shape[1], x.shape[-1])# 构造一个新的形状,除了第二维和最后一维,其他维度都为1,这样做是为了能够将freqs_cis与x进行广播操作
shape = [d if i == 1 or i == ndim - 1 else 1 for i, d in enumerate(x.shape)]# 将freqs_cis调整为新的形状,并返回return freqs_cis.view(shape)Copy to clipboardErrorCopied
最后,我们可以通过如下代码实现旋转嵌入:
代码块
Python
这里我们给出可以测试apply_rotary_emb函数的代码,大家也可以尝试在代码中添加断点,来查看每一步的计算结果。
代码块
Python
xq = torch.randn(1, 50, 6, 48) # bs, seq_len, dim//n_head, n_head_dim
xk = torch.randn(1, 50, 6, 48) # bs, seq_len, dim//n_head, n_head_dim# 使用 precompute_freqs_cis 函数获取 sin和cos
cos, sin = precompute_freqs_cis(288//6, 50)print(cos.shape, sin.shape)
xq_out, xk_out = apply_rotary_emb(xq, xk, cos, sin)
xq_out.shape, xk_out.shapeCopy to clipboardErrorCopied
OUT:
代码块
Python
torch.Size([50, 24]) torch.Size([50, 24])
在上面我们已经完成了旋转嵌入的实现,接下来我们就可以构建 LLaMA2 Attention 模块了。
代码块
Python
class Attention(nn.Module):def __init__(self, args: ModelConfig):super().__init__()# 根据是否指定n_kv_heads,确定用于键(key)和值(value)的头的数量。
self.n_kv_heads = args.n_heads if args.n_kv_heads is None else args.n_kv_heads
# 确保总头数可以被键值头数整除。assert args.n_heads % self.n_kv_heads == 0# 模型并行处理大小,默认为1。
model_parallel_size = 1# 本地计算头数,等于总头数除以模型并行处理大小。
self.n_local_heads = args.n_heads // model_parallel_size
# 本地键值头数,等于键值头数除以模型并行处理大小。
self.n_local_kv_heads = self.n_kv_heads // model_parallel_size
# 重复次数,用于扩展键和值的尺寸。
self.n_rep = self.n_local_heads // self.n_local_kv_heads
# 每个头的维度,等于模型维度除以头的总数。
self.head_dim = args.dim // args.n_heads
同样大家可以使用下面的代码来对注意力模块进行测试,可以看到代码最终输出的形状为torch.Size([1, 50, 768]),与我们输入的形状一致,说明模块的实现是正确的。
代码块
Python
OUT:
代码块
Python
相对于前面我们实现的LLaMA2 Attention模块,LLaMA2 MLP模块的实现要简单一些。我们可以通过如下代码实现MLP:
代码块
Plain Text
class MLP(nn.Module):def __init__(self, dim: int, hidden_dim: int, multiple_of: int, dropout: float):super().__init__()# 如果没有指定隐藏层的维度,我们将其设置为输入维度的4倍# 然后将其减少到2/3,最后确保它是multiple_of的倍数if hidden_dim is None:
hidden_dim = 4 * dim
hidden_dim = int(2 * hidden_dim / 3)
hidden_dim = multiple_of * ((hidden_dim + multiple_of - 1) // multiple_of)# 定义第一层线性变换,从输入维度到隐藏维度
self.w1 = nn.Linear(dim, hidden_dim, bias=False)# 定义第二层线性变换,从隐藏维度到输入维度
self.w2 = nn.Linear(hidden_dim, dim, bias=False)# 定义第三层线性变换,从输入维度到隐藏维度
self.w3 = nn.Linear(dim, hidden_dim, bias=False)# 定义dropout层,用于防止过拟合
self.dropout = nn.Dropout(dropout)def forward(self, x):# 前向传播函数# 首先,输入x通过第一层线性变换和SILU激活函数# 然后,结果乘以输入x通过第三层线性变换的结果# 最后,通过第二层线性变换和dropout层return self.dropout(self.w2(F.silu(self.w1(x)) * self.w3(x)))Copy to clipboardErrorCopied
我们着重观察一下forward函数的实现,首先,输入 x 通过第一层线性变换 self.w1 和 SILU 激活函数,然后,结果乘以输入 x 通过第三层线性变换 self.w3 的结果,最后,通过第二层线性变换 self.w2 和 dropout 层,得到最终输出。
同样大家可以使用下面的代码来对LLaMAMLP模块进行测试,可以看到代码最终输出的形状为torch.Size([1, 50, 768]),与我们输入的形状一致,说明模块的实现是正确的。
代码块
Python
# 创建MLP实例
mlp = MLP(args.dim, args.hidden_dim, args.multiple_of, args.dropout)# 随机生成数据
x = torch.randn(1, 50, args.dim)# 运行MLP模型
output = mlp(x)print(output.shape)Copy to clipboardErrorCopied
OUT:
代码块
Plain Text
torch.Size([1, 50, 768])Copy to clipboardErrorCopied
到这里,我们已经实现了LLaMA2模型的Attention模块和MLP模块,接下来我们就可以构建LLaMA2的Decoder Layer了。
代码块
Python
class DecoderLayer(nn.Module):def __init__(self, layer_id: int, args: ModelConfig):super().__init__()# 定义多头注意力的头数
self.n_heads = args.n_heads
# 定义输入维度
self.dim = args.dim
# 定义每个头的维度,等于输入维度除以头数
self.head_dim = args.dim // args.n_heads
# 定义LLaMA2Attention对象,用于进行多头注意力计算
self.attention = Attention(args)# 定义LLaMAMLP对象,用于进行前馈神经网络计算
self.feed_forward = MLP(
dim=args.dim,
hidden_dim=args.hidden_dim,
multiple_of=args.multiple_of,
dropout=args.dropout,)# 定义层的ID
self.layer_id = layer_id
# 定义注意力计算的归一化层
DecoderLayer就是把我们上面完成的Attention模块和MLP模块组合在一起,实现了一个完整的Transformer模块。
同样大家可以使用下面的代码来对DecoderLayer模块进行测试,可以看到代码最终输出的形状为torch.Size([1, 50, 768]),与我们输入的形状一致,说明模块的实现是正确的。
代码块
Python
# 创建LLaMADecoderLayer实例
decoderlayer = DecoderLayer(0, args)# 模拟输入数据
dim = args.dim
seq_len = 50
x = torch.randn(1, seq_len, dim) # [bs, seq_len, dim]
freqs_cos, freqs_sin = precompute_freqs_cis(dim//args.n_heads, seq_len)
OUT:
代码块
Plain Text
torch.Size([1, 50, 768])Copy to clipboardErrorCopied
好了,我们已经完了上述所有的模块的实现,接下来就是激动人心的时刻,我们可以构建LLaMA2模型了。,LLaMA2模型就是将DecoderLayer模块堆叠起来,构成一个完整的Transformer模型。
代码块
Python
class Transformer(PreTrainedModel):
config_class = ModelConfig # 配置类
同样大家可以使用下面的代码来对Transformer模块进行测试,可以看到代码最终输出的形状为torch.Size([1, 1, 6144]),与我们输入的形状一致,说明模块的实现是正确的。
代码块
Python
# LLaMA2Model.forward 接受两个参数,tokens和targets,其中tokens是输入的张量, 应为int类型
x = torch.randint(0, 6144, (1, 50)) # [bs, seq_len]# 实例化LLaMA2Model
model = Transformer(args=args)# 计算model的全部参数
num_params = sum(p.numel() for p in model.parameters())print('Number of parameters:', num_params)
out = model(x)print(out.logits.shape) # [batch_size, 1, vocab_size]Copy to clipboardErrorCopied
OUT:
代码块
Plain Text
Number of parameters: 82594560
torch.Size([1, 1, 6144])Copy to clipboardErrorCopied
在自然语言处理 (NLP) 中,Tokenizer 是一种将文本分解为较小单位(称为 token)的工具。这些 token 可以是词、子词、字符,甚至是特定的符号。Tokenization 是 NLP 中的第一步,直接影响后续处理和分析的效果。不同类型的 tokenizer 适用于不同的应用场景,以下是几种常见的 tokenizer 及其特点。
Word-based Tokenizer 是最简单和直观的一种分词方法。它将文本按空格和标点符号分割成单词。这种方法的优点在于其简单和直接,易于实现,且与人类对语言的直觉相符。然而,它也存在一些明显的缺点,如无法处理未登录词(OOV,out-of-vocabulary)和罕见词,对复合词(如“New York”)或缩略词(如“don't”)的处理也不够精细。此外,Word-based Tokenizer 在处理不同语言时也会遇到挑战,因为一些语言(如中文、日文)没有显式的单词分隔符。
示例:
代码块
Python
在这个例子中,输入的句子被分割成一系列单词和标点符号,每个单词或标点符号都作为一个独立的 token。
5.2.2 Character-based Tokenizer
Character-based Tokenizer 将文本中的每个字符视为一个独立的 token。这种方法能非常精细地处理文本,适用于处理拼写错误、未登录词或新词。由于每个字符都是一个独立的 token,因此这种方法可以捕捉到非常细微的语言特征。这对于一些特定的应用场景,如生成式任务或需要处理大量未登录词的任务,特别有用。但是,这种方法也会导致 token 序列变得非常长,增加了模型的计算复杂度和训练时间。此外,字符级的分割可能会丢失一些词级别的语义信息,使得模型难以理解上下文。
示例:
代码块
Plain Text
在这个例子中,单词“Hello”被分割成单个字符,每个字符作为一个独立的 token。这种方法能够处理任何语言和字符集,具有极大的灵活性。
Subword Tokenizer 介于词和字符之间,能够更好地平衡分词的细粒度和处理未登录词的能力。Subword Tokenizer 的关键思想是将文本分割成比单词更小的单位,但又比字符更大,这样既能处理未知词,又能保持一定的语义信息。常见的子词分词方法包括 BPE、WordPiece 和 Unigram。
BPE 是一种基于统计方法,通过反复合并频率最高的字符或字符序列对来生成子词词典。这种方法的优点在于其简单和高效,能够有效地处理未知词和罕见词,同时保持较低的词典大小。BPE 的合并过程是自底向上的,逐步将频率最高的字符对合并成新的子词,直到达到预定的词典大小或不再有高频的字符对。
示例:
代码块
Plain Text
Input: "lower"
Output: ["low", "er"]
Input: "newest"
Output: ["new", "est"]
在这个例子中,单词“lower”被分割成子词“low”和“er”,而“newest”被分割成“new”和“est”。这种方法有效地处理了词干和词缀,保持了单词的基本语义结构。
WordPiece 是另一种基于子词的分词方法,最初用于谷歌的 BERT 模型。与 BPE 类似,WordPiece 通过最大化子词序列的似然函数来生成词典,但在合并子词时更注重语言模型的优化。WordPiece 会优先选择能够最大化整体句子概率的子词,使得分词结果在语言模型中具有更高的概率。
示例:
代码块
Plain Text
在这个例子中,单词“unhappiness”被分割成子词“un”和“##happiness”,其中“##”表示这是一个后缀子词。通过这种方式,WordPiece 能够更好地处理复合词和派生词,保留更多的语义信息。
Unigram 分词方法基于概率模型,通过选择具有最高概率的子词来分割文本。Unigram 词典是通过训练语言模型生成的,可以处理多种语言和不同类型的文本。Unigram 模型会为每个子词分配一个概率,然后根据这些概率进行最优分割。
示例:
代码块
Plain Text
Input: "unhappiness"
Output: ["un", "happiness"]
Input: "newest"
Output: ["new", "est"]
在这个例子中,单词“unhappiness”被分割成子词“un”和“happiness”,而“newest”被分割成“new”和“est”。这种方法通过概率模型有效地处理了子词分割,使得分割结果更符合语言使用习惯。
每种 Tokenizer 方法都有其特定的应用场景和优缺点,选择适合的 Tokenizer 对于自然语言处理任务的成功至关重要。
这里我们选择使用 BPE 算法来训练一个 Subword Tokenizer。BPE 是一种简单而有效的分词方法,能够处理未登录词和罕见词,同时保持较小的词典大小。我们将使用 Hugging Face 的 tokenizers 库来训练一个 BPE Tokenizer。
首先,我们需要安装 tokenizers 库,除此之外还需要安装 datasets 和 transformers 库,用于加载训练数据和加载训练完成后的 Tokenizer。
代码块
Plain Text
pip install tokenizers datasets transformers
然后,导入所需的库。
代码块
Plain Text
import random
import json
import os
from transformers import AutoTokenizer, PreTrainedTokenizerFast
from tokenizers import (
decoders,
models,
pre_tokenizers,
trainers,
Tokenizer,)from tokenizers.normalizers import NFKC
from typing import GeneratorCopy to clipboardErrorCopied
这里我们使用与预训练相同的数据集(出门问问序列猴子开源数据集)训练tokenizer,可使用code/download_dataset.sh 和 code/deal_dataset.py 下载和预处理数据集。
注:由于数据集过大,可能会导致在训练过程中内存不足。因为本项目为学习目的,建议学习者手动分割小部分数据集用于训练验证,笔者也在 Github 仓库中存放了训练好的 tokenizer,可以直接使用。
代码块
Python
def read_texts_from_jsonl(file_path: str) -> Generator[str, None, None]:"""读取JSONL文件并安全提取文本数据"""with open(file_path, 'r', encoding='utf-8') as f:for line_num, line in enumerate(f, 1):try:
data = json.loads(line)if 'text' not in data:raise KeyError(f"Missing 'text' field in line {line_num}")yield data['text']except json.JSONDecodeError:print(f"Error decoding JSON in line {line_num}")continueexcept KeyError as e:print(e)continueCopy to clipboardErrorCopied
在训练 BPE Tokenizer 之前,我们需要创建一个完整的 Tokenizer 配置文件,包括 tokenizer_config.json 和 special_tokens_map.json。这些配置文件定义了 Tokenizer 的参数和特殊标记,用于训练和加载 Tokenizer。此处的chat_template我们与Qwen2.5模型保持一致。
代码块
Python
def create_tokenizer_config(save_dir: str) -> None:"""创建完整的tokenizer配置文件"""
config = {"add_bos_token": False,"add_eos_token": False,"add_prefix_space": False,"bos_token": "<|im_start|>","eos_token": "<|im_end|>","pad_token": "<|im_end|>","unk_token": "
json.dump(config, f, ensure_ascii=False, indent=4)# 创建special_tokens_map.json
special_tokens_map = {"bos_token": "<|im_start|>","eos_token": "<|im_end|>","unk_token": "", ""]}with open(os.path.join(save_dir, "special_tokens_map.json"), "w", encoding="utf-8") as f:
在训练 BPE Tokenizer 之前,我们需要定义一个训练函数,用于训练 Tokenizer 并保存训练好的 Tokenizer 文件。这里我们使用 tokenizers 库中的 Tokenizer 类来训练 BPE Tokenizer。
可以看到我们在训练 Tokenizer 时,配置了一些特殊的 token,如 、、<|im_start|> 和 <|im_end|>。这些 token 用于标记未知词、句子的开始和结束,以及对话的开始和结束。这些特殊 token 可以帮助模型更好地理解文本数据,提高模型的泛化能力和效果。
代码块
Python
def train_tokenizer(data_path: str, save_dir: str, vocab_size: int = 8192) -> None:"""训练并保存自定义tokenizer"""
os.makedirs(save_dir, exist_ok=True)# 初始化tokenizer
tokenizer = Tokenizer(models.BPE(unk_token="
tokenizer.normalizer = NFKC() # 添加文本规范化
tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)
tokenizer.decoder = decoders.ByteLevel()# 配置特殊token
我们可以使用训练好的 Tokenizer 来处理文本数据,如编码、解码、生成对话等。下面是一个简单的示例,展示了如何使用训练好的 Tokenizer 来处理文本数据。
代码块
Python
def eval_tokenizer(tokenizer_path: str) -> None:"""评估tokenizer功能"""try:
tokenizer = AutoTokenizer.from_pretrained(tokenizer_path)except Exception as e:print(f"Error loading tokenizer: {e}")return# 测试基本属性print("\n=== Tokenizer基本信息 ===")print(f"Vocab size: {len(tokenizer)}")print(f"Special tokens: {tokenizer.all_special_tokens}")print(f"Special token IDs: {tokenizer.all_special_ids}")# 测试聊天模板
messages = [{"role": "system", "content": "你是一个AI助手。"},{"role": "user", "content": "How are you?"},{"role": "assistant", "content": "I'm fine, thank you. and you?"},{"role": "user", "content": "I'm good too."},{"role": "assistant", "content": "That's great to hear!"},]print("\n=== 聊天模板测试 ===")
prompt = tokenizer.apply_chat_template(
messages,
tokenize=False,
# add_generation_prompt=True)print("Generated prompt:\n", prompt, sep="")# 测试编码解码print("\n=== 编码解码测试 ===")
encoded = tokenizer(prompt, truncation=True, max_length=256)
decoded = tokenizer.decode(encoded["input_ids"], skip_special_tokens=False)print("Decoded text matches original:", decoded == prompt)# 测试特殊token处理print("\n=== 特殊token处理 ===")
代码块
Plain Text
eval_tokenizer('your tokenizer path')Copy to clipboardErrorCopied
OUT:
代码块
Python
=== Tokenizer基本信息 ===
Vocab size: 6144
Special tokens: ['<|im_start|>', '<|im_end|>', '', '']
Special token IDs: [3, 4, 0, 1, 2]
在前面的章节中,我们熟悉了各种大模型的模型结构,以及如如何训练Tokenizer。在本节中,我们将动手训练一个八千万参数的LLM。
首先,我们需要下载预训练数据集。在这里,我们使用两个开源的数据集,包含了大量的中文对话数据,可以用于训练对话生成模型。
•
出门问问序列猴子开源数据集:出门问问序列猴子通用文本数据集由来自网页、百科、博客、问答、开源代码、书籍、报刊、专利、教材、考题等多种公开可获取的数据进行汇总清洗之后而形成的大语言模型预训练语料。总量大概在 10B Token。
•
BelleGroup:350万条中文对话数据集,包含了人机对话、人人对话、人物对话等多种对话数据,可以用于训练对话生成模型。
代码块
Python
# 下载预训练数据集
os.system("modelscope download --dataset ddzhu123/seq-monkey mobvoi_seq_monkey_general_open_corpus.jsonl.tar.bz2 --local_dir your_local_dir")# 解压预训练数据集
首先,我们需要为文本处理训练一个Tokenizer。Tokenizer的作用是将文本转换为数字序列,以便模型能够理解和处理。我们使用的数据集是 出门问问序列猴子开源数据集 ,这个数据集包含了大量的中文文本数据,可以用于训练Tokenizer。
注:由于数据集较大,如果大家在自己本地电脑训练的话进度比较慢,所以在这里我们提供了一个已经训练好的Tokenizer,大家可以直接使用。如果大家想要自己训练的话,可以参考下面的代码。
代码块
Plain Text
python code/train_tokenizer.pyCopy to clipboardErrorCopied
代码块
Python
import random
import json
import os
from transformers import AutoTokenizer, PreTrainedTokenizerFast
from tokenizers import (
decoders,
models,
pre_tokenizers,
trainers,
Tokenizer,)from tokenizers.normalizers import NFKC
from typing import Generator
random.seed(42)def read_texts_from_jsonl(file_path: str) -> Generator[str, None, None]:"""读取JSONL文件并安全提取文本数据"""with open(file_path, 'r', encoding='utf-8') as f:for line_num, line in enumerate(f, 1):try:
训练完成之后可以可以使用 eval_tokenizer() 测试 Tokenizer 的功能,确保 Tokenizer 正常工作。在这个函数中,我们首先加载训练好的 Tokenizer,然后测试了 Tokenizer 的基本属性、聊天模板、编码解码等功能。这些测试可以帮助我们验证 Tokenizer 的正确性,确保它能够正常工作。正确的输出为:
OUT:
代码块
Python
=== Tokenizer基本信息 ===
Vocab size: 6144
Special tokens: ['<|im_start|>', '<|im_end|>', '', '']
Special token IDs: [3, 4, 0, 1, 2]
=== 聊天模板测试 ===
Generated prompt:
<|im_start|>system
你是一个AI助手。<|im_end|><|im_start|>user
How are you?<|im_end|><|im_start|>assistant
在将数据送入到模型之前,我们还需要进行一些处理用于将文本数据转化为模型能够理解的Token。在这里我们使用的是Pytorch的Dataset类,用于加载数据集。我们定义了一个PretrainDataset类,用于加载已预处理好的数据集。我们继承了torch.utils.data.IterableDataset来定义该数据集,这使得我们可以更灵活、高效地处理数据。
代码块
Python
from torch.utils.data import Dataset
class PretrainDataset(Dataset):def __init__(self, data_path, tokenizer, max_length=512):super().__init__()
self.data_path = data_path
self.tokenizer = tokenizer
self.max_length = max_length
self.padding = tokenizer.pad_token_id if tokenizer.pad_token_id is not None else 0# 预计算每行的起始字节偏移量
self._offsets = []with open(data_path, 'rb') as f:
self._offsets.append(0)while f.readline():
self._offsets.append(f.tell())
self._total_lines = len(self._offsets) - 1 # 最后一个 tell() 是 EOFdef __len__(self):return self._total_lines
def __getitem__(self, index: int):with open(self.data_path, 'rb') as f:
f.seek(self._offsets[index])
line = f.readline().decode('utf-8')
在以上代码和图5.3可以看出,Pretrain Dataset 主要是将 text 通过 tokenizer 转换成 input_id,然后将 input_id 拆分成 X 和 Y,其中 X 为 input_id 的前 n-1 个元素,Y 为 input_id 的后 n-1 个元素。loss_mask 主要是用来标记哪些位置需要计算损失,哪些位置不需要计算损失。
图5.3 预训练损失函数计算
图中示例展示了当max_length=9时的处理过程:
•
输入序列:[BOS, T1, T2, T3, T4, T5, T6, T7, EOS]
•
样本拆分:
◦
X:[BOS, T1, T2, T3, T4, T5, T6, T7] → 模型输入上下文
◦
Y:[T1, T2, T3, T4, T5, T6, T7, EOS] → 模型预测目标
•
损失掩码:
◦
有效位置:[0, 1, 1, 1, 1, 1, 1, 1, 1] → 仅对T1-EOS计算损失
SFTDataset 其实是一个多轮对话数据集,我们的目标是让模型学会如何进行多轮对话。在这个阶段我们的输入是上一轮的对话内容,输出是当前轮的对话内容。
代码块
Python
class SFTDataset(Dataset):def __init__(self, data_path, tokenizer, max_length=512):super().__init__()
在 SFT 阶段,这里使用的是多轮对话数据集,所以就需要区分哪些位置需要计算损失,哪些位置不需要计算损失。在上面的代码中,我使用了一个 generate_loss_mask 函数来生成 loss_mask。这个函数主要是用来生成 loss_mask,其中 loss_mask 的生成规则是:当遇到 |<im_start|>assistant\n 时,就开始计算损失,直到遇到 |<im_end|> 为止。这样就可以保证我们的模型在 SFT 阶段只计算当前轮的对话内容,如图5.4所示。
图5.4 SFT 损失函数计算
可以看到,其实 SFT Dataset 和 Pretrain Dataset 的 X 和 Y 是一样的,只是在 SFT Dataset 中我们需要生成一个 loss_mask 来标记哪些位置需要计算损失,哪些位置不需要计算损失。 图中 Input ids 中的蓝色小方格就是AI的回答,所以是需要模型学习的地方。所以在 loss_mask 中,蓝色小方格对应的位置是黄色,其他位置是灰色。在代码 loss_mask 中的 1 对应的位置计算损失,0 对应的位置不计算损失。
在数据预处理完成后,我们就可以开始训练模型了。我们使用的模型是一个和LLama2结构一样的 Decoder only Transformer模型,使用Pytorch实现。相关代码在code/k_model.py文件中。此处不再赘述,源码中有详细的中文注释,且我们在之前的文章中也有详细的介绍。
在模型这一部分可以重点看一下生成式模型是如何实现生成token的,可以查看k_model.py文件中的Transforerm类中的generate方法。
代码块
Python
@torch.inference_mode()def generate(self, idx, stop_id=None, max_new_tokens=256, temperature=1.0, top_k=None):"""
给定输入序列 idx(形状为 (bz,seq_len) 的长整型张量),通过多次生成新 token 来完成序列。
在 model.eval() 模式下运行。效率较低的采样版本,没有使用键k/v cache。
"""
index = idx.shape[1]for _ in range(max_new_tokens):# 如果序列上下文过长,截断它到最大长度
idx_cond = idx if idx.size(1) <= self.args.max_seq_len else idx[:, -self.args.max_seq_len:]# 前向传播获取序列中最后一个位置的 logits
logits = self(idx_cond).logits
在 generate 方法中,我们首先获取序列中最后一个位置的 logits,然后基于这些 logits 生成新的 token。接着,生成的新 token 会被添加到序列中,模型随后会继续生成下一个 token。通过这种迭代过程,我们能够生成完整的文本。
接下来就是最重要的部分,训练模型!
注:在使用下面代码进行模型训练时,需要指定 --data_path 参数为预处理好的数据集路径,例如 --data_path seq_monkey_datawhale.jsonl,也需要指定要用哪几张GPU进行训练,例如 --gpus 0,1。
代码块
Python
def get_lr(it, all):"""
计算当前迭代的学习率,使用余弦退火调度策略
学习率调度策略:
1. Warmup阶段:学习率从0线性增长到目标学习率
2. 余弦退火阶段:学习率按余弦函数衰减到最小学习率
3. 超出训练步数后:保持最小学习率
Args:
it (int): 当前迭代步数
all (int): 总迭代步数
Returns:
float: 当前步数对应的学习率
"""
warmup_iters = args.warmup_iters # 预热迭代次数
SFT 训练和预训练的代码基本一样,只是导入的 Dataset 不一样。在这里我们使用的是 SFTDataset,用于多轮对话的训练。
代码块
Python
import os
import platform
import argparse
import time
在模型训练完成后,会在output目录下生成模型文件,这个文件就是我们训练好的模型。我们可以使用以下命令生成文本。
代码块
Plain Text
python model_sample.pyCopy to clipboardErrorCopied
我们来看下model_sample.py文件中的代码,这个文件中定义了一个TextGenerator类,用于生成文本。
代码块
Python
import os
import pickle
from contextlib import nullcontext
import torch
from k_model import ModelConfig, Transformer
from transformers import AutoTokenizer, AutoModelForCausalLM
最后我们来看一下模型输出的结果:
代码块
Python
------------------- SFT Sample -------------------
Model has 215.127 M parameters.
Sample 1:
Question: 你好呀
AI answer: 你好!有什么我可以帮你的吗?
--------------------
Sample 2:
Question: 中国的首都是哪里?
AI answer: 中国的首都是北京。
--------------------
Sample 3:
Question: 1+1等于多少?
AI answer: 1+1等于2。
--------------------
到这里,我们的模型就训练完成了,恭喜你训练了一个属于你自己的大模型。
大家在训练的时候可以将 batch 调的低一些,这样可以减少显存的占用,避免显存不足的问题。当然这样会增加训练时间,可以根据自己的显卡显存大小来调整 batch 的大小。实测 Pretrain batch 为 4 的情况下只需要 7G 显存,训练时长预计 533 小时。作者是在 8卡4090 上进行训练的,预训练一共耗时 46 小时,SFT 阶段在 BelleGroup 350万条中文指令训练 24 小时。