第二章 Transformer 架构
2.1 注意力机制
2.1.1 什么是注意力机制
随着 NLP 从统计机器学习向深度学习迈进,作为 NLP 核心问题的文本表示方法也逐渐从统计学习向深度学习迈进。正如我们在第一章所介绍的,文本表示从最初的通过统计学习模型进行计算的向量空间模型、语言模型,通过 Word2Vec 的单层神经网络进入到通过神经网络学习文本表示的时代。但是,从 计算机视觉(Computer Vision,CV)为起源发展起来的神经网络,其核心架构有三种:
•
前馈神经网络(Feedforward Neural Network,FNN),即数据从输入层单向流动到输出层,无循环结构,各层之间通过全连接或特定方式传递信息,其中多层感知机(Multi-Layer Perceptron,MLP)是最常见的形式,每一层的神经元都和上下两层的每一个神经元完全连接,如图2.1所示:
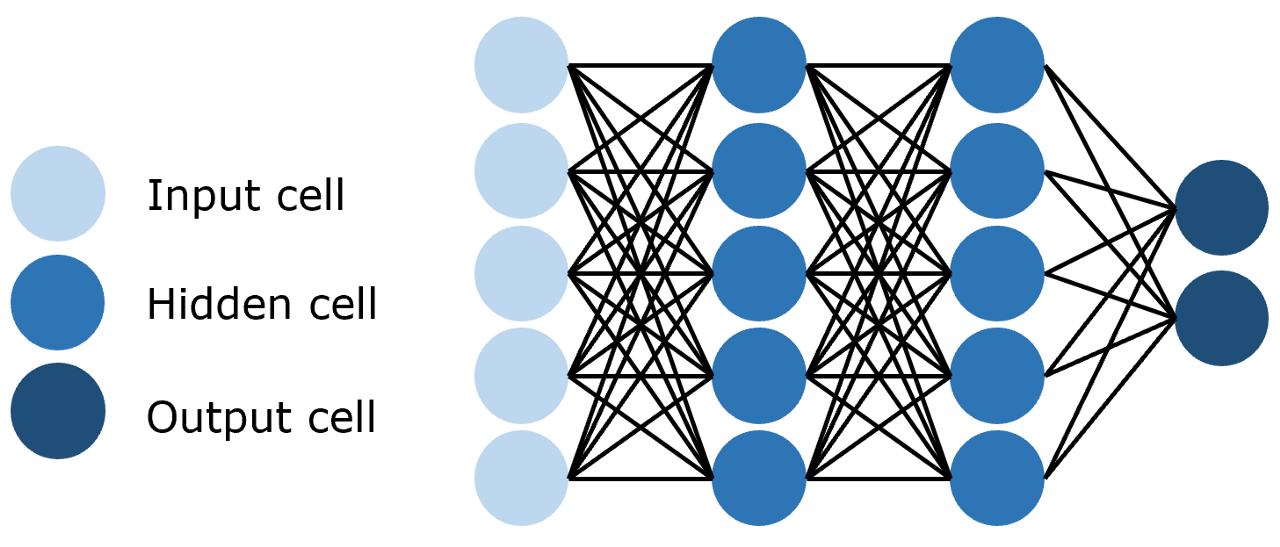
图2.1 全连接神经网络
•
卷积神经网络(Convolutional Neural Network,CNN),即训练参数量远小于全连接神经网络的卷积层来进行特征提取和学习,如图2.2所示:
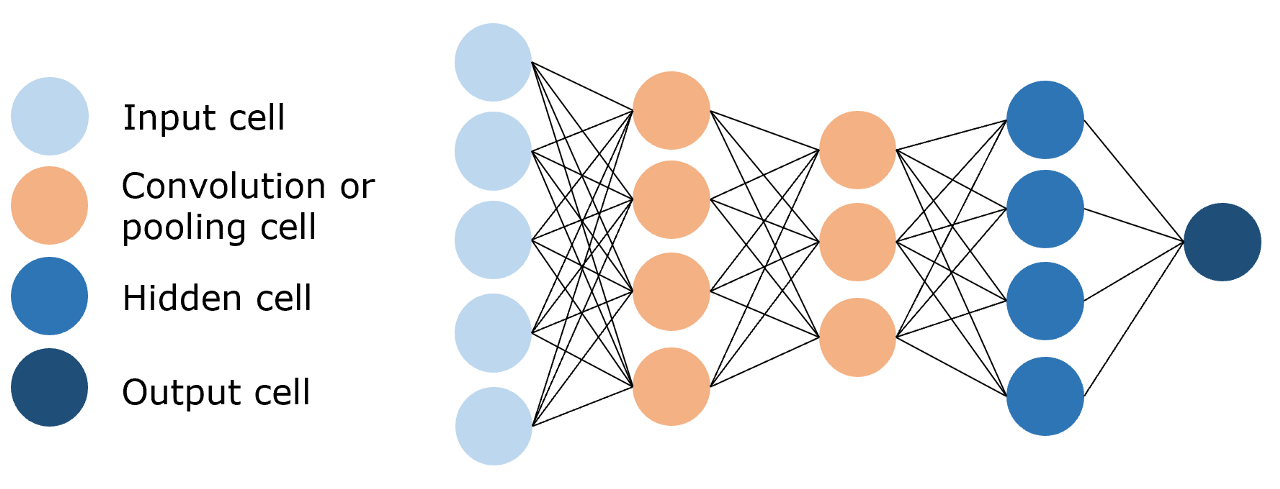
图2.2 卷积神经网络
•
循环神经网络(Recurrent Neural Network,RNN),能够使用历史信息作为输入、包含环和自重复的网络,如图2.3所示:
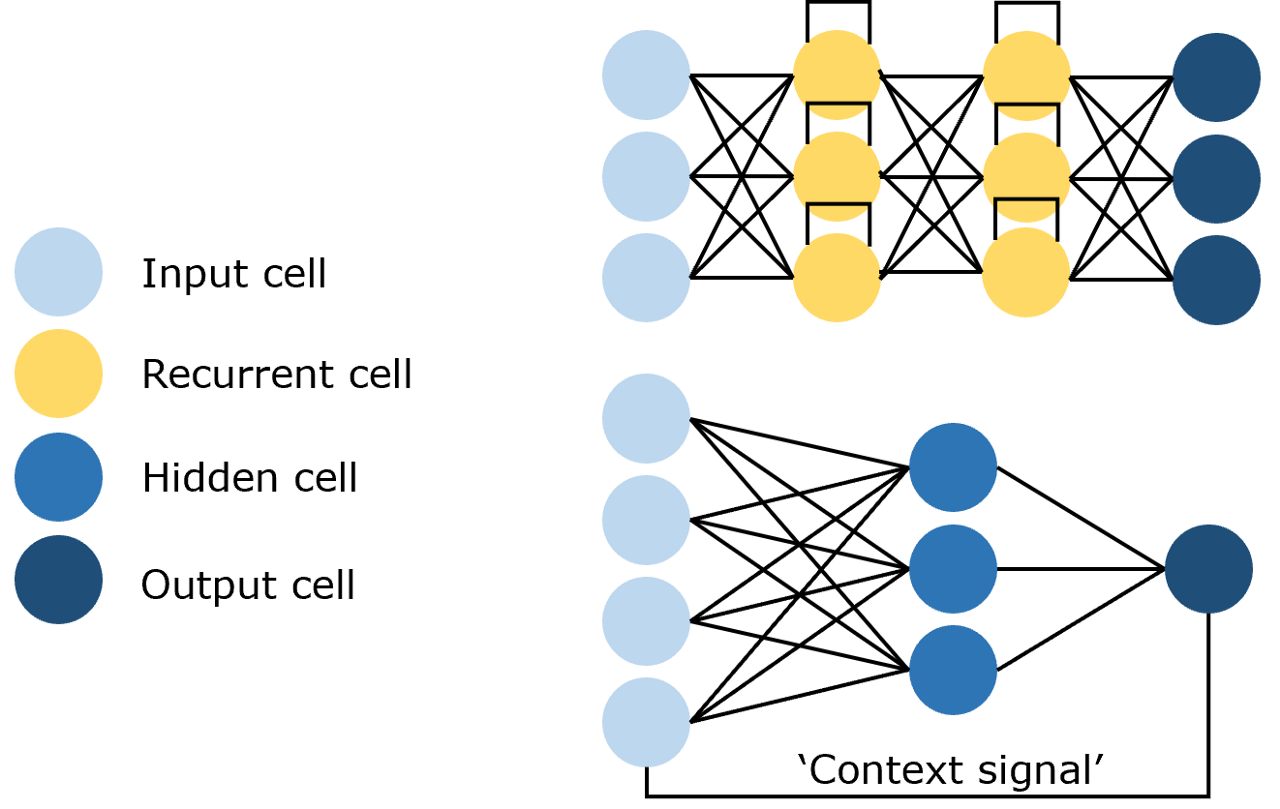
图2.3 循环神经网络
由于 NLP 任务所需要处理的文本往往是序列,因此专用于处理序列、时序数据的 RNN 往往能够在 NLP 任务上取得最优的效果。
🔔
但 RNN 及 LSTM 虽然具有捕捉时序信息、适合序列生成的优点,却有两个难以弥补的缺陷:
序列依序计算的模式能够很好地模拟时序信息,但限制了计算机并行计算的能力。由于序列需要依次输入、依序计算,图形处理器(Graphics Processing Unit,GPU)并行计算的能力受到了极大限制,导致 RNN 为基础架构的模型虽然参数量不算特别大,但计算时间成本却很高;
RNN 难以捕捉长序列的相关关系。在 RNN 架构中,距离越远的输入之间的关系就越难被捕捉,同时 RNN 需要将整个序列读入内存依次计算,也限制了序列的长度。虽然 LSTM 中通过门机制对此进行了一定优化,但对于较远距离相关关系的捕捉,RNN 依旧是不如人意的。
针对这样的问题,Vaswani 等学者参考了在 CV 领域被提出、被经常融入到 RNN 中使用的注意力机制(Attention)(注意,虽然注意力机制在 NLP 被发扬光大,但其确实是在 CV 领域被提出的),创新性地搭建了完全由注意力机制构成的神经网络——Transformer,也就是大语言模型(Large Language Model,LLM)的鼻祖及核心架构,从而让注意力机制一跃成为深度学习最核心的架构之一。
那么,究竟什么是注意力机制?
注意力机制最先源于计算机视觉领域,其核心思想为当我们关注一张图片,我们往往无需看清楚全部内容而仅将注意力集中在重点部分即可。而在自然语言处理领域,我们往往也可以通过将重点注意力集中在一个或几个 token,从而取得更高效高质的计算效果。
注意力机制有三个核心变量:Query(查询值)、Key(键值)和 Value(真值)。我们可以通过一个案例来理解每一个变量所代表的含义。例如,当我们有一篇新闻报道,我们想要找到这个报道的时间,那么,我们的 Query 可以是类似于“时间”、“日期”一类的向量(为了便于理解,此处使用文本来表示,但其实际是稠密的向量),Key 和 Value 会是整个文本。通过对 Query 和 Key 进行运算我们可以得到一个权重,这个权重其实反映了从 Query 出发,对文本每一个 token 应该分布的注意力相对大小。通过把权重和 Value 进行运算,得到的最后结果就是从 Query 出发计算整个文本注意力得到的结果。
具体而言,注意力机制的特点是通过计算 Query 与Key的相关性为真值加权求和,从而拟合序列中每个词同其他词的相关关系。
2.1.2 深入理解注意力机制
注意力机制有三个核心变量:查询值 Query,键值 Key 和 真值 Value。接下来我们以字典为例,逐步分析注意力机制的计算公式是如何得到的,从而帮助读者深入理解注意力机制。首先,我们有这样一个字典:
代码块
Plain Text
{
"apple":10,
"banana":5,
"chair":2
}Copy to clipboardErrorCopied
此时,字典的键就是注意力机制中的键值 Key,而字典的值就是真值 Value。字典支持我们进行精确的字符串匹配,例如,如果我们想要查找的值也就是查询值 Query 为“apple”,那么我们可以直接通过将 Query 与 Key 做匹配来得到对应的 Value。
但是,如果我们想要匹配的 Query 是一个包含多个 Key 的概念呢?例如,我们想要查找“fruit”,此时,我们应该将 apple 和 banana 都匹配到,但不能匹配到 chair。因此,我们往往会选择将 Key 对应的 Value 进行组合得到最终的 Value。
例如,当我们的 Query 为“fruit”,我们可以分别给三个 Key 赋予如下的权重:
代码块
Plain Text
{
"apple":0.6,
"banana":0.4,
"chair":0
}Copy to clipboardErrorCopied
那么,我们最终查询到的值应该是:
value=0.6∗10+0.4∗5+0∗2=8value=0.6∗10+0.4∗5+0∗2=8
给不同 Key 所赋予的不同权重,就是我们所说的注意力分数,也就是为了查询到 Query,我们应该赋予给每一个 Key 多少注意力。但是,如何针对每一个 Query,计算出对应的注意力分数呢?从直观上讲,我们可以认为 Key 与 Query 相关性越高,则其所应该赋予的注意力权重就越大。但是,我们如何能够找到一个合理的、能够计算出正确的注意力分数的方法呢?
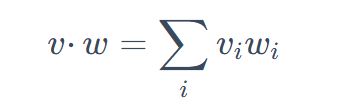
通过合理的训练拟合,词向量能够表征语义信息,从而让语义相近的词在向量空间中距离更近,语义较远的词在向量空间中距离更远。我们往往用欧式距离来衡量词向量的相似性,但我们同样也可以用点积来进行度量:
根据词向量的定义,语义相似的两个词对应的词向量的点积应该大于0,而语义不相似的词向量点积应该小于0。
那么,我们就可以用点积来计算词之间的相似度。假设我们的 Query 为“fruit”,对应的词向量为 qq ;我们的 Key 对应的词向量为 k=[vapplevbananavchair]k=[vapplevbananavchair] ,则我们可以计算 Query 和每一个键的相似程度:
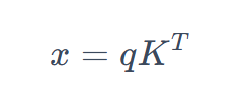
此处的 K 即为将所有 Key 对应的词向量堆叠形成的矩阵。基于矩阵乘法的定义,x 即为 q 与每一个 k 值的点积。现在我们得到的 x 即反映了 Query 和每一个 Key 的相似程度,我们再通过一个 Softmax 层将其转化为和为 1 的权重:
这样,得到的向量就能够反映 Query 和每一个 Key 的相似程度,同时又相加权重为 1,也就是我们的注意力分数了。最后,我们再将得到的注意力分数和值向量做对应乘积即可。根据上述过程,我们就可以得到注意力机制计算的基本公式:
不过,此时的值还是一个标量,同时,我们此次只查询了一个 Query。我们可以将值转化为维度为 dvdv 的向量,同时一次性查询多个 Query,同样将多个 Query 对应的词向量堆叠在一起形成矩阵 Q,得到公式:
目前,我们离标准的注意力机制公式还差最后一步。在上一个公式中,如果 Q 和 K 对应的维度 dkdk 比较大,softmax 放缩时就非常容易受影响,使不同值之间的差异较大,从而影响梯度的稳定性。因此,我们要将 Q 和 K 乘积的结果做一个放缩:
这也就是注意力机制的核心计算公式了。
2.1.3 注意力机制的实现
基于上文,我们可以很简单地使用 Pytorch 来实现注意力机制的代码:
代码块
Python
'''注意力计算函数'''def attention(query, key, value, dropout=None):'''
args:
query: 查询值矩阵
key: 键值矩阵
value: 真值矩阵
注意,在上文代码中,我们假设输入的 q、k、v 是已经经过转化的词向量矩阵,也就是公式中的 Q、K、V。我们仅需要通过上述几行代码,就可以实现核心的注意力机制计算。
2.1.4 自注意力
根据上文的分析,我们可以发现,注意力机制的本质是对两段序列的元素依次进行相似度计算,寻找出一个序列的每个元素对另一个序列的每个元素的相关度,然后基于相关度进行加权,即分配注意力。而这两段序列即是我们计算过程中 Q、K、V 的来源。
但在 Transformer 的 Encoder 结构中,使用的是 注意力机制的变种 —— 自注意力(self-attention,自注意力)机制。所谓自注意力,即是计算本身序列中每个元素对其他元素的注意力分布,即在计算过程中,Q、K、V 都由同一个输入通过不同的参数矩阵计算得到。在 Encoder 中,Q、K、V 分别是输入对参数矩阵 Wq、Wk、WvWq、Wk、Wv 做积得到,从而拟合输入语句中每一个 token 对其他所有 token 的关系。
通过自注意力机制,我们可以找到一段文本中每一个 token 与其他所有 token 的相关关系大小,从而建模文本之间的依赖关系。在代码中的实现,self-attention 机制其实是通过给 Q、K、V 的输入传入同一个参数实现的:
代码块
Plain Text
# attention 为上文定义的注意力计算函数
attention(x, x, x)Copy to clipboardErrorCopied
2.1.5 掩码自注意力
掩码自注意力,即 Mask Self-Attention,是指使用注意力掩码的自注意力机制。掩码的作用是遮蔽一些特定位置的 token,模型在学习的过程中,会忽略掉被遮蔽的 token。
使用注意力掩码的核心动机是让模型只能使用历史信息进行预测而不能看到未来信息。使用注意力机制的 Transformer 模型也是通过类似于 n-gram 的语言模型任务来学习的,也就是对一个文本序列,不断根据之前的 token 来预测下一个 token,直到将整个文本序列补全。
例如,如果待学习的文本序列是 【BOS】I like you【EOS】,那么,模型会按如下顺序进行预测和学习:
代码块
Plain Text
Step 1:输入 【BOS】,输出 I
Step 2:输入 【BOS】I,输出 like
Step 3:输入 【BOS】I like,输出 you
Step 4:输入 【BOS】I like you,输出 【EOS】Copy to clipboardErrorCopied
理论上来说,只要学习的语料足够多,通过上述的过程,模型可以学会任意一种文本序列的建模方式,也就是可以对任意的文本进行补全。
但是,我们可以发现,上述过程是一个串行的过程,也就是需要先完成 Step 1,才能做 Step 2,接下来逐步完成整个序列的补全。我们在一开始就说过,Transformer 相对于 RNN 的核心优势之一即在于其可以并行计算,具有更高的计算效率。如果对于每一个训练语料,模型都需要串行完成上述过程才能完成学习,那么很明显没有做到并行计算,计算效率很低。
针对这个问题,Transformer 就提出了掩码自注意力的方法。掩码自注意力会生成一串掩码,来遮蔽未来信息。例如,我们待学习的文本序列仍然是 【BOS】I like you【EOS】,我们使用的注意力掩码是【MASK】,那么模型的输入为:
代码块
Plain Text
在每一行输入中,模型仍然是只看到前面的 token,预测下一个 token。但是注意,上述输入不再是串行的过程,而可以一起并行地输入到模型中,模型只需要每一个样本根据未被遮蔽的 token 来预测下一个 token 即可,从而实现了并行的语言模型。
观察上述的掩码,我们可以发现其实则是一个和文本序列等长的上三角矩阵。我们可以简单地通过创建一个和输入同等长度的上三角矩阵作为注意力掩码,再使用掩码来遮蔽掉输入即可。也就是说,当输入维度为 (batch_size, seq_len, hidden_size)时,我们的 Mask 矩阵维度一般为 (1, seq_len, seq_len)(通过广播实现同一个 batch 中不同样本的计算)。
在具体实现中,我们通过以下代码生成 Mask 矩阵:
代码块
Python
# 创建一个上三角矩阵,用于遮蔽未来信息。
# 先通过 full 函数创建一个 1 * seq_len * seq_len 的矩阵
mask = torch.full((1, args.max_seq_len, args.max_seq_len), float("-inf"))
# triu 函数的功能是创建一个上三角矩阵
mask = torch.triu(mask, diagonal=1)Copy to clipboardErrorCopied
生成的 Mask 矩阵会是一个上三角矩阵,上三角位置的元素均为 -inf,其他位置的元素置为0。
在注意力计算时,我们会将计算得到的注意力分数与这个掩码做和,再进行 Softmax 操作:
代码块
Python
# 此处的 scores 为计算得到的注意力分数,mask 为上文生成的掩码矩阵
scores = scores + mask[:, :seqlen, :seqlen]
scores = F.softmax(scores.float(), dim=-1).type_as(xq)Copy to clipboardErrorCopied
通过做求和,上三角区域(也就是应该被遮蔽的 token 对应的位置)的注意力分数结果都变成了 -inf,而下三角区域的分数不变。再做 Softmax 操作,-inf 的值在经过 Softmax 之后会被置为 0,从而忽略了上三角区域计算的注意力分数,从而实现了注意力遮蔽。
2.1.6 多头注意力
注意力机制可以实现并行化与长期依赖关系拟合,但一次注意力计算只能拟合一种相关关系,单一的注意力机制很难全面拟合语句序列里的相关关系。因此 Transformer 使用了多头注意力机制(Multi-Head Attention),即同时对一个语料进行多次注意力计算,每次注意力计算都能拟合不同的关系,将最后的多次结果拼接起来作为最后的输出,即可更全面深入地拟合语言信息。
图2.4 多头注意力机制
在原论文中,作者也通过实验证实,多头注意力计算中,每个不同的注意力头能够拟合语句中的不同信息,如图2.4所示:
上层与下层分别是两个注意力头对同一段语句序列进行自注意力计算的结果,可以看到,对于不同的注意力头,能够拟合不同层次的相关信息。通过多个注意力头同时计算,能够更全面地拟合语句关系。
事实上,所谓的多头注意力机制其实就是将原始的输入序列进行多组的自注意力处理;然后再将每一组得到的自注意力结果拼接起来,再通过一个线性层进行处理,得到最终的输出。我们用公式可以表示为:
其最直观的代码实现并不复杂,即 n 个头就有 n 组3个参数矩阵,每一组进行同样的注意力计算,但由于是不同的参数矩阵从而通过反向传播实现了不同的注意力结果,然后将 n 个结果拼接起来输出即可。
但上述实现时空复杂度均较高,我们可以通过矩阵运算巧妙地实现并行的多头计算,其核心逻辑在于使用三个组合矩阵来代替了n个参数矩阵的组合,也就是矩阵内积再拼接其实等同于拼接矩阵再内积。具体实现可以参考下列代码:
代码块
Python
import torch.nn as nn
import torch
'''多头自注意力计算模块'''class MultiHeadAttention(nn.Module):def __init__(self, args: ModelArgs, is_causal=False):# 构造函数# args: 配置对象super().__init__()# 隐藏层维度必须是头数的整数倍,因为后面我们会将输入拆成头数个矩阵assert args.dim % args.n_heads == 0# 每个头的维度,等于模型维度除以头的总数。
self.head_dim = args.dim // args.n_heads
self.n_heads = args.n_heads
# Wq, Wk, Wv 参数矩阵,每个参数矩阵为 n_embd x dim# 这里通过三个组合矩阵来代替了n个参数矩阵的组合,其逻辑在于矩阵内积再拼接其实等同于拼接矩阵再内积,# 不理解的读者可以自行模拟一下,每一个线性层其实相当于n个参数矩阵的拼接
self.wq = nn.Linear(args.n_embd, self.n_heads * self.head_dim, bias=False)
self.wk = nn.Linear(args.n_embd, self.n_heads * self.head_dim, bias=False)
在本节中,我们将以上一节所介绍的 注意力机制为基础,从 Transformer 所针对的 Seq2Seq 任务出发,解析 Transformer 的 Encoder-Decoder 结构。
Seq2Seq,即序列到序列,是一种经典 NLP 任务。具体而言,是指模型输入的是一个自然语言序列 input=(x1,x2,x3...xn)input=(x1,x2,x3...xn) ,输出的是一个可能不等长的自然语言序列 output=(y1,y2,y3...ym)output=(y1,y2,y3...ym) 。事实上,Seq2Seq 是 NLP 最经典的任务,几乎所有的 NLP 任务都可以视为 Seq2Seq 任务。例如文本分类任务,可以视为输出长度为 1 的目标序列(如在上式中 mm = 1);词性标注任务,可以视为输出与输入序列等长的目标序列(如在上式中 mm = nn )。
机器翻译任务即是一个经典的 Seq2Seq 任务,例如,我们的输入可能是“今天天气真好”,输出是“Today is a good day.”。Transformer 是一个经典的 Seq2Seq 模型,即模型的输入为文本序列,输出为另一个文本序列。事实上,Transformer 一开始正是应用在机器翻译任务上的。
Transformer 中的 Encoder,就是用于上述的编码过程;Decoder 则用于上述的解码过程。Transformer 结构,如图2.5所示:
图2.5 编码器-解码器结构
Transformer 由 Encoder 和 Decoder 组成,每一个 Encoder(Decoder)又由 6个 Encoder(Decoder)Layer 组成。输入源序列会进入 Encoder 进行编码,到 Encoder Layer 的最顶层再将编码结果输出给 Decoder Layer 的每一层,通过 Decoder 解码后就可以得到输出目标序列了。
接下来,我们将首先介绍 Encoder 和 Decoder 内部传统神经网络的经典结构——前馈神经网络(FNN)、层归一化(Layer Norm)和残差连接(Residual Connection),然后进一步分析 Encoder 和 Decoder 的内部结构。
前馈神经网络(Feed Forward Neural Network,下简称 FNN),也就是我们在上一节提过的每一层的神经元都和上下两层的每一个神经元完全连接的网络结构。每一个 Encoder Layer 都包含一个上文讲的注意力机制和一个前馈神经网络。前馈神经网络的实现是较为简单的:
代码块
Python
class MLP(nn.Module):
'''前馈神经网络'''
def __init__(self, dim: int, hidden_dim: int, dropout: float):
super().__init__()
# 定义第一层线性变换,从输入维度到隐藏维度
self.w1 = nn.Linear(dim, hidden_dim, bias=False)
# 定义第二层线性变换,从隐藏维度到输入维度
self.w2 = nn.Linear(hidden_dim, dim, bias=False)
# 定义dropout层,用于防止过拟合
self.dropout = nn.Dropout(dropout)def forward(self, x):
# 前向传播函数# 首先,输入x通过第一层线性变换和RELU激活函数
# 最后,通过第二层线性变换和dropout层return self.dropout(self.w2(F.relu(self.w1(x))))Copy to clipboardErrorCopied
注意,Transformer 的前馈神经网络是由两个线性层中间加一个 RELU 激活函数组成的,以及前馈神经网络还加入了一个 Dropout 层来防止过拟合。Dropout 层只在训练时开启,推理/测试阶段关闭,所以许多Transformer结构示意图中不会画出该层。
层归一化,也就是 Layer Norm,是深度学习中经典的归一化操作。神经网络主流的归一化一般有两种,批归一化(Batch Norm)和层归一化(Layer Norm)。
归一化核心是为了让不同层输入的取值范围或者分布能够比较一致。由于深度神经网络中每一层的输入都是上一层的输出,因此多层传递下,对网络中较高的层,之前的所有神经层的参数变化会导致其输入的分布发生较大的改变。也就是说,随着神经网络参数的更新,各层的输出分布是不相同的,且差异会随着网络深度的增大而增大。但是,需要预测的条件分布始终是相同的,从而也就造成了预测的误差。
因此,在深度神经网络中,往往需要归一化操作,将每一层的输入都归一化成标准正态分布。批归一化是指在一个 mini-batch 上进行归一化,相当于对一个 batch 对样本拆分出来一部分,首先计算样本的均值:
其中, ZjiZji 是样本 i 在第 j 个维度上的值,m 就是 mini-batch 的大小。
再计算样本的方差:
最后,对每个样本的值减去均值再除以标准差来将这一个 mini-batch 的样本的分布转化为标准正态分布:
此处加上 ϵϵ 这一极小量是为了避免分母为0。
但是,批归一化存在一些缺陷,例如:
•
当显存有限,mini-batch 较小时,Batch Norm 取的样本的均值和方差不能反映全局的统计分布信息,从而导致效果变差;
•
对于在时间维度展开的 RNN,不同句子的同一分布大概率不同,所以 Batch Norm 的归一化会失去意义;
•
在训练时,Batch Norm 需要保存每个 step 的统计信息(均值和方差)。在测试时,由于变长句子的特性,测试集可能出现比训练集更长的句子,所以对于后面位置的 step,是没有训练的统计量使用的;
•
应用 Batch Norm,每个 step 都需要去保存和计算 batch 统计量,耗时又耗力
因此,出现了在深度神经网络中更常用、效果更好的层归一化(Layer Norm)。相较于 Batch Norm 在每一层统计所有样本的均值和方差,Layer Norm 在每个样本上计算其所有层的均值和方差,从而使每个样本的分布达到稳定。Layer Norm 的归一化方式其实和 Batch Norm 是完全一样的,只是统计统计量的维度不同。
基于上述进行归一化的公式,我们可以简单地实现一个 Layer Norm 层:
代码块
Python
注意,在我们上文实现的 Layer Norm 层中,有两个线性矩阵进行映射。
由于 Transformer 模型结构较复杂、层数较深,为了避免模型退化,Transformer 采用了残差连接的思想来连接每一个子层。残差连接,即下一层的输入不仅是上一层的输出,还包括上一层的输入。残差连接允许最底层信息直接传到最高层,让高层专注于残差的学习。
例如,在 Encoder 中,在第一个子层,输入会先进行层归一化(Layer Norm),然后进入多头自注意力层,其输出会与原输入相加。在第二个子层也是一样。即:
我们在代码实现中,通过在层的 forward 计算中加上原值来实现残差连接:
代码块
Python
# 注意力计算
h = x + self.attention.forward(self.attention_norm(x))# 经过前馈神经网络
out = h + self.feed_forward.forward(self.fnn_norm(h))Copy to clipboardErrorCopied
在上文代码中,self.attention_norm 和 self.fnn_norm 都是 LayerNorm 层,self.attn 是注意力层,而 self.feed_forward 是前馈神经网络。
在实现上述组件之后,我们可以搭建起 Transformer 的 Encoder。Encoder 由 N 个 Encoder Layer 组成,每一个 Encoder Layer 包括一个注意力层和一个前馈神经网络。因此,我们可以首先实现一个 Encoder Layer:
代码块
Python
class EncoderLayer(nn.Module):'''Encoder层'''def __init__(self, args):super().__init__()# 一个 Layer 中有两个 LayerNorm,分别在 Attention 之前和 MLP 之前
self.attention_norm = LayerNorm(args.n_embd)# Encoder 不需要掩码,传入 is_causal=False
self.attention = MultiHeadAttention(args, is_causal=False)
self.fnn_norm = LayerNorm(args.n_embd)
self.feed_forward = MLP(args.dim, args.dim, args.dropout)def forward(self, x):# Layer Norm
norm_x = self.attention_norm(x)# 自注意力
h = x + self.attention.forward(norm_x, norm_x, norm_x)# 经过前馈神经网络
out = h + self.feed_forward.forward(self.fnn_norm(h))return outCopy to clipboardErrorCopied
然后我们搭建一个 Encoder,由 N 个 Encoder Layer 组成,在最后会加入一个 Layer Norm 实现规范化:
代码块
Python
class Encoder(nn.Module):'''Encoder 块'''def __init__(self, args):super(Encoder, self).__init__()
# 一个 Encoder 由 N 个 Encoder Layer 组成
通过 Encoder 的输出,就是输入编码之后的结果。
类似的,我们也可以先搭建 Decoder Layer,再将 N 个 Decoder Layer 组装为 Decoder。但是和 Encoder 不同的是,Decoder 由两个注意力层和一个前馈神经网络组成。第一个注意力层是一个掩码自注意力层,即使用 Mask 的注意力计算,保证每一个 token 只能使用该 token 之前的注意力分数;第二个注意力层是一个多头注意力层,该层将使用第一个注意力层的输出作为 query,使用 Encoder 的输出作为 key 和 value,来计算注意力分数。最后,再经过前馈神经网络:
代码块
Python
class DecoderLayer(nn.Module):'''解码层'''def __init__(self, args):super().__init__()# 一个 Layer 中有三个 LayerNorm,分别在 Mask Attention 之前、Self Attention 之前和 MLP 之前
self.attention_norm_1 = LayerNorm(args.n_embd)# Decoder 的第一个部分是 Mask Attention,传入 is_causal=True
self.mask_attention = MultiHeadAttention(args, is_causal=True)
self.attention_norm_2 = LayerNorm(args.n_embd)# Decoder 的第二个部分是 类似于 Encoder 的 Attention,传入 is_causal=False
然后同样的,我们搭建一个 Decoder 块:
代码块
Python
class Decoder(nn.Module):'''解码器'''def __init__(self, args):super(Decoder, self).__init__()
# 一个 Decoder 由 N 个 Decoder Layer 组成
self.layers = nn.ModuleList([DecoderLayer(args) for _ in range(args.n_layer)])
self.norm = LayerNorm(args.n_embd)def forward(self, x, enc_out):"Pass the input (and mask) through each layer in turn."for layer in self.layers:
x = layer(x, enc_out)return self.norm(x)Copy to clipboardErrorCopied
完成上述 Encoder、Decoder 的搭建,就完成了 Transformer 的核心部分,接下来将 Encoder、Decoder 拼接起来再加入 Embedding 层就可以搭建出完整的 Transformer 模型啦。
接下来,我们就可以基于上一章实现的组件,搭建起一个完整的 Transformer 模型。
在 NLP 任务中,我们往往需要将自然语言的输入转化为机器可以处理的向量。在深度学习中,承担这个任务的组件就是 Embedding 层。
Embedding 层其实是一个存储固定大小的词典的嵌入向量查找表。也就是说,在输入神经网络之前,我们往往会先让自然语言输入通过分词器 tokenizer,分词器的作用是把自然语言输入切分成 token 并转化成一个固定的 index。例如,如果我们将词表大小设为 4,输入“我喜欢你”,那么,分词器可以将输入转化成:
代码块
Plain Text
input: 我
output: 0
当然,在实际情况下,tokenizer 的工作会比这更复杂。例如,分词有多种不同的方式,可以切分成词、切分成子词、切分成字符等,而词表大小则往往高达数万数十万。此处我们不赘述 tokenizer 的详细情况,在后文会详细介绍大模型的 tokenizer 是如何运行和训练的。
因此,Embedding 层的输入往往是一个形状为 (batch_size,seq_len,1)的矩阵,第一个维度是一次批处理的数量,第二个维度是自然语言序列的长度,第三个维度则是 token 经过 tokenizer 转化成的 index 值。例如,对上述输入,Embedding 层的输入会是:
代码块
Plain Text
[[[0],[1],[2]]]
其 batch_size 为1,seq_len 为3,转化出来的 index 如上。
而 Embedding 内部其实是一个可训练的(Vocab_size,embedding_dim)的权重矩阵,词表里的每一个值,都对应一行维度为 embedding_dim 的向量。对于输入的值,会对应到这个词向量,然后拼接成(batch_size,seq_len,embedding_dim)的矩阵输出。
上述实现并不复杂,我们可以直接使用 torch 中的 Embedding 层:
代码块
Plain Text
self.tok_embeddings = nn.Embedding(args.vocab_size, args.dim)
注意力机制可以实现良好的并行计算,但同时,其注意力计算的方式也导致序列中相对位置的丢失。在 RNN、LSTM 中,输入序列会沿着语句本身的顺序被依次递归处理,因此输入序列的顺序提供了极其重要的信息,这也和自然语言的本身特性非常吻合。
但从上文对注意力机制的分析我们可以发现,在注意力机制的计算过程中,对于序列中的每一个 token,其他各个位置对其来说都是平等的,即“我喜欢你”和“你喜欢我”在注意力机制看来是完全相同的,但无疑这是注意力机制存在的一个巨大问题。因此,为使用序列顺序信息,保留序列中的相对位置信息,Transformer 采用了位置编码机制,该机制也在之后被多种模型沿用。
位置编码,即根据序列中 token 的相对位置对其进行编码,再将位置编码加入词向量编码中。位置编码的方式有很多,Transformer 使用了正余弦函数来进行位置编码(绝对位置编码Sinusoidal),其编码方式为:
上式中,pos 为 token 在句子中的位置,2i 和 2i+1 则指示了位置编码向量的维度索引是奇数还是偶数,从上式中我们可以看出对于奇数维度和偶数维度,Transformer 采用了不同的函数进行编码。
我们以一个简单的例子来说明位置编码的计算过程:假如我们输入的是一个长度为 4 的句子"I like to code",我们可以得到下面的词向量矩阵 xx ,其中每一行代表的就是一个词向量, x0=[0.1,0.2,0.3,0.4]x0=[0.1,0.2,0.3,0.4] 对应的就是“I”的词向量,它的pos就是为0,以此类推,第二行代表的是“like”的词向量,它的pos就是1:
则经过位置编码后的词向量为:
我们可以使用如下的代码来获取上述例子的位置编码:
代码块
Python
import numpy as np
import matplotlib.pyplot as plt
def PositionEncoding(seq_len, d_model, n=10000):
P = np.zeros((seq_len, d_model))for k in range(seq_len):for i in np.arange(int(d_model/2)):
denominator = np.power(n, 2*i/d_model)
P[k, 2*i] = np.sin(k/denominator)
P[k, 2*i+1] = np.cos(k/denominator)return P
P = PositionEncoding(seq_len=4, d_model=4, n=100)print(P)
代码块
Python
[[ 0. 1. 0. 1. ]
[ 0.84147098 0.54030231 0.09983342 0.99500417]
[ 0.90929743 -0.41614684 0.19866933 0.98006658]
[ 0.14112001 -0.9899925 0.29552021 0.95533649]]
这样的位置编码主要有两个好处:
使 PE 能够适应比训练集里面所有句子更长的句子,假设训练集里面最长的句子是有 20 个单词,突然来了一个长度为 21 的句子,则使用公式计算的方法可以计算出第 21 位的 Embedding。
可以让模型容易地计算出相对位置,对于固定长度的间距 k,PE(pos+k) 可以用 PE(pos) 计算得到。因为 Sin(A+B) = Sin(A)Cos(B) + Cos(A)Sin(B), Cos(A+B) = Cos(A)Cos(B) - Sin(A)Sin(B)。
我们也可以通过严谨的数学推导证明该编码方式的优越性。原始的 Transformer Embedding 可以表示为:
很明显,这样的函数是不具有不对称性的,也就是无法表征相对位置信息。我们想要得到这样一种编码方式:
这里加上的 pmpm, pnpn 就是位置编码。接下来我们将 f(...,xm+pm,...,xn+pn)f(...,xm+pm,...,xn+pn) 在 m,n 两个位置上做泰勒展开:
可以看到第1项与位置无关,2~5项仅依赖单一位置,第6项(f 分别对 m、n 求偏导)与两个位置有关,所以我们希望第六项( pmTHpnpmTHpn )表达相对位置信息,即求一个函数 g 使得:
我们假设 HH 是一个单位矩阵,则:
通过将向量 [x,y] 视为复数 x+yi,基于复数的运算法则构建方程:
再假设存在复数 qm−nqm−n 使得:
使用复数的指数形式求解这个方程,得到二维情形下位置编码的解:
由于内积满足线性叠加性,所以更高维的偶数维位置编码,我们可以表示为多个二维位置编码的组合:
再取 θi=10000−2i/dθi=10000−2i/d(该形式可以使得随着|m−n|的增大,⟨pm,pn⟩有着趋于零的趋势,这一点可以通过对位置编码做积分来证明,而 base 取为 10000 是实验结果),就得到了上文的编码方式。
当 HH 不是一个单位矩阵时,因为模型的 Embedding 层所形成的 d 维向量之间任意两个维度的相关性比较小,满足一定的解耦性,我们可以将其视作对角矩阵,那么使用上述编码:
通过积化和差:
说明该编码仍然可以表示相对位置。
上述编码结果,如图2.6所示:
图2.6 编码结果
基于上述原理,我们实现一个位置编码层:
代码块
Python
class PositionalEncoding(nn.Module):'''位置编码模块'''def __init__(self, args):super(PositionalEncoding, self).__init__()# Dropout 层# self.dropout = nn.Dropout(p=args.dropout)# block size 是序列的最大长度
pe = torch.zeros(args.block_size, args.n_embd)
position = torch.arange(0, args.block_size).unsqueeze(1)# 计算 theta
div_term = torch.exp(
torch.arange(0, args.n_embd, 2) * -(math.log(10000.0) / args.n_embd))# 分别计算 sin、cos 结果
2.3.3 一个完整的 Transformer
上述所有组件,再按照下图的 Tranfromer 结构拼接起来就是一个完整的 Transformer 模型了,如图2.7所示:
图2.7 Transformer 模型结构
LayerNorm 层是放在 Attention 层前面的,也就是“Pre Norm”结构。考虑到目前 LLM 一般采用“Pre-Norm”结构(可以使 loss 更稳定),本文在实现时采用“Pre-Norm”结构。
如图,经过 tokenizer 映射后的输出先经过 Embedding 层和 Positional Embedding 层编码,然后进入上一节讲过的 N 个 Encoder 和 N 个 Decoder(在 Transformer 原模型中,N 取为6),最后经过一个线性层和一个 Softmax 层就得到了最终输出。
基于之前所实现过的组件,我们实现完整的 Transformer 模型:
代码块
Python
class Transformer(nn.Module):'''整体模型'''def __init__(self, args):super().__init__()# 必须输入词表大小和 block sizeassert args.vocab_size is not Noneassert args.block_size is not None
self.args = args
self.transformer = nn.ModuleDict(dict(
wte = nn.Embedding(args.vocab_size, args.n_embd),
wpe = PositionalEncoding(args),
drop = nn.Dropout(args.dropout),
encoder = Encoder(args),
decoder = Decoder(args),))# 最后的线性层,输入是 n_embd,输出是词表大小
self.lm_head = nn.Linear(args.n_embd, args.vocab_size, bias=False)# 初始化所有的权重
self.apply(self._init_weights)# 查看所有参数的数量print("number of parameters: %.2fM" % (self.get_num_params()/1e6,))'''统计所有参数的数量'''def get_num_params(self, non_embedding=False):# non_embedding: 是否统计 embedding 的参数
n_params = sum(p.numel() for p in self.parameters())# 如果不统计 embedding 的参数,就减去if non_embedding:
n_params -= self.transformer.wte.weight.numel()return n_params
注意,上述代码除去搭建了整个 Transformer 结构外,我们还额外实现了三个函数:
•
get_num_params:用于统计模型的参数量
•
_init_weights:用于对模型所有参数进行随机初始化
•
forward:前向计算函数
另外,在前向计算函数中,我们对模型使用 pytorch 的交叉熵函数来计算损失,对于不同的损失函数,读者可以查阅 Pytorch 的官方文档,此处就不再赘述了。
经过上述步骤,我们就可以从零“手搓”一个完整的、可计算的 Transformer 模型。限于本书主要聚焦在 LLM,在本章,我们就不再详细讲述如何训练 Transformer 模型了;在后文中,我们将类似地从零“手搓”一个 LLaMA 模型,并手把手带大家训练一个属于自己的 Tiny LLaMA。