RAG实战|一文拆解8种RAG架构
本文总结 8 种 RAG 架构,对每种架构进行简要介绍,并用 langchain 实现其参考代码。
Naive RAG
简介:
⭕
Naive RAG 是最基础的检索增强生成架构,采用“索引-检索-生成”的经典流程。
架构:
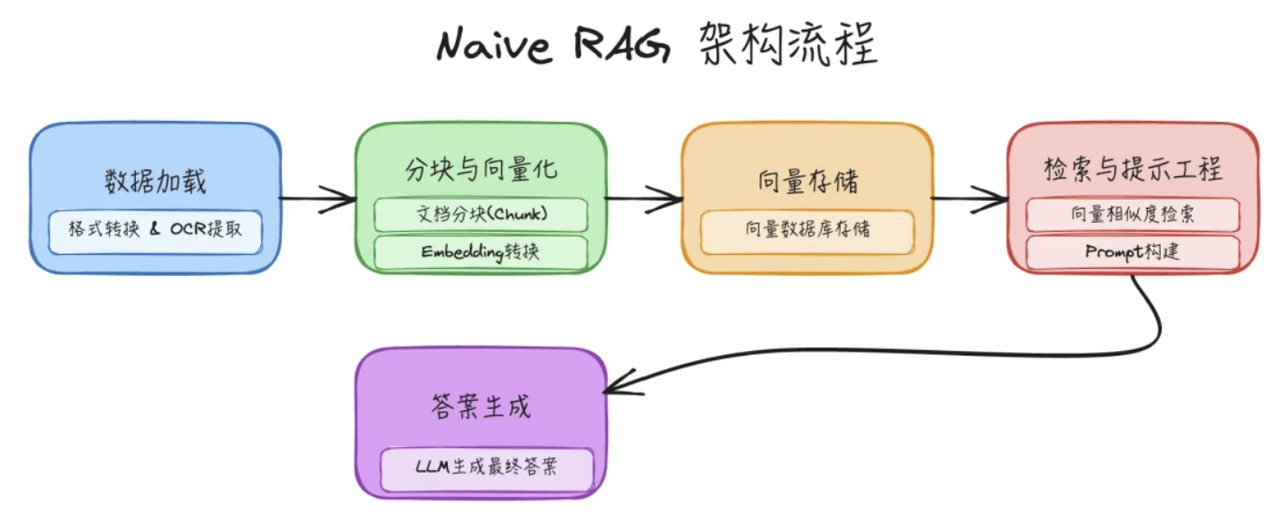
实现步骤:
数据加载 :收集数据并进行清洗,比如各个文档格式的转换,OCR 文字提取等
分块和 embedding :将文档拆分更小的 chunk,一方面让 embedding 更好转换语义信息,另一方面解决LLM的上下文长度限制问题
向量存储:将 embedding 存储到向量数据库中,方便快速搜索
search 和 Prompt工程:对于查找的问题先通过向量数据库检索,然后将召回的文件原文,通过 Prompt 加工提供给LLM
输出答案:LLM 根据 Prompt 生成答案输出
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.vectorstores import LanceDB
from langchain.schema import Document
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate
import lancedb
class NaiveRAG:
def __init__(self):
self.llm = ChatOpenAI(model="gpt-5", temperature=0)
# 使用轻量级的all-MiniLM-L6-v2模型,仅80MB
self.embeddings = HuggingFaceEmbeddings(
model_name="sentence-transformers/all-MiniLM-L6-v2",
model_kwargs={"device": "cpu"},
encode_kwargs={"normalize_embeddings": True}
)
self.db = lancedb.connect("/tmp/lancedb_naive_rag")
self.vectorstore = None
Multi-Head RAG
简介:
⭕
Multi-Head RAG 借鉴了 Transformer 的多头注意力机制,利用模型不同注意力头捕获的多样化语义特征进行并行检索。
架构:
实现步骤:
多头注意力Embedding:利用 Transformer 模型的多头注意力层(而非最后一层)生成多个embedding,每个头捕获不同的语义特征
多向量索引构建:为每个注意力头构建独立的向量索引,存储不同维度的语义信息
并行检索:针对查询,在多个索引上并行检索,每个头返回最相关的文档片段
结果融合:将多个头的检索结果进行去重和融合,综合考虑不同语义维度的相关性
上下文生成:将融合后的文档片段组装成上下文,输入LLM生成答案
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_community.vectorstores import LanceDB
from langchain.schema import Document
from langchain.embeddings.base import Embeddings
from transformers import AutoModel, AutoTokenizer
import torch
import lancedb
from typing import List
class MultiHeadEmbeddings(Embeddings):
"""自定义多头注意力Embedding,继承LangChain的Embeddings基类"""
def __init__(self, model_name="bert-base-uncased", head_index=0, num_heads=12):
self.tokenizer = AutoTokenizer.from_pretrained(model_name)
self.model = AutoModel.from_pretrained(model_name, output_hidden_states=True)
self.head_index = head_index
self.num_heads = num_heads
self.head_dim = 768 // num_heads # BERT hidden size / num_heads
Corrective RAG
简介:
⭕
架构:
实现步骤:
初始检索:使用向量检索获取与查询相关的候选文档
相关性评估:使用LLM或专门的评估模型对每个检索到的文档进行相关性评分(Correct/Incorrect/Ambiguous)
知识修正:对于评估为不相关或模糊的文档,触发知识修正机制
网络搜索增强:当本地知识库文档质量不足时,调用外部搜索引擎获取补充信息
文档重组:将评估为相关的文档和补充搜索结果重新组织,去除冗余信息
答案生成:基于修正后的高质量上下文生成最终答案
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.vectorstores import LanceDB
from langchain_community.tools import TavilySearchResults
from langchain.schema import Document
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
import lancedb
from typing import List
class CorrectiveRAG:
def __init__(self):
self.llm = ChatOpenAI(model="gpt-5", temperature=0)
Agentic RAG
简介:
⭕
Agentic RAG(智能体RAG)将 AI Agent 的规划和推理能力与 RAG 相结合。Agent 可以自主分析查询、制定检索策略、选择合适的工具(语义搜索、关键词搜索、计算器等),并根据中间结果进行迭代优化。
架构:
实现步骤:
Agent初始化:创建具有推理和规划能力的AI Agent,配备检索工具
任务分解:Agent分析用户查询,将复杂问题分解为多个子任务
工具选择:Agent根据子任务特点选择合适的工具(检索、计算、API调用等)
迭代检索:Agent可以根据中间结果决定是否需要进一步检索或调整查询策略
推理整合:Agent对多轮检索和工具调用的结果进行推理和整合
自我反思:Agent评估答案质量,必要时进行自我修正
最终输出:生成完整、准确的答案
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.vectorstores import LanceDB
from langchain.schema import Document
Graph RAG
简介:
⭕
Graph RAG 将知识图谱技术与 RAG 相结合,通过从文档中抽取实体和关系构建知识图谱,并进行社区检测和摘要生成。
架构:
实现步骤:
实体抽取:使用NER或LLM从文档中抽取实体(人物、地点、概念等)
关系抽取:识别实体之间的关系,构建三元组(实体-关系-实体)
知识图谱构建:将实体和关系存储到图数据库中(如Neo4j)
社区检测:对图进行社区划分,识别主题聚类
社区摘要:为每个社区生成摘要描述
图检索:根据查询在知识图谱中检索相关子图和社区摘要
答案生成:结合图结构信息和社区摘要生成更全面的答案
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_community.graphs import Neo4jGraph
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser, JsonOutputParser
import networkx as nx
from typing import List, Dict
import json
class GraphRAG:
def __init__(self, neo4j_uri="bolt://localhost:7687",
neo4j_user="neo4j", neo4j_password="password"):
self.llm = ChatOpenAI(model="gpt-5", temperature=0)
# 使用LangChain的Neo4j集成
self.graph_db = Neo4jGraph(
url=neo4j_uri,
username=neo4j_user,
password=neo4j_password
)
Self RAG
简介:
⭕
Self RAG 提供给模型自我评估和决策能力,它通过四个反思标记(Retrieve/ISREL/ISSUP/ISUSE)来判断:是否需要检索、文档是否相关、答案是否被支持、答案是否有用,模型会生成多个候选答案并综合评分,选择最优结果输出。
架构:
实现步骤:
检索决策:模型首先判断是否需要检索(生成Retrieve标记)
按需检索:如果需要检索,从知识库中获取相关文档
相关性评估:模型评估检索到的文档是否与查询相关(生成ISREL标记)
支持度评估:模型评估生成的内容是否被检索文档支持(生成ISSUP标记)
有用性评估:模型评估生成的回答是否对用户有用(生成ISUSE标记)
自适应生成:基于以上评估标记,模型决定是否使用检索内容、重新检索或直接生成
输出最优答案:选择评分最高的生成结果作为最终输出
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.vectorstores import LanceDB
from langchain.schema import Document
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
import lancedb
from typing import List, Tuple
class SelfRAG:
def __init__(self):
Adaptive RAG
简介:
⭕
Adaptive RAG 根据查询的类型和复杂度动态选择最优的处理策略。
架构:
实现步骤:
查询分类:分析用户查询的类型和复杂度(简单事实/多跳推理/开放性问题)
策略选择:根据查询类型选择最优的RAG策略
a.
简单查询:直接LLM回答或单次检索
动态路由:将查询路由到对应的处理流程
自适应检索:根据中间结果动态调整检索深度和范围
结果整合:整合不同策略的结果生成最终答案
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_community.vectorstores import LanceDB
from langchain.schema import Document
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableLambda, RunnablePassthrough
SFR RAG
简介:
⭕
SFR RAG(Salesforce Research RAG)是工业级高质量 RAG 的最佳实践。它采用经过指令微调的高性能 embedding 模型(如 BGE),结合 Cross-Encoder 重排序、上下文压缩、引用生成和质量验证等多项优化技术。
架构:
实现步骤:
高质量Embedding:使用SFR(Salesforce Research)的高性能embedding模型进行文档和查询编码
指令微调检索:使用指令微调的检索模型,支持多种检索任务(问答、摘要、事实核查等)
上下文压缩:对检索到的文档进行智能压缩,去除冗余信息
重排序:使用专门的重排序模型对候选文档进行精细排序
引用生成:生成答案时附带引用来源,提高可信度
质量控制:对生成结果进行事实性检验和质量评估
参考代码:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_community.embeddings import HuggingFaceBgeEmbeddings
from langchain_community.vectorstores import LanceDB
from langchain_community.cross_encoders import HuggingFaceCrossEncoder