全面解析RAG技术的四大模式:从Naive到Agentic
随着技术迭代,RAG 已从最初的简单架构发展出多种进阶形态。本文将系统解析 RAG 的四大主流模式 ——Naive RAG、Advanced RAG、Modular RAG 与 Agentic RAG,从工作原理、技术特点到适用场景进行全方位对比,为技术选型提供参考。
一、RAG 基础:检索增强生成的核心逻辑
在深入模式解析前,需先明确 RAG 的核心逻辑。简单来说,RAG 由检索(Retrieval) 与生成(Generation) 两大模块构成:
检索模块:从预设知识库中精准定位与用户问题相关的信息片段(如文档、段落、句子);
生成模块:基于检索到的信息,结合大语言模型生成符合上下文、逻辑连贯的答案。
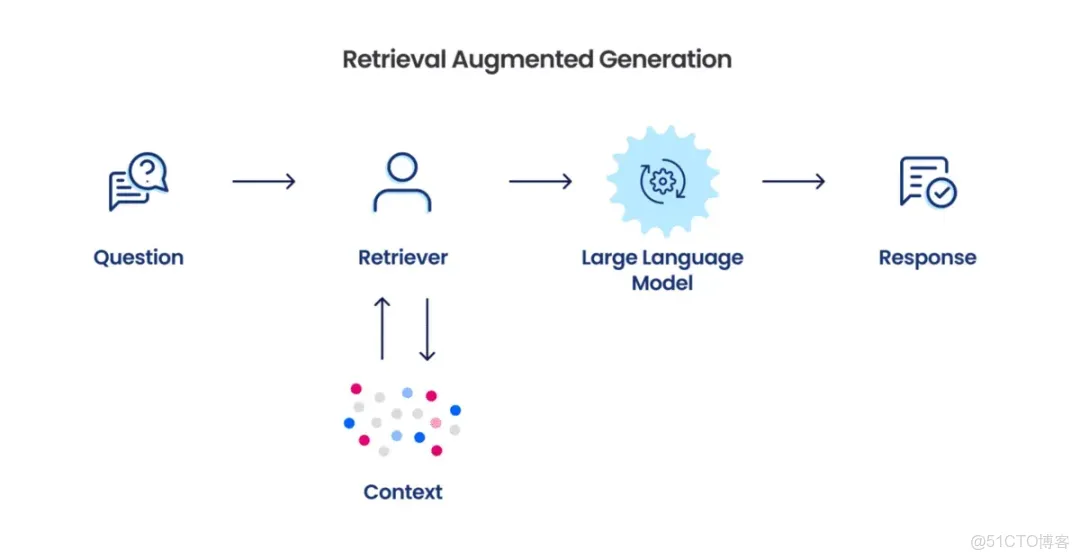
这种 “先检索再生成” 的模式,既保留了 LLM 的语言理解与生成能力,又通过外部知识的引入弥补了模型训练数据过时、事实准确性不足的缺陷。而四大模式的差异,本质上是对 “检索效率”“生成质量” “系统灵活性” 的不同优化方向。
二、Naive RAG:RAG 的 “入门款”,简单直接的基础架构
2.1 工作原理:线性流程的基础实现
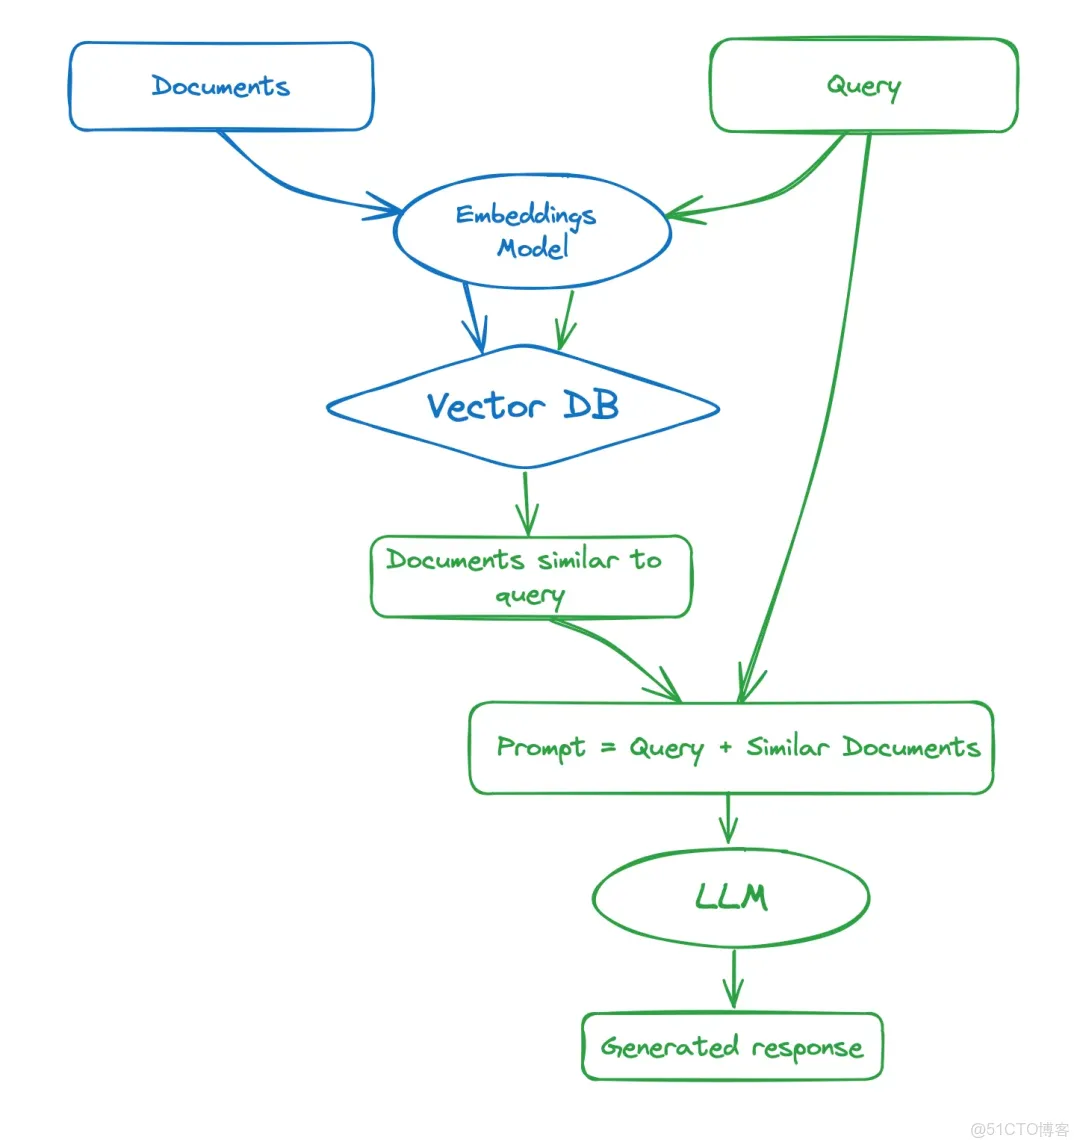
Naive RAG 是 RAG 的原始形态,架构极简,核心流程为 “单轮检索 + 直接生成”:
🌍
用户输入问题(如 “什么是 RAG 技术?”);
检索器(通常基于关键词匹配或基础向量检索)从知识库中筛选出少量相关文档(如 3-5 篇);
生成器(如 GPT-3.5)直接拼接检索到的文档片段与问题,输出答案。
其核心特点是无优化环节:检索器不做重排序,生成器不做上下文过滤,分块策略简单(如固定长度切割文档),整个流程是不可逆的。
2.2 技术特点:简单易实现,局限显著
优点
架构简单,开发成本低,适合快速搭建原型;
对硬件资源要求低,可在小规模知识库(如万级文档)上稳定运行。
缺点
检索精度低:依赖关键词或基础向量匹配,易遗漏语义相关但表述不同的内容(如 “AI” 与 “人工智能”);
抗干扰差:若检索到无关文档,生成器会 “照单全收”,导致答案冗余或错误;
长文档处理弱:固定分块可能切断语义完整的段落(如将一个事件的起因与结果分到不同块)。
2.3 适用场景
适合简单、标准化的问答场景,如企业官网 FAQ(常见问题解答)、产品说明书查询等。例如,电商平台的 “退货政策查询”,用户问题明确,知识库内容结构化强,Naive RAG 可快速响应。
三、Advanced RAG:精度升级,优化检索与生成的协同
Advanced RAG 是 Naive RAG 的进阶版,核心目标是提升检索精度与生成质量,通过多环节优化解决基础版的痛点。
3.1 工作原理:多环节优化的检索增强
在保留 “检索 - 生成” 核心流程的基础上,Advanced RAG 增加了多个关键优化步骤:
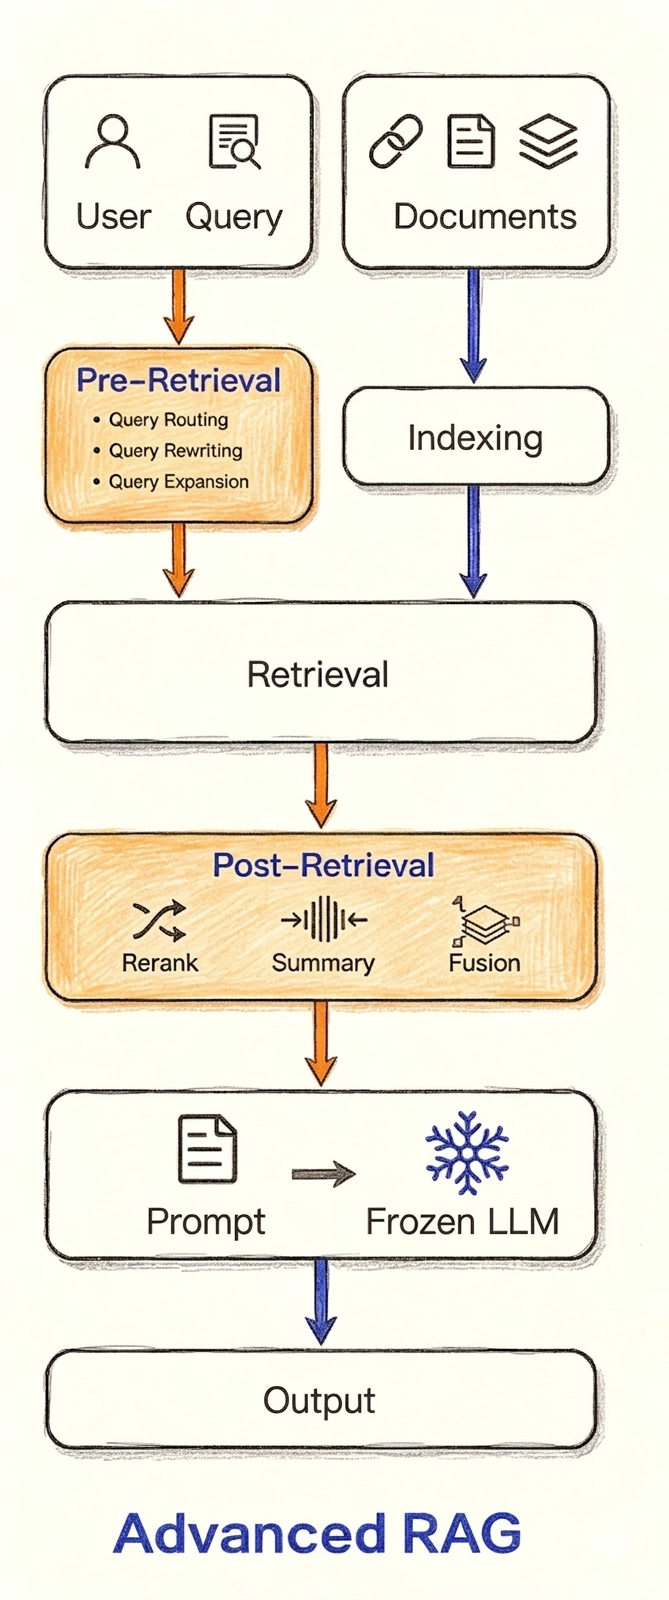
检索升级
采用稠密向量检索(如基于 BERT 的向量模型)替代关键词匹配,通过语义相似度计算提升召回率;
重排序(Reranking)
对初筛的文档片段,用重排序模型(如 CrossEncoder)二次打分,保留最相关的 Top N 结果(通常 N=3-5);
长文档处理
采用动态分块策略(如按语义段落切割),避免关键信息被机械拆分;
查询改写
对模糊问题(如 “它的原理是什么?”)进行补全或改写(如结合上下文推断 “它” 指 “RAG”),提升检索针对性。
3.2 技术特点:精度优先,复杂度适中
优点
检索精度显著提升:语义检索 + 重排序可过滤 70% 以上的无关信息;
长文档处理更合理:动态分块减少语义割裂,生成答案更连贯;
支持中等规模知识库(如十万级文档)。
缺点
架构复杂度增加:需维护检索、重排序等多模型,调试成本上升;
未解决多轮推理问题:仍依赖单轮检索,无法处理 “多步推理” 类问题(如 “对比 RAG 与微调的优劣势,并举例说明”)。
3.3 适用场景
适合中等复杂度的知识查询场景,如企业内部 helpdesk 系统、在线教育平台的课程问答(需处理较长的课件文档)等。例如,当用户提问 “如何配置 Python 环境安装 RAG 相关库?” 时,Advanced RAG 可通过语义检索定位到具体安装步骤文档,并过滤无关的理论介绍。
四、Modular RAG:模块化设计,灵活适配多场景
4.1 工作原理:解耦组件的积木式架构
Modular RAG 的核心是 “组件解耦 + 标准化接口”,将系统拆分为多个独立模块,各模块通过标准化接口通信:
核心模块包括:检索器(多模态支持)、重排序器、分块器、生成器、知识库管理器、监控器等;
模块可独立升级或替换(如将检索器从稠密向量模型换成混合检索模型,无需改动其他模块)。
例如,当需要接入表格数据时,仅需替换 “分块器” 为表格解析专用模块,其他模块保持不变。
4.2 技术特点:灵活性与可扩展性的平衡
优点
多源数据:支持多源数据接入(文本、表格、图片、PDF 等),适配复杂业务场景;
易于迭代:单个模块升级不影响整体系统,适合长期维护;
可定制化:根据需求组合模块(如简化版可去掉重排序器,增强版可加入多语言处理模块)。
灵活编排:除了最简单的线性编排之外,还可以采用条件编排、并行编排、循环编排、递归检索等多种编排方式,增加了处理的灵活性。
图:线性编排
图:条件编排
缺点
设计门槛高:需定义清晰的模块接口与数据格式,初期架构设计成本高;
模块协同复杂:多模块联动可能导致延迟增加(如多模态检索需协调文本与图片处理模块)。
4.3 适用场景
适合多源数据整合或需长期迭代的系统,如政务服务平台(需整合政策文档、办事指南、表格化流程)、科研文献管理系统(需处理 PDF 全文、图表、公式等多模态数据)。例如,某科研平台需同时检索论文全文、实验数据表格与作者信息,Modular RAG 可通过替换检索器模块支持多模态检索,且后续可独立升级生成器以支持公式生成。
五、Agentic RAG:引入智能代理,实现自主决策与迭代
5.1 工作原理:具备反思能力的闭环系统
Agentic RAG 是当前最先进的 RAG 形态,核心是在系统中引入智能体(Agent),赋予 RAG 自主规划、反思与迭代的能力:
问题分析: Agent 接收用户问题后,判断是否需要检索(如 “地球周长是多少” 可能无需检索,模型已掌握);
检索规划: 对复杂问题拆解为多步检索任务(如 “分析 2023 年新能源汽车销量数据,并预测 2024 年趋势” 需先检索 2023 年销量、政策变化、供应链情况等);
检索执行: 多条检索任务的执行可以使用单智能体完成,也可以调用多个智能体来完成。
单智能体方式主要是对多个数据源进行分别检索。
图:单智能体完成检索
多智能体方式下,主智能体负责检索路由,各个专用智能体负责处理不同的检索类型和工作流。
图:多智能体完成检索
反思: 执行检索后,Agent或者主Agent评估答案是否准确(如 “数据是否完整?逻辑是否矛盾?”),若不满足则重新规划检索(如补充检索某地区细分数据);
生成输出: 完成多轮检索与验证后,生成最终答案。
5.2 技术特点:智能决策,复杂问题的终极解决方案
优点
支持多步推理:可处理需要 “拆解 - 检索 - 整合” 的复杂问题;
自主优化能力:Agent 的反思机制可减少人为干预,提升系统鲁棒性;
适应动态环境:可根据知识库更新自动调整检索策略(如新增数据时优先检索最新文档)。
缺点
系统复杂度极高:需设计 Agent 的决策逻辑、反思规则,调试难度大;
响应速度慢:多轮检索与反思会增加 latency(通常比 Advanced RAG 慢 2-5 倍);
成本高昂:Agent 模块需搭配更强的计算资源与更复杂的工程实现。
5.3 适用场景
适合高复杂度的知识密集型任务,如金融投研分析(需整合多源数据:财报、新闻、政策、行业报告)、法律咨询(需检索案例、法条并进行多步推理)等。例如,当用户提问 “某公司 2023 年营收下降的原因,结合其财报、行业趋势与竞争对手表现分析” 时,Agentic RAG 可拆解为 “检索该公司财报→分析营收构成→检索行业整体数据→对比竞争对手表现→综合归因” 四步,自主完成多轮检索与验证。
六、四大模式对比:从技术到场景的全方位权衡
为直观呈现四大模式的差异,我们从 6 个核心维度进行对比(表 1):
| | | | |
| | | | |
| | | | |
| | | | |
| | | | |
| | | | |
七、总结与选型建议
从 Naive RAG 到 Agentic RAG,技术演进的核心是 “从静态检索到动态决策”“从单一功能到多元适配”。选型时需结合业务需求、资源投入与技术储备综合判断:
🌐
若需快速验证概念,且知识规模小:优先选择 Naive RAG;
若需平衡精度与成本,处理中等复杂度问题:Advanced RAG 是性价比之选;
若需对接多源数据或频繁迭代模块:Modular RAG 的灵活性更适配;
若需处理高复杂度、多步推理任务,且资源充足:Agentic RAG 是长期方向。
未来,RAG 的发展将进一步向 “多模态融合”、“实时知识更新”、“轻量化部署” 方向演进,而模块化与 Agent 化的结合(如 Modular Agentic RAG)可能成为主流形态。掌握四大模式的核心差异,将为技术落地提供清晰的路径图。