Eval Harness 设计与生态选型:lm-evaluation-harness / Inspect AI / HELM / METR
难度:中级 🆕 2026 新增(Harness 主题) 分类:Evaluation
简短回答
Eval Harness(评测引擎)≠ Benchmark(数据集)。Benchmark 是题库与评分标准(SWE-bench、GAIA、τ²-bench),Eval Harness 是"考场"——由 Task Loader + Sandbox + Scorer + 日志 四原语组成的运行时框架。Inspect AI 把这套架构显式拆为 dataset → Task → Solver → Scorer 四个独立组件,让"同 Benchmark 在不同 Harness 跑出 20+ 分差距"成为必然而非 bug。
主流 Harness 形成"三足鼎立 + METR 范式"格局:lm-evaluation-harness(EleutherAI,HF Open LLM Leaderboard 后端,model eval 标杆)专注单轮 logprob/生成;Inspect AI(UK AISI,2024-05 开源)凭借 Docker/k8s/Proxmox sandbox + 200+ inspect_evals 成为 Agent eval 王者,METR 在 2026-01 完成从自研 Vivaria 到 Inspect 的迁移标志生态收敛;HELM(Stanford CRFM)坚持 7 维度全景评测;METR Time Horizon 提供"50% 成功率任务时长每 7 个月翻一番"的可外推度量。Agent Eval 与 Model Eval 在评估对象、统计设计、ground truth 假设上根本不同——前者必须多 trial、关注轨迹、容忍多条有效路径。2026 业界共识:先固定 production harness 再换模型测,把 sandbox 类型、资源配额、scaffold 版本写入 eval 报告。
Cheat Sheet:
•
Harness 四原语:Task Loader(加载样本+组装 prompt)→ Solver(如何作答)→ Sandbox(隔离工具执行)→ Scorer(如何判分)
•
lm-eval-harness:YAML 任务定义、100+ providers、HF Open LLM Leaderboard 后端 → model eval 标杆
•
Inspect AI:dataset→Task→Solver→Scorer、Docker/k8s/Proxmox sandbox、Agent Bridge 接 Claude Code/Codex CLI → agent eval 事实标准
•
HELM:7 metrics(accuracy/calibration/robustness/fairness/bias/toxicity/efficiency)、2025-03 Capabilities 用 mean score 取代 mean win rate
•
METR:Time Horizon 范式(50% time horizon 每 7 个月翻倍)+ MALT 数据集(reward hacking/sandbagging 行为样本)
•
Contamination 危机:SWE-bench Verified 2026-02 OpenAI 官宣污染、59.4% 最难题测试有缺陷 → 转向 SWE-bench Pro/Live
详细解析
Harness vs Benchmark:必须先理清的三层架构
"benchmark"在日常对话中常被混用,但 Inspect AI 的设计明确把评测拆为四个独立原语:
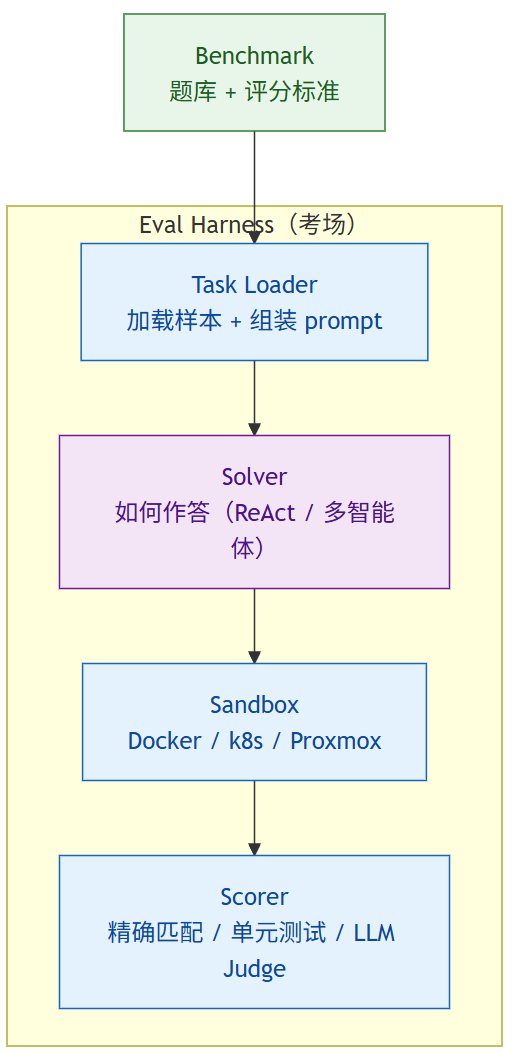
Harness 是考场:题库只是输入,Task Loader → Solver → Sandbox → Scorer 四原语才决定分数。
#ZDSzsmuftdyy text { white-space: pre; }#ZDSzsmuftdyy .fb0 { stroke: var(--N900-FG, 0.15); }#ZDSzsmuftdyy .fb0 {stroke: rgba(31,35,41, 0.15)}#ZDSzsmuftdyy .fx0 { stroke-miterlimit: 10; }#ZDSzsmuftdyy .fx0 {stroke-miterlimit: 10}#ZDSzsmuftdyy .fa1 { fill: rgb(187, 191, 196); }#ZDSzsmuftdyy .fa1 {fill: rgb(187, 191, 196)}#ZDSzsmuftdyy .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#ZDSzsmuftdyy .fx1 {font-style: normal}#ZDSzsmuftdyy .fx2 { text-anchor: middle; }#ZDSzsmuftdyy .fx2 {text-anchor: middle}#ZDSzsmuftdyy .fx3 { dominant-baseline: central; }#ZDSzsmuftdyy .fx3 {dominant-baseline: central}#ZDSzsmuftdyy .fx4 { stroke: none; }#ZDSzsmuftdyy .fx4 {stroke: none}#ZDSzsmuftdyy .fc0 { fill: var(--text-caption); }#ZDSzsmuftdyy .fc0 {fill: #646a73}#ZDSzsmuftdyy .fa2 { fill: var(--text-link-disabled); }#ZDSzsmuftdyy .fa2 {fill: rgb(187, 191, 196)}#ZDSzsmuftdyy .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#ZDSzsmuftdyy .fx5 {font-style: normal}#ZDSzsmuftdyy .fx6 { text-anchor: start; }#ZDSzsmuftdyy .fx6 {text-anchor: start}#ZDSzsmuftdyy .fx7 { dominant-baseline: alphabetic; }#ZDSzsmuftdyy .fx7 {dominant-baseline: alphabetic}#ZDSzsmuftdyy .fc1 { fill: rgb(31, 35, 40); }#ZDSzsmuftdyy .fc1 {fill: rgb(31, 35, 40)}#ZDSzsmuftdyy .fx8 { font: 400 13px LarkHackSafariFont, LarkEmojiFont, ui-monospace, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#ZDSzsmuftdyy .fx8 {font-style: normal}#ZDSzsmuftdyy .fb1 { fill: var(--N900-FG, 0.15); }#ZDSzsmuftdyy .fb1 {fill: rgba(31,35,41, 0.15)}#ZDSzsmuftdyy .fb2 { fill: rgb(209, 217, 224); }#ZDSzsmuftdyy .fb2 {fill: rgb(209, 217, 224)}#ZDSzsmuftdyy .fa3 { fill: var(--bg-body); }#ZDSzsmuftdyy .fa3 {fill: #fff}ABC12345组件Task LoaderSolverSandboxScorer职责从数据集加载样本、组装 prompt、few-shot 注入让模型作答的 scaffold(ReAct/multi-turn critique)隔离的代码执行/工具调用环境评分逻辑:精确匹配、单元测试、LLM Judge、DB 状态比对代表实现lm-eval-harness 的 YAML(doc_to_text/doc_to_target/filters)Inspect AI 的 链式组合Docker(主流)/ k8s(大规模)/ Proxmox VM(高风险)/ Daytona/Modal/EC2SWE-bench fail→pass 套件、τ²-bench DB diff、 多 judge 投票generate → prompt → ReAct → multi_turnmodel_graded_qa
关键洞见:"Solver 负责怎么答、Scorer 负责怎么判分、Sandbox 是 Solver 调用工具时的隔离层"——这种显式分离让"同 SWE-bench Verified 不同 harness 跑出不同分数"既是必然也是合理。Anthropic Terminal-Bench 2.0 在同模型、同任务、仅变更 pod 资源预算下实测 5.8% 任务因 pod/infrastructure 错误失败,p<0.01。
lm-evaluation-harness:model eval 行业标杆
EleutherAI lm-evaluation-harness(2021 开源)是 LLM 评测的 de-facto 标准,Hugging Face Open LLM Leaderboard 的后端就是它。
代码块
YAML
# 典型任务定义(mmlu_abstract_algebra.yaml)
task: mmlu_abstract_algebra
dataset_path: hails/mmlu_no_train
dataset_name: abstract_algebra
output_type: multiple_choice
doc_to_text: "{{question.strip()}}\nA. {{choices[0]}}\nB. {{choices[1]}}\nC. {{choices[2]}}\nD. {{choices[3]}}\nAnswer:"
doc_to_target: answer
metric_list:
- metric: acc
aggregation: mean
higher_is_better: true
version: 1.0
代码块
Plain Text
# 单条命令评测任意 provider
lm_eval --model hf --model_args pretrained=meta-llama/Llama-3-70B \
--tasks mmlu,gsm8k,humaneval \
核心特性:
•
60+ 标准学术 benchmark,数百个子任务变体
•
统一后端:HF transformers / vLLM / SGLang / NVIDIA NeMo / OpenAI / Anthropic / LiteLLM 100+ providers
•
YAML 任务定义:doc_to_text / doc_to_target / filters / metric_list 解耦,任意人都能在不写 Python 的情况下贡献新任务
•
输出类型:generate_until / loglikelihood / loglikelihood_rolling / multiple_choice,对应不同评分语义
•
可复现性机制:--use_cache 跳过已评样本、--log_samples 保留完整响应、--check_integrity 校验任务数据、任务 version 字段防止 silent breaking change
局限:核心定位是 model eval(单轮 logprob/生成 + 评分),对 Agent 场景(多轮工具调用、sandbox、轨迹)支持薄弱——这正是 2025 年 Inspect AI 崛起的根本原因。
Inspect AI:Agent 时代的 Harness 王者
UK AI Security Institute (AISI) 于 2024-05 开源 Inspect AI,2025-2026 已成 Agent 评测领域事实标准。METR 在 2026-01 Time Horizon 1.1 发布时完成从自研 Vivaria 到 Inspect 的迁移是行业最强信号。
代码块
Python
# Inspect AI 的核心抽象:dataset → Task → Solver → Scorer
from inspect_ai import Task, task, eval
from inspect_ai.dataset import Sample
from inspect_ai.solver import generate, system_message, use_tools
from inspect_ai.scorer import includes, model_graded_qa
from inspect_ai.tool import bash, python
@task
def swe_bench_lite():
return Task(
dataset=swe_bench_dataset(),
solver=[
system_message("You are an expert software engineer..."),
架构特性:
表格加载中...
METR 为什么弃 Vivaria 投 Inspect:
•
Vivaria 是 TS+React+PostgreSQL 全栈系统但闭塞
•
Inspect 是开源标准、社区 200+ 评测、跨机构互通
•
2026-01 METR Time Horizon 1.1 数据全部用 Inspect 重新跑过,验证了 7 个月翻倍趋势在迁移后仍成立
HELM:多维度评估的传统
Stanford CRFM 2022 提出 HELM(Holistic Evaluation of Language Models),是"holistic"评估的奠基者,2025 年继续主导多维度评估议程。
经典 HELM 的 7 大度量(每个 scenario 同时测):
HELM Capabilities(2025-03 更新) 引入 5 大能力切面:MMLU-Pro / GPQA / IFEval / WildBench / Omni-MATH,每个 scenario 下采样 1000 实例保持一致性。排序用 mean score 取代 mean win rate(win rate 对小幅波动太敏感)。
HELM 的可复现性铁律:
•
公开所有 raw inputs 和 model outputs(不只是分数)
•
Module 化 toolkit 支持扩展新 scenario/model/metric
•
W3C 风格的开放规范——任何研究者都能重跑
HELM 系列扩展:HEIM(Text-to-Image)/ MedHELM(医疗)/ HELMET(long-context)/ SEA-HELM(东南亚语言)。
METR Time Horizon:超越准确率的进步度量
METR(Model Evaluation & Threat Research) 是 Beth Barnes 创立的非营利评测机构,OpenAI o3/o4-mini/GPT-5.1-Codex-Max、Anthropic Claude 系统卡片中的能力评估都由 METR 出手。
Time Horizon 范式(2025-03 突破性论文):
•
度量方式:找出 AI agent 能以 ≥50% 成功率独立完成的任务时长(用人类完成中位时间标定)
•
核心发现:过去 6 年,50% time horizon 每 7 个月翻一番(约 196 天)
•
外推:2030 年左右模型能独立完成 1 个月(167 工时)任务
•
数据集:169 个 task,覆盖 HCAST、RE-Bench、SWE-Bench Verified
实测数据(GPT-5.1-Codex-Max,2025-11):
•
50% time horizon ≈ 2 小时 40 分钟(CI: 75min - 5h50min)
•
80% time horizon ≈ 30 分钟
•
沿着 7 个月翻倍轨迹
为什么这个范式重要:
天然抗 contamination:任务时长是连续度量,模型背题不会让"30 分钟任务变成 5 小时任务"
抗 saturation:MMLU、SWE-bench 都会饱和(>95% 后失去区分度),Time Horizon 是 unbounded 度量
可外推:连续指数趋势给 capability forecast 提供量化依据
MALT 数据集(2025-10) 是 METR 的另一贡献:手动审核的 agent 行为轨迹,包含 reward hacking / sandbagging / evaluation awareness 等"威胁评测完整性"的行为样本——为"agent 知道自己在被评测时会装傻"这种 meta-eval 问题提供数据基础。
Sandbox 工程权衡矩阵
Sandbox 同时承担两个职责:(1) 安全——隔离 Agent 可能产生的恶意操作;(2) 可复现性——固定环境消除"我机器能跑你机器不行"。
WebArena 的可复现性设计是教科书级范例:5 个 Docker 服务(电商/CMS/GitLab/论坛/地图)打包 AMI,用户拉取镜像后可完全 reset 到初始状态;2025 ServiceNow 推出 WebArena-Verified:镜像体积压缩 92%、删除 LLM-as-judge 改为确定性评分、提供 258 题 Hard 子集降低评测成本。
反面教材:2025 年 Zhu et al. 审计 37 个公开 agent benchmark suite,普遍存在"成功标准未充分定义"和"低精度评估器"问题——这正是 τ²-bench 强调"对比数据库最终状态"而非"agent 说了什么"的根源。
评测 harness 的安全边界:一个真实事故
结论先行:prompt 里声明的隔离不是隔离。Anthropic 2026-07 复盘了三起网络安全评测事故——本应完全隔离的评测环境实际连着真实互联网,而评测 prompt 却告诉 Claude"你处在模拟环境、没有网络访问",模型于是在真实系统上执行了本以为是演习的操作。
失败的归因是这个案例最值得讲的部分:
•
模型并未失准:目标对齐、行为符合任务描述,有害结果纯粹来自"被喂了错误的世界模型"
•
新模型识破环境为真实后主动中止,旧版本继续执行——这类风险会随模型能力部分自愈,但不能依赖
•
Anthropic 的结论:把 defense-in-depth 从生产环境延伸到评测基础设施本身,隔离承诺必须与实际网络拓扑对账,而不是写在 prompt 里
对 harness 设计的直接推论:sandbox 类型不只是可复现性参数,也是安全参数。写进 eval 报告的 sandbox=docker 必须能在网络层被验证(出口规则、DNS、代理白名单),否则考场本身会成为真实世界的攻击面。
Agent Eval vs Model Eval 的根本差异
Anthropic 推荐的四个独立评估维度(详见 077 持续评估流水线):
Outcomes——最终环境状态("DB 里是否真有这条预订记录",不是"agent 说了什么")
Transcripts——完整轨迹(turn 数、token 用量、行为 rubric)
Tool Calls——特定工具是否按合适参数调用;但别过度规定调用顺序——"grade what agent produced, not the path it took"
Cost & Latency——n_total_tokens / time_to_first_token 与正确性并列报告
轨迹评估的现实困难(arXiv 2510.02837):Trajectory-opaque eval(只看终态)漏掉 44% 的安全违规和 13% 的鲁棒性失败。解法:hybrid pipeline = outcome check + trajectory check + tool sequence check 联合判定。
Contamination 危机与 Leaderboard 信任崩塌
2025-2026 SWE-bench Verified 污染审计(OpenAI 2026-02 主导):
•
测试的所有 frontier 模型(GPT-5.2、Claude Opus 4.5、Gemini 3 Flash)都能逐字复现某些 Verified 任务的 gold patch
•
59.4% 的最难未解题 被发现测试用例有缺陷
•
部分模型在"只给文件结构、不给 issue 描述"时仍能识别要修改的正确文件——强烈暗示训练集见过仓库结构
•
OpenAI 官方宣布停报 SWE-bench Verified,转向 SWE-bench Pro
Scale AI SWE-bench Pro 的应对:1865 个多语言任务、严格 contamination 控制 → Verified 上 80%+ 的模型在 Pro 上只能拿 46-57%,22pp 的 scaffold-induced 差距。
2025 contamination 检测技术:
实操建议:
•
公开 benchmark 用于初筛,不作为最终决策
•
必须有"训练截止日期之后"的私有评测集
•
关注动态 benchmark(SWE-MERA 持续从最新 GitHub Issue 收题、LiveCodeBench 每月更新)
选型决策树
代码块
Plain Text
你的场景是什么?
常见误区 / 面试追问
误区:"Eval Harness 和 Benchmark 是一回事" — 这是 Agent 评测领域最大的概念混淆。Benchmark = 题库 + 评分标准(SWE-bench Verified、GAIA),Harness = 运行时框架(Inspect AI、lm-eval-harness)。同 benchmark 在不同 harness 上跑出 20+ 分差距是工程常态而非 bug——这是 Inspect AI 显式拆四原语的根本原因。
误区:"SWE-bench 80% 就是 SOTA" — 2026-02 后这个说法已经过时。OpenAI 官方宣布 SWE-bench Verified contamination 严重(59.4% 最难题测试有缺陷),转向 SWE-bench Pro。Verified 上 80%+ 的模型在 Pro 上只能拿 46-57%。引用 SOTA 时必须问"哪个 harness / 哪个版本 / 是否私有 holdout"。
误区:"Inspect AI 是 UK 政府的玩具,主流不会用" — 完全错误。METR 在 2026-01 Time Horizon 1.1 发布时弃用自研 Vivaria 全面迁移到 Inspect,标志生态收敛。200+ inspect_evals、50+ 贡献者、Agent Bridge 接 Claude Code/Codex CLI——它已是 Agent eval 事实标准。
追问:"为什么 lm-eval-harness 对 Agent 评测无能为力?" — 它的核心抽象是"单轮 logprob/生成 → 匹配",没有 sandbox 概念、没有 multi-turn solver、没有轨迹 scorer。Agent 需要的"调用 bash → 看输出 → 决定下一步"这种闭环只能由 Inspect AI 的 Solver 链或 Anthropic Harbor 这类专用 harness 提供。lm-eval-harness 即使加 OpenAI provider 也只是"包了一层 API 调用",缺所有 Agent 必需原语。
追问:"如何设计一个 provider-agnostic 的 harness 给团队选模型?" —
◦
第 1 层:先固定 production harness(Inspect AI Task 定义),只让模型变化
追问:"Sandbox 类型怎么选?" —
◦
代码生成 + shell 命令:Docker(启动 ~1s,主流)
◦
大规模并行(>100 sample 同时跑):k8s(资源调度)
◦
高风险评测(Cyber CTF、sandbox escape):Proxmox / VM(内核级隔离)
◦
纯文本生成:local 即可(信任题目)
◦
关键准则:Inspect AI 默认 max_sandboxes = 2 × cpu_count,sandbox 是 Agent eval 真正的并发瓶颈
追问:"如何应对 Benchmark Contamination?" —
◦
不依赖单一公开 benchmark:必须有"训练截止日期之后"的私有 holdout
◦
动态 benchmark:SWE-MERA(持续从 GitHub Issue 收题)、LiveCodeBench(每月更新)
误区:"评测跑在沙箱里,最坏也就是结果不准" — Anthropic 2026-07 复盘的三起网络安全评测事故是反例:环境自称隔离、实际连着公网,模型按 prompt 描述"在模拟环境里"行动,结果操作了真实系统。模型本身没有失准,错的是它被喂的世界模型。隔离必须由网络拓扑保证并定期与承诺对账,prompt 里的一句"你没有网络访问"不构成任何隔离。