回归测试:如何检测 Agent 性能退化?
简短回答
LLM/Agent 回归测试是在每次变更(Prompt 修改、模型升级、代码更新)后自动运行测试套件,检测性能是否退化的工程实践。与传统软件回归测试的关键区别:LLM 输出是非确定性的——同一输入可能产生不同输出,不能用简单的"输出相等"判断。核心方法:(1) Golden Dataset——维护一组标注好的输入-期望输出对,每次变更后自动评估;(2) 质量指标监控——追踪准确率、延迟、成本等指标的变化趋势;(3) LLM-as-Judge 自动评分——用 LLM 对比变更前后的输出质量;(4) CI/CD 集成——在部署管道中自动运行回归测试,不通过则阻止部署。Braintrust、LangSmith 等工具提供了开箱即用的回归测试集成。关键原则:每次 Prompt 或模型变更都必须有回归测试保障。
详细解析
为什么 LLM 需要回归测试?
代码块
Plain Text
导致性能退化的变更类型:
1. Prompt 修改
修改了 System Prompt 的一个词 → 安全护栏失效
添加了新规则 → 与旧规则冲突导致输出混乱
2. 模型升级
API 提供商更新了模型版本 → 行为微妙变化
GPT-4-0613 → GPT-4-turbo → 某些任务准确率下降
3. 工具/环境变更
API 返回格式变化 → Agent 解析失败
新增工具 → 干扰了原有的工具选择策略
4. 数据变更
RAG 索引更新 → 检索结果变化 → 回答质量变化
Few-shot 示例修改 → 输出风格/质量变化
回归测试框架
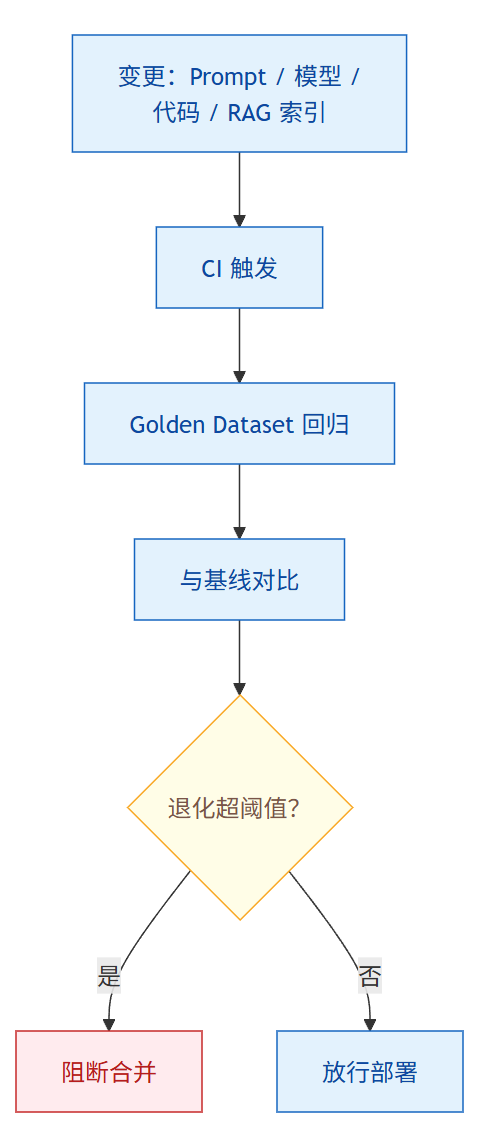
Prompt 和代码一样过 CI:变更触发 Golden Dataset 基线对比,退化超阈值就阻断合并。
代码块
Python
class LLMRegressionTester:
"""LLM/Agent 回归测试框架"""
def __init__(self, golden_dataset, metrics, threshold):
self.dataset = golden_dataset # 标注好的测试集
self.metrics = metrics # 评估指标
Golden Dataset 的设计
代码块
Python
class GoldenDataset:
"""维护回归测试的黄金数据集"""
def __init__(self):
CI/CD 集成
代码块
Python
# GitHub Actions 集成示例
ci_cd_config = """
# .github/workflows/llm-regression.yml
name: LLM Regression Test
on:
pull_request:
paths:
- 'prompts/**' # Prompt 文件变更触发
- 'config/model.yaml' # 模型配置变更触发
- 'src/agent/**' # Agent 代码变更触发
jobs:
regression-test:
runs-on: ubuntu-latest
steps:
非确定性输出的处理
代码块
Python
监控仪表盘
代码块
Plain Text
回归测试监控看板:
┌─────────────────────────────────────────────┐
│ Agent v2.3 回归测试报告 │
├─────────────────────────────────────────────┤
│ 总体通过率:94% (47/50) vs 基线: 96% │
常见误区 / 面试追问
误区:"LLM 输出不确定,没法做回归测试" — 非确定性不是不能测试的理由。用多次运行取统计指标(均值、方差、通过率),用 LLM-as-Judge 评估语义质量而非精确匹配,用统计检验判断是否有显著退化。
误区:"回归测试只需要在大更新时做" — Prompt 的微小修改也可能导致显著的行为变化。最佳实践是将回归测试集成到 CI/CD,每次 Prompt 或配置变更都自动触发。这在初期投入大,但长期节省大量排错时间。
追问:"Golden Dataset 多大合适?" — 取决于 Agent 的复杂度。建议最少 50 个测试用例覆盖核心场景,理想情况 200-500 个。每个用例应标注优先级——高优先级的用例(如安全相关)必须 100% 通过。
追问:"如何维护 Golden Dataset 的时效性?" — (1) 从生产中发现的 bug 转化为测试用例(增长策略);(2) 定期审查和淘汰过时的用例;(3) 随着功能迭代补充新场景的用例。Golden Dataset 应该是活的,随产品演进。