一文搞懂 Graph Engineering(图工程)14步拆解
🔍多数开发者构建多步骤智能体时,最终产出仅为线性串行流程:任务按次序依次执行,后序步骤需等待前序任务完成。实践中近半数等待环节属于不必要的阻塞。这类线性实现缺少路由分支、并行调度能力,本质是顺序排队执行:单上下文、串行处理任务。一旦上下文窗口占满,极易出现任务状态丢失。
本文提供一套包含 14 个要点的工程路线图,指导开发者将线性流程重构为智能体图拓扑:支持大规模子智能体集群协同、结果交叉校验,达成单体智能体无法实现的复杂任务能力。
节点即作业,边即流向
图结构由两类基础要素构成:
•
节点是具备清晰边界的执行单元,可以是智能体或是独立任务,拥有明确输入与输出。
•
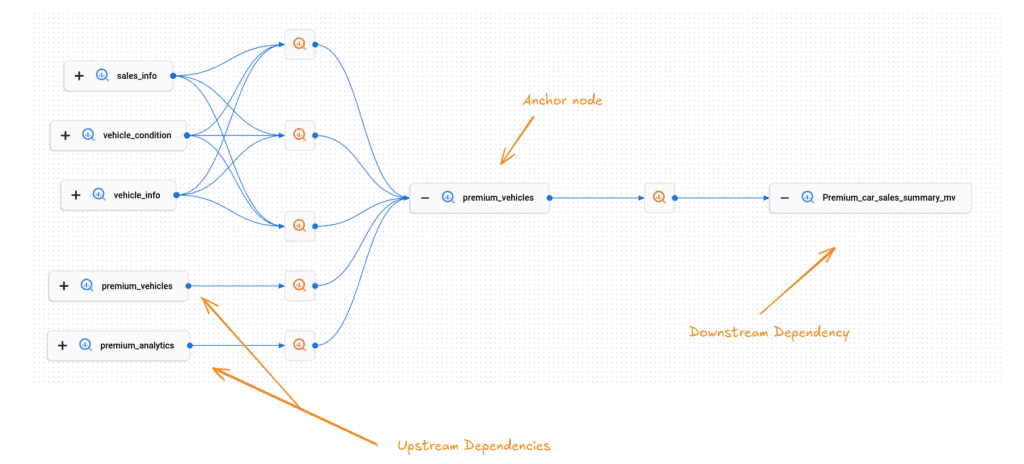
边表征依赖关系:上游节点输出向下游节点传递数据。
很多开发者存在典型误区:单纯以执行顺序定义连接关系。例如「文档总结,随后查询天气」,两个任务不存在数据互通,不具备有效边。线性脚本强行串行,引入无效等待。
⭕
判定标准:针对流程中每一处顺序执行逻辑,确认后继任务是否消费前序输出;若无数据消费,则不存在有效边,等待逻辑应当移除。
代码块
Python
Draw it as boxes and arrows. A box is an agent() call.
An arrow is a variable passed from one call’s return into another’s
prompt. If you can’t draw the arrow - if no variable crosses - the two
boxes are independent, and independence is the thing you’ll exploit
for the rest of this course.
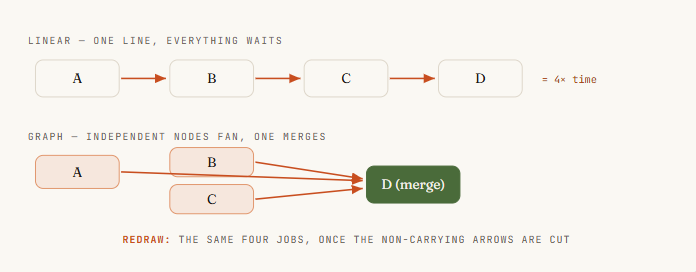
线性脚本是退化图结构
A→B→C→D 这类串行流程,本质是仅存在单条通路的退化图,每个节点仅有一条入边、一条出边。 该方案可正常运行,但执行延迟高、容错性差。链式结构无冗余机制,任一节点阻塞,下游全部任务停滞。
⭕
图工程首要能力就是重构串行链路:逐条审视节点间箭头,识别不存在数据传输的顺序依赖;移除无效连接后,串行链路将拆分为多个独立节点并发执行,输出汇聚至下游节点。
为所有节点定义接口契约
无法标准化输入输出的节点,难以实现并行调度。
💡 解决方案是建立执行契约:限定输入范围、标准化输出结构,单一节点仅承担一类职责。 输入由外部显式传入,禁止从共享上下文隐式读取;输出具备可校验的数据结构,下游节点无需额外解析。
⭕
在动态工作流中,契约通过 JSON Schema 强制约束。调用agent()并绑定结构范式后,子智能体必须输出合规结构化数据;校验在工具层自动执行,格式异常时自动重试,避免无结构自由文本带来的解析成本。这也是可嵌入图拓扑的节点,与仅面向人工阅读的智能体节点的核心区别。
代码块
JavaScript
将边视作数据契约
边不等于「B 在 A 之后执行」,而是一份数据流转约定:上游产出指定结构数据,下游节点按照该结构完成消费。以数据流而非时序定义边,具备两大优势:快速判断依赖有效性;接口不变前提下,可替换两端节点,不破坏整体拓扑。
扇出、汇聚之间的数据规整(扁平化、去重、过滤)通过原生 JavaScript 实现,无需启动智能体处理。 图架构一大成本优势:大量开发者耗费 Token 处理链路数据规整,而依托代码实现的边逻辑零模型开销。
⭕
工程准则:切勿新建智能体做结果合并。扁平化、去重等数据规整属于管道逻辑,由代码即时完成,无需消耗 Token。若每条数据链路都依赖智能体处理,将产生大量无效算力开销。
使用 parallel 实现扇出调度
面对 N 个相互独立任务(多数据源检索、批量文档审阅、多条路径审计),应当放弃串行执行,采用扇出模式并发调度。 在并行流程中,Codex 接收一组任务函数,批量启动子智能体并发运行,最终统一返回结果数组。并行能力内置两项容错特性:
屏障机制:等待全部任务单元执行完毕,再进入下一阶段,保障下游获取完整数据集;
异常隔离:任务抛出异常仅返回 null,不会造成整批任务失败。
执行结果建议统一执行filter(Boolean)过滤失效任务。系统会根据并发上限自动排队,支持批量提交上百个子任务。
代码块
JavaScript
phase('Research');
// 9个数据源,启动9个智能体并发执行
const raw = await parallel(
SOURCES.map((s) => () =>
扇出调度逻辑由编排代码承载,不占用模型对话上下文。每个子智能体持有独立上下文,仅返回最终结论。依托该机制,系统可横向扩展至数百个子智能体,不会造成主会话上下文溢出;编排层全程不消耗 Token。
通过屏障节点完成扇入汇聚
扇出必须配套汇聚逻辑。扇入节点接收全部上游分支输出,执行依赖全局数据集的操作:跨数据源去重、优先级排序、空结果提前终止等。
⭕
屏障节点直接影响整体耗时,遵循原则:仅当下游阶段必须获取全部上游数据时,启用屏障。
仅做列表扁平化等单元素独立转换,直接使用代码内联处理,无需设置屏障。 判定标准:如果执行链路为「并行→数据转换→并行」,且转换逻辑不存在跨元素依赖,应当采用流水线模式,移除屏障阻塞。
代码块
JavaScript
// 链路处理:原生JS实现,无智能体、零Token消耗
const flat = collected.flatMap((c) => c.items);
log(`Collected ${flat.length} items`);
标准拓扑:菱形架构(拆分→并发执行→结果合并)
扇出搭配扇入,形成复杂智能体系统最核心的菱形拓扑。 单个节点拆解任务,多节点并行处理,最终由汇聚节点整合输出。
⭕
广泛适用于市场调研、依赖审计、代码评审、调研报告生成场景,更换指令与数据源即可复用。
标准范式可总结为:任务展开→数据归约→结论综合。展开环节拓宽信息广度;归约依靠轻量化代码压缩数据;最终由智能体完成综合输出。
掌握菱形拓扑后,设计重心将从「如何增加执行步骤」转向「识别合理拆分点与汇聚点」,这是系统规模化的关键。
基于运行时条件实现边路由
图拓扑不局限于静态结构,部分路径选择依赖节点运行结果。路由节点读取标准化输出,动态选择下游分支:例如工单分级分发、风险差异判定,选择快速评审或完整审计流程。
在动态工作流中,路由逻辑由 JavaScript 条件语句实现。
⭕
智能体负责风险分级判定,代码完成分支调度;相同判定结果每次运行路径保持一致,具备确定性。 智能体输出决策结论,编排脚本保障流程稳定;不会出现模型随机跳过指定流程的不可控情况,所有分支逻辑必须预先定义在拓扑内。
代码块
JavaScript
在链路边缘增设校验器
图架构的核心价值不在于扩充智能体数量,而是依靠结构化机制提升结果可信度。
校验节点部署在数据流入下游之前,负责验证、过滤无效结论,仅通过校验的数据允许继续流转。 三类成熟校验范式:
⭕
对抗性校验:启动多个独立智能体对同一结论进行质疑,多数校验通过方可保留;
多视角校验:校验单元分配独立评估维度(正确性、安全性、可复现性),依靠视角多样性捕捉同质校验遗漏问题;
该模式已落地于 Bun 运行时迁移项目,通过多智能体对抗审查完成代码评审。
节点隔离,限制故障扩散
线性链路故障具备级联效应,单个节点失效阻断全流程;图架构需要将故障约束在对应节点内部。parallel()内任务异常仅返回空值,其余正常节点可持续输出,配合filter(Boolean)实现基础容错。 另一类隐性风险是并行节点资源互相干扰(例如多智能体并发读写文件)。
⭕
解决方案为运行环境隔离:分配独立工作树,各智能体在沙盒内执行,最终统一合并变更。环境隔离属于可选安全机制,仅在存在并行写入冲突的拓扑中启用。
引入收敛可控的循环拓扑
部分探索类任务(漏洞挖掘、未知范围信息检索)需要迭代执行,单次发现可能衍生更多待处理目标,需引入循环结构,实现受控回溯。循环最大风险:无法收敛,持续生成任务耗尽算力预算。
推荐「直至无新增信息」收敛模式:持续启动检索节点,连续 N 轮无新发现时终止。设计重点:去重逻辑需要覆盖所有已扫描目标,而非仅确认有效结果。否则被剔除的无效目标会反复触发检索,循环永久运行。
代码块
JavaScript
const seen = new Set();
const confirmed = [];
节点分层调度不同规格模型
并非全部节点都需要使用高阶大模型。图拓扑能够清晰区分任务类型:提取字段、工单分类属于标准化重复任务;报告汇总、结论裁决需要深度推理判断。 低成本模型承载标准化任务,高阶模型保留给强推理场景,优化推理成本。
⭕
动态工作流默认继承会话所用模型,支持在单次agent()调用单独指定模型规格。大规模任务调度前,可将扇出内重复节点下沉至低成本模型,汇聚节点保留高性能模型;不改动拓扑结构,即可优化整体 Token 开销。
拓扑结构直接决定延迟与算力成本
图拓扑并非形式装饰,是影响运行时延的核心要素。
⭕
开发者常混淆parallel()与pipeline():
•
parallel()内置屏障,所有任务等待最慢单元完成后,才启动下一阶段;
工程默认优先选用pipeline();仅当阶段必须获取全部前置数据(全局去重、批量对比、整体提前退出),才启用屏障。不能为简化代码、形式上划分阶段而引入屏障,同步阻塞会带来可量化的额外时延。任务逻辑分离 ≠ 需要同步执行。
支持自动拓扑生成:动态布线
对于需求无法预先完整拆解的任务,无需手动绘制静态图。依托动态工作流,开发者仅描述目标,Claude 自动生成编排脚本:任务拆解、选择扇出策略、调度子智能体集群、整合最终结论,生成适配本次任务的专属流程,摆脱固定拓扑约束。
⭕
三种启用方式:
在提示词中声明workflow,自动生成对应工作流;
调用预制打包工作流,/deep-research为生产可用图谱:范围界定→并行检索→信息拉取→对抗校验→综合输出,完全匹配本文框架;
开启超代码模式,会话内复杂任务自动规划工作流。
单次运行效果达标后,按下 s 键将编排脚本保存至.claude/workflows/目录,纳入版本管理,支持按名称重复执行,项目协作成员可直接复用整套拓扑。