图工程的清晰解读
首先,是图本身
图由三部分组成。
•
节点是工作的基本单元,无论是代理、普通的模型调用、确定性函数、工具,还是由人类对某项内容进行审批。
•
边决定下一个执行的任务,可以按顺序、并行执行,或根据最后一个节点的输出结果有条件地执行。
•
状态是一个沿边流动的共享对象。每个节点都会从中读取数据并写入数据。
代码块
Python
graph.add_node("research", research_agent)
graph.add_node("write", writer_agent)
graph.add_node("review", reviewer_agent)
graph.add_edge("research", "write")
graph.add_edge("write", "review")
graph.add_conditional_edge("review",
lambda state: "done" if state.approved else "write")
这几乎就是每个示例都会用到的初始流程图。研究人员收集素材,作者撰写初稿,审稿人进行评审。若评审通过,则流程结束;若未通过,则由一条边将初稿退回给作者。
三个节点,四条边,其中一条边是环。
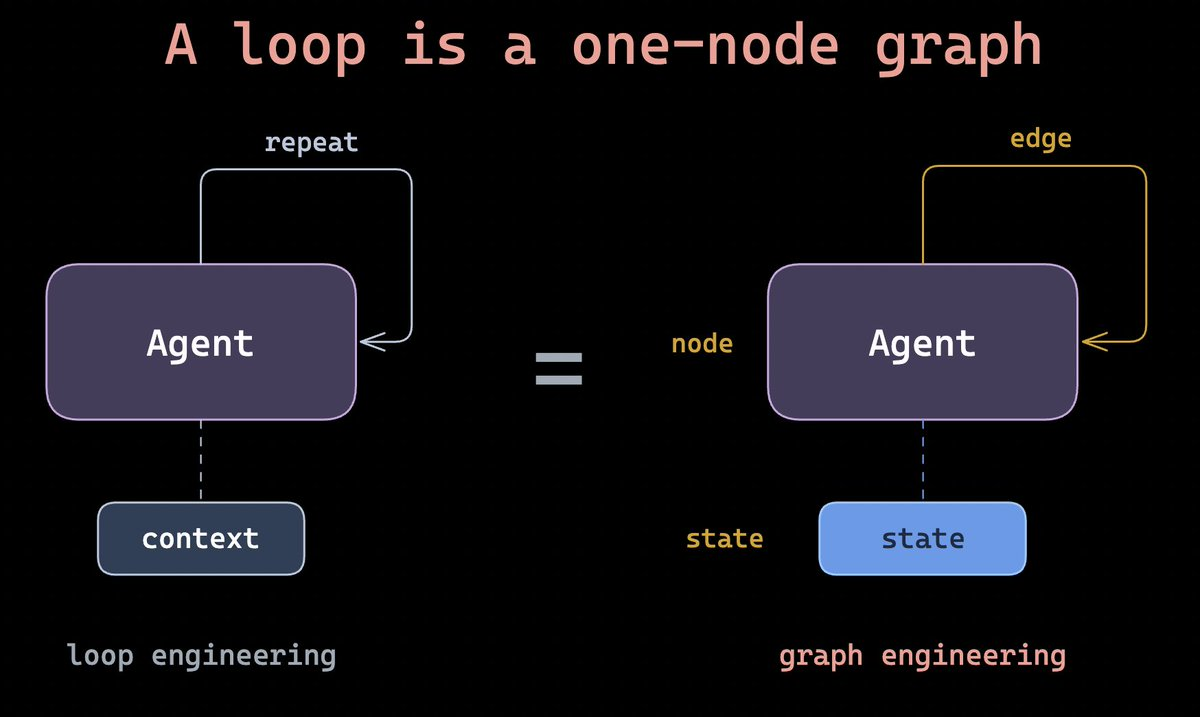
以下是重新定义一切的关键所在:单个智能体循环不过是一个单节点图,其中有一条边指向自身。图结构并不会取代循环,而是将它们连接起来并加以规范。
技术栈持续扩展
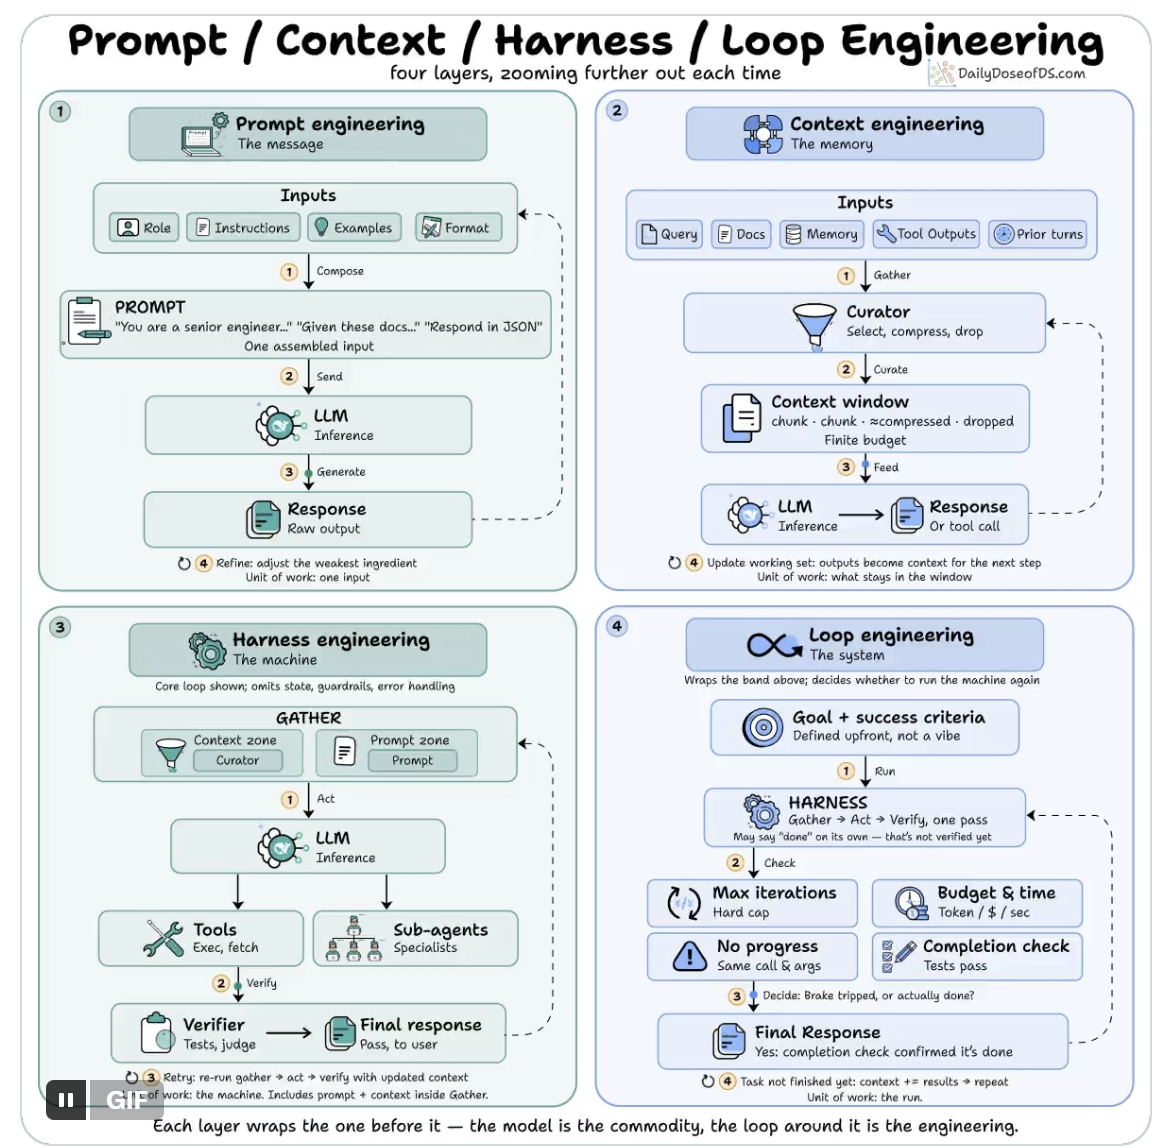
人工智能领域的重心不断远离模型,每一次偏移都冠以一个名称。
•
提示工程。你发出的语句。
•
上下文工程。模型所看到的一切,而不仅仅是你的指令。
•
框架工程。围绕模型运行工具、跟踪状态并处理错误的代码。
•
循环工程。驱动智能体朝着目标前进的自主循环。
•
图谱工程。跨多个循环的协调层,涵盖何时运行、以何种顺序运行,以及由谁对谁进行检查。
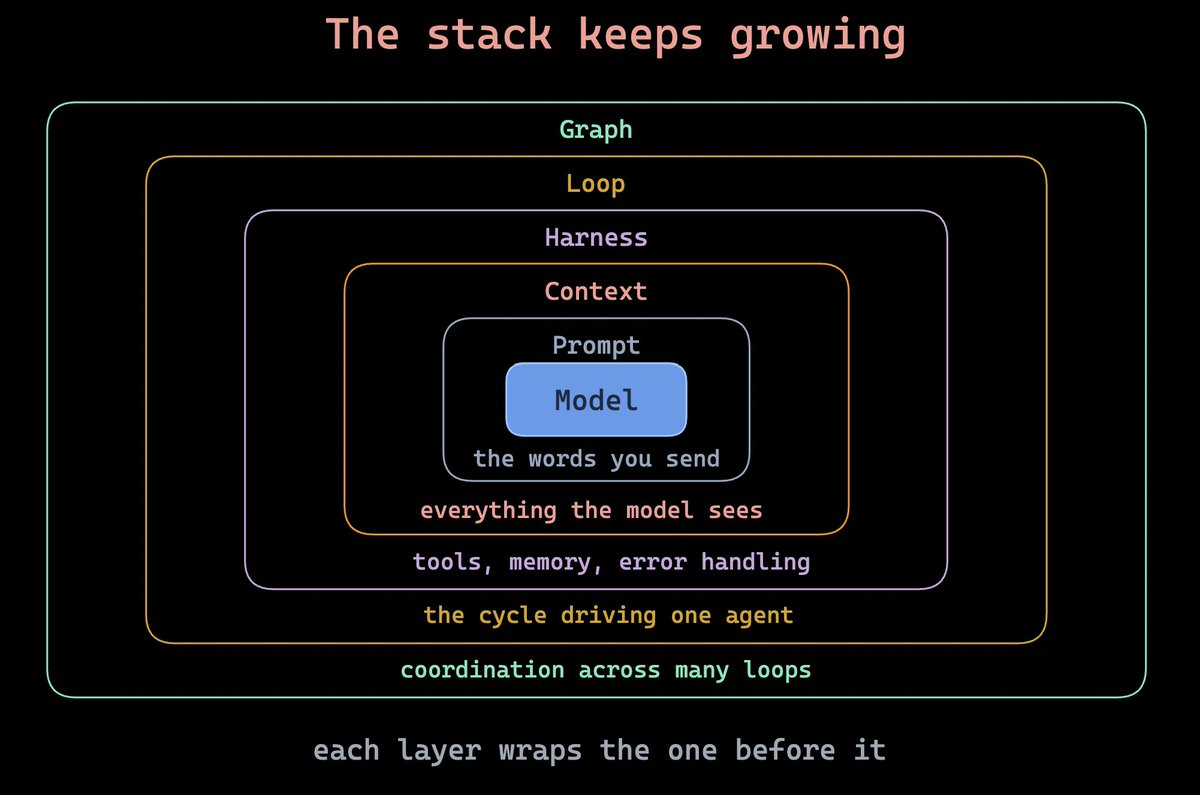
每一层都包裹着前一层。图由一个个循环构成,每个循环都需要一套完善的约束机制,每一次约束调用都涉及上下文问题,而每一个上下文又包含着提示信息。若跳过某一层,整个图就会以更复杂的方式崩溃。
还有一件事值得坦诚说明:这一切都不是什么新技术。早在2024年1月,LangGraph就已经推出了完全相同的模型——基于共享状态的节点与边。微软的AutoGen拥有GraphFlow,而谷歌更是将ADK 2.0的整个工作流运行时建立在同样的理念之上。名字是新的,做法却没变,这也正是为什么哈梅尔那条帖子的热门回复之一只是简单地写着:“欢迎回来,langchain。”
所以,这门学科并不是在发明图表,而是在懂得何时使用图表,以及如何让图表保持有效。这部分包含四个棘手的问题。
难点一:判断某个节点是否值得存在
最常见的失败是将“总结这份PDF”转化为一个由五个节点组成的图,其中包括一个抓取器、一个分块器、一个摘要生成器、一个审核器和一个格式化器。
只有当一个节点代表一种真正的专业领域时,它才能获得一席之地,也就是说,它必须对应一种不同的模型、一套不同的工具集,或者是一个真正独立的角色,例如只读评审者。那些可以内嵌到现有循环中的步骤,则不应被视为节点。
一个实用的判断标准来自相关领域的从业者:如果连一张餐巾纸都画不出这张图,那就太复杂了;而如果把两个节点合并为一个并不会损失任何信息,那它们本来就不是两个独立的节点。
难点之二:保持共享状态的整洁
在循环中,故障模式是上下文腐化;而在图中,同样的问题则表现为共享状态的污染。
每个节点都会向状态对象写入数据,因此节点二的一次粗心写入会成为节点五的可靠输入。直到输出出现错误时,才有人察觉,而到那时,这些错误数据早已在系统中流转了一半。
解决方案既简单又乏味,却十分有效:为状态定义明确的类型化模式;显式规定哪些节点可以写入哪些字段;在各节点之间定期保存状态检查点,以便在重放运行时精确定位问题发生的位置。
重放时需注意一点:检查点之后的节点会再次执行,因此任何具有外部副作用的节点,例如发送电子邮件或创建记录,都必须能够安全地重复运行。
难点三:值得信赖的路由
边是一次决策,而问题在于由谁来做出这一决策。
如果由模型决定路径,那么灵活性与不稳定性将并存。同一个状态在不同次运行中可能走向不同的路径,这使得调试变得异常棘手。
谷歌针对 ADK 2.0 的设计原则,在相关讨论中处于最清晰的立场。确定性代码应当负责控制可预测的路由,而模型则只需处理那些确实需要人工判断的步骤。
在条件可被检查的任何地方都使用代码进行路由,仅在确实需要解释时才进行模型调用。
难点四:智能体之间的相互认同
循环工程最严格的一条准则就是:绝不允许代理为自己批改作业。
图谱使博弈的 stakes 更高。二十个基于同一基础模型、读取相同有缺陷上下文的智能体,会欣然彼此认同,而模型也明显更倾向于自己的输出。
这种结果给人的感觉就像是工业规模下的“有序的胡言乱语”——无可挑剔的结构,却包裹着一个错误的答案。
解决方案是一个带有“牙齿”的审核节点。将其应用于不同的模型,为其提供全新的上下文而非整段对话,并将它的判断锚定于图谱无法伪造的证据,例如实际执行过的测试或确实编译通过的代码。
在运行其编码代理Devin一年后,Cognition的结论与此前并无二致。他们的工作模式允许多名代理阅读并发表意见,但每次只有一名代理获准对内容进行修改。
这种拆分才是最有用的部分。读操作可以安全地并行进行,因为在有人基于它采取行动之前,错误的读取不会带来任何损失。而写操作才是真正会产生损害的地方,因此将其集中在一个你能随时看到的位置。
在哪些情况下图表显得过于复杂
老实说,大多数时候都是这样。
Anthropic公布的数据使成本变得具体可见。单个智能体的运行消耗约相当于一次聊天交互的4倍token,而多智能体系统则约为15倍。每增加一个节点,这一消耗都会成倍增长。
只有当任务真正具备并行性时,天花板效应才会显现。在内部研究评估中,Anthropic的多智能体研究系统相较于单个Opus智能体高出90.2%,这是因为研究过程会自然地分解为相互独立的搜索任务。然而,他们在《构建高效智能体》一书中给出的指导原则并未发生改变。寻找尽可能最简单的解决方案,只有在任务确实需要时才增加复杂性。
就连 LangGraph 自己的说明也强调了这一点:如果你的智能体只是一个带有工具的简单循环,那么使用 LangGraph 就显得过于复杂了。
决策规则非常简单:当工作分解为真正的专业领域、需要并行的分支与汇合、每一步都需要不同的模型,或者需要故障隔离与可审计的路由时,就采用图式;否则,仍使用循环。
从哪里开始
您无需在第一天就建立代理组织架构,可逐步完善。
•
先熟练掌握单个循环,配备刹车、严格的完成度检查以及专业点评。薄弱循环的图表无非就是一种分散的失败表现。
•
在编写代码之前先在纸上画出图,并要求每个节点都为其存在提供理由。
•
提前定义状态模式并明确写入规则。状态漂移是导致图结构腐烂的主要原因。
•
将评审节点替换为具有全新上下文的其他模型,并将其与外部证据关联起来。
•
为每个节点设置预算上限。一张图由许多并行消耗代币的循环组成,而一个弱验证者如今会同时消耗资金。
要点
图谱工程并非一门取代回路工程的新学科,而是一个约定俗成的名称,每个智能体构建者迟早都会面临这一抉择:当单一回路已不足以应对时,协调便成为核心的工程任务。
这个词或许撑不过今年,但设计问题却会。
以下是图工程中的关键要点总结