【关于 判别式(discriminative)模型 vs. 生成式(generative)模型】 那些你不知道的事
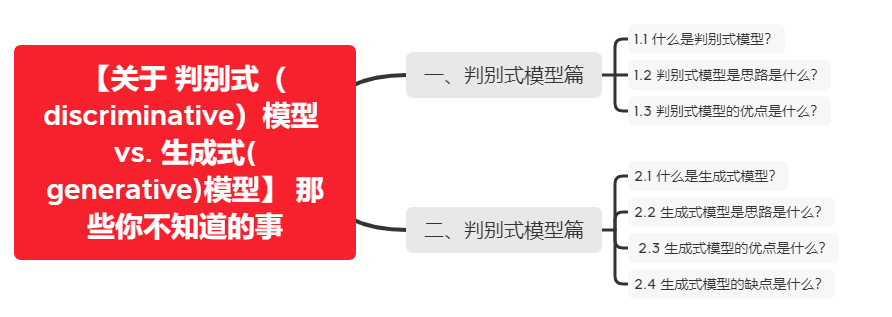
一、判别式模型篇
1.1 什么是判别式模型?
判别模型是直接对P(Y|X)建模,就是说,直接根据X特征来对Y建模训练。
1.2 判别式模型是思路是什么?
对P(Y|X)建模;
对所有的样本只构建一个模型,确认总体判别边界;
观测到输入什么特征,就预测最可能的label;
1.3 判别式模型的优点是什么?
对数据量要求没生成式的严格,速度也会快,小数据量下准确率也会好些。
二、生成式模型篇
2.1 什么是生成式模型?
在模型训练中,我学习到的是X与Y的联合模型 P(X,Y) ,也就是说,我在训练阶段是只对 P(X,Y) 建模,我需要确定维护这个联合概率分布的所有的信息参数。完了之后在inference再对新的sample计算 P(Y|X) ,导出 Y,但这已经不属于建模阶段了。
2.2 生成式模型是思路是什么?
1.对 P(X,Y) 建模;
这里我们主要讲分类问题,所以是要对每个label( yi)都需要建模,最终选择最优概率的label为结果,所以没有什么判别边界。(对于序列标注问题,那只需要构件一个model);
中间生成联合分布,并可生成采样数据。
2.3 生成式模型的优点是什么?
所包含的信息非常齐全,我称之为“上帝信息”,所以不仅可以用来输入label,还可以干其他的事情。生成式模型关注结果是如何产生的。
2.4 生成式模型的缺点是什么?
但是生成式模型需要非常充足的数据量以保证采样到了数据本来的面目,所以速度相比之下较慢。
【关于 归一化】那些你不知道的事
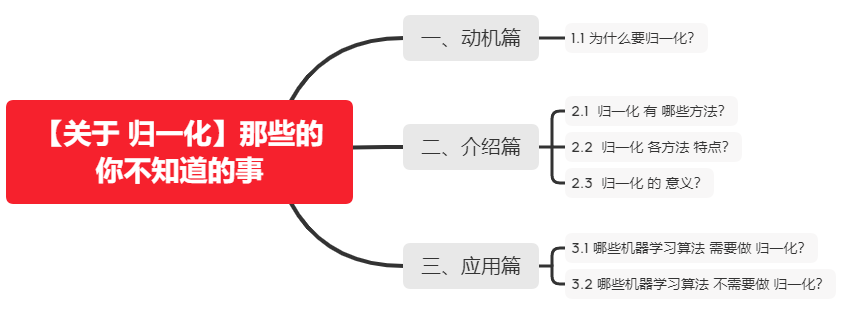
一、动机篇
1.1 为什么要归一化?
因为 每一列 数据的量纲不同,导致 数据分布区间存在差异。(人的身高可以是 180cm,也可以是 1.8m,这两个虽然表示意义相同,但是由于单位的不同,导致 机器学习在计算过程中也容易出现差异,所以就需要对数据进行归一化)。
二、介绍篇
2.1 归一化 有 哪些方法?
•
线性比例变换法:
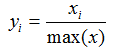
•
极差变换法:
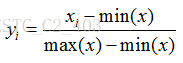
•
0 均值标准化(z-score 方法):
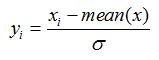
2.2 归一化 各方法 特点?
•
线性比例变换法 and 极差变换法
◦
特点:将原始数据线性化的方法转换到[0 1]的范围,该方法实现对原始数据的等比例缩放。通过利用变量取值的最大值和最小值(或者最大值)将原始数据转换为界于某一特定范围的数据,从而消除量纲和数量级影响,改变变量在分析中的权重来解决不同度量的问题。由于极值化方法在对变量无量纲化过程中仅仅与该变量的最大值和最小值这两个极端值有关,而与其他取值无关,这使得该方法在改变各变量权重时过分依赖两个极端取值。
•
0 均值标准化(z-score 方法)
◦
特点:即每一变量值与其平均值之差除以该变量的标准差。虽然该方法在无量纲化过程中利用了所有的数据信息,但是该方法在无量纲化后不仅使得转换后的各变量均值相同,且标准差也相同,即无量纲化的同时还消除了各变量在变异程度上的差异,从而转换后的各变量在聚类分析中的重要性程度是同等看待的。而实际分析中,经常根据各变量在不同单位间取值的差异程度大小来决定其在分析中的重要性程度,差异程度大的其分析权重也相对较大。
2.3 归一化 的 意义?
每个维度都是去量纲化的,避免了不同量纲的选取对距离计算产生的巨大影响。
三、应用篇
3.1 哪些机器学习算法 需要做 归一化?
•
机器学习算法算法:
◦
基于距离计算的模型:KNN;
◦
通过梯度下降法求解的模型:线性回归、逻辑回归、支持向量机、神经网络
3.2 哪些机器学习算法 不需要做 归一化?
•
机器学习算法算法:
◦
树形模型:决策树、随机森林(Random Forest)
•
为什么:
◦
原因1:因为它们不关心变量的值,而是关心变量的分布和变量之间的条件概率;
◦
原因2:因为数值缩放不影响分裂点位置,对树模型的结构不造成影响。按照特征值进行排序的,排序的顺序不变,那么所属的分支以及分裂点就不会有不同。而且,树模型是不能进行梯度下降的,因为构建树模型(回归树)寻找最优点时是通过寻找最优分裂点完成的,因此树模型是阶跃的,阶跃点是不可导的,并且求导没意义,也就不需要归一化。
【关于 正则化】那些你不知道的事
一、L0,L1,L2正则化 篇
1.1 正则化 是什么?
我们所说的正则化,就是在原来的loss function的基础上,加上了一些正则化项或者称为模型复杂度惩罚项。
1.2 什么是 L0 正则化 ?
•
介绍:指向量中非零元素的个数,希望参数中大部分元素为0,希望参数是稀疏的;
•
公式:
•
直观理解:即将所有的非零项都作为1加起来,然后再用步长调节。意思很明显,每一个对预测产生了贡献的参数,我都惩罚一次,不多不少,大家都一样。
就像一个法官判决,你偷了一毛钱,他杀了一个人,法官均以“价值观不正确”为由,把你们判一样的罪……只有一点都没参与的人,才不会被判刑。
•
缺点:难以优化(存在NP难问题)
1.3 什么是 L1 (稀疏规则算子 Lasso regularization)正则化 ?
•
介绍:指向量中各元素绝对值之和,是 L0 正则项的最优凸近似;
•
公式:
∑j=1m|θj|
•
直观理解:即将所有的绝对值值相加。
拿法官举例子,就是,法官要按照你们的罪行量刑判罪,但是都得判,无论你影响最终是好是坏(比如你杀了个人,这个人也是个坏人,但是你还是犯了杀人罪得判刑)都按照罪行判罪。于是就都取个绝对值,表示都判,然后按照罪行大小判罪了……
•
优点:
•
参数稀疏 的 优点:
◦
特征选择:通过将无用特征所对应的权重设为0,以去除无用特征;
◦
可解释性:因为无用特征的权重对应权重都为0,所以只需要介绍权重不为 0 的特征;
1.4 什么是 L2 正则化(岭回归 Ridge Regression 或者 权重衰减 Weight Decay)正则化 ?
•
介绍:向量各元素的平方和然后求平方根,防止模型出现过拟合的问题
•
公式:
∑j=1mθj2
•
直观理解:所有项目的平方和相加最后开根
•
作用:防止过拟合问题
•
优点:
◦
防止过拟合,提升模型的泛化能力;
二、对比篇
2.1 什么是结构风险最小化?
在经验风险最小化的基础上(也就是训练误差最小化),尽可能采用简单的模型,以此提高泛化预测精度。
下面是一个图像解释(假设X为一个二维样本,那么要求解参数
w
也是二维):
•
原函数曲线等高线(同颜色曲线上,每一组
w1,w2
带入值都相同)
2.2 从结构风险最小化的角度理解L1和L2正则化
•
L1和L2加入后的函数图像:
从上面两幅图中我们可以看出:
•
如果不加L1和L2正则化的时候,对于线性回归这种目标函数凸函数的话,我们最终的结果就是最里边的紫色的小圈圈等高线上的点。
•
当加入L1正则化的时候,我们先画出以下函数的图像:
该图像也就是一个菱形,代表这些曲线上的点算出来的1范数 |ω1|+|ω2| 都为F,那我们现在的目标是不仅是原曲线算得值要小(越来越接近中心的紫色圈圈),还要使得这个菱形越小越好(F越小越好)。那么还和原来一样的话,过中心紫色圈圈的那个菱形明显很大,因此我们要取到一个恰好的值。那么如何求值呢?
以同一条原曲线目标等高线来说,现在以最外圈的红色等高线为例,我们看到,对于红色曲线上的每个点都可以做一个菱形,根据上图可知,当这个菱形与某条等高线相切(仅有一个交点)的时候,这个菱形最小。用公式说这个时候能使得在相同的下,由于相切的时候的$C|\omega|{1}\left|\omega{1}\right|+\left|\omega_{2}\right|$小,所以:能够使得更小。
有了上述说明,我们可以看出,最终加入L1范数得到的解,一定是某个菱形和某条原函数等高线的切点。现在有个比较重要的结论来了,我们经过观察可以看到,几乎对于很多原函数等高曲线,和某个菱形相交的时候及其容易相交在坐标轴(比如上图),也就是说最终的结果,解的某些维度及其容易是0,比如上图最终解是这也就是我们所说的L1更容易得到稀疏解(解向量中0比较多)的原因。
当然了,光看着图说,L1的菱形更容易和等高线相交在坐标轴,一点都没说服力,只是个感性的认识,不过不要紧,其实是很严谨的,我们直接用求导来证明,具体的证明这里有一个很好的答案了,简而言之就是假设现在我们是一维的情况下
•
•
其中是目标函数,是没加L1正则化的目标函数,是L1正则项,那么要使得0点成为最值的可能得点,,虽然在0点不可导,但是我们只需要让0点左右的导数异号,即
•
•
也就是的情况下,0点都是可能得最值点。
•
当加入L2正则化的时候,分析和L1正则化是类似的,也就是说我们仅仅是从菱形变成了圆形而已,同样还是求原曲线和圆形的切点作为最终解。当然与L1范数比,我们这样求的L2范数的从图上来看,不容易交在坐标轴上,但是仍然比较靠近坐标轴。因此这也就是我们老说的,L2范数能让解比较小(靠近0),但是比较平滑(不等于0)。
综上所述,我们可以看见,加入正则化项,在最小化经验误差的情况下,可以让我们选择解更简单(趋向于0)的解。
2.3 L1 vs L2
三、dropout 篇
3.1 什么是 dropout?
•
方式:通过以概率p主动临时性地忽略掉神经网站中的部分隐藏节点来防止过拟合,即让这些神经元以一定概率不工作;
3.2 dropout 在训练和测试过程中如何操作?
•
训练过程:在训练开始时,随机删除一些隐藏层神经元,即认为这些神经元不存在,同时保持输入层与输出层的神经元个数不变,按照反向传播学习算法对神经网络中的参数进行学习更新(被删除的节点不参与更新)。在这个“残缺”的网络中,让神经网络学习数据中的局部特征(即部分分布式特征)。在多个“残缺”之网(相当于多个简单网络)中实施特征,总要比仅在单个健全网络上进行特征学习,其泛化能力来得更加健壮。这里的“泛化”,实际上就是适应各种情况的能力。如果神经网络仅仅在训练集合上表现好(好比“窝里横”),而在应对其他新情况表现不佳,就表明陷入“过拟合”状态,其实就是泛化能力差。
•
在测试阶段,将参与学习的节点和那些被隐藏的节点以一定的概率p加权求和,综合计算得到网络的输出。对于这样的“分分合合”的学习过程,有学者认为,“丢弃学习”可视为一种集成学习(Ensemble Learning)。
3.3 dropout 如何防止过拟合?
先回到正常的模型(没有dropout),我们用相同的训练数据去训练5个不同的神经网络,一般会得到5个不同的结果,此时我们可以采用 “5个结果取均值”或者“多数取胜的投票策略”去决定最终结果。(例如 3个网络判断结果为数字9,那么很有可能真正的结果就是数字9,其它两个网络给出了错误结果)。这种“综合起来取平均”的策略通常可以有效防止过拟合问题。因为不同的网络可能产生不同的过拟合,取平均则有可能让一些“相反的”拟合互相抵消。dropout掉不同的隐藏神经元就类似在训练不同的网络(随机删掉一半隐藏神经元导致网络结构已经不同),整个dropout过程就相当于 对很多个不同的神经网络取平均。而不同的网络产生不同的过拟合,一些互为“反向”的拟合相互抵消就可以达到整体上减少过拟合。
dropout减少神经元之间复杂的共适应关系:因为dropout程序导致两个神经元不一定每次都在一个dropout网络中出现。(这样权值的更新不再依赖于有固定关系的隐含节点的共同作用,阻止了某些特征仅仅在其它特定特征下才有效果的情况)。迫使网络去学习更加鲁棒的特征 (这些特征在其它的神经元的随机子集中也存在)。换句话说假如我们的神经网络是在做出某种预测,它不应该对一些特定的线索片段太过敏感,即使丢失特定的线索,它也应该可以从众多其它线索中学习一些共同的模式,提升模型鲁棒性,从这个角度看 dropout就有点像L1,L2正则,减少权重使得网络对丢失特定神经元连接的鲁棒性提高)
【关于 激活函数】那些你不知道的事
一、动机篇
1.1 为什么要有激活函数?
数据角度:由于数据是线性不可分的,如果采用线性化,那么需要复杂的线性组合去逼近问题,因此需要非线性变换对数据分布进行重新映射;
线性模型的表达力问题:由于线性模型的表达能力不够,引入激活函数添加非线性因素
二、激活函数介绍篇
2.1 sigmoid 函数篇
2.1.1 什么是 sigmoid 函数?
•
公式
•
图像
2.1.2 为什么选 sigmoid 函数 作为激活函数?
sigmoid 函数 能够把输入的连续实值变换为0和1之间的输出,特别的,如果是非常大的负数,那么输出就是0;如果是非常大的正数,输出就是1.
2.1.3 sigmoid 函数 有什么缺点?
在深度神经网络中梯度反向传递时导致梯度爆炸和梯度消失,其中梯度爆炸发生的概率非常小,而梯度消失发生的概率比较大;
output 不是0均值(即zero-centered);
a.
后果:会导致后一层的神经元将得到上一层输出的非0均值的信号作为输入。 产生的一个结果就是:x>0, f=wTx+b那么对w求局部梯度则都为正,这样在反向传播的过程中w要么都往正方向更新,要么都往负方向更新,导致有一种捆绑的效果;
幂函数耗时;
2.2 tanh 函数篇
2.2.1 什么是 tanh 函数?
•
公式:
•
图像
2.2.2 为什么选 tanh 函数 作为激活函数?
tanh 函数 能够 解决 sigmoid 函数 非 0 均值 问题
2.2.3 tanh 函数 有什么缺点?
梯度爆炸和梯度消失;
幂函数耗时;
2.3 relu 函数篇
2.3.1 什么是 relu 函数?
•
公式
f(x)=max(0,x)
•
图像
2.3.2 为什么选 relu 函数 作为激活函数?
解决了gradient vanishing问题 (在正区间)
计算速度非常快,只需要判断输入是否大于0
收敛速度远快于sigmoid和tanh
2.3.3 relu 函数 有什么缺点?
ReLU的输出不是zero-centered;
Dead ReLU Problem,指的是某些神经元可能永远不会被激活,导致相应的参数永远不能被更新;
三、激活函数选择篇
深度学习往往需要大量时间来处理大量数据,模型的收敛速度是尤为重要的。所以,总体上来讲,训练深度学习网络尽量使用zero-centered数据 (可以经过数据预处理实现) 和zero-centered输出。所以要尽量选择输出具有zero-centered特点的激活函数以加快模型的收敛速度;
如果使用 ReLU,那么一定要小心设置 learning rate,而且要注意不要让网络出现很多 “dead” 神经元,如果这个问题不好解决,那么可以试试 Leaky ReLU、PReLU 或者 Maxout;
最好不要用 sigmoid,你可以试试 tanh,不过可以预期它的效果会比不上 ReLU 和 Maxout.
【关于 过拟合和欠拟合】那些你不知道的事
一、过拟合和欠拟合 是什么?
欠拟合和过拟合属于对立情况,都是导致模型泛化能力不高的两种常见原因,均是模型学习能力和数据复杂性失调的表现
二、过拟合/高方差(overfiting / high variance)篇
2.1 过拟合是什么及检验方法?
•
问题表现:高方差
◦
当训练集和测试集的误差之间有大的差距时,为高方差;
◦
当方差很高,训练集和验证集的准确率相差太多,应该是过拟合;
◦
表现为训练效果好,但是测试效果差,即模型的泛化能力差。可以通过观察模型在训练集和测试集上的损失函数值随着epoch的变化,如果是过拟合,模型在测试集上的损失函数值一般是先下降后上升。
2.2 导致过拟合的原因是什么?
训练数据太少,样本单一。如果训练样本只有负样本,然后拿生成的模型去预测正样本,这肯定预测不准。所以训练样本要尽可能的全面,覆盖所有的数据类型;
存在噪声。噪声指训练数据中的干扰数据。过多的干扰会导致记录了很多噪声特征,忽略了真实输入和输出之间的关系;
模型过于复杂。模型太复杂,已经能够死记硬背记录下了训练数据的信息,但是遇到没有见过的数据的时候不能够变通,泛化能力太差。我们希望模型对不同的数据都有稳定的输出。模型太复杂是过拟合的重要因素。
2.3 过拟合的解决方法是什么?
增加样本,要覆盖全部的数据类型。数据经过清洗之后再进行模型训练,防止噪声数据干扰模型;
降低模型复杂度。在训练和建立模型的时候,从相对简单的模型开始,不要一开始就把特征做的非常多,模型参数挑的非常复杂;
正则化。在模型算法中添加惩罚函数来防止过拟合。常见的有L1,L2正则化。而且 L1正则还可以自动进行特征选择;
集成学习方法bagging(如随机森林)能有效防止过拟合;
减少特征个数(不是太推荐,但也是一种方法)。可以使用特征选择,减少特征数或使用较少的特征组合,对于按区间离散化的特征,增大划分的区间;
交叉检验,通过交叉检验得到较优的模型参数;
早停策略。本质上是交叉验证策略,选择合适的训练次数,避免训练的网络过度拟合训练数据;
DropOut策略。核心思想就是bagging,可以看作是低成本的集成学习。所谓的Dropout指的是在用前向传播算法和反向传播算法训练DNN模型时,一批数据迭代时,随机的从全连接DNN网络中去掉一部分隐藏层的神经元。 在对训练集中的一批数据进行训练时,我们随机去掉一部分隐藏层的神经元,并用去掉隐藏层的神经元的网络来拟合我们的一批训练数据。使用基于dropout的正则化比基于bagging的正则化简单,这显而易见,当然天下没有免费的午餐,由于dropout会将原始数据分批迭代,因此原始数据集最好较大,否则模型可能会欠拟合。
三、欠拟合/高偏差(underfiting / high bias)篇
3.1 欠拟合是什么及检验方法?
•
问题表现:高偏差
3.2 导致欠拟合的原因是什么?
•
原因:模型没有很好的捕捉数据特征,不能很好地拟合数据
3.3 过拟合的解决方法是什么?
做特征工程,添加更多的特征项,比如特征组合、高次特征,来增大假设空间。如果欠拟合是由于特征项不够,没有足够的信息支持模型做判断;
集成学习方法boosting(如GBDT)能有效解决high bias;
增加模型复杂度。如果模型太简单,不能够应对复杂的任务。可以使用更复杂的模型。比如说可以使用SVM的核函数,增加了模型复杂度,把低维不可分的数据映射到高维空间,就可以线性可分,减小欠拟合;
减小正则化系数。