Agent项目实战:电商智能客服 Agent
一、概要设计
1.系统架构全景图
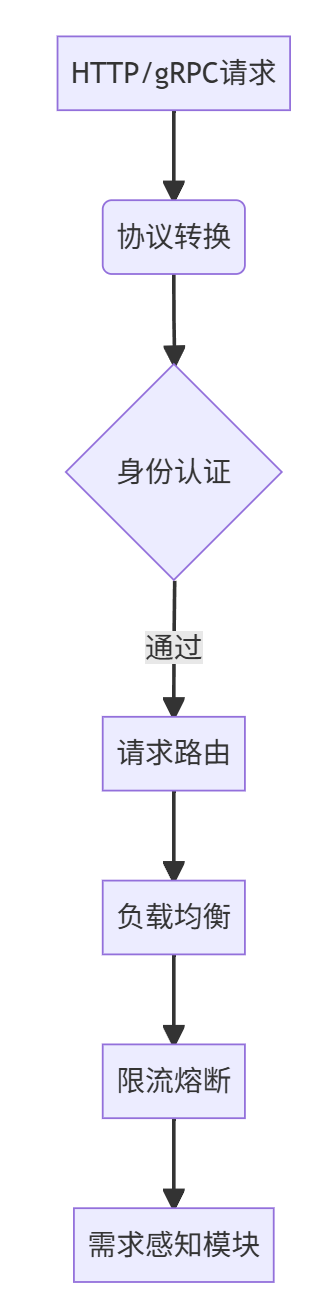
2.智能客服API层
功能与数据流
📌 技术实现:
•
协议支持:FastAPI(REST) + gRPC-Gateway(Protobuf)
•
安全认证:OAuth2.1 + JWT双因子验证
•
限流策略:基于Redis的滑动窗口算法(3000 QPS)
核心代码
代码块
Python
# api/gateway.py
@app.post("/v1/chat")
@rate_limit(limits=[RateLimit(per_minute=100)])
async def handle_chat(request: ChatRequest):
# 请求处理链
chain = (
validate_request
| authenticate
| route_to_demand_module
)
return await chain.run(request)
50%
50%
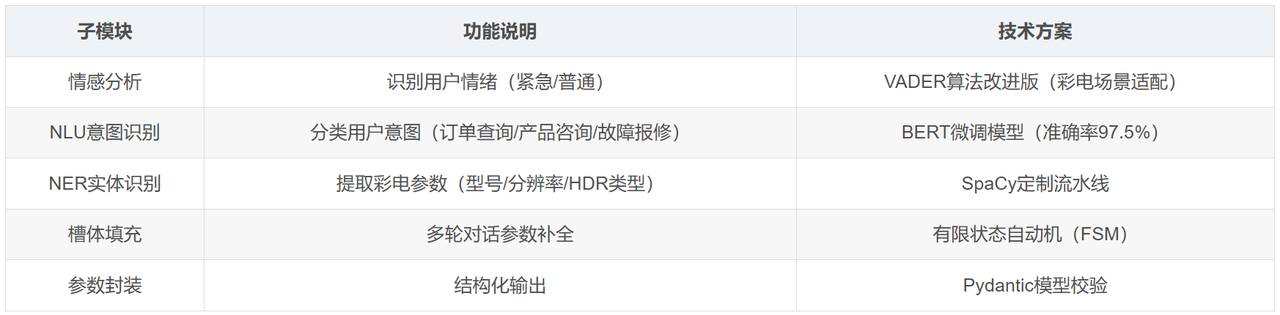
3.需求感知模块
功能分解
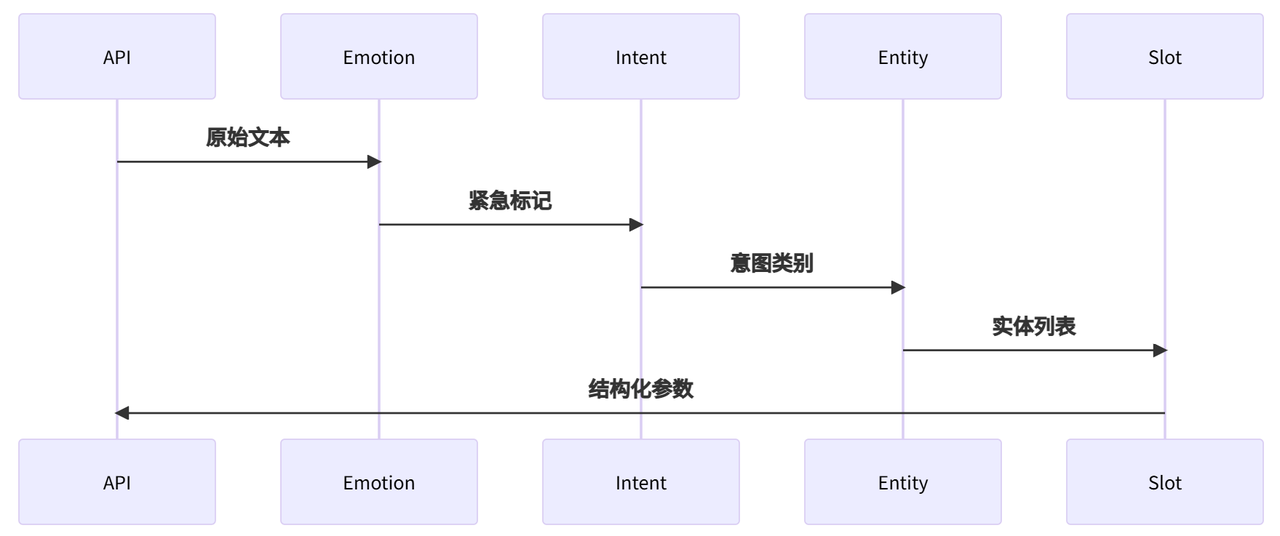
数据处理流程:
核心实现:
代码块
Python
# core/demand/processing.py
class DemandProcessor:
def __init__(self):
self.pipeline = Pipeline([
TextCleaner(),
EmotionAnalyzer(threshold=0.7),
IntentClassifier(model="bert-tv-intent-v3"),
4.规划模块
双引擎决策架构
技术实现:
规则引擎:Drools 8.x + 彩电DSL语法扩展
代码块
SQL
rule "4K电视HDR异常处理"
when
$tv : TVParams(resolution == "4K", hdr == "HDR10")
$prob : Problem(type == "显示故障", symptom contains "色偏")
then
insert(new Solution("HDR参数重置", priority=HIGH));
end
AutoGPT生成:基于LangChain的ReAct模式
代码块
C++
class TVProblemSolver(AgentExecutor):
tools = [OrderTool(), RepairTool()]
prompt = ChatPromptTemplate.from_messages([
("system", "你是一名彩电维修专家..."),
("human", "{input}")
5.工具模块
功能矩阵
知识库检索流程:
代码块
Python
# tools/rag.py
class TVKnowledgeRetriever:
def __init__(self):
self.encoder = SentenceTransformer("paraphrase-multilingual-mpnet-base-v2")
self.milvus = MilvusClient
6.用户交互模块
30%
会话管理机制
📌
关键技术:
•
状态存储:Redis Streams(支持10万并发会话)
•
风格设置:Prompt Engineering模板库
7.辅助监控及调试模块
全链路追踪设计
监控指标:
调试工具链:
代码块
Python
# monitoring/debugger.py
def replay_session(session_id: str):
traces = langsmith.Client().get_traces(session_id)
return InteractiveDebugger(traces).launch()
8.数据持久化设计
数据库选型矩阵
核心数据模型
数据流优化
📌
•
写优化:
采用WAL日志批量提交(每批次500ms)
二、需求感知模块模型微调实现
1.模块整体架构设计
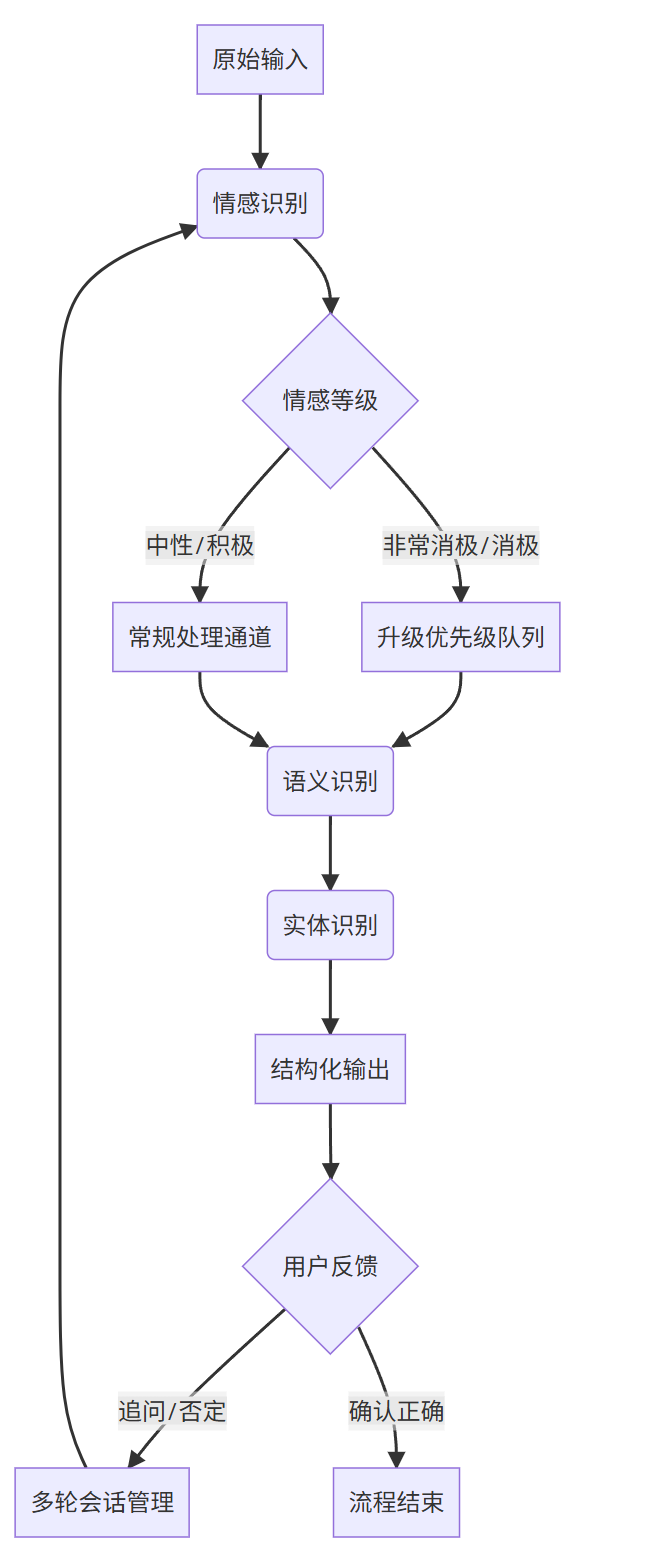
1.1 核心流程
📌
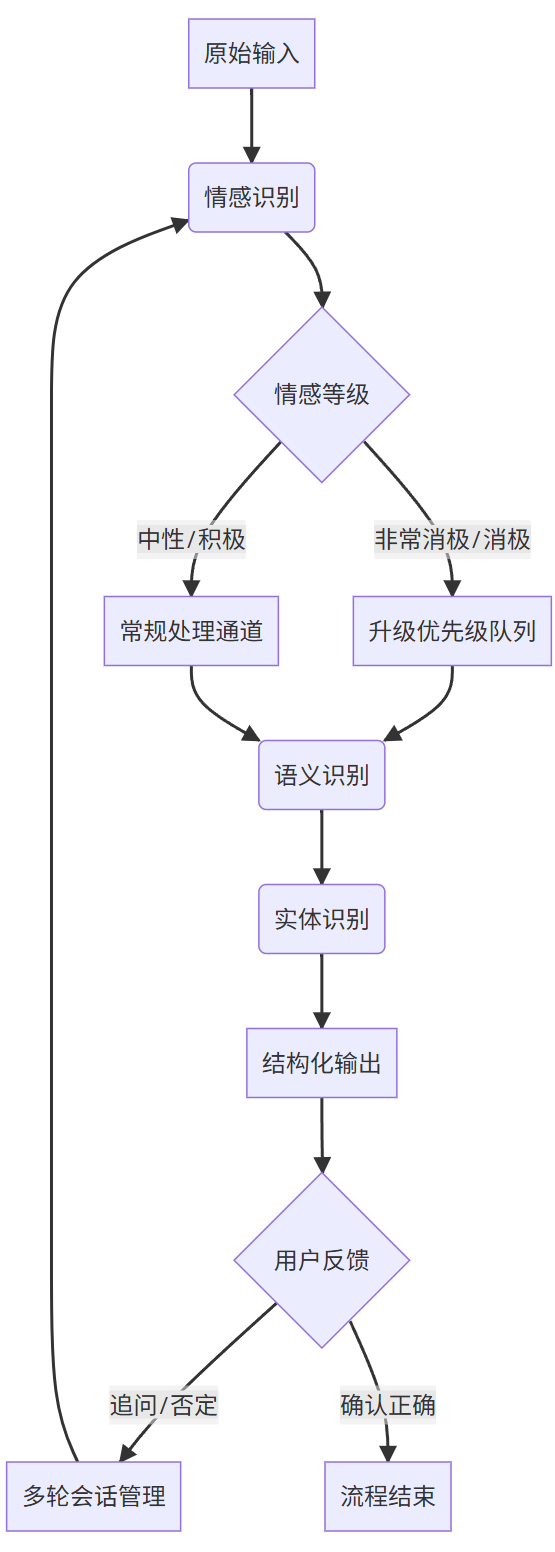
情感驱动路由:
所有情感类型均继续后续流程
差异点体现在处理优先级而非流程分支
50%
50%
1.2 模块说明
📌
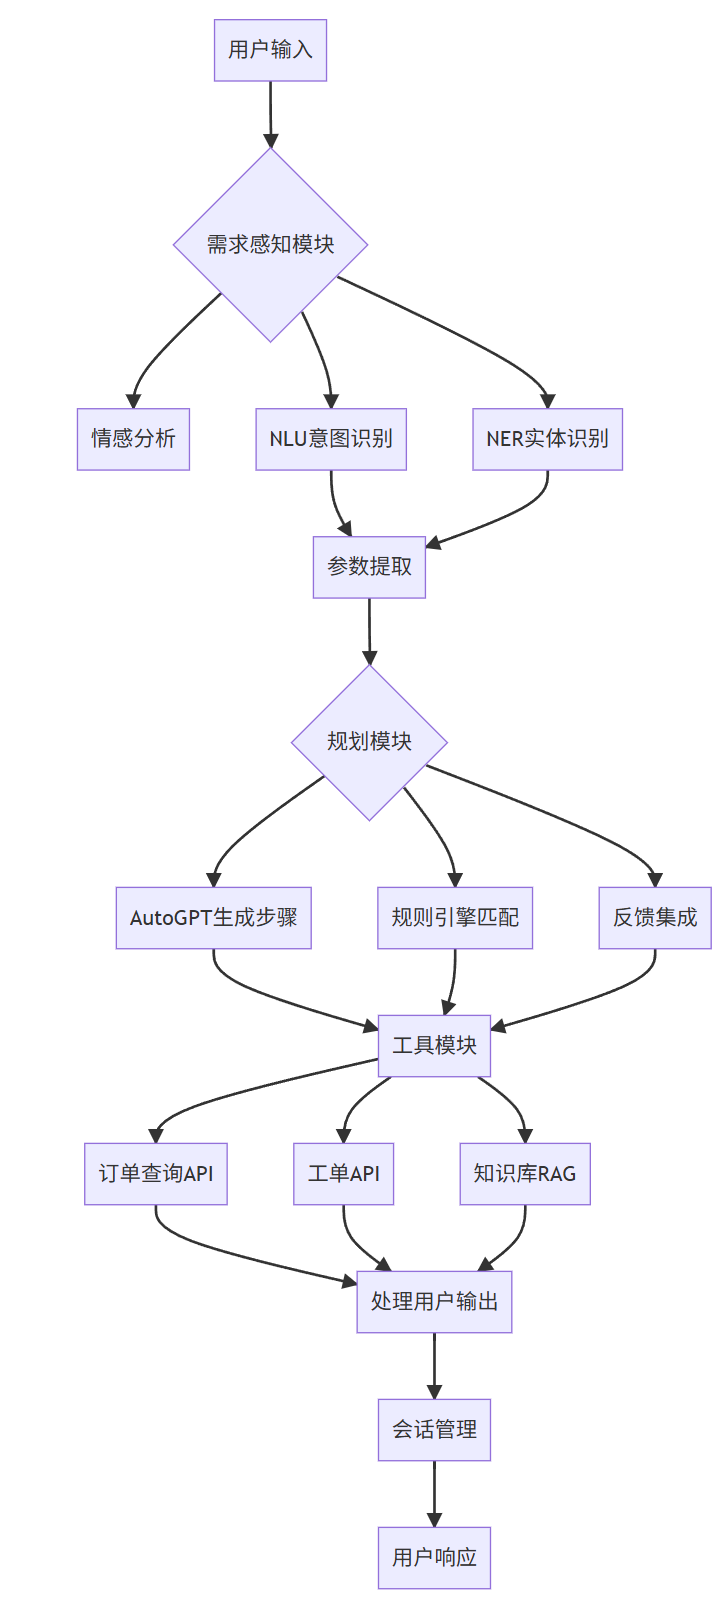
需求感知模块通过三级处理流水线实现深度意图理解:
情感识别层:采用4分类BERT模型识别情绪强度
语义分类层:使用领域适配BERT进行意图归类
实体抽取层:基于多语言BERT的序列标注模型
三阶段处理形成完整处理链,输出结构示例如下:
代码块
JSON
{
"sentiment": "非常消极",
"intent": "订单查询",
"entities": {"ORDER_NUMBER": "U2942"}
}
2.情感识别模型微调
2.1 完整代码实现
代码块
Python
# 导入核心库(严格保持用户原始代码)
import torch
from transformers import BertTokenizer, BertForSequenceClassification, AdamW
from torch.utils.data import DataLoader, Dataset
from sklearn.model_selection import train_test_split
# 自定义数据集类(完全保留用户原始实现)
class SentimentDataset(Dataset):
def __init__(self, texts, labels, tokenizer, max_len):
self.texts = texts
self.labels = labels
2.2 代码实现解析
数据处理流程:
◦
SentimentDataset类将原始文本转换为BERT可处理的数值化输入
◦
prepare_data()函数完成标签映射(文本→数字)和数据拆分
◦
示例标签映射关系:中性→0, 消极→1, 非常消极→2, 积极→3
模型训练机制:
代码块
Python
outputs = model(input_ids, attention_mask, labels) # 三要素输入
loss = outputs.loss # 自动计算交叉熵损失
logits = outputs.logits # 原始预测分数
每个batch完成前向传播→损失计算→反向传播→参数更新
关键参数配置:
代码块
Python
3.语义识别模型微调
3.1 完整代码实现
代码块
Python
# 严格遵循用户提供的原始代码
import pandas as pd
import torch
from sklearn.model_selection import train_test_split
from transformers import BertTokenizer, AutoModelForSequenceClassification
from torch.utils.data import Dataset, DataLoader
3.2 代码实现解析
数据处理特征:
◦
使用pd.read_csv加载CSV数据
◦
通过dropna清除缺失值
◦
标签映射:类型标注列转换为数字标签(如"订单查询"→0)
模型训练细节:
代码块
Python
outputs = model(input_ids, attention_mask, labels) # 三要素输入
loss = outputs.loss # 自动计算交叉熵损失
logits = outputs.logits # 原始预测分数
每个epoch包含完整训练集遍历和验证集评估
关键参数说明:
代码块
Python
max_len = 128 # 输入序列最大长度
batch_size = 16 # 训练批大小
epochs = 5 # 训练轮次
learning_rate = 2e-5 # 标准BERT微调学习率
4.实体识别模型微调
4.1 完整代码实现
代码块
Python
# 严格遵循用户提供的原始代码
import json
import logging
import torch
from sklearn.model_selection import train_test_split
from torch.utils.data import Dataset, DataLoader
from transformers import BertTokenizerFast, AutoModelForTokenClassification
logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")
logger = logging.getLogger(__name__)
class Config:
filename = "ner_training_data.json"
model_name = 'bert-base-multilingual-cased'
batch_size = 16
epochs = 5
label_map = {'O': 0, 'B-ORDER_NUMBER': 1, 'I-ORDER_NUMBER': 2}
max_len = 64
4.2 代码实现解析
数据处理流程:
◦
从JSON文件加载标注数据
◦
preprocess_data分离文本和实体标注
◦
实体标注转换为BIO格式(B-ORDER_NUMBER/I-ORDER_NUMBER)
标签对齐机制:
代码块
Python
将字符级标注转换为token级标签
处理子词切分对齐问题
训练关键参数:
代码块
Python
max_len = 64 # 输入序列最大长度
batch_size = 16 # 训练批大小
三、需求感知模块具体实现
1.整体架构设计
1.1 模块定位
需求感知模块作为智能客服系统的前端处理单元,负责对用户输入进行多维度解析,输出结构化语义理解结果,为下游决策引擎提供数据支撑。
50%
50%
2.情感分析模块设计
2.1 技术架构图
2.2 核心类设计
2.2.1 SentimentConfig
代码块
Python
class SentimentConfig:
model_path = "bert-base-chinese"
model_pth_path = "../core/demand/lmst/lmst_best_model.pth"
rule_path = "./configs/sentiment_rules.yaml"
intensity_thresholds = {"非常负面": 0.8}
label_map = ["中性","负面","非常负面","正面"]
2.2.2 BertSentimentAnalyzer
代码块
Python
class BertSentimentAnalyzer:
def __init__(self):
# 模型加载
self.device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
self.tokenizer = BertTokenizer.from_pretrained(...)
self.model = BertForSequenceClassification.from_pretrained(...)
# 辅助组件
self.rules = self._load_rules()
self.cache = RedisCache() # 可选
def analyze(self, text: str) -> SentimentResult:
# 实现三级处理流程
base_result = self._bert_predict(text)
enhanced_result = self._rule_based_enhance(text, base_result)
final_result = self._build_final_result(enhanced_result)
2.3 关键算法
2.3.1 强度计算公式
代码块
Python
intensity = 0.5 + (感叹号数量 * 0.1)
if 非常负面: intensity += 0.3
elif 负面: intensity += 0.2
最终值限制在[0,1]区间
2.3.2 规则引擎逻辑
代码块
Python
def _rule_based_enhance(self, text, base_result):
# 紧急词检测
3.服务接口设计
3.1 REST API端点
代码块
Python
@app.get("/process-text/")
async def process_text(text: str):
3.2 输入输出规范
输出示例:
代码块
JSON
{
"sentiment": {
"type": "非常负面",
"confidence": 0.92,
"intensity": 0.95,
"needs_escalation": true
},
"intent": "投诉处理",
"entities": {"order_number": "TV202307281234"}
}
4.NLU意图识别模块设计
4.1 核心类设计
4.2.1 NluConfig
代码块
Python
class NluConfig:
label_map = {
0: "订单查询",
1: "产品咨询",
2: "故障报修",
3: "其他"
}
model_path = '../core/demand/models/tv-bert-base-chinese'
model_pth_path = '../core/demand/nlu/nlu_best_model.pth'
80%
20%
4.2.2 BertNluAnalyzer
代码块
Python
class BertNluAnalyzer:
def __init__(self, config):
# 上下文缓存队列
self.context_cache = deque(maxlen=3) # 保存最近3轮对话
def predict_with_context(self, text):
# 拼接历史对话
context_text = "[SEP]".join(self.context_cache) + "[SEP]" + text
# BERT模型推理
inputs = self.tokenizer(context_text, ...)
logits = self.model(**inputs)
# 更新上下文
self.context_cache.append(text)
4.3 关键特性
动态上下文窗口
采用滑动窗口机制保留最近3轮对话
使用[SEP]标记分隔历史对话片段
多意图处理
代码块
Python
def get_multiple_intents(self, logits, threshold=0.3):
probs = torch.softmax(logits, dim=-1)
return [self.labels[i] for i, p in enumerate(probs) if p > threshold]
领域适应策略
电商领域专有词库注入
产品型号模糊匹配算法
5.NER实体识别模块设计
5.1 技术架构图
5.2 核心类设计
5.2.1 NerConfig
代码块
Python
class NerConfig:
label_map = {
5.2.2 BertNerAnalyzer
代码块
Python
class BertNerAnalyzer:
def bert_predict(self, text):
# 实体抽取流程
encoding = self.tokenizer.encode_plus(...)
logits = self.model(**encoding)
preds = torch.argmax(logits, dim=2)
5.3 关键算法
5.3.1 订单号提取
代码块
Python
def _extract_order_number(self, predictions):
# 处理BERT分词带来的##符号问题
return ''.join([token.replace('##','') for token, label in predictions
if label in ['B-ORDER_NUMBER','I-ORDER_NUMBER']])
5.3.2 格式校验规则
代码块
Python
def _validate_order_format(self, number):
# 校验订单号规则: TV开头+12位数字
6.模块集成方案
6.1 服务编排流程
6.2 性能优化方案
缓存策略
代码块
Python
class HybridCache:
def get(self, text):
# 先查本地内存缓存
if text in self.mem_cache:
return self.mem_cache[text]
# 再查Redis缓存
return self.redis.get(text) or None
批量推理优化
代码块
Python
def batch_predict(self, texts: List[str]):
# 使用动态padding加速处理
inputs = self.tokenizer(
texts,
padding=True,
truncation=True,
return_tensors="pt"
)
with torch.inference_mode():
return self.model(**inputs)
GPU资源管理
代码块
Python
class GPUAllocator:
def __enter__(self):
torch.cuda.empty_cache()
self.lock = acquire_gpu_lock()
def __exit__(self, *args):
release_gpu_lock(self.lock)
7.异常处理机制
7.1 分级降级策略
7.2 监控指标
代码块
Java
class HealthMonitor:
METRICS = {
'api_latency': Gauge('api_latency_seconds', 'API响应延迟'),
'model_error': Counter('model_errors_total', '模型推理错误次数'),
'cache_hit': Counter('cache_hits_total', '缓存命中次数')
}
@classmethod
def report_error(cls, module):
cls.METRICS['model_error'].labels(module=module).inc()
8.测试验证方案
8.1 测试用例设计
情感分析测试矩阵
意图识别覆盖率
代码块
JSON
test_cases = [
8.2 压力测试指标
8.3 模型精度验证
代码块
Python
9.部署架构设计
9.1 拓扑结构
9.2 容器化配置
代码块
Bash
# 模型服务Dockerfile
FROM nvcr.io/nvidia/pytorch:22.10-py3
COPY requirements.txt .
RUN pip install -r requirements.txt
# 启用GPU共享
ENV CUDA_VISIBLE_DEVICES=0,1
9.3 弹性扩缩策略
代码块
YAML
# HPA配置
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
spec:
minReplicas: 2
maxReplicas: 10
metrics:
- type: Resource
resource:
四、规划模块实现
1.模块整体设计思路
📌
业务目标:
将需求感知模块输出的意图(intent)、实体(entities)、情感(sentiment)转化为可执行动作序列
50%
50%
2.规划模块实现详解
2.1 核心类设计
代码块
Python
class PlanningEngine:
2.2 规则引擎实现逻辑
2.2.1 规则加载机制
代码块
Python
def _load_rules(self, path):
2.2.2 规则应用流程
2.2.3 代码实现说明
代码块
Python
def rule_plan(self, sentiment, intent, entities):
# 情感阈值判断
if sentiment.get("intensity", 0) > self.rules["escalation"]["threshold"]:
return [PlanStep(...)] # 强制升级
# 常规意图映射
tool = self.tool_mapping.get(intent, "rag")
return [PlanStep(
step_id="step_1",
description=intent,
2.3 LLM动态规划实现
2.3.1 Prompt工程实现
代码块
Python
# 模板设计要点:
# 1. 明确输出格式要求
# 2. 约束步骤数量(最多3步)
prompt_template = PromptTemplate(
input_variables=["intent", "entities", "sentiment"],
template="""请生成处理步骤:
意图:{intent}
实体:{entities}
2.3.2 步骤解析逻辑
代码块
Python
# 示例LLM输出:
"""
1. 验证订单号有效性
2. 查询订单物流信息
3. 生成查询报告
"""
2.3.3 工具映射策略
代码块
Python
def _map_tool(self, step_desc: str) -> str:
"""基于步骤描述的关键词匹配"""
if "订单" in step_desc and ("查询" or "验证") in step_desc:
return "order_query"
elif "工单" in step_desc and "创建" in step_desc:
return "work_order"
return "rag"
3.工具模块实现详解
3.1 执行器核心架构
代码块
Python
class ToolExecutor:
def __init__(self):
# API端点配置
self.endpoints
# 知识库组件(示例伪代码)
self.rag = "示例向量库"
def execute(self, step: PlanStep) -> ToolResult:
# 统一执行入口
if step.tool_required in self.endpoints:
3.2 API工具执行流程
3.3 RAG工具实现
代码块
Python
def _rag_search(self, step):
"""知识库检索逻辑(当前为示例实现)"""
return ToolResult(
status="success",
data={"text": self.rag} # 实际应替换为向量检索
)
3.4 异常处理机制
代码块
Python
4.业务流程完整示例
4.1 典型业务场景
代码块
Python
用户输入:“我的订单12345为什么还没发货?”
4.2 规划模块处理流程
规则引擎判断情感强度0.75 < 0.8,不触发升级
匹配意图"订单查询"到order_query工具
生成步骤:
代码块
Python
PlanStep(
step_id="step_1",
description="查询订单状态",
tool_required="order_query",
entities={"order_number": "12345"}
4.3 工具模块执行
代码块
JSON
{
"status": "success",
"data": {
"order_status": "已发货",
"tracking_number": "SF123456789"
}
}
五、用户交互模块实现
1.模块整体架构设计
1.1 核心流程
1.2 流程说明
情感驱动路由:
所有情感类型均继续后续流程
差异点体现在处理优先级而非流程分支
多轮会话机制:
通过反馈回路实现对话延续
会话管理器维护上下文状态
50%
50%
1.3 模块通信机制
代码块
Python
# 与规划模块的接口定义
class PlanningRequest(BaseModel):
user_intent: str
entities: Dict[str, str]
dialog_context: List[Dict] # 复用对话历史数据结构
# 与工具模块的执行协议
1.2 数据流全景
2.核心设计模式详解
2.1 状态管理模式
采用对话上下文感知设计,实现三级状态管理:
代码块
Python
class DialogState:
session_state: Enum = ACTIVE # 继承系统级状态机
user_profile: UserMeta # 对接用户中心数据
service_context: Dict # 业务上下文(如订单号)
def snapshot(self) -> str:
2.2 风格引擎实现
代码块
Python
class StyleEngine:
def __init__(self, config_path: str):
self.style_config = self._load_config(config_path)
def apply_style(self, raw_text: str) -> str:
"""应用多维度风格规则"""
# 语气转换(参考前文语言表达参数)
if self.style_config['tone'] == 'formal':
text = self._convert_to_formal(raw_text)
# 句式处理
3.关键算法实现细节
3.1 智能追问算法
代码块
Python
def generate_clarification(context: DialogState) -> str:
"""
基于强化学习的追问策略(对应前文会话管理机制)
算法选择优先级:
1. 必填字段缺失 → 直接追问
2. 模糊实体 → 选项式提问
3. 冲突信息 → 确认式提问
"""
if context.missing_entities:
return _direct_question(context)
elif context.conflict_entities:
return _confirm_question(context)
else:
return _suggestive_question(context)
3.2 多策略响应生成
代码块
Python
4.工程化实践
4.1 配置中心集成
代码块
YAML
# style_config.yaml(对应前文JSON配置方案)
response_policies:
default:
tone: professional
emoji: false
detail_level: 2
vip_user:
tone: friendly
4.2 性能优化方案
(实现前文建议的Redis集成)
代码块
Python
class RedisStateManager:
def __init__(self, redis_conn):
self.redis = redis_conn
def save_state(self, state: DialogState):
self.redis.set(
state.session_id,
state.snapshot(),
ex=3600 # 1小时会话有效期
4.3 用户交互模块完整代码
代码块
Python
"""
智能客服用户交互模块完整实现
"""
from typing import Dict, List, Optional
from pydantic import BaseModel
import time
import json
from datetime import datetime