第六节 ReAct 框架详解:让大模型学会思考与行动
什么是 ReAct 框架?
ReAct (代表 Reasoning and Acting,推理与行动) 是由普林斯顿大学和谷歌研究人员在 2022 年的一篇开创性论文中提出的概念。
在 ReAct 出现之前,大语言模型 (LLM) 通常以两种孤立的方式使用:
纯推理 (Reasoning-only):提示模型逐步思考(思维链),仅依靠其内部预训练的权重来解决数学或逻辑难题。
纯行动 (Acting-only):提示模型输出一个命令或 API 调用,但不要求它解释为什么选择该操作。
🦄
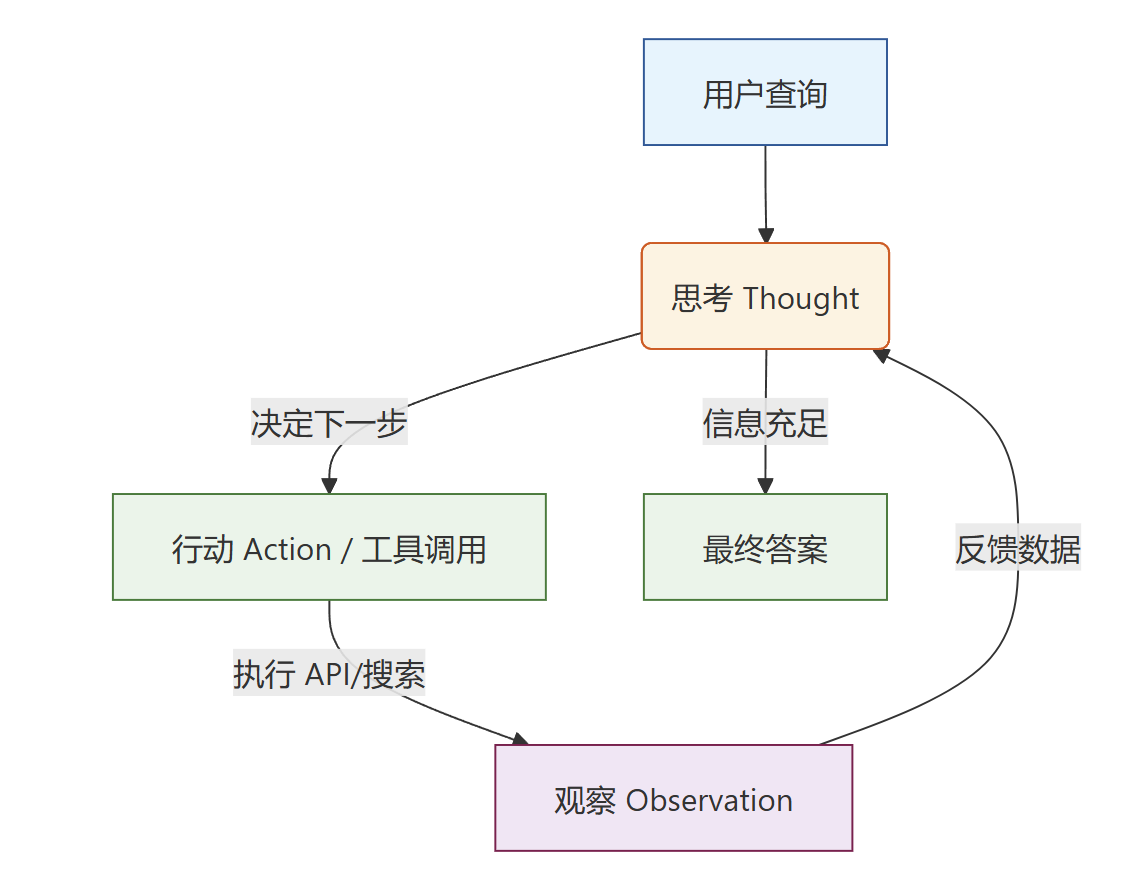
ReAct 将这两种范式结合了起来。它的核心思想是:推理可以帮助模型决定下一步该采取什么行动,而行动则允许模型收集信息,从而改善其未来的推理过程。
📝 术语链接:为了彻底理解 ReAct,建议先熟悉 思维链 (CoT) 以及 AI Agent (智能体) 的基本概念。
ReAct 是如何工作的:轨迹循环
ReAct 的核心是一个无限循环,直到模型确定它已经获得了最终答案才会停止。这个循环由三个不同的阶段组成:
思考 (Thought):LLM 分析当前问题的状态,并决定接下来需要什么信息。
行动 (Action):LLM 选择一个特定的工具(如 搜索、计算器、天气API),并提供必要的输入参数。
观察 (Observation):系统执行该工具,并将原始输出结果返回给 LLM。
随后,LLM 会基于这个 Observation 生成一个新的 Thought,循环往复。
一个真实的 ReAct 执行轨迹
用户查询:"现任美国总统和苹果公司 CEO 的年龄差是多少?"
•
思考 1:我需要查明现任美国总统是谁,以及苹果的 CEO 是谁。然后我需要他们的年龄。先从美国总统开始。
•
行动 1:搜索[现任美国总统 2026]
•
观察 1:[搜索结果: ...]
•
思考 2:好的,总统是 X,今年 Y 岁。现在我需要找苹果的 CEO。
•
行动 2:搜索[苹果 CEO 2026]
•
观察 2:[搜索结果: 蒂姆·库克...]
•
思考 3:蒂姆·库克是 CEO。我来查查他的年龄。
•
行动 3:搜索[蒂姆·库克 年龄]
•
观察 3:[搜索结果: 蒂姆·库克 65 岁...]
•
思考 4:总统 Y 岁,库克 65 岁。差值是 Y - 65。我需要计算一下。
•
行动 4:计算器[Y - 65]
•
观察 4:[结果: Z]
•
思考 5:我已经得出了最终答案。
•
最终答案:"他们的年龄差是 Z 岁。"
ReAct vs 思维链 (CoT)
#JLRbnpqxQqyM text { white-space: pre; }#JLRbnpqxQqyM .fb0 { stroke: var(--N900-FG, 0.15); }#JLRbnpqxQqyM .fb0 {stroke: rgba(31,35,41, 0.15)}#JLRbnpqxQqyM .fx0 { stroke-miterlimit: 10; }#JLRbnpqxQqyM .fx0 {stroke-miterlimit: 10}#JLRbnpqxQqyM .fa1 { fill: rgb(187, 191, 196); }#JLRbnpqxQqyM .fa1 {fill: rgb(187, 191, 196)}#JLRbnpqxQqyM .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#JLRbnpqxQqyM .fx1 {font-style: normal}#JLRbnpqxQqyM .fx2 { text-anchor: middle; }#JLRbnpqxQqyM .fx2 {text-anchor: middle}#JLRbnpqxQqyM .fx3 { dominant-baseline: central; }#JLRbnpqxQqyM .fx3 {dominant-baseline: central}#JLRbnpqxQqyM .fx4 { stroke: none; }#JLRbnpqxQqyM .fx4 {stroke: none}#JLRbnpqxQqyM .fc0 { fill: var(--text-caption); }#JLRbnpqxQqyM .fc0 {fill: #646a73}#JLRbnpqxQqyM .fa2 { fill: var(--text-link-disabled); }#JLRbnpqxQqyM .fa2 {fill: rgb(187, 191, 196)}#JLRbnpqxQqyM .fa3 { fill: rgb(246, 248, 250); }#JLRbnpqxQqyM .fa3 {fill: rgb(246, 248, 250)}#JLRbnpqxQqyM .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#JLRbnpqxQqyM .fx5 {font-style: normal}#JLRbnpqxQqyM .fx6 { text-anchor: start; }#JLRbnpqxQqyM .fx6 {text-anchor: start}#JLRbnpqxQqyM .fx7 { dominant-baseline: alphabetic; }#JLRbnpqxQqyM .fx7 {dominant-baseline: alphabetic}#JLRbnpqxQqyM .fc1 { fill: rgb(51, 51, 51); }#JLRbnpqxQqyM .fc1 {fill: rgb(51, 51, 51)}#JLRbnpqxQqyM .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#JLRbnpqxQqyM .fx8 {font-style: normal}#JLRbnpqxQqyM .fb1 { fill: var(--N900-FG, 0.15); }#JLRbnpqxQqyM .fb1 {fill: rgba(31,35,41, 0.15)}#JLRbnpqxQqyM .fb2 { fill: rgb(225, 228, 232); }#JLRbnpqxQqyM .fb2 {fill: rgb(225, 228, 232)}#JLRbnpqxQqyM .fa4 { fill: var(--bg-body); }#JLRbnpqxQqyM .fa4 {fill: #fff}ABC12345特性思维链 (CoT)仅依赖内部模型权重高(如果事实未知或过时)差(容易产生逻辑级联错误)纯数学计算、逻辑推导、文本总结ReAct外部工具 + 内部权重低(可通过工具验证事实)极佳(能观察工具失败并调整)网络调研、API 交互、多步复杂执行信息来源幻觉风险错误恢复适用场景
ReAct 实战指南 (Python 示例)
虽然 LangChain 等框架将这一过程高度封装,但从零手写一个 ReAct Agent 才能真正看清它的底层运作方式。它极其依赖严格的提示词工程。
python
代码块
Python
import openai
🔧 立即体验:为 ReAct Agent 定义工具时,确保你的 JSON 描述完美无缺。使用我们的 JSON 格式化工具 校验你的 Schema。
构建 ReAct Agent 的最佳实践
提供极度清晰的工具描述 — LLM 的 Thought 完全依赖于确切知道工具的作用。像"搜索网络"这样的描述太模糊了。应该使用:"在实时互联网上搜索当前事件、新闻和客观事实。"
设置硬性迭代上限 (Max Steps) — ReAct 循环很容易陷入无限的失败重试死循环中(例如,反复尝试同一个错误的搜索词)。务必在代码层设置硬停止条件(如 max_iterations=5)。
强制格式输出 — 较小的模型(如 Llama-3-8B)可能会忘记输出 PAUSE 或 Action: 关键字。使用 JSON 模式、Structured Outputs 功能或非常严格的 System Prompt 来强制约束格式。
优雅处理工具故障 — 如果工具抛出了 500 错误,不要让应用程序崩溃。将错误字符串作为 Observation 返回给模型(如 Observation: API 返回 500 内部错误)。LLM 会读取这个错误,并生成一个新的 Thought 来尝试其他替代工具。
⚠️ 常见错误:
•
给 Agent 塞了太多工具 → 解决方案:上下文窗口有容量和注意力限制。如果你塞入 100 个工具,LLM 会彻底晕头转向。请使用分层路由架构或工具检索 (Tool Retrieval) 系统。
•
忘记设置 "PAUSE" 停止词 → 解决方案:确保在调用大模型 API 时显式传入 stop=["Observation:"] 参数,否则模型会自己把观察结果给"幻觉"出来!
常见问题 (FAQ)
OpenAI 出了 Function Calling,ReAct 是不是过时了?
完全没有。OpenAI 的函数调用(或工具调用)只是一种更可靠的、结构化输出 JSON 的方式,用来执行 Action 阶段。其底层的认知架构——即要求模型在决定调用函数前,先生成一段思考 (Thought)——依然是纯正的 ReAct 思想,并且这仍被业界公认为最佳实践。
为什么我的 ReAct Agent 会自己捏造 (幻觉) Observation?
当你在 API 调用中没有配置正确的 stop (停止序列) 时就会发生这种情况。LLM 不知道它应该停下来等待环境的回复,所以它就顺着往下自己瞎编了。请确保传递 stop=["Observation:"]。
哪些模型最适合跑 ReAct?
具备强大逻辑推理和指令遵循能力的模型。GPT-4o、Claude 3.5 Sonnet 和 DeepSeek-V3 是运行 ReAct 的佼佼者。参数量较小的模型(<10B 参数)往往很难在多轮对话中维持严格的 Thought -> Action 格式。
总结
ReAct 框架将大语言模型从静态的文本生成器,转变为动态的、自主的问题解决专家。通过强制执行"推理、行动、观察"的严格循环,ReAct Agent 能够穿梭于复杂的外部环境中,灵活调用工具,并具备了从错误中自我恢复的智能。