从0-1搭建 AI Agent 团队:9个落地阶段拆解
本文整理的9个落地阶段,参考Anthropic Claude Agent SDK官方工程文档、多智能体权威研究方案,也是区分「只能演示的玩具智能体」和「能24小时自动干活的量产智能体」的核心标准。
💡 整套体系分为三大层级、九个阶段:
1. 单个智能体:让单个AI能稳定、规范地独立干活
2. 团队协调层:让多个AI分工协作、互不冲突、高效配合
3. 量产稳定层:打造可商用、可兜底、无人值守的成熟AI团队
第一层级:打磨单个智能体
阶段01:搭建真正的AI Loops
•
绝大多数人做的“智能体”,本质只是加长版问答提示词,根本算不上真正的智能体。
•
普通聊天机器人:一次提问、一次回答,任务直接结束。
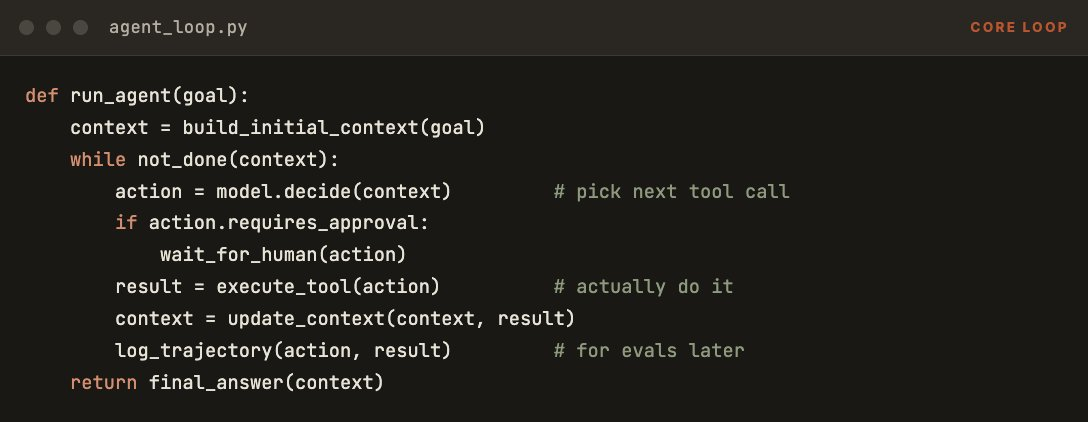
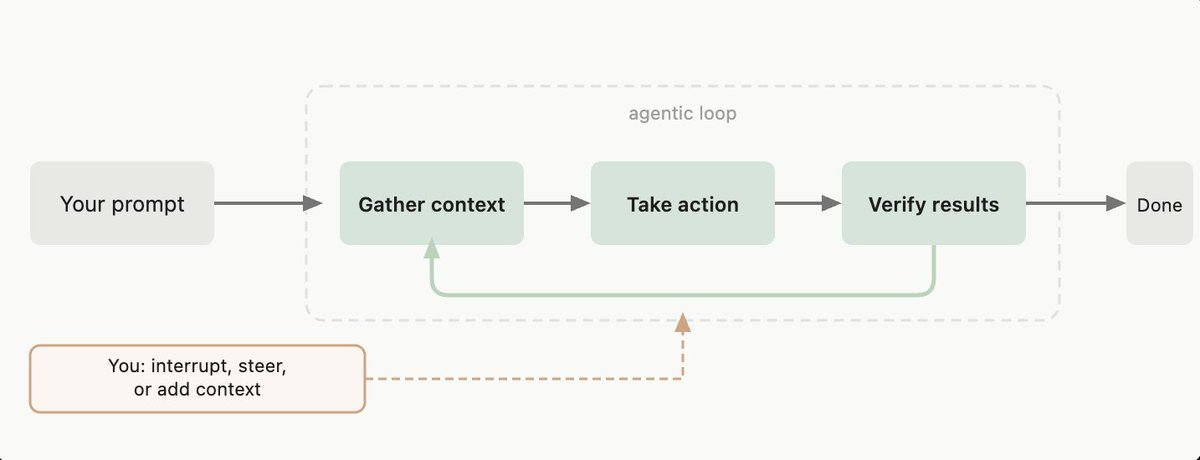
真正的AI智能体:是一套闭环工作循环(Loop),接收目标 → 判断动作 → 执行操作 → 观察结果 → 决策下一步 → 循环往复,直到任务完成或触发停止条件。
50%
50%
⭕
标准有效循环,必须包含3个核心配置:
✅ 审批关卡:高危操作必须人工确认
✅ 日志记录:每一步操作全程留痕
✅ 明确终止条件:杜绝无限循环、无限耗损算力
⚠️ 核心落地小贴士
停止条件远比大家想象的更重要!没有终止机制的AI,会无限循环、持续烧钱。通用安全终止规则:
1. 任务目标完成,自动停止
2. 最大迭代次数限制(固定30-50次,强制封顶)
3. 支持用户手动中止
4. 结果误差超标,自动终止重试
阶段02:精细化管理上下文
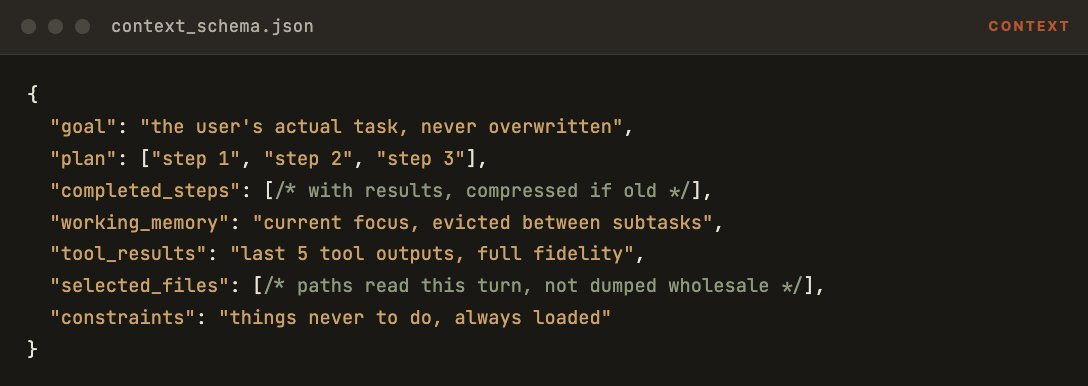
AI智能体80%的翻车问题(变笨、出错、遗忘信息),根源都不是模型能力差,而是上下文信息管理混乱。要么缺关键信息、要么信息太多分心、要么拿到过期无效信息。Anthropic官方给出的上下文四大核心操作(量产必备):
1. 写入:精准添加信息
每一步写入上下文的内容都要精简,每一行文字都会消耗算力、分散AI注意力,杜绝冗余内容。
2. 筛选:精准调取信息
从资料库、历史记录中只提取当前任务需要的内容,不全部堆砌,避免信息过载。
3. 压缩:精简历史信息
上下文快要占满时,自动总结早期对话和操作记录,保留核心决策逻辑,删除无效细节,保证AI不卡顿、不分心。
4. 隔离:子任务独立上下文
子AI单独开启独立窗口干活,只加载当前任务的相关信息,完成后只返回结果摘要,不把杂乱过程同步给主AI。
落地核心优势
主AI全程干净无冗余,只把控全局,不被细碎任务流程干扰,这是多AI团队稳定运行的关键。
阶段03:规范工具调用规则
很多AI故障不是工具不能用,而是AI自由发挥调用工具:自己瞎编格式、乱填参数、越权操作。
⭕
解决办法:放弃自由调用,使用标准化工具模板(Schema),把“AI猜怎么调用工具”,变成“AI按固定模板填空调用”,全程可控、可校验。
量产级工具规则,必须包含5项约束:
✅ 前置条件:明确调用工具前必须满足的要求
✅ 副作用说明:标注调用后会产生的所有影响
✅ 人工审批开关:高危调用自动进入人工审核
✅ 禁止操作清单:强制拦截所有违规、越权操作
✅ 固定参数格式:杜绝AI自编参数、格式错乱
第二层级:搭建团队协调能力(让多个AI有序分工、高效协作)
阶段04:创建独立子AI
合格的子AI,是专属岗位专家:拥有独立上下文、专属工具集、适配的专属模型。
⭕
落地逻辑:
•
主AI判断任务类型,拆分出细分工作,启动对应领域的子AI。
比如调研类任务,就启动调研子AI,只用调研工具、适配轻量化低成本模型,只专注完成细分任务。
•
子AI全程独立干活,只输出结构化摘要结果,杂乱的执行过程不占用主AI上下文。
参考官方调用逻辑:
执行效果:
子AI独立扫描142个文件,标记11个风险接口,最终只返回1.2k字精简摘要,原始日志不干扰主流程。
核心关键:
子AI的返回格式,比提示词更重要!必须强制结构化输出(摘要+清单+结果列表),否则主AI无法精准识别、统筹工作,直接导致团队协作混乱。
阶段05:设计总控编排AI
编排器就是整个AI团队的总指挥。核心准则:只规划、只委派、只汇总,绝不亲自执行具体任务。
如果总指挥亲自写代码、查数据、调接口,就会被细碎信息干扰,失去全局把控能力,整个团队彻底乱套。
量产级编排器三层工作循环:
代码块
Plain Text
def orchestrator_loop(goal):
plan = make_plan(goal) # 1. 制定整体执行方案
results = []
for step in plan:
subagent = pick_specialist(step) # 2. 匹配对应岗位子AI,委派任务
result = run_subagent(subagent, step)
results.append(result)
if plan_needs_revision(result):
plan = revise_plan(plan, result) # 动态调整方案,适配执行结果
⭕
成本与效率最优方案
•
高端昂贵大模型(Opus)做总指挥,负责规划统筹;
•
中端、轻量化低成本模型(Sonnet/Haiku)做执行子AI,负责落地干活。
这套模式下,同等成本的AI团队,工作量是单机AI的5-10倍,效率翻倍、成本更低。
阶段06:搭建共享任务清单
没有统一任务清单的AI团队,本质只是多个AI各自单打独斗,根本不算协作。
⭕
常见问题:两个AI抢同一个任务、做完的工作无人知晓、总指挥忘记委派进度、任务重复/遗漏。
解决方案:搭建结构化共享任务清单,所有AI统一读写、同步状态。
示例标准任务结构:
代码块
Python
"goal": "Add auth to all unprotected endpoints",
"tasks": [
{
"id": "t1",
三大核心作用,彻底解决协作bug:
1. 明确负责人:杜绝多个AI抢同一任务
2. 显性依赖关系:未完成前置任务,绝不执行后续步骤
3. 可视化进度:总指挥无需翻看日志,直接查看状态把控全局
第三层级:打造量产级AI团队
阶段07:配置记忆、断点续跑、安全沙箱
•
演示版AI:对话结束就失忆,出错就从头重来,随意操作本地文件。
•
量产版AI团队:记得住、断得续、不瞎搞,三大核心配置缺一不可。
1. 结构化长效记忆
不依赖杂乱的对话日志,单独建立专属记忆文件:决策记录、规范惯例、历史故障、成功方案,下次启动自动加载,持续积累经验。
2. 断点续跑(持久性)
每完成一步就自动存档,中途崩溃、中断后,下次直接从断点继续执行,不用从头重来。彻底解决“50步任务,47步出错,全部白干”的痛点。
3. 安全沙箱机制
限制AI操作权限,只能访问授权资源,禁止随意读取本地文件、随意写入外部目录、越权操作系统文件。
沙箱是区分「帮忙干活的AI」和「搞砸项目的AI」的核心屏障。
记忆文件示例:
代码块
Plain Text
# Decisions log
## 2026-05-22
- chose JWT over session cookies (mobile clients drive this)
- auth lives in src/auth/, never duplicated per route
- all endpoints under /api/admin require role check, not just login
## 2026-05-29
- adopted shared task list pattern (state/tasks.json)
- orchestrator on Opus, subagents on Sonnet/Haiku
- max_iterations = 30 per loop, hard cap enforced by harness
阶段08:建立评测与轨迹核查
绝大多数团队更新AI系统,全靠“感觉更好用”,没有标准校验。看似优化升级,实则暗藏bug,几周后就会出现各种翻车问题。量产AI必须搭建三层评测体系,量化效果、规避隐患:
1. 固定评测题库
准备20-100个标准化测试任务,固定正确输出结果,每次更新系统后自动跑测,统计通过率,直观判断优化效果。
2. 执行轨迹核查
不止看最终结果对不对,更要看执行路径是否安全合规。两个AI可能得出一样的结果,但一个路径安全稳定,一个全程高危操作,轨迹核查能提前拦截风险路径,避免后续事故。
3. CI自动门禁
系统更新、代码合并前自动跑评测,通过率不达标直接拦截,禁止上线,和正规代码测试标准对齐。
标准评测模板示例:
代码块
JSON
{
阶段09:配置权限与人工审核
最后一步,也是决定AI团队能否通宵自动干活、无需人工盯守的关键。单独搭建一份权限规则文件,所有工具调用、操作行为都要先过权限校验,规则独立于模型之外,AI绝对无法绕过、篡改。
标准三级权限体系:
✅ 无需审批(自动执行)
读取项目文件、运行测试、创建分支、写入记忆文件、新建草稿PR等低风险操作。
⚠️ 需要人工审批(禁止自动执行)
合并代码、线上部署、删除文件、安装新依赖、修改CI/CD配置等中高危操作。
❌ 绝对禁止(永久拦截)
强制推送主干分支、读取密钥隐私、访问未授权域名、修改权限规则、绕过安全校验等高危操作。
落地核心建议
权限文件一定要在搭建第一个子AI之前写完,不要等出了事故再补规则。这是量产AI团队最核心的安全底牌。
代码块
Python
## Always allowed (no approval needed)