第八章 Harness Engineering —— Vibe Coding时代真正的护城河
和几个做AI开发的朋友聊,他们的体感也在印证这一点:团队里写代码最快的人,产出反而不如一个"不怎么写代码"的同事。后者整天在写文档、定规范、调prompt、搭流程。作为独立开发者,我自己用Claude Code也是一样:花在"写代码"上的时间越来越少,花在"告诉AI怎么写"上的时间越来越多。
🥛
在Vibe Coding时代,决定产出质量的,越来越不是"用哪个模型",而是"你给模型搭了什么样的环境"。AI Agent频频翻车的真正瓶颈,大概率不是模型本身,而是包裹在模型外面的那套基础设施和工具——也就是"harness"。
一、三年三个阶段:从Prompt到Context到Harness
把过去三年AI开发范式的演进讲得很清楚(见题图)。
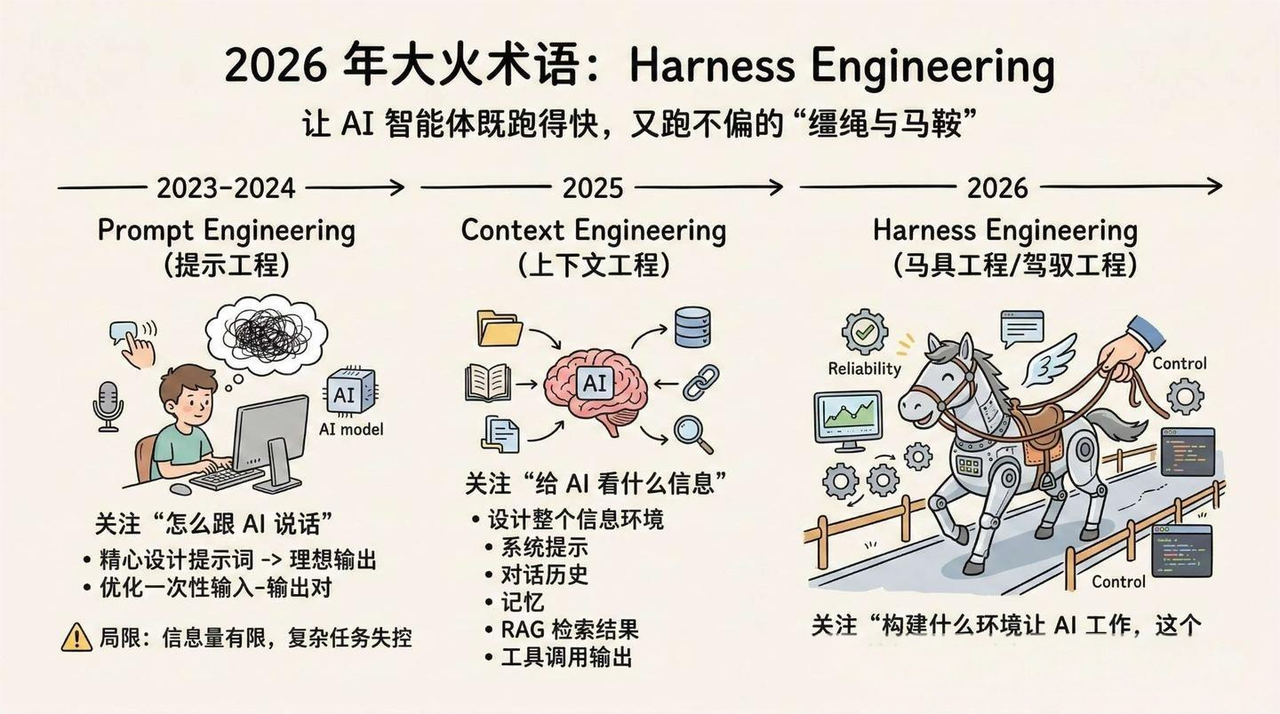
我觉得这个框架是理解Harness Engineering最好的切入点:
💡
2023-2024:Prompt Engineering(提示工程)——关注"怎么跟AI说话"。精心设计一段提示词,希望模型给出理想输出。本质上是优化一次性的输入-输出对。局限很明显:一条消息能塞的信息有限,任务一复杂就失控。
⛱️
2025:Context Engineering(上下文工程)——关注"给AI看什么信息"。不再只盯措辞,而是设计信息环境:系统提示、对话历史、记忆、RAG检索结果、工具调用输出。
🏕️
2026:Harness Engineering(马具工程/驾驭工程)——关注"构建什么环境让AI工作,这个环境如何保证它的产出是可靠的"。比Context Engineering更进一步——不仅管理输入给模型的信息,还包括模型之外的整个执行环境:验证闭环、架构约束、生命周期管理、熵清理。
"Harness"这个词,字面意思是马具——缰绳、马鞍、嚼子。AI Agent就像一匹动力十足但不太守规矩的马,Harness就是那套让它既能跑得快、又不会跑偏的控制系统。这个概念最早由Mitchell Hashimoto(Terraform的作者)提出,核心原则是:每次发现AI犯错,就花时间工程化一个机制,让它以后再也不犯这个错。
Google前首席决策科学家Cassie Kozyrkov最近专门写了一篇长文讨论这个转变。她的观点很直白:Vibe Coding降低了语法门槛,但没有降低系统思维门槛——事实上,它提高了这个门槛。
二、不是孤例:所有数据都指向同一个结论
42%到78%不是孤例。LangChain最近做了一个实验:他们的编程Agent在Terminal Bench 2.0上从52.8%提升到66.5%,排名从Top 30一路冲到Top 5。他们用的模型始终是GPT-5.2-Codex,一行模型代码没改,只调了三样东西:系统提示词、工具配置和中间件钩子。
OpenAI自己就更极端了。2026年2月他们发了一篇文章,讲了一个内部实验:一个最初只有3名工程师的小团队,5个月时间,零行手写代码,完全由Codex Agent生成了一个百万行级别的生产级内部产品。约1500个PR被提交和合并,平均每人每天3.5个PR,后来团队扩展到7人,吞吐量反而还在上升。
这些数据指向一个结论:模型是商品,马具才是护城河。
目前最前沿的玩法已经在跨厂商组合了:用Claude Code作为执行Agent,用Codex Harness作为验证环境。写代码的是一个模型,检验代码的是另一套系统。这个思路本身就说明了问题——大家竞争的焦点早就不是"用谁家的模型",而是"怎么搭这套验证和控制的基础设施"。
三、我理解的"马具"到底是什么
Kozyrkov用了一个很好的比喻:你用AI写代码,就像雇了一个能力超强但完全不了解你情况的实习生。问题不在于它做不好你明确交代的事——问题在于你没交代的部分,它会用"过度自信的即兴发挥"来填补。每一个你没有明确的模糊地带,都是你在不知不觉中把决策权泄露给了这个实习生。
她管这叫"信任债务"(Trust Debt):你没有审计过的那些AI假设,累积起来的成本。它不会提前告诉你,而是默默复利,直到某天一起爆发。
那怎么管理这个实习生?说白了就是四件事。
3.1 第一,把规矩写下来。
很多人用Claude Code或者Cursor,上来就开始对话。这就好比你不给任何背景,直接说"把这个功能做了"。结果可想而知。
现在的做法是:项目根目录放一个CLAUDE.md或AGENTS.md。但关键是——OpenAI踩过的坑告诉我们——这个文件应该是一张"地图",不是一本百科全书。OpenAI的Codex团队原话是:给Agent一张地图,不要给它一本1000页的操作手册。
具体怎么写?大概20-40行就够了:项目是什么、核心代码在哪、代码风格遵循什么规范、有哪些绝对不能碰的红线。然后把详细规则分拆到CONVENTIONS.md、ARCHITECTURE.md等独立文件里,让AI按需查阅。
更关键的一点:要写清楚"什么事不要做"。AI最大的问题不是不会做,而是太会自作主张。你不告诉它边界在哪,它会在模糊地带自动补全业务逻辑。
3.2 第二,规格先行,别上来就写代码。
Kozyrkov提出了一个"双翻译"习惯:在让AI写代码之前,先让它用自然语言复述一遍它理解的需求和假设。看看它的"计划书"。每一个你没纠正的假设,都等于你默认批准了。
代码写完之后,再让另一个独立的AI把代码翻译回自然语言,告诉你这段代码到底做了什么、可能在哪里出问题。然后跟你脑中的预期做对比。差异会立刻跳出来。
这个方法对业余项目已经够用了。但对生产级项目,需要更系统化——写正式的功能规格文档,包含功能范围、不包含什么、数据结构、验收标准和边界情况,再交给AI去实现。
3.3 第三,建立验证闭环。
不能让AI写完代码就完事。OpenAI内部管这叫"Ralph Wiggum Loop"——AI自己写代码、自己开PR、自己审查、自己跑测试、失败了自己修、再跑测试,循环往复直到通过。人类只在真正需要判断的时候介入。
为什么?因为当代码量大到百万行级别,人已经不可能逐行审查了。你能做的是监控信号,不是审查噪音。
3.4 第四,控制信息量——这是最反直觉的一点。
很多人觉得应该给AI尽可能多的上下文。这条路是不对的,信息太多,AI反而会被淹没。
Anthropic在设计长时间运行的Agent时采用了"渐进式披露"(Progressive Disclosure):AI需要处理哪个模块,就只加载那个模块的文档。
Claude Code的Skills机制就是这个思路:启动时AI只看到skill的名字和简短描述,真正需要用的时候才加载完整内容。本质上就是给大模型做"懒加载"。
Kozyrkov用了一个精辟的类比:恒温器不需要理解热力学。它只需要测量温度,然后跟设定值比较。你的harness也是一样——不需要理解AI内部的每一行推理,只需要精确定义边界就够了。
四、"做减法"才是硬道理
我注意到一个趋势:所有在Harness工程上走得最远的团队,最终都在做减法。 Cassie Kozyrkov的文章里引用了一个很有说服力的细节:Phil Schmid测量发现,用标准方式集成6个MCP服务器,光schema定义就要消耗47000个token。你的AI还没开始想问题,就已经吃掉了4万7千token的"粮草"。而一个简单的CLI封装只需要大约400 token。
Vercel的实践验证了这一点。他们一开始给Agent配了完整的工具库——搜索、代码、文件、API,应有尽有。结果Agent反而困惑了,反复调用冗余工具。后来大刀阔斧砍到只留基础bash访问,准确率飙到100%,速度快了3.5倍。
Manus(后来并入Meta的AI Agent系统)的经历更极端:6个月内重写了5次框架,同一个模型。他们最初用todo.md让Agent每一步都重写任务列表,结果大约30%的token都浪费在更新这个文件上。后来换成子Agent规划器,按需注入结构化对象,token消耗大幅下降。他们的首席科学家Peak Ji说了一句话:模型越强,我们搭的脚手架就应该越少,而不是越多。
Anthropic也表达了类似观点:随着模型能力提升,那些模型曾经需要的工具,现在可能反过来在限制它们。
这跟Richard Sutton的"苦涩的教训"(The Bitter Lesson)是一脉相承的:长期来看,简洁通用的方法总会胜过复杂精巧的方法。
五、如果你今天想开始,做三件事就够了
不用一步到位。
第一,在项目根目录建一个CLAUDE.md。 花15分钟,写清楚:项目技术栈、核心代码路径、代码规范的红线。保持20-40行。如果超过了,说明你在写百科全书而不是地图。
第二,任何功能开发之前,先让AI复述它理解的需求。 在你的prompt末尾加一句:"在你写代码之前,先详细告诉我你对我要求的理解,以及你需要我确认的假设。"读它返回的内容。这一步能在代码产生之前拦住大部分"fanfiction"。
第三,每个季度清理一次你的规则文件。 模型在进步,三个月前需要的很多限制,现在可能已经多余了。哪些工具30天没被调用过?删掉。哪些规则是因为旧模型太笨才加的?去掉。如果你的harness只增不减,说明它正在变成牢笼而不是马具。
六、最后说一句
随着模型能力的提升,现在框架里做的一些事情会逐渐被模型自身吸收。规划、自我验证、长期一致性——这些都会变得越来越不依赖上下文注入。
这是否意味着框架会越来越不重要?不太可能。就像提示词工程在今天依然至关重要一样,框架工程大概率也会长期发挥作用。框架的价值不只是弥补模型的短板,它是围绕模型智能构建系统、让模型更高效发挥的那层"放大器"。一个配置良好的环境、合适的工具、持久状态和验证循环,无论底层模型有多强,都能让它跑得更稳、更快。
💡
模型负责提供智能,框架负责把这种智能变成真正有用的东西。
在将来,不会写代码,可能不再是什么大问题;不懂系统,才是大问题。未来真正稀缺的,不是能写出漂亮代码的人,而是能设计出一套环境、让AI持续稳定产出的人。这套环境,就是你的护城河。
大学也在跟进。今年课改的核心就是教学生构建环境约束和反馈环来控制AI Agent,本质上就是Harness Engineering。SIT新开了类似方向的课程,斯坦福和CMU的Prompt Engineering课也在被Agentic Infrastructure取代。这不是流行语,它正在成为下一代工程师的基础素养。