12种 Agent Harness 设计模式
这些 Agent Harness 模式可分为四大类:记忆与上下文、工作流与编排、工具与权限,以及自动化。
类别一:记忆与上下文(Memory & Context)
这五种模式构成了一条渐进的路径:从为智能体提供一份静态的规则文件,到按目录范围限定这些规则,再到将记忆分层组织,接着在后台清理这些记忆,最后在上下文窗口满载时对对话本身进行压缩。
持久化指令文件模式(Persistent Instruction File Pattern)
如果没有持久化的指令文件,每个客服会话都会从空白状态开始。用户每次都会重复相同的约定、命令和边界条件。客服在第五次会话中犯的错误,与第一次会话中的错误如出一辙。
🧠
该模式引入了一种持久的项目级配置文件,它会在每次会话开始时自动加载。该文件定义了构建命令、测试命令、架构规则、命名规范以及编码标准。它随仓库一同提供,而非存储于用户的剪贴板中。
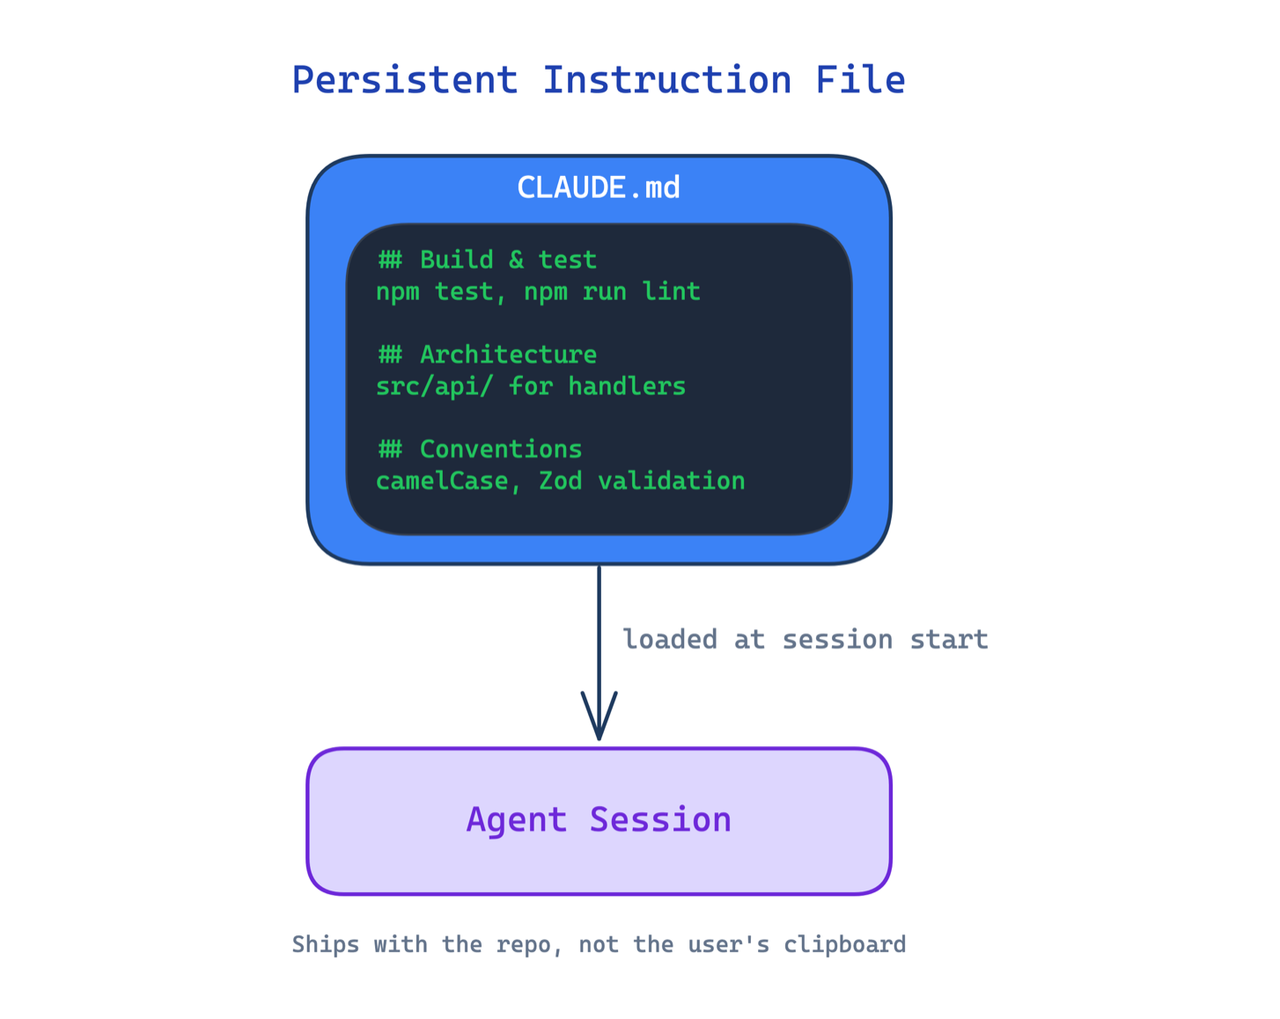
💡核心作用:当您的代理在多个会话中处理同一代码库时,请使用此方法。主要的权衡在于维护负担:随着项目的演进,该文件必须保持最新;如果指令文件过时,其危害甚至可能超过完全没有指令文件的情况,因为它可能会向代理传授过时的规则。
作用域上下文组装模式(Persistent Instruction File Pattern)
对于小型项目,一个单独的指令文件即可胜任。但随着代码库规模的扩大,这个文件要么变成一团难以维护的“大泥团”,被开发者忽视;要么过于通用,以至于对任何特定目录都缺乏实际意义。
🧠
此模式可从多个文件中按不同作用域动态加载指令:组织、用户、项目根目录、父级目录以及子目录。代理会根据其在代码库中的具体位置,看到不同的规则。导入语法允许将大型指令集拆分到多个文件中,而无需重复定义。
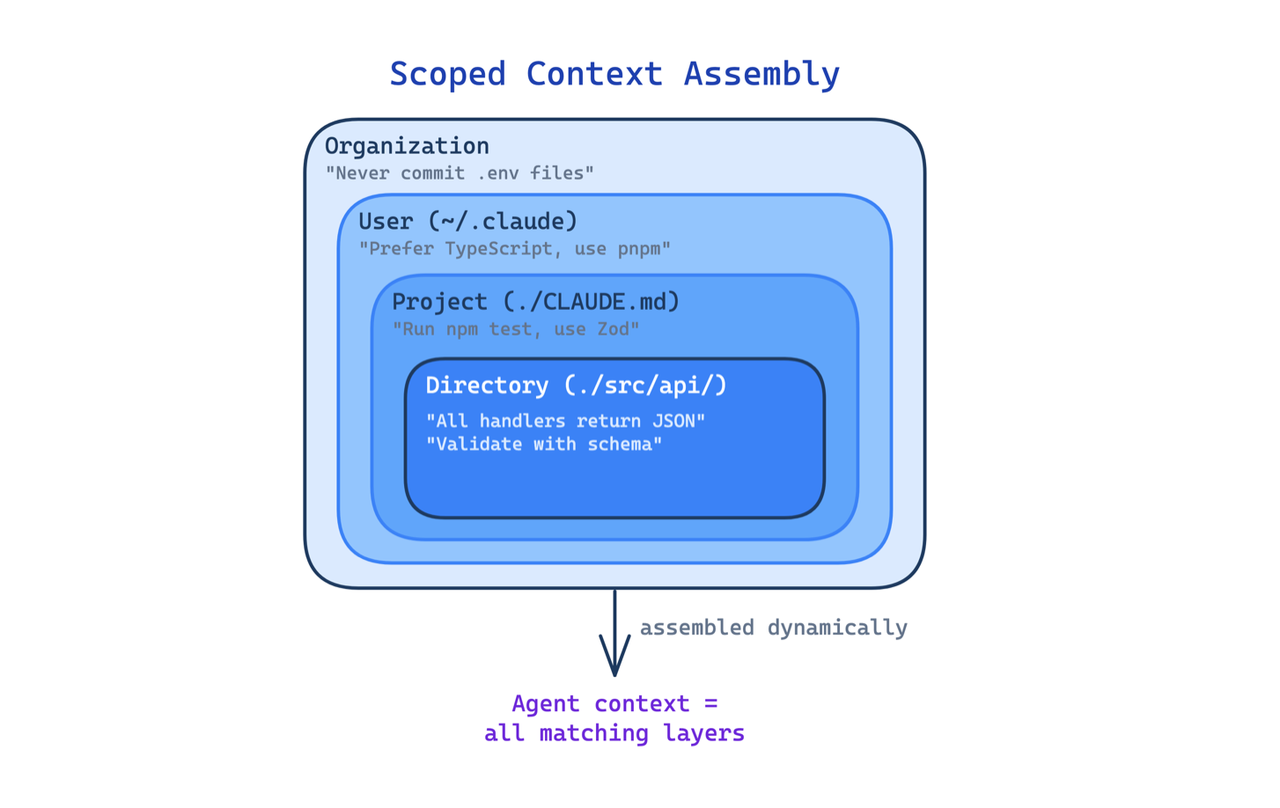
💡核心作用:此方法适用于单体仓库、多语言项目,或任何不同目录遵循不同规范的代码库。主要的权衡在于可发现性:当配置说明分散在多个文件中时,就更难理解代理实际看到的内容。不同作用域中的冲突规则可能会导致意想不到的行为。
分层记忆模式(Tiered Memory Pattern)
一个以相同方式记住所有内容的智能体,最终反而什么也记不牢。每轮对话都将全部记忆加载到上下文窗口中,既浪费token、触发尺寸限制,又会让有用信息淹没在噪声之中。
🧠
这种模式将智能体的记忆划分为多个独立的层次,并采用不同的加载策略。一个精简的索引(在 Claude Code 中最多保留 200 行)始终处于上下文之中。当当前任务与特定主题匹配时,相关主题文件会按需加载。完整的会话记录则保存在磁盘上,仅在需要时才进行检索。
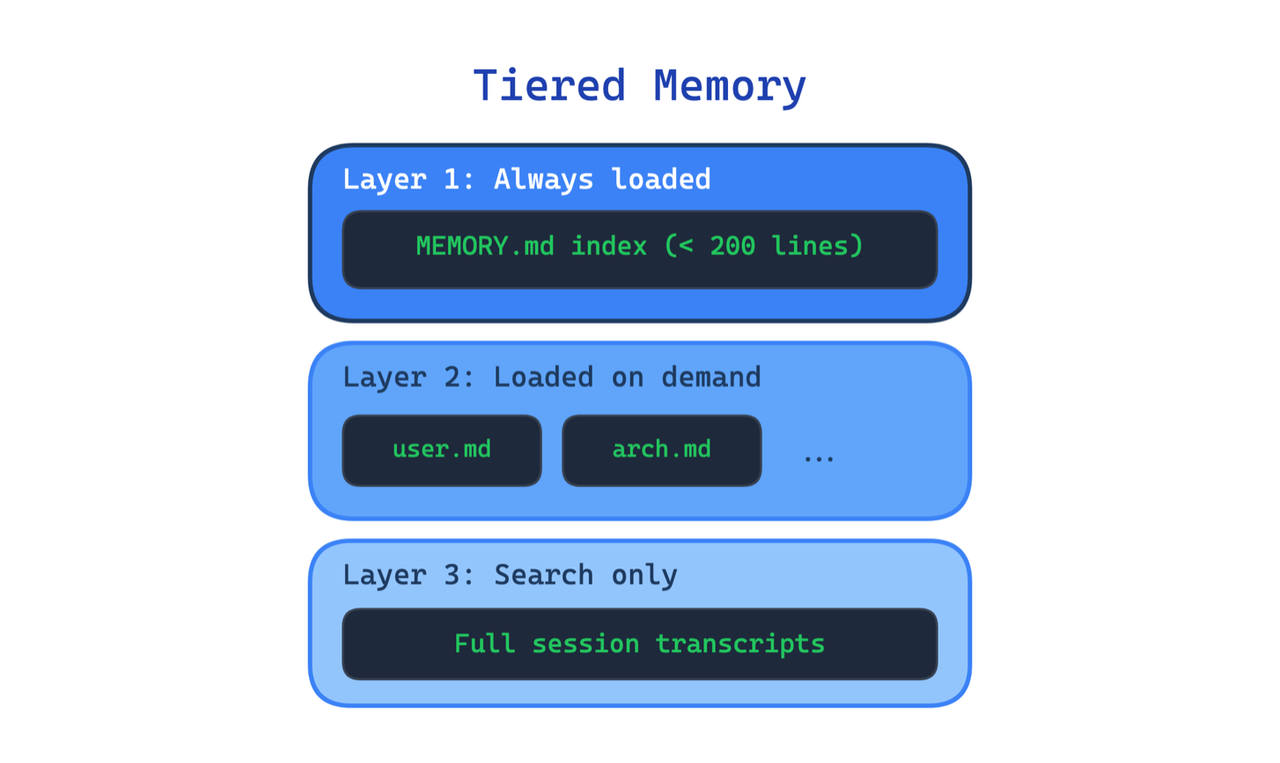
💡核心作用:当您的代理跨多个会话运行,并需要保留偏好设置、决策或工作流状态时,请使用此功能。主要的权衡在于:如何决定哪些信息该存放在何处、何时在各层之间提升或降级信息,以及如何使索引与底层文件保持同步,这些都会带来额外的复杂性。
梦境巩固模式(Dream Consolidation Pattern)
即使采用分层存储,智能体的内存也会随时间逐渐退化。重复条目不断累积,过时的事实与新信息相互矛盾,索引也日益膨胀,直至不再紧凑。
🧠
该模式会运行一个后台进程,在空闲时段定期对代理内存进行审查、去重、修剪和重组。不妨将其视为代理状态的垃圾回收机制。
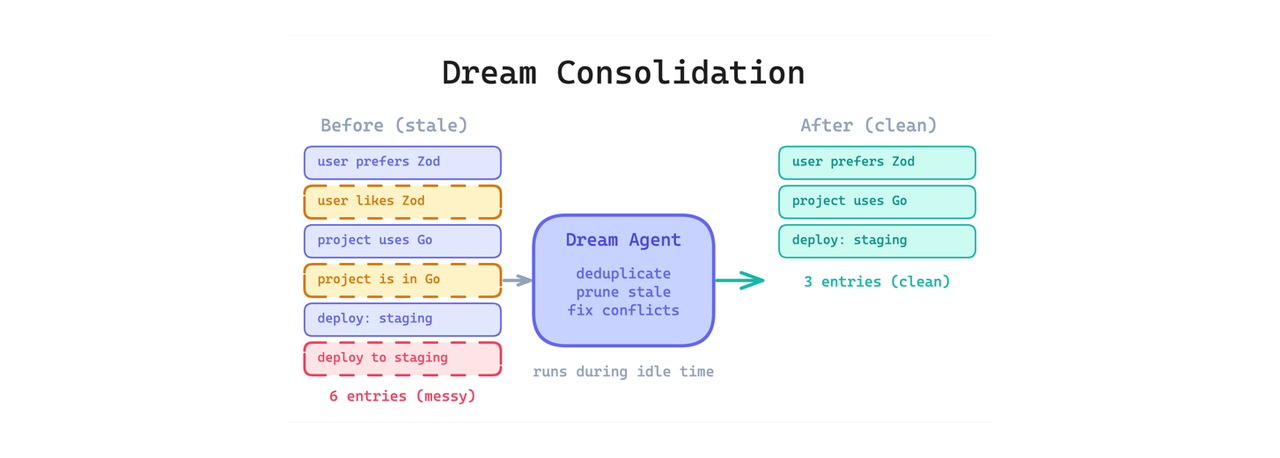
💡核心作用:当您的智能体在多个会话中积累了大量记忆,且无法依赖用户手动进行整理时,请使用此功能。主要的权衡在于,整合过程本身会消耗令牌,并且可能出错。过于激进的修剪可能会误删用户仍需的内容。
渐进式上下文压缩模式(Progressive Context Compaction Pattern)
长时间的智能体会话最终会达到上下文窗口的上限。此时,智能体要么完全丢失最早的上下文,要么停止运行。而对于那些需要在多轮对话中持续进行推理的任务而言,这两种情况都是不可接受的。
🧠
该模式应用了多级压缩,针对对话的不同历史阶段进行优化。较新的对话轮次保持完整细节,较旧的轮次则被轻度摘要,而非常久远的轮次则会被大幅折叠。
💡核心作用:当会话轮次经常超过20至30轮时,请使用此选项。主要的权衡在于有损压缩:每一步的摘要都会丢失细节,如果智能体后续需要从被折叠的片段中获取某些信息,它可能会凭空“编造”而非承认自己已遗忘。
类别二:工作流与编排(Workflow and Orchestration)
这里的共同主题是分离:将阅读与写作分离、将研究环境与编辑环境分离,以及将串行工作与并行工作分离。这些模式之所以重要,是因为大多数代理的默认行为是把所有事情混在一起,而随着任务规模的扩大,这种混杂会降低质量。
探索-计划-行动循环模式(Explore-Plan-Act Loop Pattern)
当代理直接进入文件编辑环节时,往往会基于不完全的理解做出修改。其结果是误改了错误的文件、遗漏了依赖关系,以及采取了一些忽视现有模式的做法。
🧠
这种模式将工作流划分为三个阶段,且各阶段的写权限逐步提升。
•
在探索阶段,代理仅能读取、搜索并绘制代码库的结构;
•
在计划阶段,它会与用户讨论具体方案;
•
只有到了执行阶段,它才会获得对工具的完全访问权限。
💡核心作用:适用于任何涉及陌生代码库或需要在多个文件中进行非 trivial 修改的任务。主要的权衡在于速度:强制执行探索与规划会在智能体生成输出之前增加额外的回合,这在处理简单任务时会显得较为缓慢。
上下文隔离的子代理模式(Context-Isolated Subagents Pattern)
在一次漫长的智能体会话中,上下文窗口会不断累积各种信息:研究发现、规划讨论、代码修改、测试结果以及错误日志。等到智能体深入到代码编辑阶段时,其上下文早已被前期各环节的无关内容所污染。
🧠
此模式会运行多个独立的智能体,每个智能体都拥有自己的上下文窗口、系统提示词以及受限的工具访问权限。研究型智能体无法编辑代码;规划型智能体无法执行命令。每个子智能体仅能看到与其特定任务相关的信息。
💡核心作用:当会话较长、包含多个阶段,或涉及上下文需求差异较大的任务时,请使用此方法。主要的权衡在于协调开销:主代理必须决定向每个子代理传递哪些信息,而先前阶段的重要细节可能在交接过程中丢失。
分叉-汇合并行模式(Fork-Join Parallelism Pattern)
即使大型任务可以被拆分为独立的单元,但如果代理一次只能处理一项任务,这些任务仍会按顺序执行。例如,在20个文件之间进行迁移时,即便其中大多数文件彼此之间并无依赖关系,整个过程也依然需要依次完成20个步骤。
该模式会并行启动多个子代理,每个子代理都在仓库的独立副本上、以隔离的 Git 工作树中运行。父进程的缓存上下文会被每个分支复用,因此在令牌成本方面,并行分支几乎无需额外开销。待所有分支完成后,结果将自动合并。
当一项任务可分解为彼此独立、互不依赖于对方输出的单元时,请使用此方法。主要的权衡在于合并复杂度:当并行分支涉及重叠文件时,合并可能会产生比串行处理更难解决的冲突。
类别三:工具与权限(Tools and Permissions)
如果内存模式描述的是代理所知的内容,而工作流模式描述的是其运作方式,那么这些模式则规定了它被允许执行的操作。
逐步扩展工具模式(Progressive Tool Expansion Pattern)
同时赋予智能体所有可用工具的访问权限会导致选择难题。当有60种工具可见时,模型会花费更多时间来决定使用哪一种,并且更有可能选错。
🧠
该模式以一个小型的默认工具集(Claude Code 中不足 20 个工具)为起点,并按需启用更多工具。该智能体初始仅包含读取、编辑、写入、Bash、Grep、Glob 以及少数其他工具。MCP工具、远程工具和自定义技能仅在需要时才会激活。
💡核心作用:当您的智能体能够访问多种工具,但大多数任务仅需使用其中少数几种时,请采用此方法。主要的权衡在于:扩展逻辑会增加复杂性——智能体必须决定何时启用工具;而启用过晚则会导致智能体在缺乏相应能力的情况下浪费行动次数。
命令风险分类模式(Command Risk Classification Pattern)
让代理程序在未经检查的情况下执行任意的 shell 命令是危险的。然而,要求用户对每条命令都进行确认又会令人疲惫不堪,最终用户往往会直接对所有操作点击“是”。
🧠
该模式在执行前应用确定性的预解析与基于工具的权限控制。每种工具均设有独立的允许、询问与拒绝规则,并支持模式匹配。Shell 命令会经过一个分类层,该层会对动词、选项及目标进行解析,以评估风险。代码中的自动模式分类器会自动批准低风险操作,同时为所有危险行为保留安全分类器。
💡核心作用:当您的代理能够执行 shell 命令或与外部系统交互时,请使用此选项。主要的权衡在于其刚性:确定性分类器无法预判所有安全或危险的命令,因此规则需要持续调整。
单一职责工具设计模式(Single-Purpose Tool Design Pattern)
当代理将所有文件操作都通过通用的 shell(如 cat、sed、grep、find)来执行时,这些命令更难审查、更难进行权限管控,也更难被模型正确地理解与使用。一条用于编辑文件的 sed 命令,在结构上与一条会破坏文件的 sed 命令几乎完全相同。
🧠
这种模式用针对每种常见操作的专用工具取代了通用的:FileReadTool、FileEditTool、GrepTool 和 GlobTool。每个工具都具有类型化的输入、受限的作用域以及独立的权限规则。
💡核心作用:当您的代理频繁执行常见的文件和搜索操作时,请使用此功能。主要的权衡在于灵活性:专用工具无法覆盖所有边缘情况,因此您仍需备有一套通用的 Shell 作为备用方案。
类别四:自动化(Automation)
最后一种模式之所以独立存在,是因为它贯穿了所有其他类别。它所解决的问题同样适用于记忆、工作流和工具:模型无法可靠地记住那些必须每次都执行的程序性步骤。
确定性生命周期钩子模式(Deterministic Lifecycle Hooks Pattern)
有些操作必须每次都无一例外地执行:每次编辑后运行格式化程序、在执行命令前进行验证、以及当工作目录发生变化时重新加载配置。依赖模型通过提示指令来记住这些操作是不可靠的。模型会根据上下文压力而遗忘、跳过或重新解释指令。
🧠
此模式会在代理生命周期的特定节点自动执行命令或其他操作,完全无需用户干预。凡是每次都需要执行的操作,都应放在钩子中,而非直接写在指令里。
💡核心作用:当您遇到一些不应被跳过的固定行为时,请使用此选项。其主要权衡在于调试难度:当钩子中出现异常时,由于钩子是在对话之外执行的,排查问题往往比处理提示级别的指令更为困难。