工具选择策略:LLM 如何决定使用哪个工具?
难度:中级 分类:Tool Use
简短回答
LLM 选择工具的核心机制是将用户意图与工具描述做语义匹配。主要策略有:描述驱动选择(LLM 读取工具 description 自行判断,最常用)、Function Calling 结构化选择(通过 API 的 tools 参数让模型选择)、Embedding 检索选择(工具数量多时用 RAG 检索相关工具)、训练式路由(用分类器或微调模型做工具路由,适合规模化场景)。工具描述的质量是选择准确率的第一影响因素。
详细解析
LLM 的工具选择过程
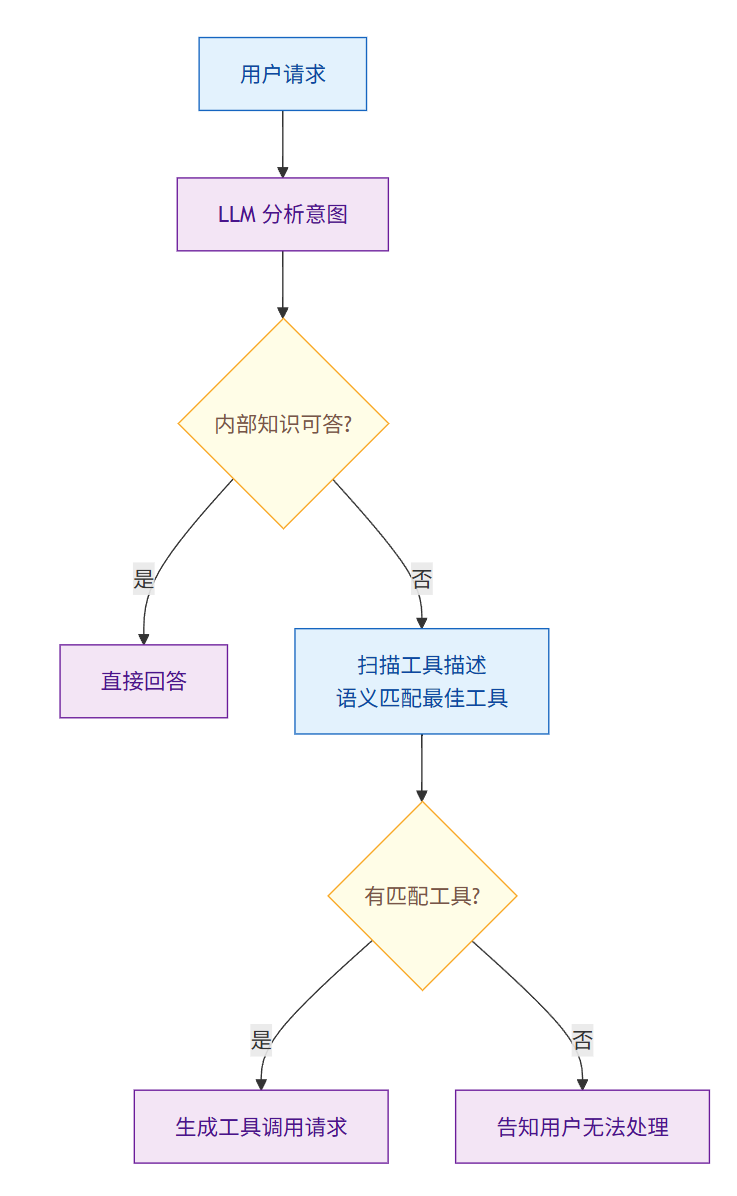
工具选择是一次三路决策:内部知识可答则直答,语义匹配到工具则生成调用,否则坦白无法处理。
Agent 的"大脑"(LLM)负责工具选择逻辑。这不是魔法,而是基于 Prompt 中的指令和工具描述做模式匹配和推理。
策略 1:描述驱动选择(最基础)
LLM 在 System Prompt 中看到所有工具的列表和描述,自行判断使用哪个。
代码块
Python
system_prompt = """你可以使用以下工具:
1. search_docs: 搜索产品文档,包括API文档和用户指南。
当用户问产品功能或技术问题时使用。
优化工具描述的关键原则:
•
说明做什么(功能)
•
说明什么时候用(触发条件)
•
说明什么时候不用(排除条件)
•
与相似工具做区分
代码块
Python
# 差:模糊的描述
"description": "搜索数据"
# 好:精确的描述 + 使用/排除条件
"description": (
"搜索产品知识库中的技术文档和API参考。"
"当用户询问产品功能、配置方法或错误代码含义时使用。"
"不适用于搜索订单信息(用 query_orders)或用户账户(用 get_profile)。"
)
策略 2:Function Calling 结构化选择
通过 API 原生的 tools 参数,让模型进行结构化选择:
代码块
JSON
response = client.messages.create(
model="claude-sonnet-4-5-20250929",
tool_choice 选项:
•
auto:模型自主决定是否使用工具(默认)
•
required:模型必须选择至少一个工具
•
{"type": "tool", "name": "X"}:强制使用特定工具
•
none:禁止使用工具
策略 3:Embedding 检索选择(工具多时)
当工具数量超过 50 个,把所有工具塞进 System Prompt 会浪费上下文窗口且降低选择准确率。用 RAG 方式动态检索相关工具:
代码块
Python
class ToolRetriever:
def __init__(self, tools: list[dict]):
# 将工具描述嵌入向量空间
self.tool_embeddings = embed([t["description"] for t in tools])
self.tools = tools
def get_relevant_tools(self, query: str, top_k: int = 5) -> list[dict]:
"""基于查询语义检索最相关的工具"""
query_embedding = embed(query)
similarities = cosine_similarity(query_embedding, self.tool_embeddings)
top_indices = similarities.argsort()[-top_k:][::-1]
return [self.tools[i] for i in top_indices]
# 使用流程
relevant_tools = retriever.get_relevant_tools(user_query, top_k=5)
# 只将 top-5 相关工具传入 LLM
response = llm.generate(query=user_query, tools=relevant_tools)
优势: 100+ 工具时不会溢出上下文窗口,减少"选择困难"。
策略 4:分层选择(两阶段路由)
代码块
Python
# 第一阶段:LLM 选择工具类别
categories = {
"customer_service": ["query_orders", "create_ticket", "get_profile"],
"product_info": ["search_docs", "get_pricing", "check_compatibility"],
"billing": ["get_invoice", "process_refund", "update_payment"],
}
# 先让 LLM 选类别
category = llm.classify(query, list(categories.keys()))
# 第二阶段:在类别内选择具体工具
tools_in_category = categories[category]
selected_tool = llm.select_tool(query, tools_in_category)
策略 5:训练式路由(规模化方案)
LLM 路由在早期灵活但规模化后低效——每次选择都需要 LLM 推理。训练一个专用分类器做路由更高效:
代码块
Plain Text
# 训练一个轻量级分类器做工具路由
from sklearn.ensemble import GradientBoostingClassifier
# 训练数据:(用户查询, 正确的工具)
X_train = embed(queries)
y_train = tool_labels
router = GradientBoostingClassifier()
router.fit(X_train, y_train)
# 推理:毫秒级路由,不需要 LLM
predicted_tool = router.predict(embed(new_query))
适用场景: 高并发、成本敏感的生产环境,工具选择模式已经稳定。
处理歧义和降级
代码块
Python
class ToolSelector:
def select(self, query: str, tools: list) -> str:
scores = self.score_tools(query, tools)
if max(scores.values()) < 0.3:
# 没有工具匹配 → 直接用 LLM 回答
return None
if scores[first] - scores[second] < 0.1:
# 两个工具分数接近 → 让 LLM 结合推理选择
return self.llm_tiebreak(query, top_2_tools)
return max(scores, key=scores.get)
各策略对比
常见误区 / 面试追问
误区:"工具名称是选择的关键" — 描述才是关键。LLM 主要靠 description 理解工具的用途和适用场景。名称只是标识符。
误区:"工具越多越好" — 工具过多会增加选择错误率、消耗上下文窗口、增加延迟。从 1-2 个工具开始逐步增加,确保每个工具的描述清晰且不重叠。
追问:"如何评估工具选择的准确率?" — 构建测试集:N 个用户查询 + 对应的正确工具。运行后计算选择准确率。低于 90% 就需要优化描述或调整策略。
追问:"ReAct 框架如何影响工具选择?" — ReAct 在工具选择前加了显式的"Thought"步骤,让 LLM 先推理为什么需要这个工具再调用。这提高了选择的可解释性和准确性。