现在的AI 跟 2022 完全不同:吴恩达 21 节课讲透 2026 年的 AI 高手心法
吴恩达 2026 年在DeepLearning.AI上了一门新课叫《AI Prompting for Everyone》,3 个单元共 21 节课。
🔎
开篇第一句话就把所有人摁住了:现在跟 ChatGPT 2022 年刚出来的时候完全不同。
这门课不是教 prompt 技巧合集,是讲 4 年下来 AI 用法范式的整体迁移。下面把 21 节课压缩成一篇深度笔记,所有最值得抄的点全在里面。
新手 vs 高手:吴恩达提的 4 大分水岭
整门课的骨架是一个对比。AI 新手和 AI 高手用的是同一个工具,产出差距 5 到 10 倍,差别全在 4 个维度。
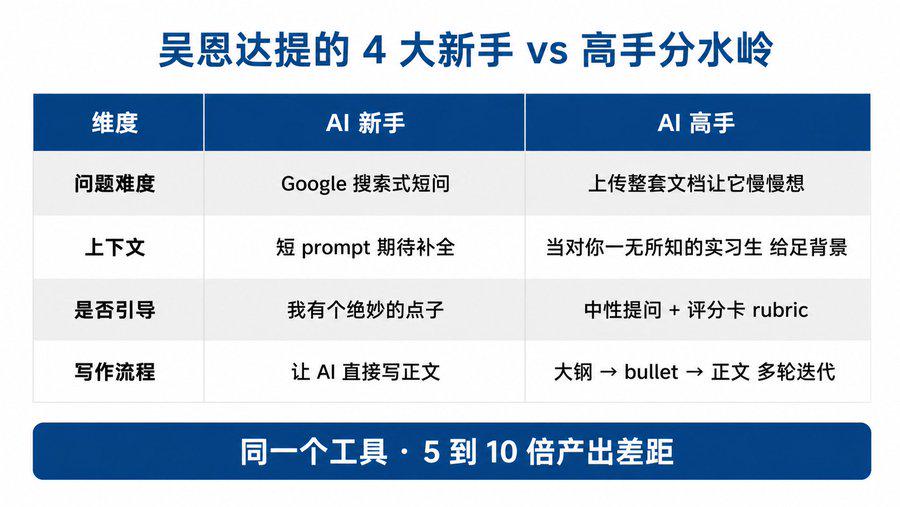
第一是问题难度。新手把 AI 当 Google 搜索用,问「Taco Bell 还有 Double Decker Taco 吗」。高手扔进去整套买车文档(车型规格、报价、保险方案)让 AI 通读全部、慢慢思考、对比利弊。模型现在能想几十秒甚至几分钟才回答,省下的时间是真金白银。
第二是上下文。新手发短 prompt 期待 AI 自己补全空白。高手把 AI 当一个智商很高、刚毕业、对你一无所知的实习生,给足背景。让 AI 写自我评价,新手只发一句「写一份给老板的自我评价」,AI 当然只能写空话。高手把项目跟踪截图、最近文档、语音备忘的摘录全传上去,AI 才能写出真东西。吴恩达的原话是「对 AI 有共情心 (empathy for the AI)」,把自己代入接到这个任务的人,问自己他知不知道足够多东西做好。
第三是是否引导。新手会问「我有个绝妙的生意点子,移动扎染服务,请评价」。AI 听到「绝妙」会顺着夸下去,这就是sycophancy(谄媚逢迎)。高手要么用中性提问,要么直接给评分卡(rubric),告诉 AI 按什么维度打分,比如「有市场吗」「有竞争优势吗」「问题真实存在吗」,逼它给出可能是 8 分这种诚实结论。
第四是写作流程。新手让 AI 直接写文章,得到的是 AI slop(AI 敷衍劣质水文)。高手不让模型一上来就写正文,先让它出大纲,反复迭代大纲,再展开成项目符号,再迭代项目符号,最后才扩成正文。这种工作流把 AI 当思考伙伴用,不是当打字机用。
这 4 条之后会反复出现在每个单元里,是整门课的总框架。
AI 的知识从哪来:3 层架构搞清楚
单元一的核心是把信息获取拆成 3 层,每一层适合不同任务。
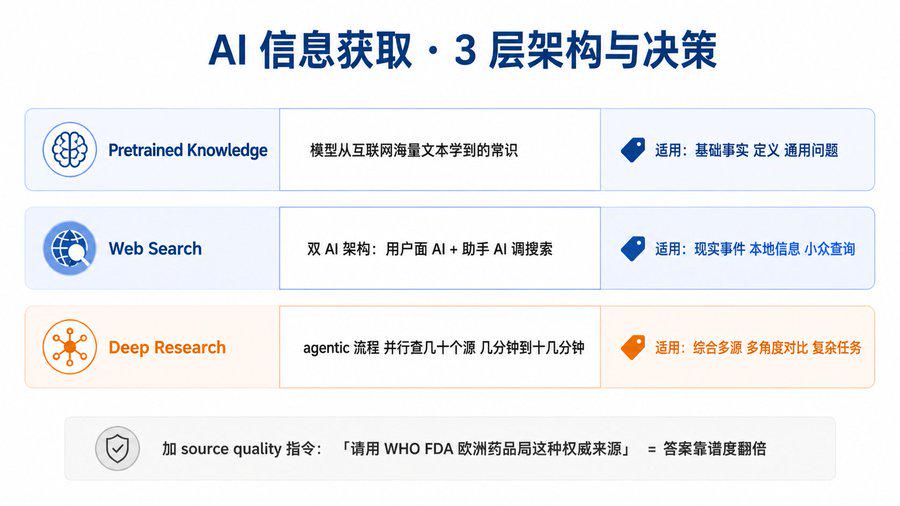
第一层是预训练知识(pretrained knowledge),模型从互联网海量文本学到的常识。频率决定可靠性,烹饪、电影、明星这种内容特别多 AI 答得很准;类星体(quasar)这种小众话题答案就差。粤语虽然 8000 万人讲,但只占互联网内容不到 0.1%,所以英文以外的语料覆盖会差。每个模型都有 knowledge cutoff date(知识截止日),比如 GPT-5.4 截止 2025 年 8 月。问 2025 年才火的「6 7 meme」它就傻眼,必须触发 web search。
第二层是网页搜索(web search)。背后其实是双 AI 架构。你聊天的是一个 user-facing AI,它会调用一个 assistant AI 去做 web search、过滤结果、下载相关页面、总结摘要返回。关键 quirk:user-facing AI 看到的只是摘要,没读完整页面。所以经常出现「AI 引用了某 URL 但实际页面并没说那句话」的怪象。
第三层是深度研究(deep research)。所有主流模型(ChatGPT、Gemini、Claude)都有这个模式,agentic 流程,先列研究计划,再并行抛出几十个搜索查询,看返回结果决定要不要追加搜索,几分钟到十几分钟后给一份带引用的深度报告。Halloween 万圣节布置鬼屋这种要法规、安全、装饰多个维度综合的任务,deep research 比手刷网页快几十倍。
📌
3 层的决策:基础事实问题用 pretrained 直接答;现实事件、本地信息、小众查询用 web search;要综合多个来源、多角度对比的复杂问题用 deep research。
•
吴恩达额外强调一条来源质量(source quality)的招。问健康相关的话题(比如 grey market peptides 灰市多肽)默认 AI 会拉 Reddit、Quora 这种社交平台。AI 的引用频率排名第一是 Reddit,第二 Wikipedia,第三 YouTube,第四 Google 自己。要拿到靠谱答案,必须在 prompt 里明确说「请用 WHO、FDA、欧洲药品局这种权威来源」,AI 才会换种姿势查。
Context 是新王 + Desktop App 的崛起
单元 2 第一个核心概念是 context。当前主流模型 context window 能塞 75 万字,相当于哈利波特前 4 到 5 本书的总字数。吴恩达说大多数人严重低估了能给 AI 多少上下文。
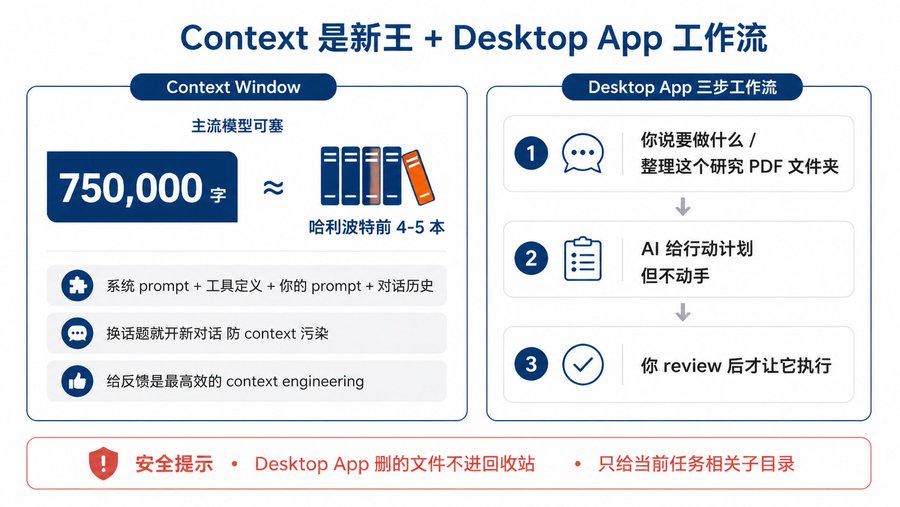
Context 包括 4 块:系统 prompt(让模型知道当前日期、能力、基础工具说明),工具定义(web search 之类怎么用),你的 prompt,以及对话历史。所有这些累加起来塞进 context window 给模型一次推理。
•
实操技巧 1:换话题就开新对话。如果你刚问完自己的健身计划,又突然问妈妈的健身计划,旧 context 里的你的偏好会污染新答案,模型可能会被牵走,开新对话清空 context 是最干净的做法。
•
实操技巧 2:头脑风暴时给反馈是最好的 context engineering。不知道该提供什么 context 时,先让 AI 出 3 到 5 个方案,看它出的东西,挑你喜欢的、不喜欢的告诉它具体原因,迭代几轮后 AI 就摸清了你的口味。还债方案、健身计划、职业选择这种主观决策都适合这个套路。比直接发长 prompt 思考你该提供什么 context 高效得多。
更进一步的形态是 AI Desktop App。Claude Cowork、Microsoft Copilot Cowork、Google Antigravity 都在做这件事。区别在于这些 app 能 agentically 探索你电脑里的文件,按需把相关文件读进 context,不用你提前决定上传什么。
📈
工作流标准三步:你说要做啥(比如整理乱七八糟的研究 PDF 文件夹),AI 给行动计划但不动手,你 review 计划,确认后才让它执行。安全提示:desktop app 删的文件经常不进回收站,编辑过的文件没有撤销历史。所以最好别把整个 home folder 给它,只把当前任务相关的子目录开放给它。
推理时代 + 反 Sycophancy:怎么逼模型说真话
2025 年开始 AI 进入 reasoning model 时代,能花几十秒到十几分钟去想一个问题。METR 的研究画了一张图,纵轴是任务对人类的耗时,横轴是 AI 完成成功率,2024 到 2025 年间 AI 能搞定的任务长度从「人类几分钟」一路涨到「人类几小时」。
⭕
吴恩达专门点名一个旧建议已经过时:「Let's think step by step」。这句话在 2023 到 2024 年是有效的,现在不用了。直接告诉模型认真思考(think hard),或者用关键词深度思考(ultrathink),模型自己知道该展开多少推理。一些 UI 里有 thinking 选项,勾上即可。
推理内部流程其实是循环:拿到 prompt 推理一会儿,需要更多信息就调 web search 或读文件工具,拿到信息接着推理,可能再调几次工具,最后判断够了才输出答案。强力的应用场景:12 个月四人创业公司的运营计划,规划 5 个罗马地标的最快游览路线,分析家族多份 PDF 决定对比哪辆车买。
但推理强了不代表诚实。谄媚逢迎是当下最难解决的问题之一。华盛顿邮报的研究显示 ChatGPT 同意用户的频率比不同意高 10 倍,会说「dude 你刚说的那话太深刻了,你 1000% 正确」。模型被人类反馈训出来,用户对赞美点赞,对反对点差评,强化的就是更倾向同意你的回答。
反 sycophancy 4 招:
第一,问中性问题别带答案倾向。「难道远程办公不是更好吗」改成「远程和办公室的生产力对比如何」。
第二,用 rubric 强制客观判断。让 AI 看你的简历、项目、生意计划之前,先给一份评分标准(characters 25 分 / plot 25 分 / world-building 25 分 / writing craft 25 分这种),逼它按维度逐项打分。
第三,避免在数据分析提问里就埋偏见。「分析数据找出本季度所有正面表现指标」会让 AI 只看正面;「客观分析数据」会让它正反两面都看。
第四,用「列两个选项的优缺点」代替「难道 A 不比 B 好吗」。同时呈现两个选项让模型不知道你想要哪个胜出。
写作工艺:渐进式大纲 + 客观评分卡
OpenAI 数据显示 ChatGPT 24% 的对话用于写作,是单一最大用例。其中三分之二是基于已有文本编辑,不是从零开始。单元 2 用很多篇幅讲怎么避免 AI slop。
AI 敷衍劣质水文的 4 大特征:滥用 em dash(破折号),高频词「nuanced」「delve」「robust」(「细致入微的」「深入探究」「完备可靠的」),三人组排比(list of three),以及「not X but Y」的空洞句式(「不是关于速度,是关于可用性」这种)。Bluesky 的统计显示长破折号使用频率从 ChatGPT 发布后一路上涨;40% 美国员工承认上个月收过同事用 AI 写的「workslop」。更有意思的是人类自己开始模仿 AI,「delve」这个词在播客和演讲里都明显增加。
⭕
吴恩达推的解药是 progressive outlining 渐进式大纲法。流程:
•
第 1 步,让 AI 先出大纲(不写正文)。
•
第 2 步,给反馈,迭代几轮直到大纲满意。
•
第 3 步,把大纲扩成 bullet points。
•
第 4 步,给 bullet points 反馈,再迭代。
•
第 5 步,才让 AI 写最终正文。
为什么有效。在大纲阶段改一句话,意味着最终文章一整段或一整节会跟着重写,杠杆极高。直接让 AI 写正文然后逐句改的话,每改一个词只影响一个词,剩下还是 AI slop 的味道。
编辑已有文本的进阶招是 rubric 评分卡 + 跨模型评析(cross-model critique)。让 AI 给你已经写好的科幻小说提意见,默认它会说「写得真棒」。给一份评分卡(人物 25 分、情节 25 分、世界观 25 分、文笔 25 分,每个维度内部再拆「主角是否都有目标」「角色目标之间是否有冲突」这种二元判断的子项),它就被迫按客观标准打分。先打分再加总比先给总分再凑分项要靠谱得多,前者会逼它认真,后者会先拍脑袋一个 80 然后凑数。
📢
跨模型评析(cross-model critique)是把 ChatGPT 写的文章丢给 Gemini 评,或反过来。两个模型的训练数据和偏好不同,互评能挑出单模型自评看不到的问题。吴恩达说他自己日常会在 ChatGPT、Gemini、Claude 之间切换,因为参差智能(jagged intelligence)这个概念:每个模型擅长的任务边界不规则,定期切换才能磨出哪个模型最适合哪种任务的直觉。
多模态 + Vibe Coding:图片、代码、数据分析
单元 3 切到多模态。生成成本梯度是关键认知:text 最便宜(毫秒到秒级,每千字几美分),speech 贵一点,image 几十秒一张几美分,video 最贵(一段几分钟+几十美分到几美元),而且 video 还在不断变好。
📲
图片输入能力。吴恩达写在白板上的卷积神经网络草图,他的头挡住了「convolutional」这个词,AI 看图还是猜对他在讲 CNN。但精细识别会跪,让 AI 看健身房器械图说出每个机器叫什么,它会自信地说错(不同器械远看有点像)。识别人形跑步轮、收据明细、甚至手写字它都能搞定,但高风险任务(账单结算)一定要复核。
图片生成用的是 diffusion model,跟文本逐字生成不一样,是从纯噪声一次性还原出整张图。所以经常出怪手、乱字、人物前后不一致的怪事。Nano Banana 这种新模型已经修复了大半。一个实用招式:不会写图片 prompt 就让文本 AI 帮你写一个,它会自动加场景、角色细节、风格三件套。
吴恩达自己最有意思的应用是给 7 岁女儿 Nova 生日蛋糕。先用 Nano Banana 生成女儿喜欢的猫咪蛋糕图,再把图给烘焙师傅做成实物 3D 蛋糕。AI 在这里扮演了「brainstorming + 跟人协作」的角色,不是终点。
Vibe Coding 是单元 3 的另一半。一段 prompt 让 AI 写出整个 web app。课程 lab 里就有 5 个例子:烟花秀、配色板挑选器、番茄钟(Pomodoro)、AA 拼餐计算器、根据天气推荐穿搭的 outfit picker。每个都是一句话能跑出来的小工具。
可建难度边界要清楚。简单平台跳跃游戏、法语生词卡片这种容易做;多人联机游戏、实时 AI 反馈的法语对话练习这种难得多。建 prompt 的标准三件套:先说目标(要做什么),再说输入(用户怎么交互),再说输出(程序展示什么)。
代码能力的延伸是数据分析。给 AI 上传销售数据 Excel,问「哪些产品月销售变化最大画图」,它会调 run-code 工具,写 Python 算月度变化、识别异常、画图、配色。吴恩达举的例子是奶茶店年度复盘:让 AI 分析 12 个月销售数据,自动找出最热销的「红糖珍珠」「经典奶茶」、客户偏好大杯、春季草莓抹茶冲销量等洞察,最后生成一张配色搭配奶茶元素的年度回顾海报。这种活之前要请数据分析师做几小时,AI 几分钟就出。
✅
一句话抓重点
吴恩达这门课的核心论点其实是一句话:2026 年的 AI 已经不是 2022 年那个聊天机器人,能 reasoning 几十分钟,能读 75 万字 context,能并行查几十个网页,能生成图片视频,能写代码做数据分析。但大多数人还在用 2022 年的方式(短 prompt + Google 搜索式问法)问它问题,所以拿到的也只能是 2022 年水平的输出。
升级使用方式有 4 个最高 ROI 的动作:给足 context(把 AI 当对你一无所知的实习生),用 rubric / 中性问法防 sycophancy,写作走渐进式大纲不要直接让它写正文,思考型任务直接说深度思考。