技能资产化闭环:让经验沉淀为可复用 Skill
在 Agent Skills 生态里,SKILL.md 不只是一个说明文件,它可以成为 Agent 的程序性记忆:什么时候使用、如何执行、调用哪些脚本、遵守哪些约束、如何处理异常。技能层自进化的关键,就是让这些技能不再只靠人工维护,而是能被评估、改写、验证和回滚。
Darwin Skill:用评测和 ratchet 机制优化 Skill
下面从 Darwin Skill 切入第二类闭环:SKILL.md 被明确当成可被度量、被迭代的资产。Darwin Skill 面向 SKILL 优化的主张可以概括为「像训练模型一样优化你的 Agent Skills」,方法论直接对齐 Karpathy 的 autoresearch:用可量化目标驱动改动,并用 棘轮(ratchet) 只保留可验证的增益,其余 git revert 掉,避免基线随时间悄悄变差。
机制上拆成几条硬原则:单一可编辑资产(一次只改一个待优化的 SKILL.md)、双重评估(结构侧偏静态分析,效果侧要在测试提示上跑起来看输出)、独立评分(用子 Agent 打分,减轻「自改自评」)、人在回路(阶段之间暂停,展示 diff 与分数变化后再继续)。效果验证侧会用到诸如 test-prompts.json 一类的测试集;总分 100 来自 八维 rubric,其中结构维度与效果维度分值配比写得很清楚(效果里「实测表现」权重最高)。
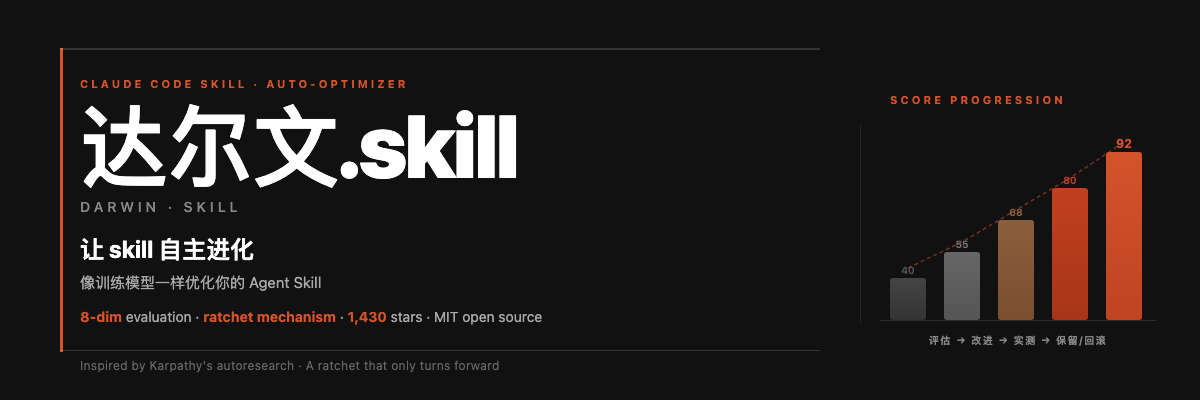
图 4 Darwin Skill
下图与其 Core Loop 一致,对应 Evaluate → Improve → Validate → Confirm → Keep or Revert。
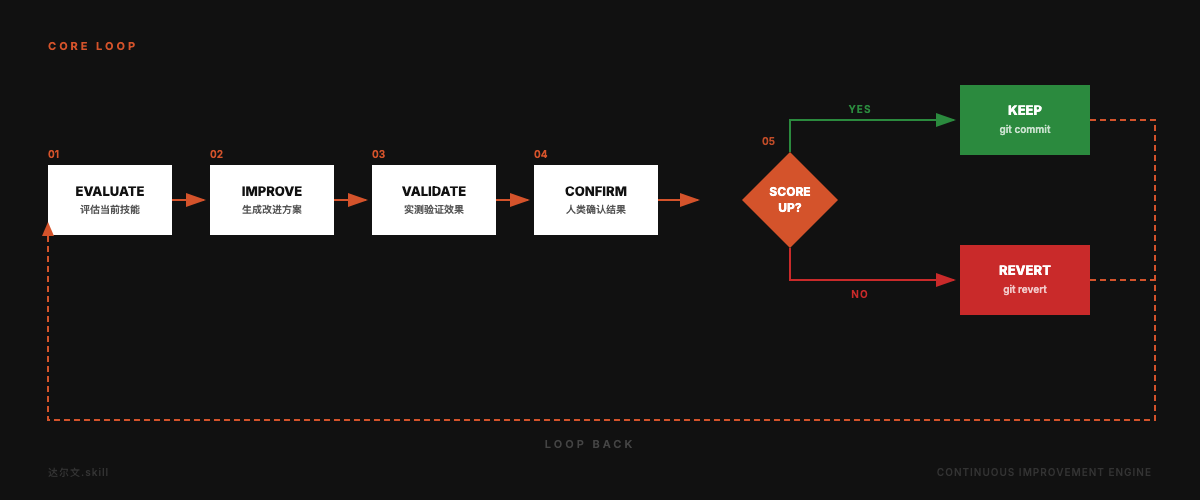
图 5 Darwin Skill:Evaluate → Improve → Validate → Confirm → Keep or Revert 闭环
这套流程可以拆成五步:
Evaluate:对目标 SKILL.md 做结构分析与效果验证,汇总为八维加权分。
Improve:找出得分最低的维度,生成一轮针对性改写并提交改动。
Validate:在测试提示集(如 test-prompts.json)或等价真实任务上复测。
Confirm:展示 diff 与分数变化,由人确认是否进入下一轮或下一个 Skill。
Keep or Revert:新总分高于当前最优则保留,否则回滚;棘轮保证有效基线单调不降。
八维 rubric 把总分拆到多个维度(结构侧与效果侧分值配比见示意图);「实测表现」在效果维度里权重最高。
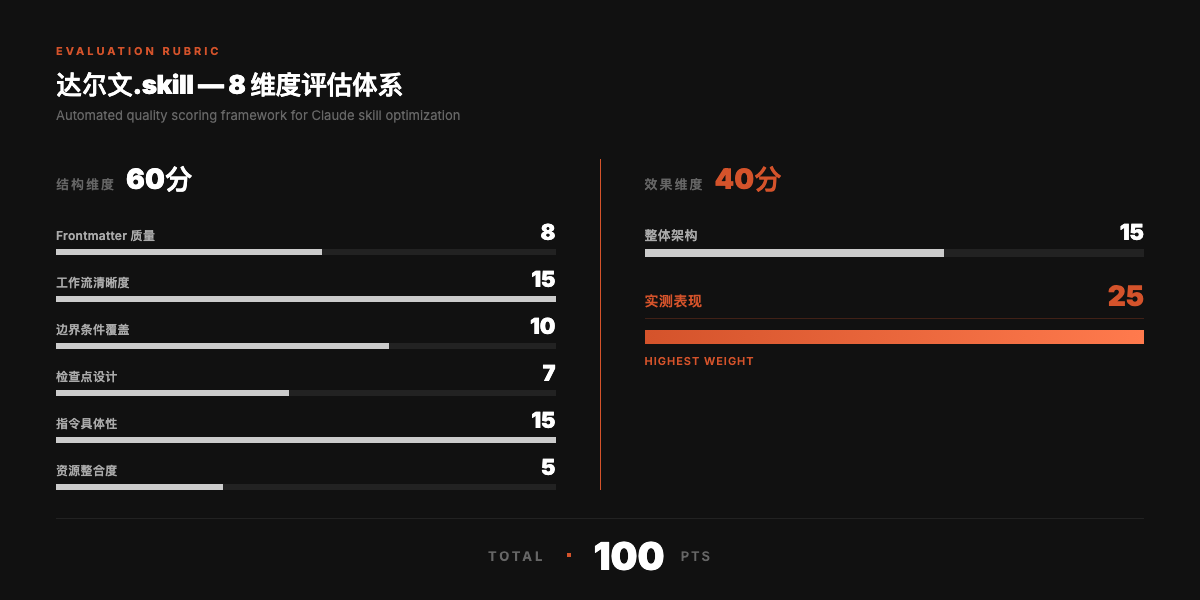
图 6 Darwin Skill:八维评分体系(总分 100)
Darwin Skill 最重要的设计不是「自动改技能」,而是只让可验证的改进留下来。凡兼容开放 Agent Skill / SKILL.md 宿主的工具链都可接入,包括 Claude Code、Codex、OpenClaw、Trae、CodeBuddy 等;Darwin Skill 在其中扮演相对独立的技能优化器角色。
JiuwenClaw:运行时技能自演化
JiuwenClaw 面向长期陪伴式使用的标语是「Understands You. Evolves With You」:Autonomous Evolution 即在不满或执行出错时依反馈持续改进相关技能。实现上依靠 SkillCallOperator 统领读写与合并,连同 SignalDetector(基于规则、不调用 LLM)监视工具结果与用户措辞里的纠错线索;可归因到当前技能的事件交给 SkillEvolutionManager 编排扫描与生成,SkillOptimizer 在需要改动时调用 LLM 写出演进条目,先入 evolutions.json,再在合适时机 solidify 合并回 SKILL.md,也可通过 /evolve 手动触发。失败类信号偏向写入 Troubleshooting 一类小节,用户纠正则更常被整理成 Examples。每条技能在 workspace 下自有目录(典型路径形如 ~/.jiuwenclaw/workspace/agent/skills/<skill_name>/),配置里可开启 evolution_auto_scan,工具回合结束后也可能在后台追加演进记录。
从分类上看,它仍然最适合归入技能资产化闭环:持久增量落在 SKILL.md 与 evolutions.json,而不是一次性的对话摘要。
图 7 JiuwenClaw:项目概览与运行时技能自演化语境
与仓库文档中的 Evolution flow 对齐的一条流水线:用户对话或工具执行 → SignalDetector → SkillEvolutionManager → SkillOptimizer → evolutions.json → solidify → SkillCallOperator(后者统一读写并在下一轮调用前加载合并后的 SKILL.md)。
与 Darwin Skill 相比:Darwin 更强调「像训练模型一样」的全套评测、八维打分、棘轮与强人在回路;JiuwenClaw 把演进嵌在日常会话与工具回路里,信号驱动、条目先入 JSON 再固化进文档,工程侧重点在在线可用性与快速迭代。它也免不了与内建上下文闭环交叉(同一轮对话里就要检测反馈),但本章仍以技能资产为主标签,因为可审计的长期增量主要在技能文件与演进记录里。
EvoSkill:从失败轨迹中演化技能变体
EvoSkill 面向 coding agent 的自动技能发现与改进:在仓库语境里,它把 GEPA 那种「靠反馈改一处 prompt」的思路,扩展成对 整套 agent program 的迭代(可同时提议多条 skill 与 system prompt 变异),在 留出验证集 上打分,每一轮优秀候选会以 全新程序状态 进入下一轮,而不是只在原地补丁一段话。
自助回路在文档里被拆成五段:Base Agent 用当前最优配置跑基准里的样本;Proposer 对照失败样例提出针对性改动;Generator 写出新的技能文件或改写系统提示;Evaluator 在 held-out 数据上给新版本打分;Frontier 维护表现最好的 Top-N 套程序,并以 program/* Git 分支形式版本化(另有 frontier/* 标签标记前沿成员),便于 evoskill diff、evoskill skills 审计与回滚。工程上通过 evoskill init / evoskill run 驱动,数据集多为带标准答案的 CSV,可按任务写 .evoskill/task.md,执行模式支持本机、Docker 或 Daytona 远程沙箱;宿主 harness 覆盖 Claude Code、OpenCode、OpenHands、Goose、Codex CLI 等。演进配置里可选 skill_only 或 prompt_only,打分支持规则匹配、LLM-as-judge、脚本等多种 scorer。
图 8 EvoSkill:面向编码 Agent 的技能与提示协同演进框架
与 Darwin Skill 侧重「单一 SKILL.md + 八维棘轮」、JiuwenClaw 侧重在线会话信号不同,EvoSkill 更贴近 离线基准驱动 的「整包 Agent 配置进化」:成败证据来自可重复评测,产出是可拷贝的 skills 目录与 program.yaml 一类制品,适合要把编码助手从通用模型收成 专精流水线 的团队。