01-libero
LIBERO 数据集深度解析:架构、统计与工程实现
1. 概述 (Introduction)
在机器人学习(Robot Learning)领域,LIBERO (Lifelong Learning Benchmark for Robot Manipulation) 是一个具有里程碑意义的基准测试集。它专为研究终身学习(Lifelong Learning)和知识迁移(Knowledge Transfer)而设计。与传统的单一任务数据集不同,LIBERO 旨在评估机器人策略在面对新任务序列时,如何克服“灾难性遗忘”(Catastrophic Forgetting)并利用先验知识加速学习。
本章基于实际的数据探索(EDA),对 LIBERO 数据集的四个核心子集(Suites)进行了详尽的定量与定性分析,并探讨了其在 LeRobot 与 OpenVLA 两种不同训练框架下的数据形态差异。
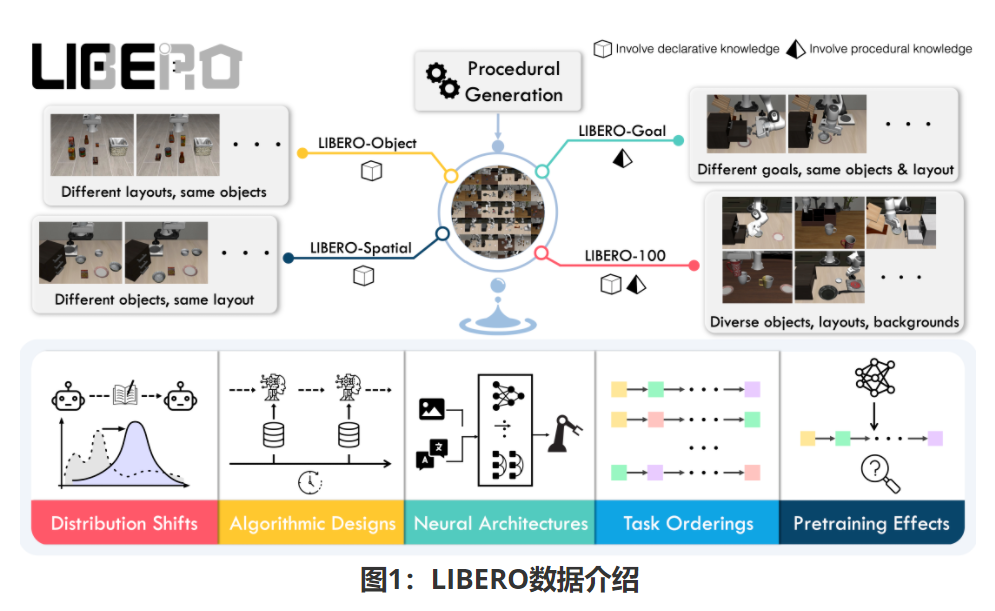
图1:LIBERO数据介绍
2. 数据集架构与任务分类学 (Dataset Architecture & Taxonomy)
LIBERO 数据集并非杂乱无章的任务集合,而是被精心划分为四个具有特定语义目标的任务套件(Task Suites)。每个套件包含 10 个核心任务,旨在测试机器人不同维度的泛化能力。
2.1 LIBERO-Object:物体层面的泛化
•
设计意图:测试机器人对不同物体视觉特征(颜色、形状、纹理)的鲁棒性。
•
核心逻辑:动作序列高度相似(“捡起 X 放入篮子”),但操作对象 发生变化。
•
典型任务:
◦
捡起字母汤罐头 (Alphabet Soup)
◦
捡起奶油芝士 (Cream Cheese)
◦
捡起番茄酱 (Ketchup)
◦
注:所有动作均为 Pick-and-Place,变量仅为物体本身。
2.2 LIBERO-Spatial:空间布局的鲁棒性
•
设计意图:测试机器人在物体相对位置发生变化时的空间感知与规划能力。
•
核心逻辑:操作对象固定(通常是黑色碗),但其初始位置及周围环境(干扰物位置)发生变化。
•
典型任务:
2.3 LIBERO-Goal:目标状态的多样性
•
设计意图:测试机器人完成特定目标状态(State Change)的能力,涉及复杂的交互。
•
核心逻辑:任务目标不再是单一的抓取,而是涉及开合、推拉、放置等多种物理交互。
•
典型任务:
◦
打开橱柜的中间抽屉。
◦
推盘子到炉子前面。
◦
放置酒瓶在酒架上。
◦
叠放:把碗放在盘子上。
2.4 LIBERO-10 (Long-Horizon):长程时序推理
•
设计意图:测试机器人执行长序列、多步骤组合任务的能力。这是最具挑战性的子集。
•
核心逻辑:通常涉及两个或以上的连续动作,或者条件触发动作。
•
典型任务:
◦
把字母汤罐头 和 奶油芝士盒都放进篮子(多物体序列)。
◦
把黑色的碗放进橱柜的底层抽屉 并关上(复杂交互序列)。
◦
打开炉子,然后把摩卡壶放在上面(因果序列)。
3. 定量统计分析 (Quantitative Analysis)
通过对 Parquet 文件的遍历与统计,我们得出了以下精确的数据分布情况。这对于训练时的 Batch Size 设定及 Epoch 规划至关重要。
3.1 总体规模
•
总 Episodes:1,693 个
•
总样本帧数 (Samples/Frames):273,465 帧
•
平均采样率:约 161.5 帧/Episode
3.2 子集详细统计表
| | | | | |
| | | | | |
| | | | | |
| | | | | |
| | | | | |
3.3 数据分布洞察
样本均衡性:除 libero_10 因任务复杂度导致样本量显著较多外,其余三个数据集的样本量保持在 5万-6万 级别,各子任务的 Episodes 数量基本维持在 35-50 个之间。这种均衡性有利于避免模型训练时的过拟合。
时序特征:libero_10 的 267.7 平均步长表明,训练该子集需要模型具备更长的上下文窗口(Context Window)或更强的显存(Memory)管理能力。
4. 数据工程:LeRobot 与 OpenVLA 格式对齐
在实际工程落地中,数据格式的异构性是训练的主要障碍。LIBERO 数据集目前主要存在两种流通格式:面向 HuggingFace 生态的 LeRobot (Parquet) 格式和面向 TensorFlow/Google 生态的 OpenVLA (RLDS/TFRecord) 格式。
4.1 格式对比矩阵
| | | |
| | | |
| | | |
| | | |
| | | |
4.2 数据对齐挑战与解决方案
由分析脚本可知,两者处于 "不兼容" 状态。若要使用 LeRobot 格式的数据微调 OpenVLA 模型,必须执行 ETL (Extract-Transform-Load) 流程:
Extract (提取):利用 Pandas 或 PyArrow 读取 .parquet 文件,解析扁平化的 observation.image 和 action 列。
Transform (转换):
◦
结构重组:将扁平数据重组为 (episode, step) 的层级结构。
◦
类型转换:将图片字节流或 Numpy 数组转换为 TF Feature 格式。
◦
元数据注入:添加 RLDS 必需的 is_first, is_last, reward 等字段。
Load (加载):利用 tf.io.TFRecordWriter 序列化为 .tfrecord 文件,并生成对应的 RLDS 签名文件。
5. 总结 (Conclusion)
LIBERO 数据集通过结构化的任务设计,清晰地解耦了机器人操作中视觉(Object)、空间(Spatial)、交互(Goal)与时序(10/Long-Horizon)四个维度的挑战。
•
对于算法研究者:LIBERO 提供了评估模型在特定能力上短板的绝佳标尺(例如,模型能做好 Object 任务但做不好 Spatial 任务,说明其空间注意力机制存在缺陷)。
•
对于工程开发者:理解 LeRobot 与 OpenVLA 格式的差异是构建高效数据流水线(Data Pipeline)的前提。libero_10 显著增加的序列长度也提醒我们在模型部署时需关注推理延时和显存占用。
附件:Libero数据集统计分析报告及分析代码
代码块
Python
#!/usr/bin/env python3
"""
分析Libero数据集,统计每个大任务下的小任务数量和样本数量
"""
import pandas as pd
上面的是lerobot格式的数据分析
下面的是openvla格式的
代码块
Python
#!/usr/bin/env python3
"""
分析Libero数据集,统计每个大任务下的小任务数量和样本数量
"""
import os
import tensorflow_datasets as tfds
import tensorflow as tf
def analyze_dataset(dataset_path):
"""
Analyzes a single dataset to extract unique language instructions using tfds.
"""
try:
# Suppress verbose logging
tf.get_logger().setLevel('ERROR')
builder = tfds.builder_from_directory(builder_dir=dataset_path)
数据集概况
本次分析了4个Libero数据集,每个数据集都包含10个不同的任务类型(task_0到task_9)。
详细统计结果
1. libero_10_no_noops_lerobot_v21
•
总Episode数量: 379
•
总样本数量: 101,469
•
平均每Episode样本数: 267.7
•
任务类型数量: 10个任务
各任务详细统计:
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
2. libero_goal_no_noops_lerobot_v21
•
总Episode数量: 428
•
总样本数量: 52,042
•
平均每Episode样本数: 121.6
•
任务类型数量: 10个任务
各任务详细统计:
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
3. libero_object_no_noops_lerobot_v21
•
总Episode数量: 454
•
总样本数量: 66,984
•
平均每Episode样本数: 147.5
•
任务类型数量: 10个任务
各任务详细统计:
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
4. libero_spatial_no_noops_lerobot_v21
•
总Episode数量: 432
•
总样本数量: 52,970
•
平均每Episode样本数: 122.6
•
任务类型数量: 10个任务
各任务详细统计:
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
总体汇总
| | | | |
| | | | |
| | | | |
| | | | |
| | | | |
| | | | |
主要发现
数据集结构统一: 所有4个数据集都包含10个任务类型(task_0到task_9)
样本数量差异: libero_10数据集的样本数量最多(101,469),其次是libero_object(66,984)
Episode长度差异: libero_10的平均Episode长度最长(267.7),libero_goal和libero_spatial的Episode相对较短(约122)
任务分布: 各数据集内的任务分布相对均匀,每个任务大约有30-50个episodes
数据规模: 总共包含1,693个episodes,273,465个样本点
数据特点
•
数据格式: 所有数据都以parquet格式存储,每个episode一个文件
•
数据结构: 每个样本包含observation.state、action、timestamp等字段
•
任务标识: 通过task_index字段标识不同的任务类型
•
时序性: 每个episode代表一个完整的任务执行序列
lerobot和openvla数据对齐性讨论
代码块
Plain Text
详细task分析
这个 openvla 格式的 libero 数据集分为4个大类任务,每个大类下正好包含10个不同的子任务。
详细分析结果
1. libero_object_no_noops
这个类别主要关注于拾取特定物品并将其放入篮子。
•
子任务列表:
a.
捡起字母汤罐头并放入篮子。
b.
捡起烧烤酱并放入篮子。
c.
捡起黄油并放入篮子。
d.
捡起巧克力布丁并放入篮子。
e.
捡起奶油芝士并放入篮子。
f.
捡起番茄酱并放入篮子。
2. libero_goal_no_noops
这个类别主要关注于实现特定的目标状态,例如开关抽屉、放置物品到特定位置等。
•
子任务列表:
a.
打开橱柜的中间抽屉。
b.
打开顶层抽屉,把碗放进去。
c.
把盘子推到炉子前面。
d.
把碗放在盘子上。
e.
把碗放在炉子上。
f.
把碗放在橱柜顶部。
g.
把奶油芝士放进碗里。
3. libero_10_no_noops
这个类别包含了一系列组合任务,需要同时操作多个物品。
•
子任务列表:
a.
捡起书并将其放入球童的后隔间。
b.
把两个摩卡壶都放在炉子上。
c.
把字母汤罐头和奶油芝士盒都放进篮子。
d.
把字母汤罐头和番茄酱都放进篮子。
e.
把奶油芝士盒和黄油都放进篮子。
f.
把黑色的碗放进橱柜的底层抽屉并关上。
g.
把白色的杯子放在左边的盘子上,把黄白色的杯子放在右边的盘子上。
4. libero_spatial_no_noops
这个类别主要关注于空间关系,即根据物品之间的相对位置来执行操作。
•
子任务列表:
a.
从盘子和模子之间捡起黑碗,然后放在盘子上。
b.
从桌子中央捡起黑碗,然后放在盘子上。
c.
从木柜顶层抽屉里捡起黑碗,然后放在盘子上。
d.
从饼干盒旁边捡起黑碗,然后放在盘子上。
e.
从盘子旁边捡起黑碗,然后放在盘子上。
f.
从模子旁边捡起黑碗,然后放在盘子上。
g.
从饼干盒上捡起黑碗,然后放在盘子上。
h.
从模子上捡起黑碗,然后放在盘子上。