第八节 分析数据集并生成报告
入门提示
代码块
Markdown
我正在这个工作空间开展一项数据分析项目。
目标:
- 探究靠近高速公路的房屋是否具有较低的房产估值。
首先:
- 阅读`AGENTS.md`文件,说明推荐的Python环境
- 加载位于[数据集路径]的数据集
- 说明每个文件的内容、可能的连接键以及明显的数据质量问题
- 提出一个可复现的工作流程,涵盖数据导入与整理、可视化、建模及报告输出等环节
约束条件:
- 更倾向于使用脚本和保存的成果,而非一次性笔记本状态
- 不得凭空生成缺失值或随意合并键
- 如有必要,建议补充相关技能或划分工作树,以提升工作流程的可复现性
输出内容:
- 环境搭建方案
- 数据清单
- 分析计划
- 首批需要创建的命令或文件
明确您的使用场景
请选择一个您希望用数据回答的具体问题。
问题越具体越好。这将有助于Codex了解您的目标,以及如何协助您达成目标。
运行示例:高速公路附近的属性值
作为示例,我们将探讨以下问题:
靠近高速公路的房屋在房产估值方面会低多少?
假设一个数据集包含房产价值或成交价格,而另一个数据集则包含位置、地块或与高速公路的距离等信息。这项工作不仅仅是运行一个模型,更重要的是确保输入数据的可信度,对数据连接过程进行详细记录,对结果进行压力测试,并最终产出一份可供他人使用的成果物。
搭建环境
在启动新的数据分析项目时,您需要搭建环境并明确项目的各项规则。
•
环境:Codex 应当了解该项目的 Python 环境、包管理器、文件夹结构以及输出规范等标准配置。
•
技能:诸如笔记本清理、电子表格导出或最终报告打包等重复性工作流程,应转化为可复用的技能,而非在每个提示中重新说明。
•
工作树:将不同的探索分别置于独立的工作树中,以避免某一假设、合并策略或可视化分支相互干扰。
如需了解有关如何安装和使用技能的更多信息,请参阅我们的技能文档.
引导Codex的行为
在接触数据之前,请告知 Codex 在仓库中的行为规范。将个人默认设置放在~/.codex/AGENTS.md,并将项目规则放置于仓库中AGENTS.md.
一个小AGENTS.md往往就足够了:
代码块
Markdown
## Data analysis defaults
- Use `uv run` or the project's existing Python environment.
- Keep source data in `data/raw/` and write cleaned data to `data/processed/`.
- Put exploratory notebooks in `analysis/` and final artifacts in `output/`.
- Never overwrite raw files.
- Prefer scripts or checked-in notebooks over unnamed scratch cells.
- Before merging datasets, report candidate keys, null rates, and join coverage.
如果该代码仓库尚未定义 Python 环境,请让 Codex 创建一个可复现的环境,并说明如何运行该项目。对于数据分析工作,这一步比直接绘制图表更为重要。
导入数据
通常,最快捷的入门方式就是粘贴文件路径,让 Codex 对其进行检查。这正是 Codex 能帮助您解答那些基础却至关重要的问题的地方:
•
这里有哪些文件格式?
•
每个数据集似乎代表什么?
•
哪些列可能是目标、标识符、日期、地点或度量?
•
明确的质量问题在哪里?
先不要急于得出结论,先列出清单并加以说明。
整理并合并输入数据
大多数实际工作都从这里开始。您拥有两个或多个数据集,主键并不明确,而简单的合并可能会导致数据丢失或产生重复记录。
在执行合并前,请 Codex 为您生成合并概要:
•
检查候选键的唯一性。
•
衡量空值率和格式差异。
•
规范化明显的格式问题,如大小写、空格或地址格式。
•
执行试运行连接并报告匹配率。
•
在写入最终合并文件之前,推荐最安全的合并策略。
如果您需要派生出最佳键,例如规范化后的地址、由若干列构建的地块标识符,或基于位置的连接,请在确认合并之前,先让 Codex 为您说明其中的权衡与边界情况。
通过图表进行探索,并使用独立的工作树
在探索性数据分析阶段,Codex 能够借助清晰的隔离机制获益。一个工作树可以用于测试地址清洗或特征工程,而另一个工作树则专注于图表绘制或探索其他模型方向。这样既能确保每次代码变更都易于审查,又能避免将不兼容的思路混杂于单一长任务之中。
ChatGPT 桌面版应用内置了工作树支持。如果您在终端中工作,普通的 Git 工作树也同样适用:
git worktree add ../analysis-highway-eda -b analysis/highway-eda
git worktree add ../analysis-model-comparison -b analysis/highway-modeling
在所举的示例中,这一步正是将高速公路附近的住宅与较远地区的住宅进行比较、识别异常值、检查缺失值的分布模式,并判断所观察到的效果是真实存在的,还是反映了社区构成、房屋面积或其他因素的影响。
对问题建模
并非每项分析都需要复杂的模型。不妨从一个易于解释的基准模型入手。
对于高速公路这一问题,一个合理的初步分析方法是采用回归模型或其他透明的计量模型,以在控制房屋面积、房龄和地理位置等相关因素的前提下,估计临近高速公路与房产价值之间的关系。
请 Codex 明确说明:
•
目标变量与特征的定义。
•
应纳入哪些控制变量及原因。
•
泄漏风险与排除项。
•
它如何选择划分、评估或不确定性估计。
•
结果的通俗解释。
如果第一个模型表现较弱,这仍然很有价值。它能帮助你判断问题出在模型、特征、连接质量,还是问题本身。
传达结果
只有当他人能够消费这份分析时,它才真正有用。请让 Codex 生成受众所需的成果:
•
给技术协作伙伴的Markdown备忘录。
•
用于下游业务操作的电子表格或CSV文件。
•
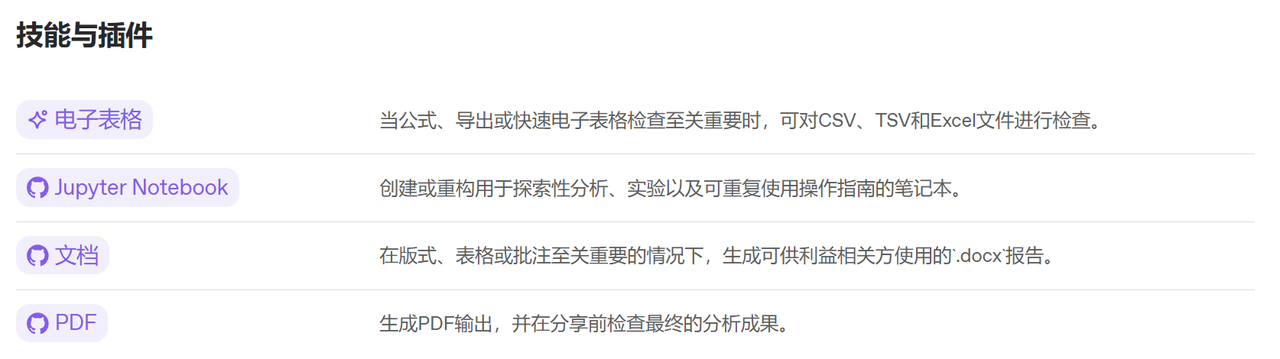
A.docx简短的使用说明$doc当格式和表格至关重要时。
•
使用……生成的附录或最终交付物$pdf.
•
一个轻量级仪表板或静态报表站点,使用$vercel-deploy.
这里也是您提出注意事项的地方。如果联接质量不完善、存在抽样偏差,或者模型假设较为脆弱,Codex 应当在交付成果中予以明确说明。
需考虑的技能
特别适合此工作流的精选技能是:
•
$spreadsheet用于CSV、TSV和Excel的编辑或导出。
•
$jupyter-notebook当可交付成果应保持为笔记本原生格式时。
•
$doc和$pdf用于面向利益相关方的输出。
•
$vercel-deploy当您想将结果以 URL 的形式分享时。
当工作流趋于稳定后,为重复的部分创建本地仓库技能,例如refresh-data, merge-and-qa, 或者publish-weekly-report。这比在每个任务中反复粘贴相同的流程化提示更符合长期最佳实践。
建议提示
设置分析环境
代码块
Haskell
我是一名数据分析师,负责维护此代码库。
请阅读 `AGENTS.md` 文件,检查是否已存在 Python 环境,并为本项目搭建一个最小可复现的分析工作流。
**要求:**
- 优先使用 `uv` 和本地的 `.venv` 环境,除非该代码库已统一采用其他方式。
- 创建清晰的文件夹结构,分别用于存放原始数据、处理后的数据、笔记本以及输出结果。
- 说明如何运行 Python 脚本、安装依赖包以及保存产出物。
- 请勿修改原始数据文件。
加载数据集并进行说明
代码块
Haskell
请加载位于[路径]的数据集,并说明其内容。
构建首个可解释模型
代码块
Haskell
建模分析高速公路邻近性是否与较低的房产估值相关。
要求:
- 从一个易于解释的基准模型入手;
- 明确界定目标变量、特征变量及控制变量;
- 阐述数据泄漏风险及排除措施;
- 报告效应大小、不确定性以及主要局限性;
- 保存建模代码并附上一份简要的结果说明。