AI产品经理agent项目,prd要写什么?
🧠 智能客服系统功能需求说明书
▫️
版本:V1.1
编制日期:2026年5月7日
编制人:需求分析团队
审核人:技术总监
批准人:产品委员会
引言
1.1 文档目的
本说明书旨在明确智能客服系统(以下简称“系统”)的功能边界、非功能约束及数据交互要求,作为系统设计、开发、测试及验收的核心依据。确保系统满足企业客户服务场景的智能化需求,提升服务效率与用户体验。
1.2 适用范围
本说明书覆盖系统的用户交互层、核心处理层、知识库管理、运营支撑等全模块功能,适用于系统开发团队、产品经理、测试人员及企业运营人员。
系统概述
2.1 系统定位
🌐
本系统是一款企业级智能客服解决方案,通过自然语言处理(NLP)、机器学习(ML)等技术
实现 7×24小时自动服务,降低人工压力,提升服务响应速度与一致。
50%
50%
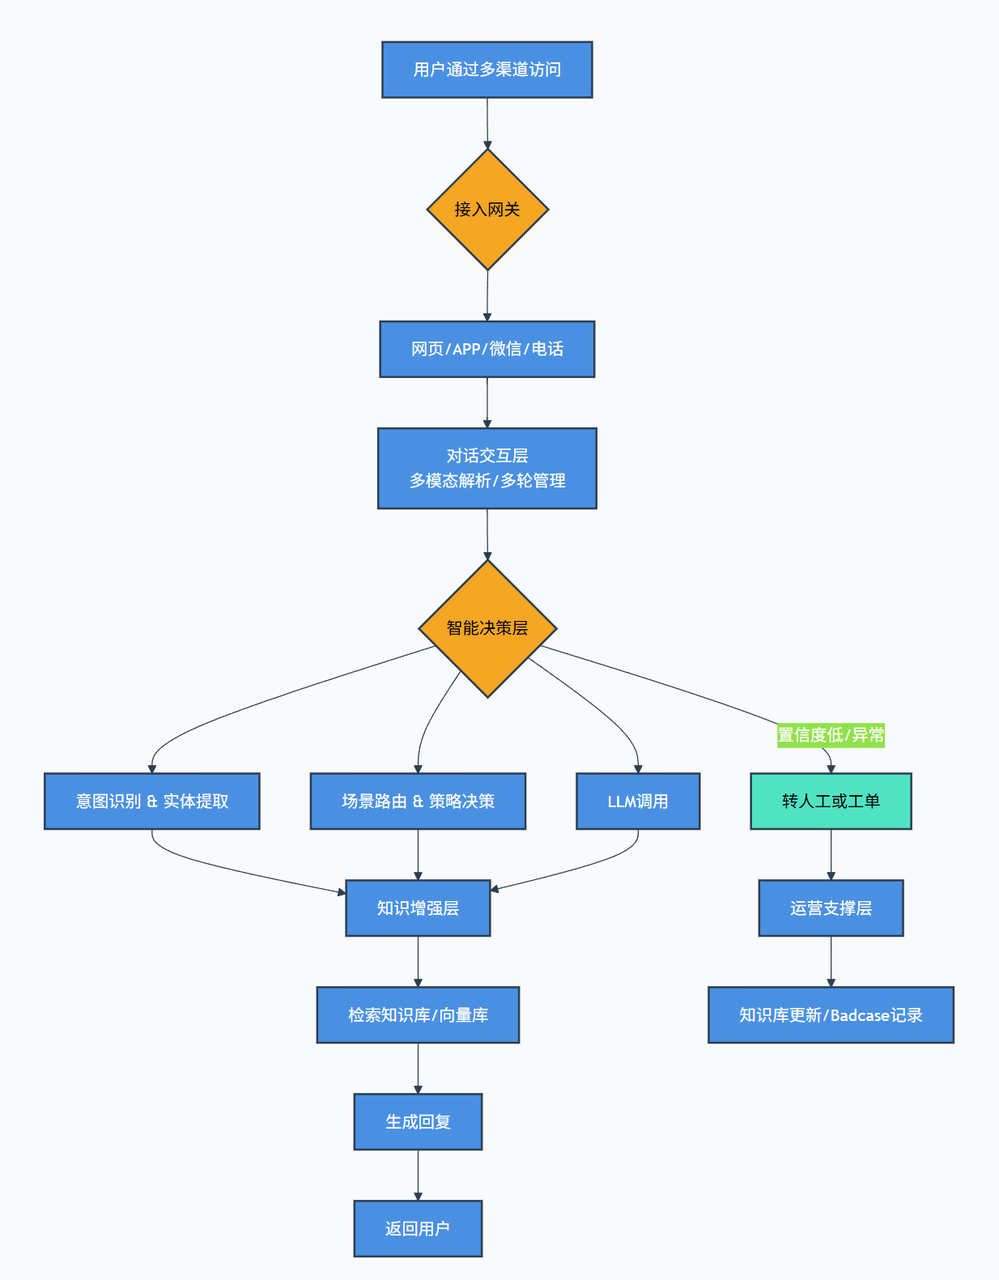
2.2 系统架构
系统采用分层架构设计,各层职责清晰:
代码块
Plain Text
┌─────────────────────────────────────────────────────────────┐
│ 用户触点层 │
│ 网页/APP/微信/电话/抖音小程序/企业微信 │
└─────────────────────────────────────────────────────────────┘
│
┌─────────────────────────────────────────────────────────────┐
│ 对话交互层 │
│ 多模态输入解析 │ 多轮对话管理 │ Agent调度 │ 情感计算 │
50%
50%
2.3 核心价值
功能需求
3.1 用户交互模块
3.1.1 多渠道接入
•
支持渠道:网页端(PC/移动端)、APP(iOS/Android)、微信生态(公众号、小程序)、电话(语音IVR)
•
会话同步:用户切换渠道(如从微信到APP),系统保留历史对话上下文,无需重复输入
示例场景:用户在微信咨询“订单取消方法”,半小时后打开APP,系统自动拉取微信会话记录,可直接继续对话。
3.1.2 多模态输入处理
3.1.3 会话管理
•
生命周期管理:会话开始(用户首次发消息)→ 活跃中 → 超时关闭(30分钟无交互)→ 主动结束
•
会话转接:支持静默转人工(用户无感知)和主动转人工(提示“是否需要转接客服?”)
•
会话标签:运营人员可手动为会话打标签(如“高投诉”“潜在销售机会”)
•
上下文记忆:保留至少10轮对话的意图和实体,支持跨轮次引用
•
追问机制:信息不全时自动追问
👤 用户:“退货怎么操作?”
🤖 系统:“请提供您的订单号”
•
场景切换:支持从“订单查询”切换至“售后投诉”,保留场景内上下文
50%
50%
3.2 对话管理模块
3.2.1 多轮对话支持
3.2.2 意图识别与实体提取
3.2.3 对话策略
•
优先级策略:用户同时提出多个需求时,按紧急程度排序
例如:“修改地址”优先级 > “查询订单”
•
个性化回复:根据用户画像调整回复内容
👑 VIP用户:“您的专属客服已就绪,是否立即转接?”
•
错误处理:无法识别意图时回复引导语,并记录未识别问题
🤖 “抱歉,我没理解您的问题,请换种方式表达”
3.3 知识库管理模块
3.3.1 知识录入与维护
•
录入方式:批量导入(Excel/CSV) + 单条录入
•
知识分类:支持无限级目录,按业务场景分类(订单管理/售后支持/产品咨询)
•
审核流程:录入 → 待审核 → 已审核 → 上线,未审核知识不可调用
•
知识更新:支持修改/删除,修改后重新审核;支持定时同步
3.3.2 知识检索
3.3.3 版本控制与备份
•
版本管理:记录每次修改(修改人、时间、内容),支持回滚至任意历史版本
•
数据备份:每日自动备份至异地服务器,保留30天
3.4 智能处理模块
3.4.1 NLU/NLG引擎
▫️
•
NLU引擎:中文分词、词性标注、依存句法分析
•
输入:“查询订单123456的物流” → 输出:{意图: "物流查询", 实体: {订单号: "123456"}}
•
NLG引擎:支持模板化回复、生成式回复(可选),语气可配置
3.4.2 机器学习模块
•
模型训练:基于历史对话定期训练意图识别模型(每周一次)
50%
50%
3.4.3 多模态处理
3.5 运营管理模块
3.5.1 用户与权限管理
▫️
•
用户管理:创建/禁用/删除运营账号,记录姓名、角色、联系方式
•
权限模型:RBAC,支持自定义角色(如“知识库编辑员”“工单处理员”“只读统计员”)
•
操作日志:记录所有操作(操作人、时间、内容),支持导出
3.5.2 工单系统
3.5.3 话术管理
▫️
•
自定义回复:节日问候、活动通知等,可关联特定场景(如用户首次访问)
•
场景话术:针对“新用户注册”“促销活动”等设置话术,支持定时启用
•
话术审核:所有自定义话术需审核上线,避免违规内容
3.6 统计分析模块
3.6.1 对话统计
3.6.2 用户行为分析
•
高频问题:统计Top 10用户问题,可导出
•
用户流失分析:中断对话比例原因(无法识别意图/等待过长)
•
用户画像:基于对话数据生成年龄、性别、兴趣、常见画像
50%
50%
3.6.3 系统性能分析
•
意图识别准确率:按时间/场景统计
•
知识库命中率:命中数/总查询数,显示未命中问题
•
并发量统计:峰值/平均值,支持阈值告警
3.6.4 知识库效能分析
▫️
•
知识热度:高频调用知识Top 10(如“快递查询”)
•
知识更新频率:每月更新趋势
•
知识有效性:用户对每条知识的满意度比例
3.7 场景挖掘与决策逻辑
本节描述系统如何从对话数据中自动挖掘高频/高价值场景,并基于规则+模型进行动态决策路由。
3.7.1 场景挖掘流程
历史对话日志 → 聚类分析(DBSCAN/BERTopic) → 候选场景提取 → 人工标注 → 场景库上线
▫️
•
无监督聚类:每周自动对未标记对话进行聚类,发现新兴问题类型
3.7.2 决策逻辑模型
系统采用双层决策引擎:
3.7.3 动态策略路由
系统支持策略热更新(无需发布),运营人员可通过可视化编排:
代码块
Plain Text
场景: 退货咨询
条件:
- 意图: "退货"
- 实体存在: "订单号"
- 用户等级: "VIP"
动作:
- 调用知识库: "退货流程_VIP专属"
- 同时弹窗: "是否立即转接高级客服?"
- 若用户否定: 继续自助流程
3.8 Agent 执行链路设计
本系统内置多Agent协作框架,用于处理复杂任务
3.8.1 Agent 角色定义
3.8.2 Agent 执行链路示例
3.8.3 Agent 监控与回滚
•
执行轨迹记录:每个Agent的输入输出均记录到链路日志。
•
异常回滚:若任一Agent返回失败,支持整体回滚
•
超时熔断:单个Agent执行超时(默认5秒)自动熔断,转人工兜底。
非功能需求
4.1 性能需求
4.2 易用性需求
•
界面设计:Material Design风格,核心功能操作≤3步
•
帮助文档:在线检索,支持按关键词查找
•
提示引导:实时提示(“知识录入成功”),错误提示明确(“订单号格式错误,请输入12位数字”)
4.3 可靠性需求
•
故障恢复:自动切换备用服务器,恢复≤5分钟
•
数据一致性:多节点同步延迟≤1秒
•
容错性:支持乱码、超长文本等异常输入,系统不崩溃
4.4 可扩展性需求
•
微服务架构:支持独立扩展知识库、并发等模块
•
第三方集成:CRM、ERP、物流系统(RESTful / SOAP)
•
开放API:提供对话接口、知识库接口,支持企业二次开发
4.5 兼容性需求
企业知识库构建
在原有知识管理基础上,增加面向大模型的知识工程方法。
5.1 知识来源与预处理
5.2 知识表示与存储
系统支持双重表示:
•
文本表示:存储在 Elasticsearch,用于关键词检索。
•
向量表示:使用 text-embedding-v3(1024维)存储至 Milvus,用于语义检索。
代码块
JSON
{
"knowledge_id": "KB_12345",
"question": "如何申请开电子发票?",
"answer": "您可以在APP订单详情页点击【申请发票】...",
"vector": [0.12, -0.34, ...],
"category": "售后",
"tags": ["发票", "电子发票"],
"valid_from": "2026-01-01"
}
5.3 知识自动更新与失效检测
•
主动探测:定期爬取产品官网/文档,比对MD5,发现变更自动触发审核流程。
•
失效检测:通过用户反馈(“这个答案没有帮助”)低于阈值时,标记为“待审核”。
数据需求
6.1数据类型
6.2 数据存储
6.3 数据处理
•
数据脱敏:手机号显示为138****1234
•
数据清洗:定期清理未完成对话、重复知识库内容
接口需求
7.1 内部接口
7.2 外部接口
安全需求
8.1 数据安全
•
访问控制:RBAC模型,普通运营人员无法查看用户敏感数据
•
数据销毁:用户注销后7天内永久删除所有数据
8.2 系统安全
8.3 用户安全
•
身份认证:运营人员双因素认证(密码+短信验证码)
•
会话安全:JWT令牌,有效期30分钟
•
权限审计:每季度审计一次,删除闲置/超额权限账号
8.4 审计跟踪
▫️
•
操作日志:保留1年,记录所有运营操作
•
对话日志:保留1年,支持按用户ID/对话ID检索
•
审计报告:每月生成安全审计报告
Badcase 分析与迭代优化
9.1 Badcase 定义与采集
9.2 Badcase 处理流程
采集 → 自动分类 → 人工标注 → 归因分析 → 生成改进任务 → 修复验证 → 上线
自动分类与聚类
•
使用小模型(如TextCNN)对badcase预分类:意图错误_高置信度、知识缺失、逻辑错误等。
•
对大量相似badcase聚类,避免重复处理。
归因分析维度
9.3 迭代优化机制
▫️
•
周迭代:每周二定期更新模型 + 知识库(基于上周badcase)。
•
灰度发布:新模型先覆盖5%流量,人工评估通过后全量。
•
回滚预案:若新模型准确率下降超过2%,自动回滚至上一版本。
9.4 效果度量指标
附录
10.1 参考文档
•
《自然语言处理技术规范》(GB/T)
•
《企业级客服系统设计指南》
•
第三方API文档(百度ASR、阿里云OCR)
10.2 术语表
(同1.4节)
10.3 需求变更记录
文档结束 ✅
本需求说明书将作为项目开发与验收的唯一依据,任何需求变更请填写《需求变更记录》并经过审批流程。