Codex × Hotjar:一键自动分析用户并标记痛点
本章围绕“Codex × Hotjar”组合,介绍了产品经理如何利用AI自动分析用户录屏并标记痛点。
一、案例展现
场景1:AI自动筛选高价值录屏
🌐
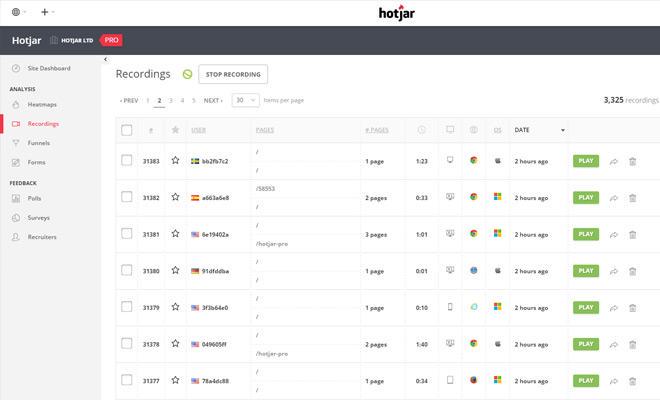
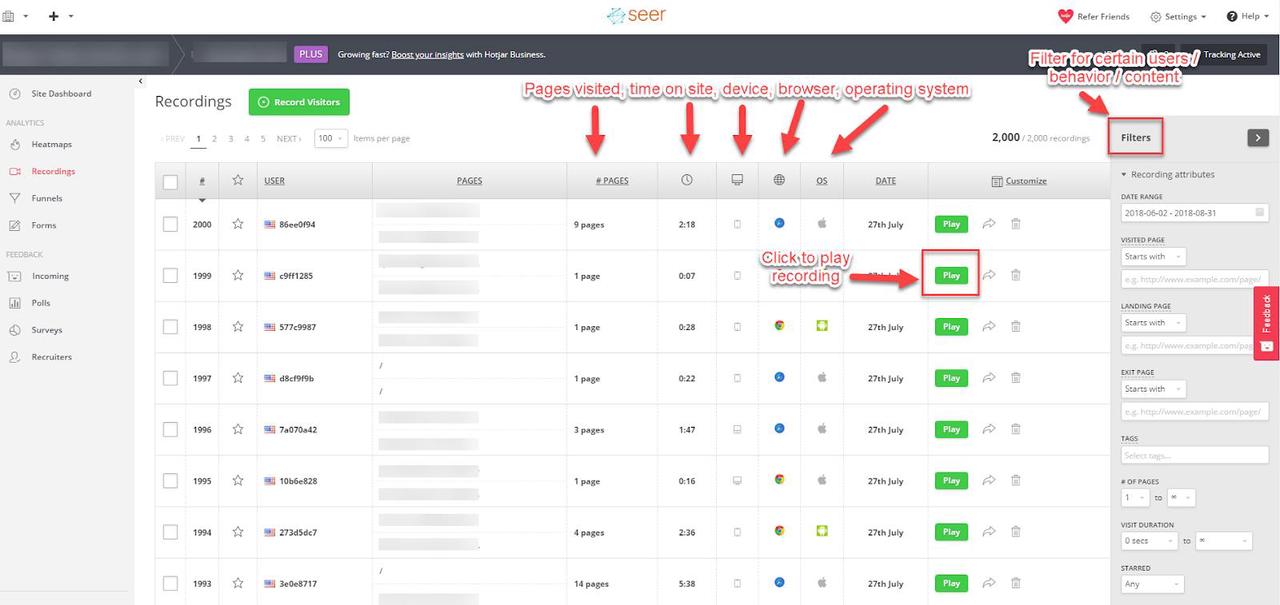
以前你需要在录屏库里一个个看、一个个判断。现在你可以用一个Prompt直接让Codex帮你调用Hotjar API,筛选出挫败感分数最高的录屏,并按痛点类型自动标注。
从Hotjar拉取最近7天挫败感分数最高的20条录屏,按照‘卡死类’‘点击无响应类’‘滚动异常类’分类标注,生成摘要列表。
44%
56%
场景2:痛点热点图自动生成
🌐
录屏分析的本质是找“问题重灾区”——哪些页面、哪些元素出问题的频率最高。
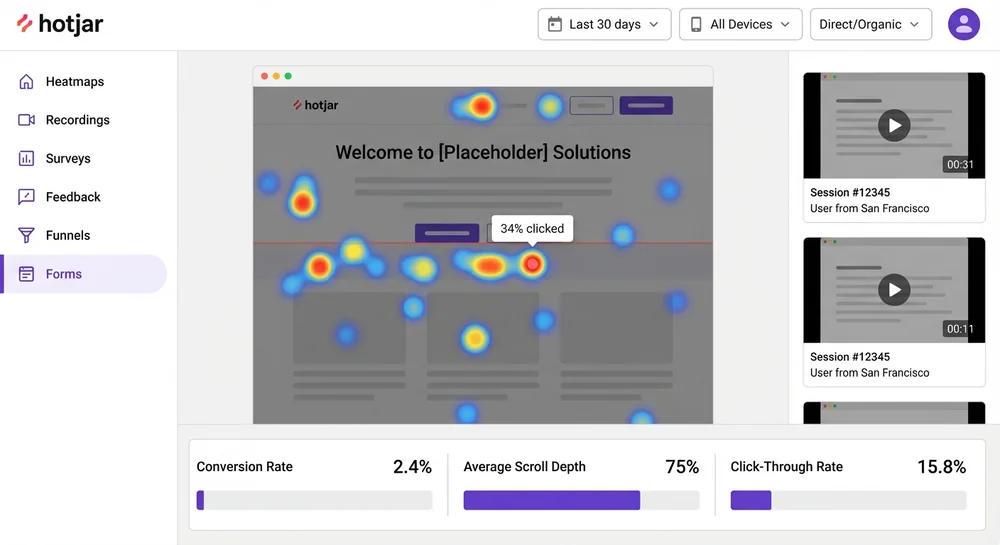
分析过去两周所有挫败感分数>70的录屏,统计高频问题页面TOP5,按问题出现次数排序。
场景3:录屏自动打标签,建立问题跟踪库
🌐
当你积累了一定量的问题录屏后,AI还可以帮你做跨时间维度的问题追踪——某个按钮的卡死问题是从哪天开始出现的?修复后挫败感分数有没有下降?
把过去30天所有rate-limited或server-error相关的录屏打上‘后端异常’标签,按时间排序,标注首次出现日期。
这些标注信息会自动写入你的需求池表格。之后你再问“本周新增了多少后端异常类痛点”,Codex也能快速统计并反馈。
50%
50%
场景4:跨渠道用户路径归因
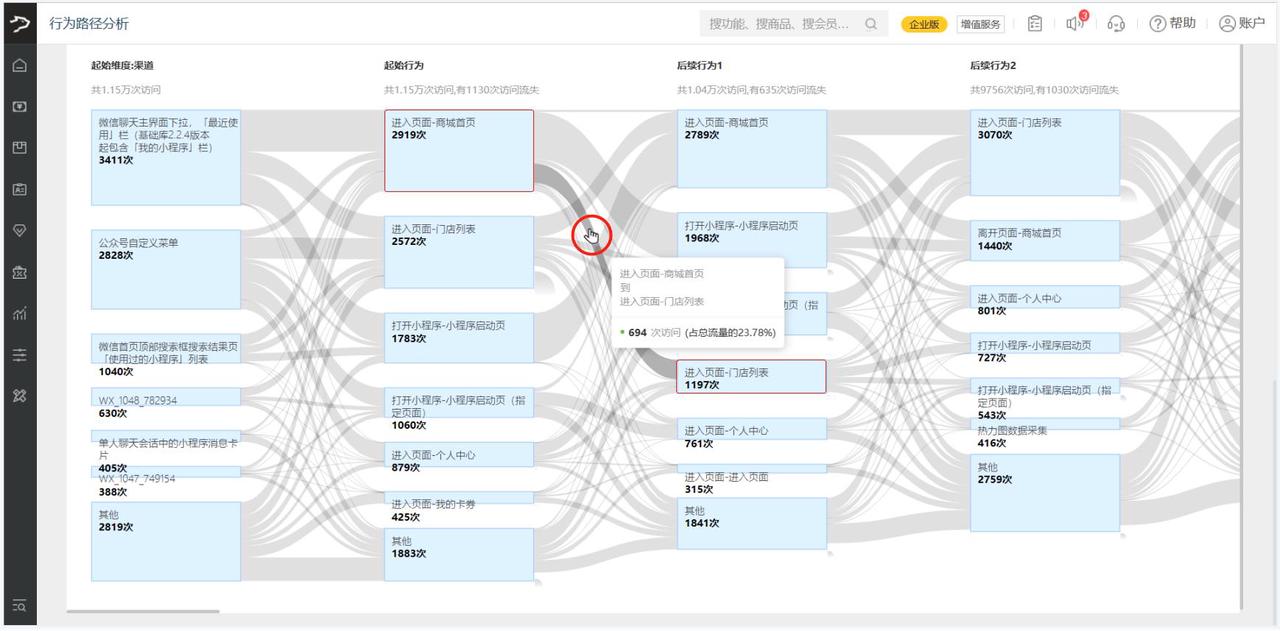
痛点往往不是孤立的——用户在某个页面流失,可能和前面几个页面积累的负面体验有关。AI可以帮你把这些录屏串联起来看:
找出所有在/pricing页面出现rage-click的录屏,追溯这些用户进入/pricing前的来源路径,统计TOP3前序页面。
这个能力特别适合分析“高流失率页面”背后的真正原因——有时问题不在流失页面本身,而在引流页面的信息误导或之前的页面卡顿积攒的负面情绪。
51%
49%
二、实战:Codex + Hotjar API 配置
打通Codex和Hotjar的关键在于数据管道。我们需要先把Hotjar中的数据提取出来,再让Codex进行分析。这里有几条路径,选最适合你的就行。
路径一:dltHub AI Workbench(推荐,10分钟上手)
dltHub提供了一个AI Workbench,可以直接在Python中构建Hotjar到数据库的数据管道,并且原生支持Codex、Claude Code、Cursor等AI编码辅助工具。
这套方案的核心价值在于:通过dlt的REST API连接器,你可以用声明式的Python代码一次性拉取Hotjar的所有核心数据——包括会话记录、调查问卷、站点配置等,根本不需要手动处理API细节。
操作步骤:
代码块
Haskell
1. 安装dlt并初始化工作空间(对接Codex)uv run dlthub ai init --agent codex#
2. 安装REST API管道工具包uv run dlthub ai toolkit install rest-api-pipeline#
3. 在Codex中,向AI助手描述数据源,让它自动生成Hotjar到数据库的管道代码
一旦管道建立完成,Hotjar的session recordings(会话录屏数据)就会自动进入你的数据库。之后在Codex里用自然语言提问,它就能直接从这个数据库中查询并分析用户痛点趋势了。
为什么推荐dltHub路径? 因为它原生支持AI工作区,Codex可以感知项目的完整上下文,未来做增量更新、数据格式演变时,AI都能自动帮你调整,后续维护成本极低。
路径二:用n8n搭建自动化节点(低代码,最适合日常运营)
如果你希望更轻量级地构建“数据提取→AI分析→写回记录”的工作流,n8n也是一个不错的选择。
n8n是一个开源的工作流自动化平台,用拖拽节点的方式就能完成复杂的多步骤联动。社区已经提供了Hotjar的n8n节点,支持获取会话录屏、调查问卷、热图数据等核心操作。
具体操作:
在n8n的Community Nodes设置中搜索安装 n8n-nodes-hotjar;
配置Hotjar API Key(从Hotjar后台的Settings → API中生成,并赋予read权限);
搭建一个定时触发器(比如每小时跑一次),配合OpenAI节点生成当批次录屏的分析摘要,再通过Webhook推送到Slack或直接写入Airtable。
这套组合非常适合需要在生产环境中快速迭代测试的团队。
路径三:手动构建Python脚本(最灵活,适合需要深度定制的场景)
如果你想完全控制数据处理的每一层,直接用Hotjar API也可以。
安装Hotjar Python库后,你就可以拉取站点的录屏元数据、加载用户点击坐标散点图、表单停留时长分布等,然后将这些结构化的行为数据交给大模型进行自然语言分析:
“这批JSON数据中,87%的用户在3秒内放弃了表单填写,请帮我总结可能的原因,并列举3个最优先的体验改进项。”
一般化思路架构图:
数据采集层
→ Hotjar API
→ 录屏元数据、挫败感分数、点击热图
数据管道层
→ dlt / n8n
→ 自动增量提取+结构化入库
AI分析层
→ Codex
→ 读取结构化数据,自然语言交互分析
洞察输出层
→ 痛点标注 → 更新需求池
→ 统计报告 → 推送到Slack
→ 热点图 → 写入看板
三、产品经理的痛点分析方法论:让AI帮你分准类
痛点分析本质上是在做“行为模式识别”——把散落在各个录屏中的用户异常行为,聚类成一类可被修复的问题。以下这个方法框架,可以帮你更好地和AI协作完成这套流程。
标准流程
数据准备
•
确保Hotjar已配置Frustration Score追踪
•
通过API连接,将最近7天录屏的元数据(URL、挫败感分数、rage-click次数、用户停留时长、表单放弃节点等)导入Codex可访问的数据集
筛选与分析
•
在Codex中执行自然语言筛选,比如“找出挫败感分数>75、来自移动端的所有录屏”
•
让AI提取共性行为特征(比如“超过70%的用户在第二个表单字段反复修改”)
归类与定性
•
AI生成初步分类(卡死类、交互无反馈类、加载缓慢类),产品经理做最终定性(有些AI判定的“卡死”可能是用户正常的思考停顿,需要人工过一遍)
•
将痛点归因到具体的页面元素(如“/checkout页面的CTA按钮”)
跟踪改进
•
标记问题为待修复,写入需求池
•
修复后,定期查询新录屏以确认挫败感分数是否回落
痛点分类速查表
四、避坑指南
数据质量是底线
Hotjar API取回的元数据依赖事件埋点。如果埋点命名混乱(不同页面用不同名称标记同一个按钮),AI的分析结果就很难准确。建议先在Hotjar Lexicon里梳理核心事件的定义和属性。
挫败感分数≠绝对真相
Frustration Score的设计初衷是帮用户“跑个初筛”,但它不能识别出所有类型的痛点。低挫败感分数的录屏里,依然可能藏着重度体验问题(比如部分用户出于习惯默默忍受,并未表现出rage-click或u-turn)。最终的问题定性,需要你的产品判断力来兜底。
API配额与成本
Hotjar API存在请求速率限制(各套餐不等)。全量拉取所有会话元数据可能触发频率上限,建议批量分段拉取,并做好分页和限流逻辑。n8n节点内置了相关错误重试与延迟逻辑,能让自动化更加健壮。
隐私合规不可忽视
录屏数据可能涉及用户PII(个人身份信息)。务必在Hotjar设置中开启数据脱敏规则(屏蔽支付表单、隐藏输入字段),千万不要将未脱敏的敏感录屏数据喂给AI,确保数据处理符合GDPR/CCPA等合规要求。
数据保留周期
Hotjar的数据保留取决于你的套餐级别,默认通常是365天。建议定期对历史录屏元数据做增量备份,用于长期的趋势对比分析。
五、写在最后
Hotjar录屏分析的常见误区,是把它当成“观看录像带”——花大量时间去发现零散的Bug,而不是系统性地理解用户行为模式。
通过Codex和Hotjar API的组合,你可以把这件事从“纯手工”变成“半自动化+智能归因”。产品经理的核心投入将从“花几个小时看几十条录屏”变成“花20分钟审阅AI生成的分析结论,再把它变成产品迭代的优先级”。
我把自己平时用的录屏痛点分析Prompt模板和Hotjar API数据管道配置脚本整理成了一个文档,包含:
•
高挫败感录屏批量筛选Prompt(可直接复制使用)
•
痛点分类规则配置模板
•
跨周期痛点趋势对比分析方法
•
从录屏洞察到需求池更新的自动化衔接思路