Codex × LangSmith:自动评估AI产品中的LLM调用质量
本章围绕“Codex × LangSmith”组合,介绍了AI产品经理如何系统化评估LLM调用质量。
一、先搞明白:LangSmith能做什么
•
全链路追踪:让黑箱变透明
🌐
LangSmith依靠唯一TraceID,完整记录LLM应用从用户输入到最终输出的全部执行流程,将原本晦涩的运行黑箱转化为可视化追踪树。它可精准展示每一步的提示词内容、耗时、Token消耗等细节,帮助开发者快速定位AI回答出错的具体环节,高效排查问题。
•
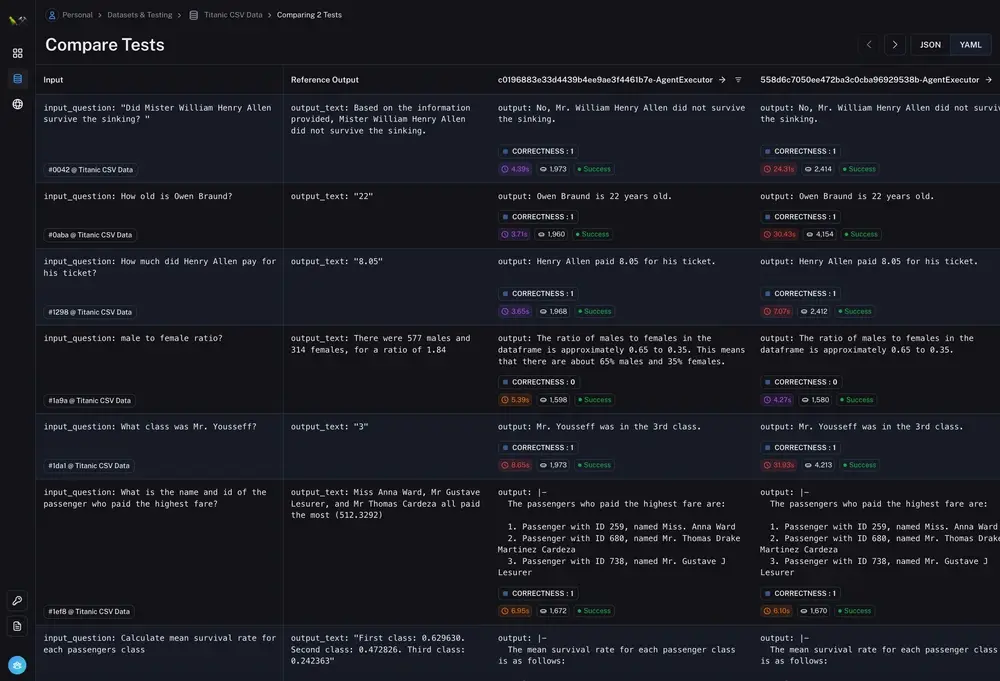
自动化评估框架:用数据说话
🌐
LangSmith提供多维度量化评估能力,支持预设或自定义指标,可实现A/B测试、回归测试、指标告警等全流程测评。同时搭载可视化的提示词游乐场与提示词中心,无需代码,产品经理等非技术人员也能独立完成提示词迭代与模型实验、评估工作。
•
Align Evals:让AI评分更接近人的判断
🌐
Align Evals是LangSmith的核心升级功能,主要解决传统AI评估评分与用户真实体感、人工判断不符的问题。它支持自定义评估权重、依托人工标注数据迭代校准评估规则,让AI评估标准贴合团队产品标准,实现更精准、更贴合用户体验的智能打分。
•
Insights:从海量数据中自动发现异常模式
🌐
Insights功能可自动化分析海量LLM调用数据,解放人工排查工作。它能智能挖掘用户提问偏好、使用习惯以及模型出错、产生幻觉的高频场景与异常趋势,快速定位AI回答质量波动的核心原因
二、核心配置:Codex + LangSmith MCP集成实战
第1步:获取LangSmith API密钥
访问LangSmith官网,用GitHub或Google账号登录后,在Settings页面中找到API Keys选项卡,点击Create API Key并保存生成的密钥。同时从URL中复制你的Workspace ID。
📌 这一步只需要做一次,后续的配置都会用到。
第2步:在Codex中配置LangSmith MCP服务器
LangSmith提供了托管版MCP服务器,无需自行部署,直接在Codex的MCP配置中添加即可。
有两种配置方式:
方式一:Codex桌面应用GUI配置
打开Codex → 点击左下角⚙️设置图标 → MCP Servers → “+ Add Server” → 选择“Streamable HTTP”模式 → 在URL处填入LangSmith托管MCP服务器的地址:
text
https://langsmith-mcp-server.onrender.com/mcp
在Headers中添加LANGSMITH-API-KEY和LANGSMITH-WORKSPACE-ID。配置完成后重启Codex,集成即可生效。
方式二:Python代码集成
如果你想在自己的评估脚本中深度集成,也可以通过LangSmith SDK在Python中初始化客户端:
python
from langsmith import Client, Traceclient = Client()trace = Trace(run_id="unique_id")with trace.start_span("prompt_processing"): processed_prompt = preprocess_prompt(raw_input)with trace.start_span("model_inference"): output = model.generate(processed_prompt)trace.set_output(output)client.submit_trace(trace)
这套SDK的使用场景是深度定制的自动化评估工作流——比如你要在CI/CD流程中跑回归测试,或者要在某个数据分析Notebook里批量评估历史调用数据。
第3步:验证连接
配置完成后,在Codex中输入以下Prompt验证是否能正常读取LangSmith数据:
“列出我LangSmith工作区中最近10条根运行记录。”
Codex会调用LangSmith MCP工具,读取并返回运行记录的汇总列表。如果你看到列出了具体的运行记录——包括每次LLM调用的输入、输出、耗时、Token消耗等元数据——说明集成已配置成功。
三、产品经理的核心场景:3个实战指令
集成打通之后,以下三个场景是最值得先用起来的。
场景1:一键对比两个Prompt版本的评估得分
假设你正在优化客服Agent的Prompt,你写了一个新版本v2打算替代v1,但你不知道它是不是真的比v1好。传统做法:让几个同事手动对比10个典型问答,花半小时得出一个“感觉好了一点”的结论。
在Codex中,你可以直接这样操作:
“读取LangSmith中实验A(Prompt v1)和实验B(Prompt v2)的评估结果,对比两个版本在回答正确性和表达流畅度两个维度的平均得分,告诉我v2相比v1在哪个维度提升最明显、在哪个维度可能有下降。”
LangSmith的对比实验机制在这里充分发挥价值——你可以在一次实验中用同一个测试集同时评估多个版本,横向对比得分差异,彻底告别“凭感觉”改Prompt的盲目状态。
场景2:定位回答质量突然下降的“元凶”
某天早上你看到LangSmith告警:过去24小时的LLM回答正确率从89%骤降至72%。你需要在最短时间内找到原因——是哪类用户的问答出了问题?哪个模型的调用环节出现了异常?是提示词崩了还是模型本身不行了?
在Codex中输入:
“分析LangSmith中过去24小时回答正确率下降20%的原因。先按用户意图类别分组,找出错误率最高的TOP3意图;然后按模型版本拆分,对比v2.5和v2.4的表现差异;最后输出带有具体错误样例的根因分析报告。”
这里的核心能力是LangSmith提供的Insights——自动从海量生产数据中发现异常模式,告诉产品经理到底哪里出了问题。你不需要自己去猜、去翻日志,AI已经帮你完成了第一轮归因。
场景3:识别易出问题的用户场景
有的时候,AI出错不是因为某一次Prompt写得不好,而是在某个特定的用户场景下,系统的表现整体偏弱。比如,当用户的问题涉及多个产品功能对比时,AI的回答质量就明显下降。如果没有系统性评估,这类模式性问题非常难被发现。
Codex可以帮你做这件事:
“遍历LangSmith中最近两周的回答评分数据,分析出评分低于60分的会话中,用户提出的问题主要呈现出哪些共性的语义特征。输出TOP3共同特征,并给出可能导致评分偏低的原因假设。”
LangSmith的Insights功能在这里的价值是:它会自动在海量的追踪数据中聚类出有意义的语义模式,帮助产品经理从“微观的单个案例”上升到“宏观的系统性问题”。
四、进阶玩法:LLM-as-a-Judge校准
前边提到的“用AI评估AI”机制,最大的风险是评估器本身可能与人的判断对不上。LangSmith的Align Evals功能,提供了让评估器和人类评分保持同步的完整流程。
以下是一个完整的校准步骤示范:
第一步:定义评估标准
*“创建一个评估器,专门评估客服Agent的回复质量。评估标准如下:回答正确性(占比40%)- 信息必须准确无误;回复实用性(占比35%)- 能解决用户的实际需求;表达简洁性(占比25%)- 信息密度高,没有废话。阈值设定:综合得分低于70为不合格。”*
第二步:让评估器学习你的标准
准备50-100条历史问答记录,人工标注每条记录的得分,作为Gold Standard数据集,然后让Align Evals反复迭代评估器配置,直到它的自动评分与人工标注高度一致。
第三步:持续迭代对齐
每隔一段时间,重新抽样一些新的会话进行人工抽查。如果发现自动评分和人的判断出现持续偏差(比如AI总给长回答打高分但你的用户嫌弃啰嗦),更新评估器的Prompt,重新校准。
这一套流程的本质,是把评估器的评分标准“复刻”成你团队的真实质量观。最终形成的评估器,就是一个始终忠实地按你的标准打分的“AI质检员”。