电商问数——智能数据分析 Agent
欢迎来到「电商问数」项目,正式开启「AI 智能体实战速成指南」的实战项目学习~~ ✨
如果你正在找一个真正适合入门进阶的 AI 项目,而不是只调用一次大模型接口、写几个 Prompt、演示一下 SQL 生成结果,那么这套「电商问数」教程非常适合你。
它把 MySQL、LangGraph、Qdrant、Elasticsearch、Embedding、FastAPI、SSE 和前端联调放进同一条业务链路里,用一个自然语言问数场景,把智能体项目开发中最关键的知识点串起来:
•
用 MySQL 模拟教学数仓和元数据库
•
用 Qdrant 做字段和指标的语义向量检索
•
用 Elasticsearch 做字段真实取值的全文检索
•
用 LangGraph 编排多阶段问数智能体工作流
•
用 FastAPI + SSE 把后端能力交付给前端页面
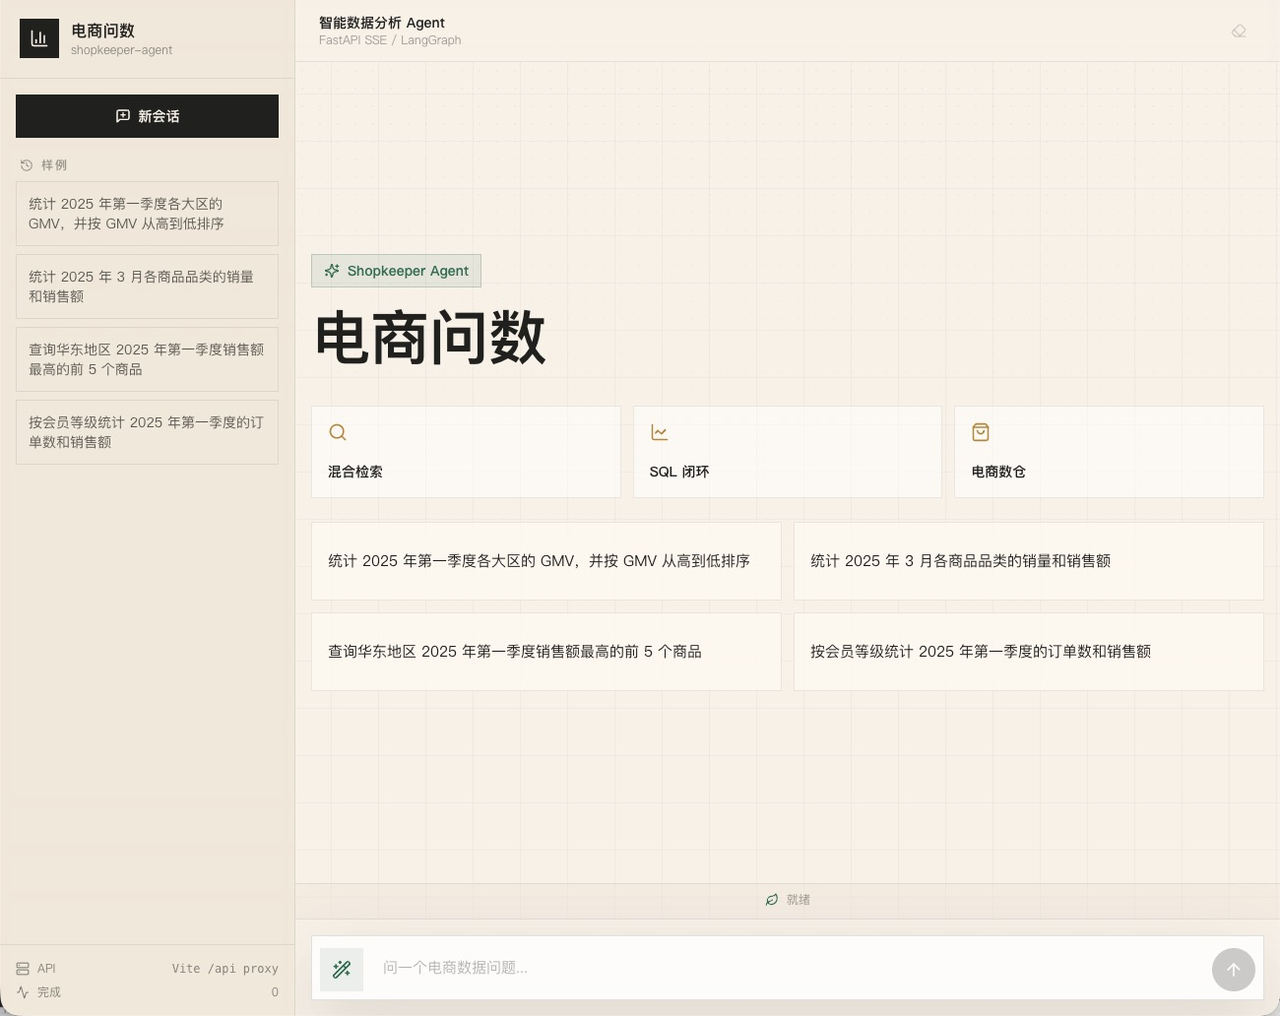
一句话概括:「电商问数」不是一个只会让大模型裸写 SQL 的 Demo,而是一套围绕“先构建元数据知识库,再检索、推理、生成、校验和执行 SQL”展开的智能问数实战项目。
它可能不是一个完整的企业级生产系统,但非常适合作为入门到进阶阶段的项目实战课程。你可以在这里系统学习一套智能体应用从“数据准备”到“检索增强”,再到“工作流编排”和“接口交付”的完整主链路。
📖 项目介绍
在真实问数场景里,业务同学通常不会写 SQL,数据分析同学也很难随时记住所有表结构、字段含义、指标口径和字段取值。单纯把自然语言问题直接交给大模型,很容易出现表选错、字段选错、指标理解错和 SQL 幻觉等问题。
电商问数 要解决的就是这个问题:
•
用户用自然语言提问
•
系统自动召回相关字段、指标和字段取值
•
大模型基于上下文进行分步推理
•
生成 SQL 并查询数据仓库
•
以流式方式返回分析结果
✨ 项目亮点
•
检索 + 推理 + 生成,而不是模型直出 SQL
◦
先围绕问题召回相关字段、指标和值域,再组织上下文生成 SQL,整体链路更稳、更可控。
•
面向企业问数场景的混合检索
◦
Qdrant 负责字段和指标的语义召回。
◦
Elasticsearch 负责字段取值的全文检索。
◦
MySQL 负责保存完整、权威的结构化元数据。
•
支持字段、指标、取值三类信息协同召回
◦
比单纯做表级或字段级检索更贴近真实企业分析流程。
•
从检索到执行的完整可运行链路
◦
不停留在 Prompt 设计,而是会真实生成 SQL、执行查询,并以流式方式返回结果。
•
工程化后端结构清晰
◦
基于 FastAPI + LangGraph + Repository + Client Manager 组织配置、客户端、仓储层、服务层与智能体流程,便于维护和扩展。
•
不仅有实战代码,还有完整配套教程文档
◦
项目配有一套系统化、持续更新、完全免费的教程讲义,适合按章节从数仓基础、元数据知识库到问数智能体流程逐步学习。
•
兼顾学习价值与可扩展性
◦
既可以按教程章节逐步理解,也可以在此基础上继续扩展权限控制、SQL 审核、结果可视化等能力。
这套课程十分适合这些场景:
•
想系统学习 LangGraph,但不想只停留在几个玩具节点。
•
想把 MySQL、Qdrant、Elasticsearch 和大模型放到同一个业务场景里理解。
•
想做一个比简单模型调用更接近实际开发的 AI Agent 项目。
•
想把项目写进简历,并且能说清楚数据层、检索层、智能体层、服务层和前端层分别做了什么。
🏗️ 系统架构
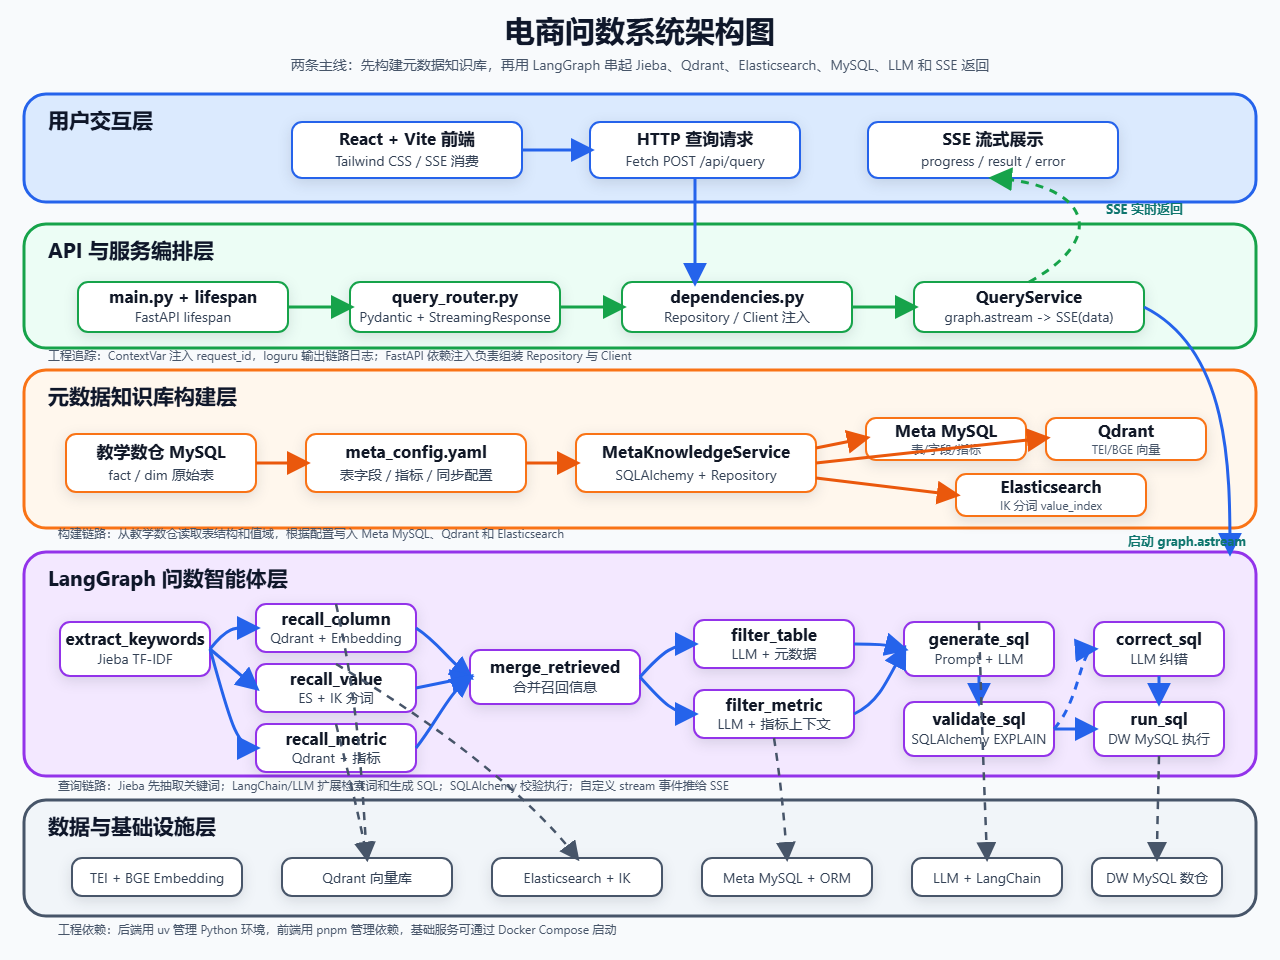
项目围绕两条主线展开:
🛠️ 项目技术栈
表格加载中...
📁 项目结构
代码块
Python
shopkeeper-agent/
├── app/
│ ├── agent/ # LangGraph 图、状态、上下文和各类节点
│ ├── api/ # FastAPI 路由、依赖注入、生命周期和请求结构
│ ├── clients/ # MySQL、Qdrant、Elasticsearch、Embedding 客户端管理
│ ├── conf/ # 配置 dataclass 与配置加载工具
│ ├── core/ # 日志、request_id 上下文等通用能力
│ ├── entities/ # 更贴近业务语义的数据对象
│ ├── models/ # SQLAlchemy ORM 模型
🚀 快速开始
当前仓库已经包含一套可直接启动的本地开发环境,你可以按照以下顺序启动项目。
准备环境
•
Python >= 3.14
•
uv
•
Docker 与 Docker Compose
•
Node.js 与 pnpm
克隆项目
代码块
Plain Text
git clone https://github.com/didilili/shopkeeper-agent.git
cd shopkeeper-agent
安装后端依赖
代码块
Plain Text
uv sync
配置大模型 API Key
代码块
Plain Text
cp .env.example .env
把 .env 中的 LLM_API_KEY 替换成真实密钥:
代码块
Plain Text
LLM_API_KEY=your_real_api_key
默认配置使用兼容 OpenAI 接口的硅基流动服务:
代码块
Plain Text
llm:
如需使用其他兼容 OpenAI API 的模型平台,修改 conf/app_config.yaml 中的 model_name 和 base_url。
准备 Embedding 模型
项目通过 TEI 加载 BAAI/bge-large-zh-v1.5。模型文件体积较大,无法再仓库中进行提交,需要先下载到 Docker 挂载目录:
代码块
Plain Text
uv run hf download BAAI/bge-large-zh-v1.5 --local-dir docker/embedding/bge-large-zh-v1.5
如果手动下载,请解压到:docker/embedding/bge-large-zh-v1.5路径下。
启动 Docker 基础服务
代码块
Plain Text
docker compose -f docker/docker-compose.yaml up -d
默认端口:
docker/mysql/meta.sql 和 docker/mysql/dw.sql 会在 MySQL 容器首次启动时自动初始化元数据库和教学数仓。
构建元数据知识库
代码块
Plain Text
uv run python -m app.scripts.build_meta_knowledge -c conf/meta_config.yaml
这一步会把表字段元数据写入 MySQL,把字段和指标向量写入 Qdrant,并把字段真实取值写入 Elasticsearch。
启动后端
代码块
Plain Text
uv run fastapi dev main.py
后端接口:
代码块
Plain Text
请求示例:
代码块
Plain Text
{
"query": "统计华北地区的销售总额"
}
SSE 消息类型:
启动前端
代码块
Plain Text
cd frontend
pnpm install
pnpm dev
前端默认通过 Vite 代理把 /api 转发到 http://127.0.0.1:8000。如需修改:
代码块
Plain Text
cd frontend
cp .env.example .env
代码块
Plain Text
VITE_DEV_PROXY_TARGET=http://127.0.0.1:8000
🚧 能力边界
这套项目主要关注智能问数的学习流程,不刻意覆盖生产治理能力,例如:
•
用户登录、角色权限和数据权限控制
•
多租户隔离
•
SQL 安全审计和执行白名单
•
查询缓存、限流和性能治理
•
系统化评测集与自动化回归评测
•
监控告警、链路追踪平台和灰度发布
•
更复杂的多轮问数记忆、追问改写和会话管理
这些能力适合在基础流程跑通之后继续扩展。shopkeeper-agent 更适合承担一个清晰角色:先把智能问数最关键、最必要、最值得学习的工程链路讲清楚、跑起来,并为后续扩展企业级能力打基础。