WorkBuddy实战:基于Agent的数据分析系统
一、快速上手WorkBuddy
安装完成后,打开 Codex,用你的 GitHub / Google 账号注册登录
提示:如果你已经安装了 Cursor,直接跳到下一步
二、安装 WorkBuddy 插件
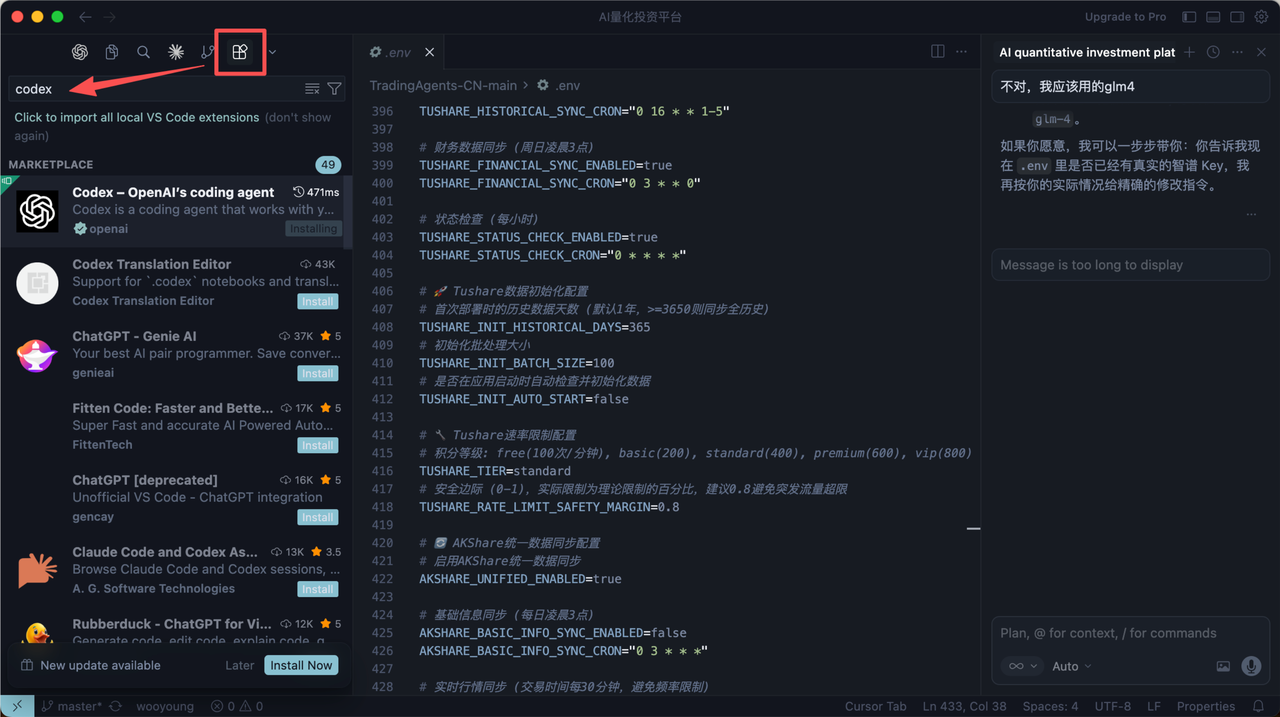
在 Cursor 左侧扩展栏中搜索 WorkBuddy
选择第一个由 OpenAI 开发的插件,点击 "Install" 安装
50%
50%
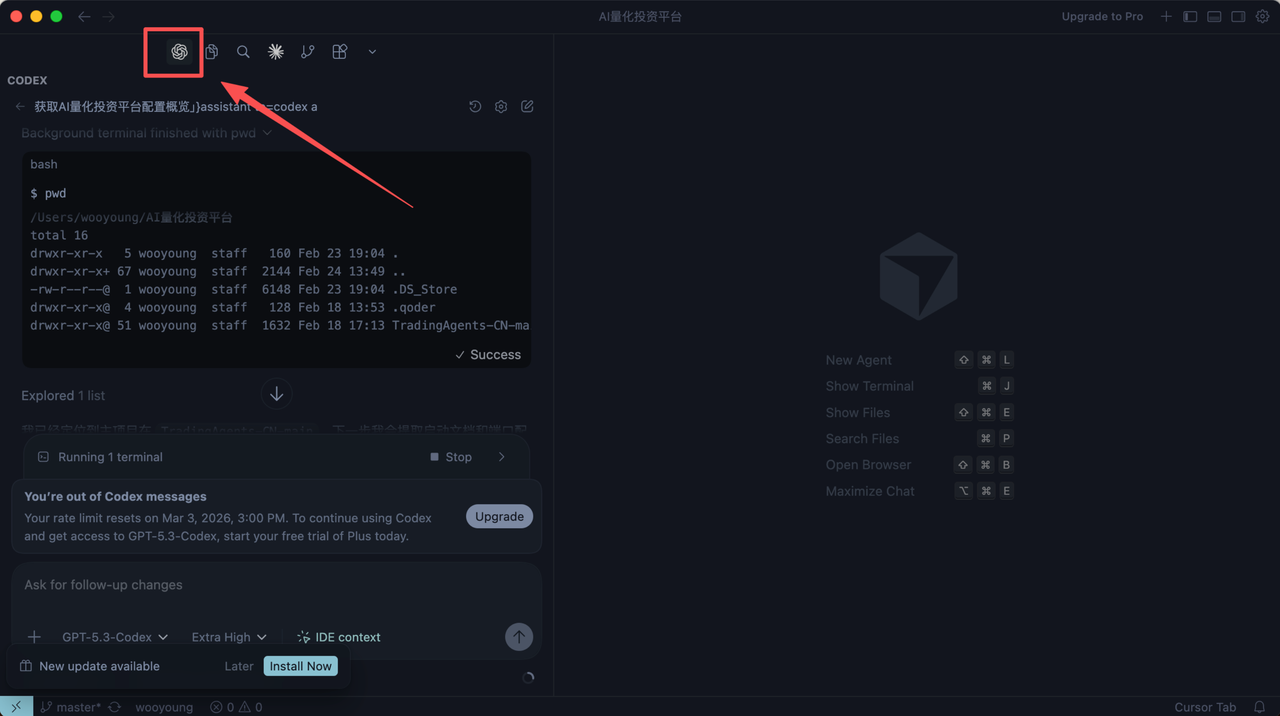
提示:安装完成后,你会在右下角看到 Codex 的聊天窗口,或者按 Cmd/Ctrl + Shift + I 打开
三、导入数据分析 Agent 项目文件
我们用一个开源的数据分析 Agent 项目作为起点。这里推荐使用 PandasAI——一个让 AI 通过自然语言直接分析数据的工具。
两种方式任选其一:
方式一:直接 Clone 项目
代码块
Plain Text 自动换行复制
# 在终端中执行
git clone h***s://github.***/gventuri/pandas-ai.git
cd pandas-ai
pip install -r requirements.txt
方式二:在 Cursor 中创建新项目
🔔
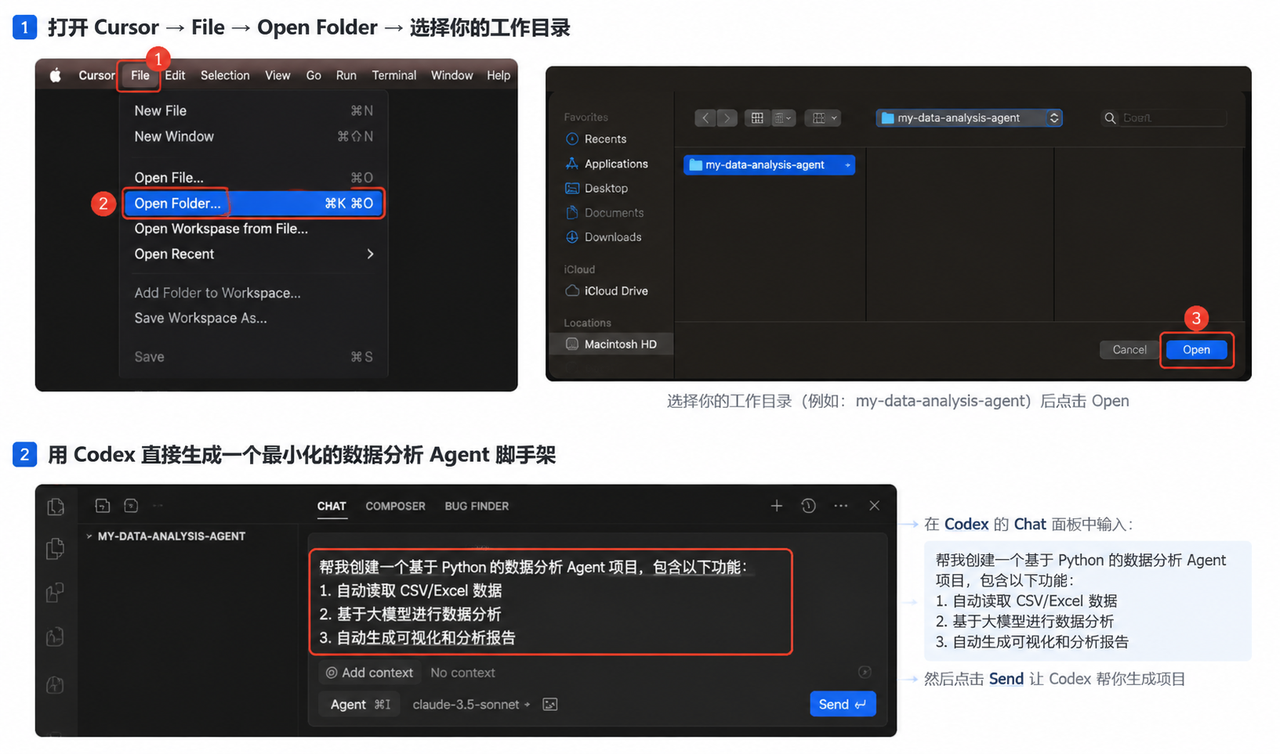
打开 Cursor → File → Open Folder → 选择你的工作目录
用 Codex 直接生成一个最小化的数据分析 Agent 脚手架
在 Codex 中输入以下 Prompt:
帮我创建一个基于 Python 的数据分析 Agent 项目,包含以下功能:
•
1. 自动读取 CSV/Excel 数据
•
2. 基于大模型进行数据分析
四、项目部署后,进入 VibeCoding 阶段
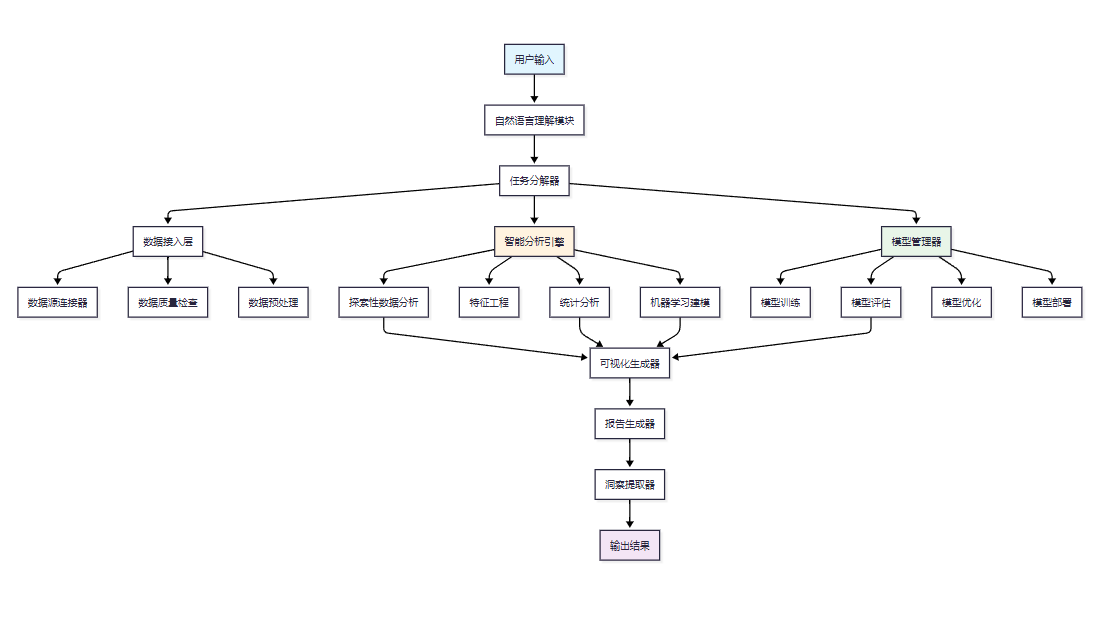
数据分析智能体的核心架构采用模块化设计,包含数据接入、智能分析、模型管理和输出呈现四个主要层次。
第一步:让 Codex 理解项目结构
在 Codex 中提问:
代码块
Plain Text 取消自动换行复制
这个项目的入口在哪里?核心的 Agent 模块是什么?帮我解释一下项目的整体架构。
第二步:搭建核心数据分析流水线
在 Codex 中输入以下 Prompt:
代码块
Plain Text 取消自动换行复制
Codex 会帮你生成核心的 Agent 架构代码,类似下面这样:
代码块
Python 取消自动换行复制
import pandas as pd
import numpy as np
from typing import Dict, List, Any, Optional
from dataclasses import dataclass
import logging
@dataclass
class AnalysisTask:
"""数据分析任务定义"""
task_id: str
task_type: str # 'exploration', 'modeling', 'prediction', 'monitoring'
data_source: str
五、自动化数据探索及可视化
5.1 数据探索分析
数据探索是数据分析的第一步,智能体需要能够自动识别数据特征、发现异常值和分布模式。
这是最关键的一步。让 Codex 帮你创建自动化数据探索模块,对接你自己的数据。
在 Codex 中输入 Prompt:
代码块
Plain Text 取消自动换行复制
帮我创建一个 AutomatedEDA 类,实现自动数据探索功能:
Codex 会生成类似下面的代码(包含 AutomatedEDA 核心功能):
代码块
Python 取消自动换行复制
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
import warnings
warnings.filterwarnings('ignore')
class AutomatedEDA:
5.2 智能可视化生成
数值变量箱线图
50%
相关性热力图
50%
核密度估算直方图
50%
数据分析可视化大屏
50%
智能体需要根据数据特征自动选择最合适的可视化方法。
代码块
Python 取消自动换行复制
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.express as px
import plotly.graph_objects as go
from plotly.subplots import make_subplots
class IntelligentVisualization:
"""智能可视化生成器"""
def __init__(self):
plt.style.use('seaborn-v0_8')
sns.set_palette("husl")
def auto_visualize(self, df: pd.DataFrame, target_column: str = None) -> Dict[str, str]:
"""根据数据特征自动生成可视化"""
visualizations = {}
# 数值变量分布图
🔔
实操建议:把你的数据文件(CSV/Excel)放到项目目录下,然后在 Codex 中告诉它你的文件路径和数据格式,让它自动完成 EDA。
六、配置自动化建模与模型评估体系
6.1 自动化建模配置
机器学习建模是数据分析智能体的核心能力,需要实现从特征工程到模型选择的全自动化流程。
•
让 Codex 为你的 Agent 添加机器学习建模能力。
在 Codex 中输入 Prompt:
代码块
Plain Text 取消自动换行复制
帮我创建一个 AutomatedML 模块,支持:
1. 自动特征工程
2. 多模型自动选择(随机森林、XGBoost、线性回归)
3. 超参数自动优化
4. 模型性能评估
5. 特征重要性分析
代码块
Python 取消自动换行复制
from sklearn.model_selection import train_test_split, GridSearchCV, cross_val_score
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier, GradientBoostingRegressor
from sklearn.linear_model import LinearRegression, LogisticRegression
from sklearn.svm import SVR, SVC
from sklearn.metrics import mean_squared_error, r2_score, accuracy_score, classification_report
6.2 模型性能评估体系
建立完善的模型评估体系是确保智能体产出可靠结果的关键。
表1:模型性能评估指标体系
七、生成智能报告与业务洞察
7.1 智能报告
自动化报告生成是数据分析智能体的重要输出能力,需要将复杂的分析结果转化为易懂的商业洞察。
代码块
Python 取消自动换行复制
from jinja2 import Template
import matplotlib.pyplot as plt
from datetime import datetime
import json
class IntelligentReportGenerator:
"""智能报告生成器"""
def __init__(self):
self.template_engine = Template
self.insights = []
def generate_comprehensive_report(self, analysis_results: Dict[str, Any],
business_context: Dict[str, Any] = None) -> str:
"""生成综合分析报告"""
# 提取关键洞察
key_insights = self._extract_key_insights(analysis_results)
# 生成执行摘要
7.2 业务洞察自动提取
代码块
Python 取消自动换行复制
import numpy as np
from scipy import stats
from typing import List, Dict, Any, Tuple
class BusinessInsightExtractor:
"""业务洞察自动提取器"""
def __init__(self):
self.insight_rules = self._load_insight_rules()
def extract_insights(self, df: pd.DataFrame, analysis_results: Dict[str, Any]) -> List[Dict[str, Any]]:
八、设置业务指标监控与预警
8.1 业务指标监控
业务指标监控与预警是数据分析智能体的重要应用场景,能够帮助企业及时发现业务异常。
图2:实时业务监控与预警系统架构图
•
让数据分析 Agent 具备实时监控能力,在业务指标异常时自动告警。
在 Codex 中输入 Prompt:
代码块
Plain Text 取消自动换行复制
帮我创建一个业务指标监控系统,支持:
代码块
Python 取消自动换行复制
from datetime import datetime, timedelta
from typing import Dict, List, Any, Optional
import asyncio
from dataclasses import dataclass
from enum import Enum
class AlertLevel(Enum):
"""告警级别枚举"""
INFO = "info"
WARNING = "warning"
CRITICAL = "critical"
EMERGENCY = "emergency"
8.2 关键业务指标监控配置
表2:关键业务指标监控配置表
九、技术栈对比选型与实际运行测试验证
9.1 数据分析工具对比
表3:数据分析工具技术对比
9.2 成本效益分析
表4:传统方案与智能体方案成本效益对比
9.3 评测结果展示
表5:数据分析智能体综合评测结果
•
让 Codex 帮你创建一个完整的测试用例,用电商销售数据来验证整个数据分析 Agent 的效果。
在 Codex 中输入 Prompt:
代码块
Plain Text 取消自动换行复制
帮我创建一个电商销售数据分析的完整测试案例,包含:
1. 生成模拟的电商销售数据(含季节性趋势)
2. 用 DataAnalysisAgent 执行分析
3. 输出关键洞察和报告
代码块
Python 取消自动换行复制
import pandas as pd
import numpy as np
from data_analysis_agent.core.agent import DataAnalysisAgent, AnalysisTask
async def ecommerce_sales_analysis():
"""电商销售数据分析案例"""
# 创建智能体实例
agent = DataAnalysisAgent({
'model_config': {
'auto_feature_engineering': True,
'model_selection': 'auto',
'optimization': True
}
})
# 模拟电商销售数据
np.random.seed(42)
dates = pd.date_range('2023-01-01', '2023-12-31', freq='D')
将代码保存为 test_ecommerce.py,在终端运行:
代码块
Plain Text 自动换行复制
🔔
十、部署与上线
10.1 本地部署
代码块
Plain Text 自动换行复制
10.2 Docker 部署
编写 Dockerfile:
代码块
Plain Text 自动换行复制
FROM python:3.9-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install -r requirements.txt
COPY . .
CMD ["python", "app.py"]
10.3 所需 API
•
OpenAI API(用于自然语言分析能力)
•
Pandas / NumPy(数据处理)
•
Scikit-learn(机器学习建模)
•
Matplotlib / Seaborn(可视化)
•
Jinja2(报告模板)
总结
🔔
通过以上十个步骤,你用 Codex 从零搭建了一个完整的数据分析 Agent 系统。这个系统可以自动完成数据探索、可视化、建模、报告生成和业务监控全流程。如果需要进一步定制,随时在 Codex 中提出需求即可!