第4章:AI风格克隆——注入少量样本学习
本章摘要
欢迎来到《零基础构建智能体工程》的第二阶段:构建 AI 的脑。
在《零基础构建智能体工程》的前三天,我们的工程重点聚焦于“驯服 AI 的嘴”。通过 S.C.O.R.E. 模型与 JSON 语义契约,我们成功让大语言模型(LLM)输出了具备逻辑确定性的结构化数据。然而,这种“工程化”的成功往往伴随着“机器味”的副作用:生成的文本虽然准确,却缺乏情感温度、叙事张力与独特的品牌人格。
本章将引导学员实现从“通用逻辑”到“个性化表达”的范式转移,进入“构建 AI 的脑”的关键阶段。我们将引入 少样本学习 (Few-Shot Learning) 技术,利用极少量的 样本 (Exemplars) 激活模型内部的 上下文学习(In-Context Learning) 能力。
通过本章的“风格提取-提示链构建-对比测试”实战方案,你将引导智能体完成从“工具性输出”向“人格化交互”的进阶,使其能够复刻特定人类的“方言”
基础理论:少样本学习的思维锚点
你可能会问:“我并没有重新训练模型(Fine-tuning),为什么它能学会新风格?” 大语言模型展现出的“智慧”在很大程度上源于其在推理阶段的自适应能力。这种能力被称为上下文学习(In-Context Learning),它允许模型在不改变物理参数(Weight)的前提下,通过对输入提示词中示例的观察,动态调整其预测输出的概率分布。
2.1 学习范式的阶梯:零样本、单样本与少样本
在智能体工程的提示设计中,根据提供示例的数量与深度,通常将学习范式分为三个层级。
表3-1展示了不同学习范式在技术实现与应用效果上的差异:
#SnKviukfAPwb text { white-space: pre; }#SnKviukfAPwb .fb0 { stroke: var(--N900-FG, 0.15); }#SnKviukfAPwb .fb0 {stroke: rgba(31,35,41, 0.15)}#SnKviukfAPwb .fx0 { stroke-miterlimit: 10; }#SnKviukfAPwb .fx0 {stroke-miterlimit: 10}#SnKviukfAPwb .fa1 { fill: rgb(187, 191, 196); }#SnKviukfAPwb .fa1 {fill: rgb(187, 191, 196)}#SnKviukfAPwb .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#SnKviukfAPwb .fx1 {font-style: normal}#SnKviukfAPwb .fx2 { text-anchor: middle; }#SnKviukfAPwb .fx2 {text-anchor: middle}#SnKviukfAPwb .fx3 { dominant-baseline: central; }#SnKviukfAPwb .fx3 {dominant-baseline: central}#SnKviukfAPwb .fx4 { stroke: none; }#SnKviukfAPwb .fx4 {stroke: none}#SnKviukfAPwb .fc0 { fill: var(--text-caption); }#SnKviukfAPwb .fc0 {fill: #646a73}#SnKviukfAPwb .fa2 { fill: var(--text-link-disabled); }#SnKviukfAPwb .fa2 {fill: rgb(187, 191, 196)}#SnKviukfAPwb .fa3 { fill: rgb(31, 35, 41); }#SnKviukfAPwb .fa3 {fill: rgb(31, 35, 41)}#SnKviukfAPwb .fx5 { font: 700 14px LarkHackSafariFont, LarkEmojiFont, "Microsoft YaHei", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#SnKviukfAPwb .fx5 {font-style: normal}#SnKviukfAPwb .fx6 { text-anchor: start; }#SnKviukfAPwb .fx6 {text-anchor: start}#SnKviukfAPwb .fx7 { dominant-baseline: alphabetic; }#SnKviukfAPwb .fx7 {dominant-baseline: alphabetic}#SnKviukfAPwb .fc1 { fill: rgb(255, 255, 255); }#SnKviukfAPwb .fc1 {fill: rgb(255, 255, 255)}#SnKviukfAPwb .fx8 { font: 700 14px 微软雅黑; }#SnKviukfAPwb .fx8 {font-style: normal}#SnKviukfAPwb .fc2 { fill: rgb(5, 16, 26); }#SnKviukfAPwb .fc2 {fill: rgb(5, 16, 26)}#SnKviukfAPwb .fx9 { font: 400 14px 微软雅黑; }#SnKviukfAPwb .fx9 {font-style: normal}#SnKviukfAPwb .fx10 { font: 400 14px LarkHackSafariFont, LarkEmojiFont, "Microsoft YaHei", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#SnKviukfAPwb .fx10 {font-style: normal}#SnKviukfAPwb .fb1 { fill: var(--N900-FG, 0.15); }#SnKviukfAPwb .fb1 {fill: rgba(31,35,41, 0.15)}#SnKviukfAPwb .fb2 { fill: rgb(221, 221, 221); }#SnKviukfAPwb .fb2 {fill: rgb(221, 221, 221)}#SnKviukfAPwb .fa4 { fill: var(--bg-body); }#SnKviukfAPwb .fa4 {fill: #fff}ABCDE1234范式名称示例数量核心机制预期效果典型应用场景零样本单样本少样本 (Zero-Shot) (One-Shot) (Few-Shot)012月10日依赖预训练阶段的通用语义概率分布通过单个锚点确立输入/输出的映射边界捕捉数据分布的细微特征、节奏感与叙事逻辑泛化性强,但缺乏特定任务的针对性与风格一致性初步具备格式模仿能力,但容易对单一示例过度拟合能够实现高度人格化的风格克隆与复杂逻辑推理基础问答、通用翻译、情感分类初筛简单的 JSON 格式定义、命名实体提取规范品牌声量建设、个性化写作助手、特定领域法律/医学文案
如果将大语言模型比作一位精通世界菜系的资深厨师,那么:
✅
零样本提示(Zero-Shot)就相当于只给厨师一张写着“红烧肉”三个字的订单。厨师会根据职业生涯中见过的数百万份红烧肉的平均做法(预训练数据)来烹饪,结果往往中规中矩,缺乏惊喜。
在智能体工程中,这些“样菜”就是示例(Examples),它们充当了“思维空间的锚点”,强力引导 AI 进入特定的表达语境 。 当 LLM(大语言模型)面对一个空白的输入框时,它的思维是在一个巨大的、高熵的概率空间里游荡的。当你提供几个 输入 -> 输出 的示例时,你实际上是在这个高维空间里打下了几根桩子。
2.2 技术机制:注意力机制与诱导头的协作
从底层原理来看,少样本学习的实现高度依赖于 Transformer 架构中的注意力机制(Attention Mechanism)。注意力机制允许模型在处理当前 Token 时,通过计算查询向量(Query)与键向量(Key)的相似度,将权重分配给输入序列中的相关部分。
数学表达如下:
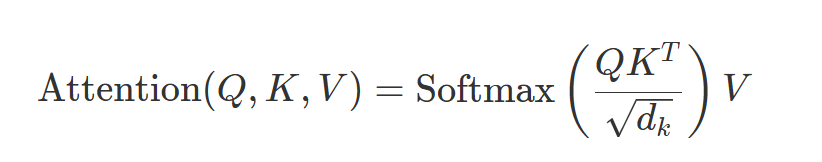
其中,其中dkdk 作为缩放因子确保了数值稳定性 。当提示词中包含多个风格样本时,模型内部会形成一种被称为“潜空间漂移”(Latent Space Shifting)的现象。
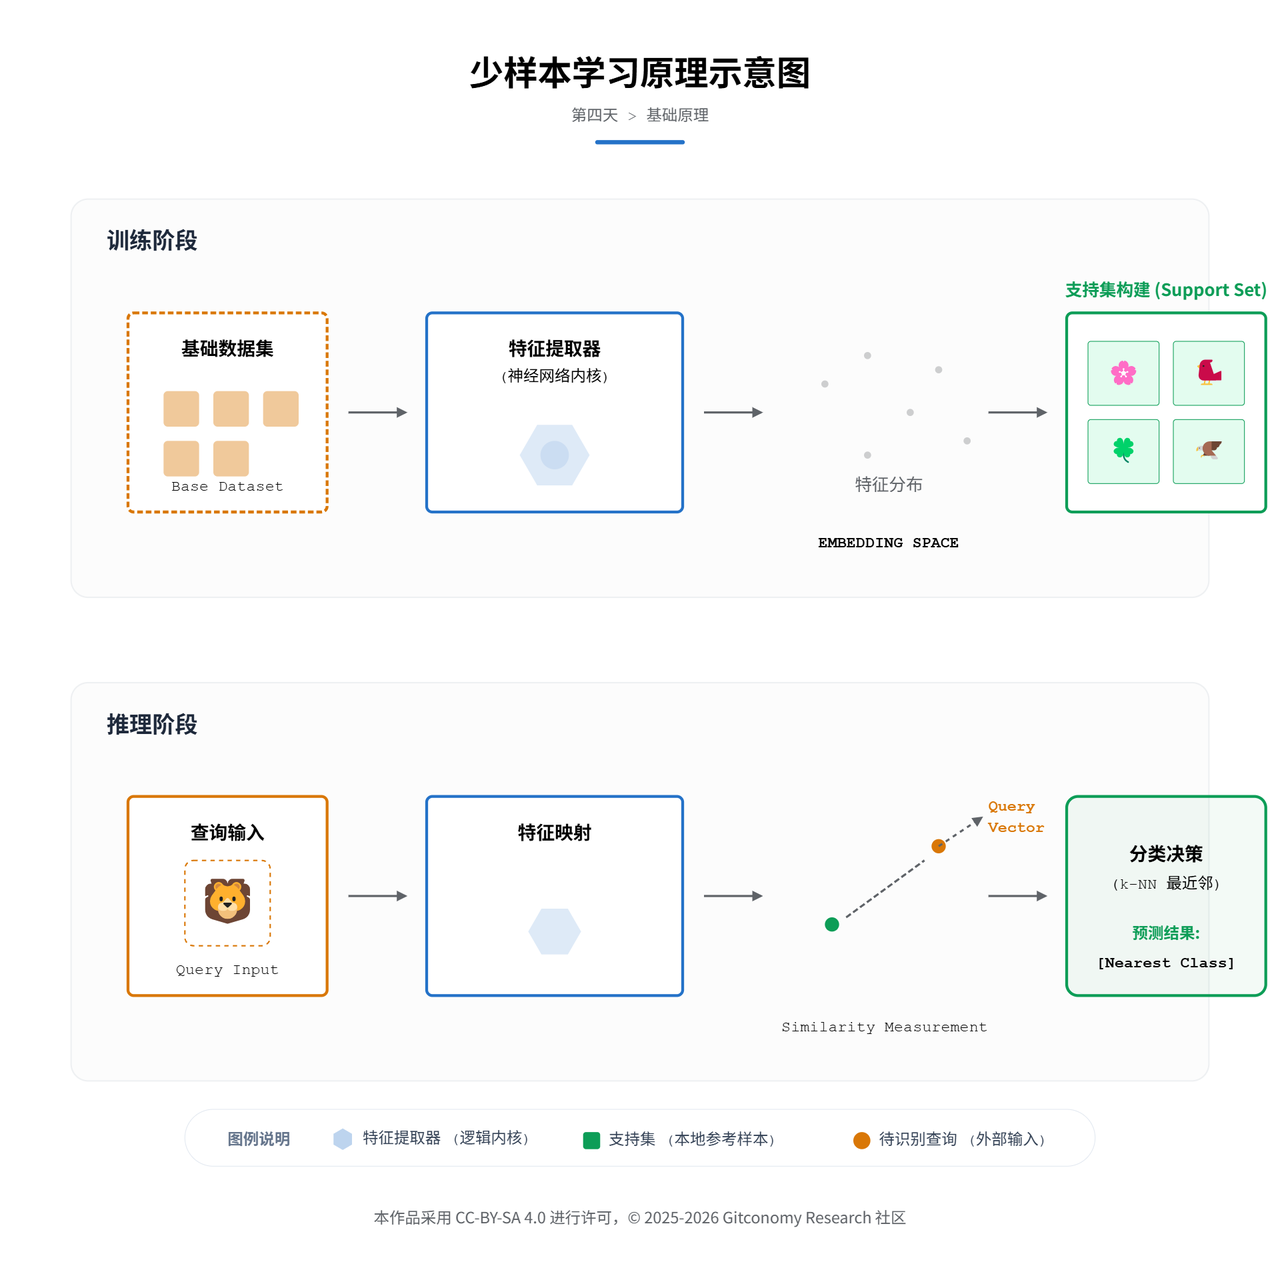
图4-1:少样本学习原理示意图
👍
研究表明,模型中存在一种特定的神经回路,被称为“诱导头”(Induction Heads) 。诱导头通常由跨层的两个注意力头协作完成:第一层头负责将前一个 Token 的信息传递给当前位置;第二层头(即真正的诱导头)则在序列中搜索与当前模式匹配的历史记录,并预测下一个 Token。这种“扫描-匹配-复制”的算法逻辑,是 AI 能够通过区区几个例子就学会某种“方言”的技术原理。当提示词中包含样本(Examples)时,模型的 诱导头 (Induction Heads)会在序列中扫描这些样本的模式(Pattern)。这些样本充当了高维潜空间中的 “锚点” (Anchors):
•
无样本时:思维游荡在高熵的通用概率空间。
•
有样本时:样本改变了 Query 与 Key 向量的相似度计算,将模型的生成策略强行“拖拽”到特定的风格区域。
•
权重调整:虽然我们没有修改模型的参数(权重),但示例改变了模型的注意力机制(Attention)。模型会分析示例之间的规律(Pattern),并在推理时临时调整其生成策略,以匹配这些规律。
因此,In-Context Learning 本质上是在推理过程中进行了一次微型的、临时的梯度下降,让模型在几毫秒内“学会”了你的特定任务。
💡 提示工程技巧:样本的多样性很重要
如果你给的 3 个例子都是关于“科技新闻”的,AI 可能会误以为你只想要它写科技新闻。 最佳实践:提供风格统一、但内容领域不同的样本(例如:一个写美食、一个写旅游、一个写心情),这样 AI 就能剥离出“内容”,只锁定“风格”。
实战演练:从“机器味”到“人格化”的风格克隆
本次实战的核心任务是:利用 “少样本学习 (Few-Shot Learning)” 技术,将一段“说明书式”的产品介绍,将其封装为可被自动化脚本直接调用的 JSON 数据契约,然后重构为一篇极具感染力的小红书“种草文案”。
图4-2:第四天实验步骤
3.1 实验任务工单:智能手表文案的“工程化重构”
任务背景:你是一名刚入职的社交媒体运营,老板扔给你一段关于“智能手表”的技术参数,要求你发一篇小红书笔记。
任务目标:不能只发枯燥的参数,必须模仿小红书博主的独特“方言”(Emoji、感叹号、情绪词),让读者产生购买冲动。
3.2 执行步骤拆解
请按照以下步骤执行您的实验:
步骤 1:获取“原石” (准备高熵文本)
首先,我们需要一段没有风格、平铺直叙的原始文本。请在 Obsidian 中新建笔记,粘贴以下内容作为待处理对象:
原始文本: “这款智能手表具备长达 14 天的续航能力。它支持多种运动模式监测,并能实时记录心率和血氧数据。外观采用极简设计,适合各种场合佩戴。现在购买可享受限时折扣。”
步骤 2:提取“样本” (寻找风格锚点)
为了让 AI 学会“小红书味”,你需要给它喂食 3 个高质量的样本(Exemplars)。请复制以下三段文案,它们将作为 Few-Shot 的核心素材:
•
样本 1:
•
🆘干皮亲妈!这款面霜真的绝绝子!😭 💧满满的玻尿酸成分,上脸瞬间吸收,感觉几万个水分子在往毛孔里钻!集美们,闭眼冲!🔥 #干皮救星 #无限回购
•
样本 2:
•
不允许还有人没去过这家神仙咖啡店!☕️✨ 复古的装修风格,随手一拍都是电影感大片,氛围感直接拉满!💯 #探店 #氛围感
•
样本 3:
•
救命!这个收纳神器真的太香了!🏠 以前乱糟糟的桌面瞬间整齐,强迫症表示极度舒适!收纳控必入,谁用谁知道!👇 #收纳 #提升幸福感
注:这些样本虽然内容不同(面霜、咖啡、收纳),但风格高度统一(Emoji、感叹号、情绪词),这正是 Few-Shot 生效的关键。
步骤 3:组装 S.C.O.R.E. 提示词 (构建Prompt)
请在 Obsidian 的 Text Generator 插件中,输入以下完整的结构化提示词。注意看 Example 模块是如何嵌入上述样本的:
💡 提示工程技巧:样本多样性至关重要
如果你给的 3 个例子都是“科技产品”,AI 可能会误以为你只想要它写科技新闻。最佳实践是提供 风格统一、但领域不同 的样本(如美食、美妆、家居),这样 AI 就能剥离出“内容”,只锁定“风格”。
步骤 4:运行与验收 (对比测试)
执行生成:将光标放在提示词最后,Ctrl+J 触发 Text Generator。或者 Ctrl+P 触发Tars
验收标准:
◦
AI 是否使用了“救命”、“绝绝子”等词?(这是 One-Shot 很难做到的)
◦
AI 是否在“续航能力”后面自动加了电池 Emoji 🔋?(这是上下文学习产生的联想)
◦
AI 是否保留了核心参数没有瞎编?
Text Generator 产生的样例效果:
代码块
Plain Text
#智能手表推荐
Tars 产生的样例效果
代码块
Plain Text
【沉浸体验】🏃♀️🏃♂️戴上这个小手表,运动监测直接开挂!心率、血氧、卡路里统统搞定~有种追剧追到半途自动提醒的感觉呢 😱💗
【核心优势】⌚14天续航不蹦迪?不存在的!谁用谁知道,睡前放好,第二天醒来秒变电量满格!比普通的智能手表优秀百倍好吗 👏🔥
【卖点强化】❤️心率监测?血氧数据?这都能实时看!姐妹们在家办公🏕️或者健身完,随时了解自己的身体状态~超级安心!
通过这个具体的“复制 -> 组装 -> 生成”流程,您就能直观体会到 Few-Shot Learning 是如何通过几个例子(Anchors),强行把 AI 从“说明书模式”拽进“小红书模式”的。
本章总结
本章揭示了提示词工程的第二层逻辑:数据本身也是指令。通过 2-5 个高质量样本,你可以在推理阶段临时调整模型的输出分布,实现从“说明书体”到“小红书体”的风格切换。这种零训练成本的个性化能力,是构建品牌化智能体的核心技术。样本不是装饰,是思维空间的锚点——选对样本,比写对指令更重要。
👍
💡 不修改模型参数,也能改变模型行为——这就是上下文学习的价值。
下一章预告:AI 学会了“怎么说话”,但它的“阅读能力”仍受限于上下文窗口。第5章将引入 知识切片——将长文本拆解为可独立检索的原子笔记,为 RAG 系统构建高质量的知识底座。
课后思考
中间迷失
当 Prompt 过长时,模型往往只能记住开头和结尾的例子,而位于中间的风格特征会被“稀释”。在构建包含 10 个以上样本的复杂 Prompt 时,应该如何排列样本的顺序?
注意力稀释与幻觉⚠️ 幻觉警示
样本过多若演变为杂乱,会干扰模型的注意力分配。请尝试在你的 Prompt 中放入 8 个风格迥异的样本,观察输出结果是否会出现逻辑崩坏或事实性幻觉?
Token 成本
每一个少样本示例都会占据昂贵的上下文窗口。如何建立一个“样本库”,根据不同的任务动态抽取最相关的 3 个样本注入 Prompt,而不是每次都发送全部样本?
课后任务: 尝试在你的智能体中分别放入 1 个、3 个和 8 个风格样本。观察输出结果在风格细腻度、指令遵循度以及逻辑稳定性上的变化。是否存在一个“甜点位”(Sweet Spot)?
附录 1:核心术语表 (Glossary)